

Hoewel er tegenwoordig bijna overal veel gegevens zijn, zijn analytische databases nog steeds behoorlijk exotisch. Ze zijn slecht bekend en nog slechter effectief te gebruiken. Veel mensen blijven "cactussen eten" met MySQL of PostgreSQL, die zijn ontworpen voor andere scenario's, worstelen met NoSQL of betalen te veel voor commerciële oplossingen. ClickHouse verandert de spelregels en verlaagt de drempel om de wereld van analytische DBMS binnen te stappen aanzienlijk.
De presentatie van BackEnd Conf 2018 en deze is gepubliceerd met toestemming van de spreker.
Wie ben ik en waarom vertel ik over ClickHouse? Ik ben directeur ontwikkeling bij LifeStreet, dat ClickHouse gebruikt. Daarnaast ben ik oprichter van Altinity. Dit is een partner van Yandex die ClickHouse promoot en Yandex helpt ClickHouse succesvoller te maken. Ik ben ook bereid om mijn kennis over ClickHouse te delen.
En ik ben niet de broer van Petya Zaitsev. Mensen vragen me hier vaak naar. Nee, we zijn geen broers.
«Iedereen weet», dat ClickHouse:
- Zeer snel is,
- Zeer gebruiksvriendelijk is,
- Wordt gebruikt bij Yandex.
Wat minder bekend is, is in welke bedrijven en hoe het wordt gebruikt.
Ik zal jullie vertellen waar, waarvoor en hoe ClickHouse wordt gebruikt, naast Yandex.
Ik zal uitleggen hoe specifieke taken met ClickHouse in verschillende bedrijven worden opgelost, welke middelen van ClickHouse je kunt gebruiken voor jouw taken en hoe ze in verschillende bedrijven zijn gebruikt.
Ik heb drie voorbeelden geselecteerd die ClickHouse vanuit verschillende perspectieven laten zien. Ik denk dat dit interessant zal zijn.
De eerste vraag: «Waarom is ClickHouse nodig?». Het lijkt een vrij voor de hand liggende vraag, maar er zijn meer antwoorden dan één.
- Het eerste antwoord is voor de prestaties. ClickHouse is erg snel. Analytics op ClickHouse is ook zeer snel. Je kunt het vaak gebruiken waar iets anders erg langzaam of slecht werkt.
- Het tweede antwoord is de kosten. En vooral de kosten van schaling. Bijvoorbeeld, Vertica is een uitstekende database. Het werkt heel goed als je niet veel terabytes aan gegevens hebt. Maar als het gaat om honderden terabytes of petabytes, dan lopen de licentie- en ondersteuningskosten op tot een zeer aanzienlijk bedrag. En dat is duur. Maar ClickHouse is gratis.
- Antwoord drie is de operationele kosten. Dit is een andere benadering. RedShift is een uitstekende analogie. Met RedShift kun je heel snel een oplossing maken. Het zal goed werken, maar je zult elke uur, elke dag en elke maand behoorlijk veel betalen aan Amazon, omdat het een aanzienlijk dure service is. Google BigQuery ook. Als iemand het heeft gebruikt, weet hij dat je daar meerdere queries kunt uitvoeren en plotseling een rekening van honderden dollars kunt krijgen.
In ClickHouse zijn deze problemen er niet.
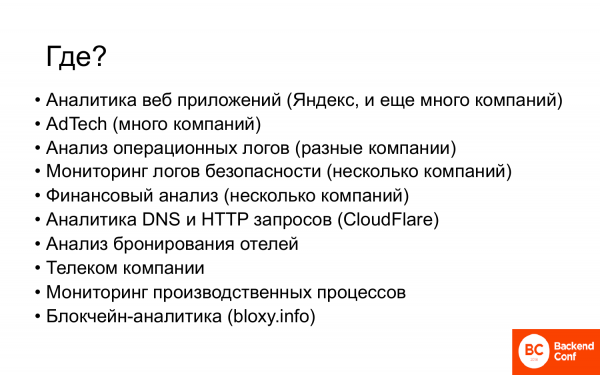
Waar wordt ClickHouse momenteel gebruikt? Naast Yandex wordt ClickHouse in tal van verschillende bedrijven en organisaties gebruikt.
- In de eerste plaats gaat het om webapplicatie-analyse, dat wil zeggen een use case die uit Yandex komt.
- Veel AdTech-bedrijven gebruiken ClickHouse.
- Talrijke bedrijven die operationele logs vanuit verschillende bronnen moeten analyseren.
- Enkele bedrijven gebruiken ClickHouse voor het monitoren van beveiligingslogs. Ze laden deze in ClickHouse, maken rapporten en krijgen de resultaten die ze nodig hebben.
- Bedrijven beginnen het te gebruiken voor financiële analyse, dat wil zeggen dat ook grote bedrijven geleidelijk aan ClickHouse ontdekken.
- CloudFlare. Als iemand ClickHouse volgt, heeft hij zeker de naam van dit bedrijf gehoord. Dit is een van de belangrijke bijdragers uit de community. En zij hebben een zeer serieuze ClickHouse-installatie. Ze hebben bijvoorbeeld een Kafka Engine voor ClickHouse gemaakt.
- Telecombedrijven zijn begonnen het te gebruiken. Verschillende bedrijven gebruiken ClickHouse ofwel als proof of concept, of al in productie.
- Eén bedrijf gebruikt ClickHouse voor het monitoren van productieprocessen. Ze testen chips, houden veel parameters bij, rond de 2000 kenmerken. En daarna analyseren ze – een goede partij of een slechte.
- Blockchain-analyse. Er is een Russisch bedrijf zoals Bloxy.info. Dit is een analyse van het Ethereum-netwerk. Dit hebben ze ook op ClickHouse gedaan.
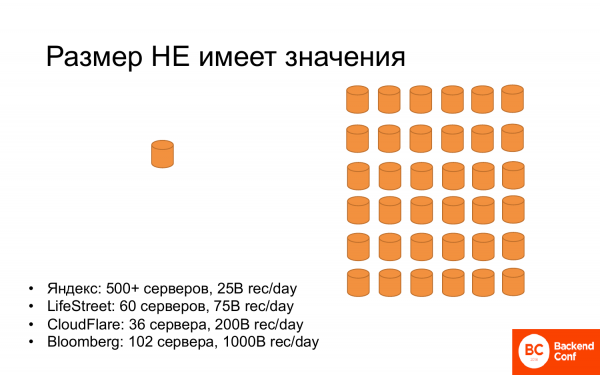
Trouwens, de grootte doet er niet toe. Er zijn veel bedrijven die één kleine server gebruiken. En daarmee kunnen ze hun problemen oplossen. En nog meer bedrijven gebruiken grote clusters van meerdere servers of tientallen servers.
En als je naar de records kijkt, dan:
- Yandex: 500+ servers, 25 miljard records per dag die ze daar opslaan.
- LifeStreet: 60 servers, ongeveer 75 miljard records per dag. Minder servers, meer records dan bij Yandex.
- CloudFlare: 36 servers, they store 200 billion records a day. They have even fewer servers and even more data they store.
- Bloomberg: 102 de server, about a trillion records a day. The record holder for records.
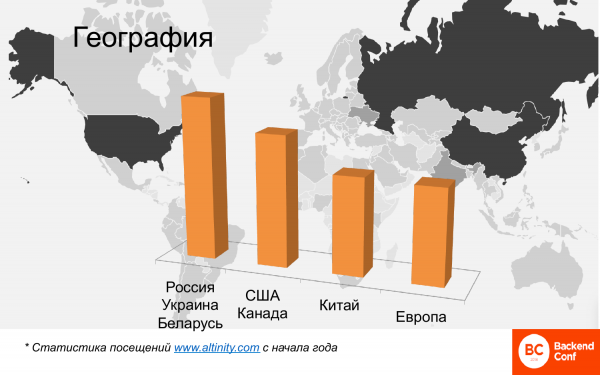
Geographically, that's also a lot. This map shows the heatmap of where ClickHouse is used in the world. Here, Russia, China, and America stand out prominently. There are few European countries. Four clusters can be highlighted.
This is a comparative analysis; there's no need to look for absolute figures. This analysis is of visitors reading English-language materials on the Altinity website, as there are no Russian-speaking materials. The largest users are from Russia, Ukraine, and Belarus, that is, the Russian-speaking part of the community. Following them are the USA and Canada. China is catching up very quickly. Half a year ago, there was almost no data from China; now China has already surpassed Europe and continues to grow. Old Europe isn't lagging either, and surprisingly, France leads in ClickHouse usage.
Why am I telling you all this? To show that ClickHouse is becoming the standard solution for big data analysis and is already widely used. If you are using it, you are on the right trend. If you are not using it yet, you need not worry about being alone without anyone to help you, as many are already engaged with it.
These are examples of real ClickHouse usage in several companies.
- The first example is an advertising network: migration from Vertica to ClickHouse. I know several companies that have migrated from Vertica or are in the process of doing so.
- The second example is a transactional storage solution on ClickHouse. This example is built on anti-patterns. Everything that should not be done in ClickHouse according to developer advice has been done here. Yet, it works effectively, and significantly better than a typical transactional solution.
- The third example is distributed computing on ClickHouse. There was a question about how ClickHouse can be integrated into the Hadoop ecosystem. I will show an example of how a company created something like a map reduce container on ClickHouse, taking data localization into account, etc., to solve a very non-trivial task.
- LifeStreet – This is an Ad Tech company that possesses all the technologies related to an advertising network.
- It focuses on optimizing ads and programmatic bidding.
- Veel gegevens: ongeveer 10 miljard gebeurtenissen per dag. Daarbij kunnen gebeurtenissen in verschillende subgebeurtenissen worden verdeeld.
- Veel klanten van deze gegevens, en dat zijn niet alleen mensen, maar veel meer – dat zijn verschillende algoritmen die zich bezighouden met programmatic bidding.
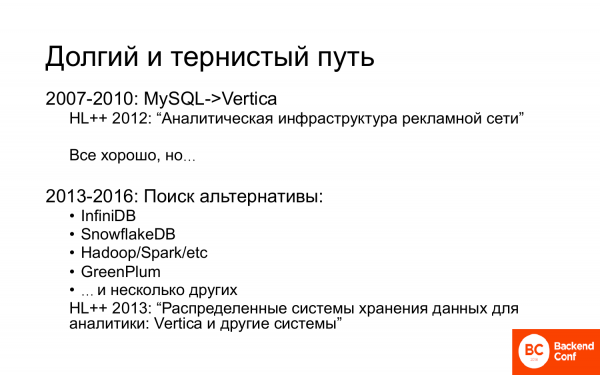
Het bedrijf heeft een lange en moeilijke weg afgelegd. En ik heb daarover verteld op HighLoad. Eerst is LifeStreet overgestapt van MySQL (met een korte onderbreking naar Oracle) naar Vertica. En daarover is een verhaal te vinden.
En alles ging heel goed, maar al snel werd duidelijk dat de gegevens groeiden en dat Vertica duur was. Daarom werden verschillende alternatieven gezocht. Sommige daarvan zijn hier opgesomd. En eigenlijk hebben we een proof of concept of soms performance testing gedaan met bijna alle databases die tussen 2013 en 2016 beschikbaar waren op de markt en ongeveer geschikt waren qua functionaliteit. En over sommige daarvan heb ik ook op HighLoad gesproken.
De taak was om in de eerste plaats te migreren van Vertica, omdat de gegevens groeiden. En ze groeiden exponentieel gedurende enkele jaren. Daarna kwamen ze op een plateau, maar desondanks. En met het oog op deze groei, de zakelijke eisen voor het volume aan gegevens waarover analyses moeten worden gemaakt, was het duidelijk dat er binnenkort gesproken zou worden over petabytes. En voor petabytes betalen is al heel duur, dus zochten we naar een alternatief om naartoe te gaan.
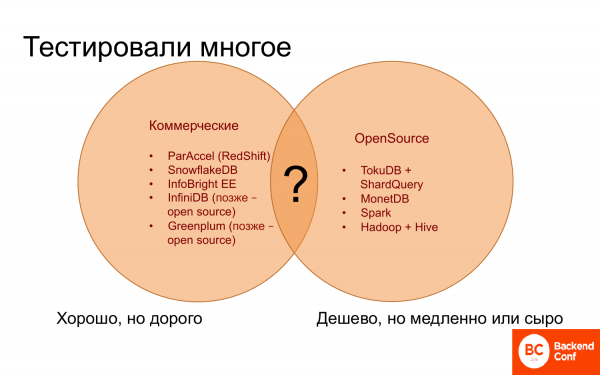
Waarheen te gaan? En lange tijd was het volkomen onduidelijk waarheen te gaan, omdat aan de ene kant commerciële databases waren die redelijk goed werkten. Sommige werken bijna net zo goed als Vertica, andere iets minder goed. Maar ze zijn allemaal duur; niets goedkopers en beters konden we vinden.
Aan de andere kant zijn er open source oplossingen, die niet erg veel zijn, dat wil zeggen, voor analyses kunnen ze op de vingers van één hand worden geteld. En ze zijn gratis of goedkoop, maar werken langzaam. En vaak ontbreekt het aan de nodige en nuttige functionaliteit.
Er was eigenlijk niets dat het goede van commerciële databases combineerde met alles wat gratis was in open source.
Er was niets tot het onverwachts Yandex ClickHouse tevoorschijn haalde, alsof het een konijn uit een hoed was. En dat was een onverwachte oplossing; tot nu toe wordt de vraag gesteld: 'Waarom?', maar toch.
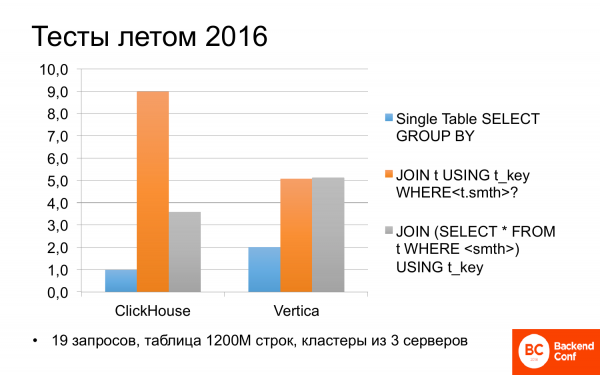
En in de zomer van 2016 begonnen we te kijken naar wat ClickHouse is. En het bleek dat het soms sneller kan zijn dan Vertica. We hebben verschillende scenario's getest met verschillende queries. En als de query slechts één tabel gebruikte, dus zonder enige joins, dan was ClickHouse twee keer zo snel als Vertica.
Ik heb geen moeite gespaard en heb gisteren ook naar de tests van Yandex gekeken. Daar is het hetzelfde: ClickHouse is twee keer zo snel als Vertica, daarom praten ze er vaak over.
Maar als er joins in de queries zitten, is het allemaal niet zo eenduidig. En ClickHouse kan twee keer zo langzaam zijn als Vertica. Maar als je de query een beetje aanpast en herschrijft, zijn ze ongeveer gelijk. Niet slecht. En gratis.
En na het verkrijgen van de testresultaten en het bekijken van verschillende perspectieven, ging LifeStreet voor ClickHouse.
Dit is 2016, ter herinnering. Het was als in de mop over de muizen die huilden en zich prikten, maar doorgingen met het eten van de cactus. Hierover is uitgebreid gesproken, er zijn video's over enzovoort.
Daarom ga ik hier niet in detail op in, ik zal alleen de resultaten en enkele interessante dingen die ik toen niet heb verteld delen.
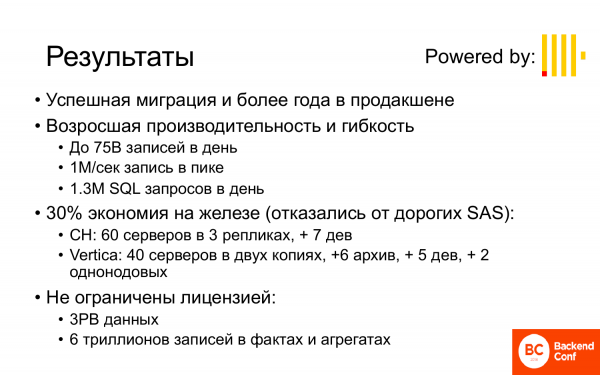
De resultaten zijn:
- Een succesvolle migratie en het systeem draait al meer dan een jaar in productie.
- De prestaties en flexibiliteit zijn toegenomen. Van de 10 miljard records die we zelfs maar kort konden opslaan, slaat LifeStreet nu 75 miljard records per dag op en kan dit drie maanden of langer doen. In de piek is dat tot een miljoen gebeurtenissen per seconde. Meer dan een miljoen SQL-queries per dag komen deze systeem binnen, voornamelijk van verschillende bots.
- Ondanks dat er voor ClickHouse meer servers zijn gebruikt dan voor Vertica, is er wel bespaard op hardware, omdat in Vertica vrij dure SAS-schijven werden gebruikt. In ClickHouse werden SATA-schijven gebruikt. En waarom? Omdat de insert in Vertica synchroon is. En synchronisatie vereist dat de schijven niet te veel vertragen, evenals dat het netwerk niet te veel vertraagt, wat een behoorlijk dure operatie is. Terwijl de insert in ClickHouse asynchroon is. Bovendien kan alles altijd lokaal worden geschreven, zonder extra kosten, waardoor gegevens in ClickHouse veel sneller kunnen worden ingevoegd dan in Vertica, zelfs op de niet snelste schijven. En voor het lezen is het ongeveer hetzelfde. Lezen op SATA, als ze in RAID zitten, is ook vrij snel.
- Niet gelicentieerd, dat wil zeggen 3 petabyte aan gegevens op 60 servers (20 servers is één replica) en 6 triljoen records in feiten en aggregaten. Iets dergelijks kon Vertica zich niet veroorloven.
Nu ga ik over naar praktische zaken in dit voorbeeld.
- Het eerste is een efficiënte schema. Het schema heeft veel invloed.
- Het tweede is het genereren van efficiënt SQL.
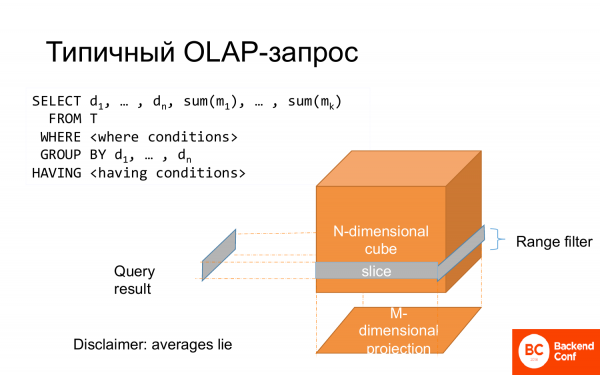
Een typische OLAP-query is een select. Een deel van de kolommen gaat naar group by, een deel van de kolommen gaat naar aggregatiefuncties. Er is een where-clausule, die we kunnen beschouwen als een snede van de kubus. Het hele group by kan worden gezien als een projectie. Daarom spreekt men van multidimensionale data-analyse.
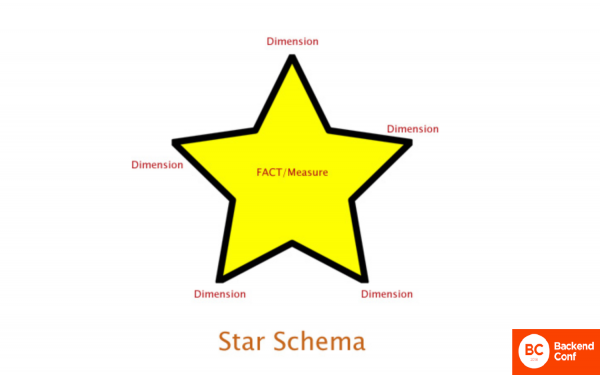
En vaak wordt dit gemodelleerd in de vorm van een ster-schema, waarbij er een centraal feit is en kenmerken van dat feit aan de zijkanten, via stralen.
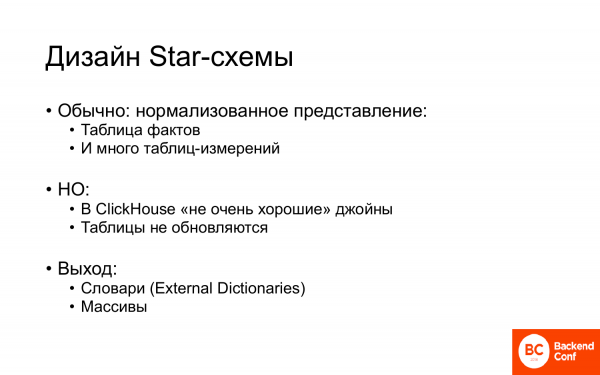
En vanuit het perspectief van het fysieke ontwerp, hoe dit op een tabel wordt gelegd, maakt men meestal een genormaliseerde weergave. Je kunt het denormaliseren, maar dat kost veel schijfruimte en is niet zo efficiënt voor queries. Daarom maakt men meestal een genormaliseerde weergave, dat wil zeggen, een feitentabel en veel, veel dimensietabellen.
Maar in ClickHouse werkt dit slecht. Er zijn twee redenen:
- De eerste is dat de joins in ClickHouse niet zo goed zijn, dat wil zeggen, er zijn joins, maar ze zijn slecht. Voorlopig slecht.
- De tweede is dat tabellen niet worden bijgewerkt. Gewoonlijk moet er iets veranderen in deze tabellen rond het ster-schema. Bijvoorbeeld, de naam van de klant, de naam van het bedrijf, enzovoort. En dat werkt niet.
Er is echter een oplossing voor dit probleem in ClickHouse. zelfs twee:
- De eerste is het gebruik van woordenboeken. External Dictionaries helpen voor 99% het probleem met het ster-schema, met updates en dergelijke op te lossen.
- De tweede is het gebruik van arrays. Arrays helpen ook om van de joins af te komen en van de problemen met normalisatie.
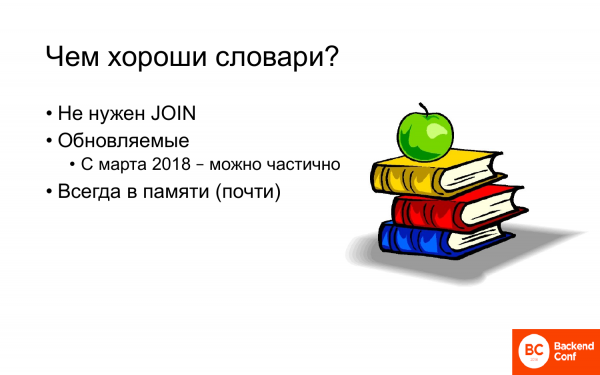
- Je hebt geen joins nodig.
- Bijwerkbaar. Sinds maart 2018 is er een niet-gedocumenteerde mogelijkheid (dit vind je niet in de documentatie) om woordenboeken gedeeltelijk bij te werken, dat wil zeggen, de records die zijn gewijzigd. Praktisch gezien is dit vergelijkbaar met een tabel.
- Altijd in het geheugen, daarom werken joins met het woordenboek sneller dan wanneer het een tabel zou zijn die op schijf staat en waarvan nog niet zeker is of deze in de cache zit, waarschijnlijk niet.
- Je hebt ook geen joins nodig.
- Dit is een compacte weergave 1 op veel.
- En naar mijn mening zijn arrays gemaakt voor nerds. Dit zijn lambda-functies en dergelijke.
Dit is geen loze woorden. Dit is een zeer krachtige functionaliteit die het mogelijk maakt om veel dingen heel eenvoudig en elegant te doen.
Typische voorbeelden die helpen bij het werken met arrays. Deze voorbeelden zijn eenvoudig en goed begrijpelijk:
- Zoeken op tags. Als je daar hashtags hebt en je wilt bepaalde berichten vinden op basis van een hashtag.
- Zoeken op key-value paren. Er zijn ook bepaalde attributen met waarden.
- Het opslaan van lijsten met sleutels die je naar iets anders moet vertalen.
Al deze taken kunnen zonder arrays worden opgelost. Tags kunnen in één rij worden geplaatst en met een reguliere expressie worden geselecteerd, of in een aparte tabel, maar dan moet je joins uitvoeren.
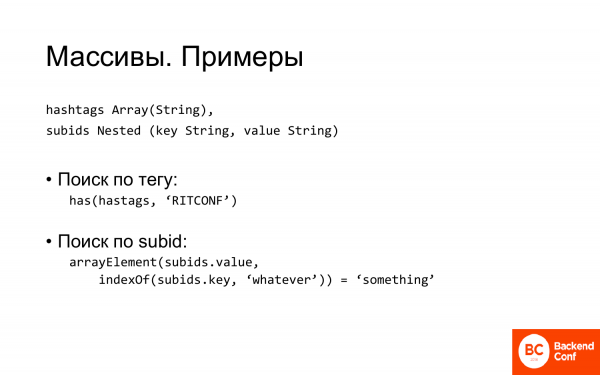
In ClickHouse hoeft er echter niets te worden gedaan, het is voldoende om een string array voor hashtags te beschrijven of een geneste structuur voor systemen zoals key-value te maken.
Een geneste structuur – dat is misschien niet de beste naam. Dit zijn twee arrays die een gemeenschappelijk element in de naam hebben en enkele gerelateerde kenmerken.
En zoeken op tag is heel eenvoudig. Er is een functie has, die controleert of een element in de array aanwezig is. Dat is alles, we hebben alle berichten gevonden die verband houden met onze conferentie.
Zoeken op subid is iets ingewikkelder. Eerst moeten we de index van de sleutel vinden en dan het element met deze index nemen en controleren of deze waarde is wat we nodig hebben. Maar het blijft heel eenvoudig en compact.
Een reguliere expressie die je zou willen schrijven als je alles in één lijn zou opslaan, zou ten eerste onhandig zijn. En ten tweede zou het veel langer duren om uit te voeren dan twee arrays.
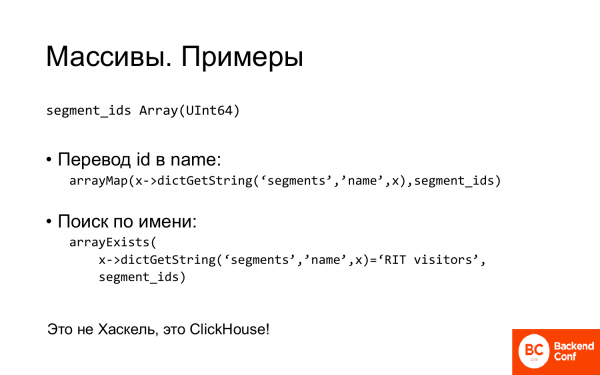
Een ander voorbeeld. Je hebt een array waarin je ID's opslaat. En je kunt ze vertalen naar namen. De functie arrayMap. Dit is een typische lambda-functie. Je geeft het lambda-expressies door. En het haalt de waarde van de naam voor elk ID uit de woordenlijst.
Op dezelfde manier kan je ook zoeken. Een predicaatfunctie wordt doorgegeven die controleert aan welke voorwaarden de elementen voldoen.
Deze zaken vereenvoudigen de structuur aanzienlijk en lossen een heleboel problemen op.
Maar het volgende probleem waarmee we te maken kregen, en waar ik het over wil hebben, zijn effectieve queries.
- In ClickHouse is er geen queryplanner. Helemaal niet.
- Maar desondanks moeten ook complexe queries nog steeds worden gepland. In welke gevallen?
- Als er meerdere joins in de query zijn die je in subselecties verpakt, dan is de volgorde waarin ze worden uitgevoerd belangrijk.
- En ten tweede, als de query gedistribueerd is. Want in een gedistribueerde query wordt alleen de meest interne subselect gedistribueerd uitgevoerd, terwijl alles daarbuiten naar één server wordt gestuurd, waarmee je bent verbonden en dat daar wordt uitgevoerd. Dus als je gedistribueerde queries met veel joins hebt, moet je de volgorde kiezen.
En zelfs in eenvoudigere gevallen is het soms nodig om het werk van de planner uit te voeren en de queries een beetje te herschrijven.
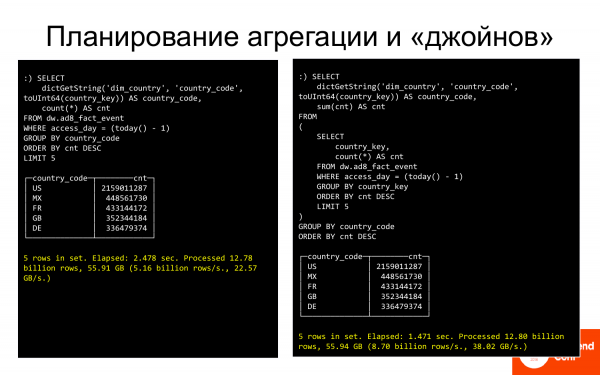
Hier is een voorbeeld. Aan de linkerkant is er een query die de top 5 landen toont. En het duurt 2,5 seconden, als ik het goed heb. Aan de rechterkant is dezelfde query, maar iets herschreven. In plaats van te groeperen op string, gingen we groeperen op sleutel (int). En dat is sneller. Vervolgens hebben we een woordenboek aan het resultaat gekoppeld. In plaats van 2,5 seconden wordt de query 1,5 seconden. Dat is goed.
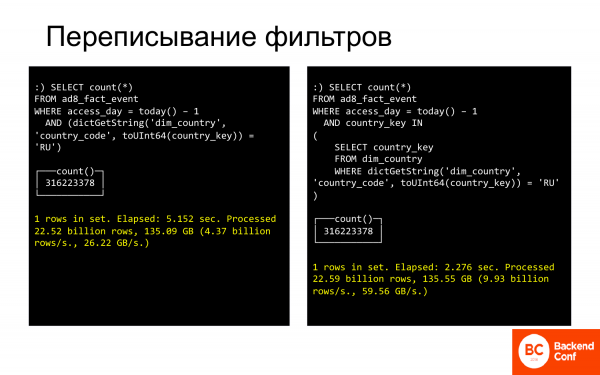
Een vergelijkbaar voorbeeld met het herschrijven van filters. Hier is de query voor Rusland. Het duurt 5 seconden. Als we het zo herschrijven dat we opnieuw niet de string, maar de getallen met een bepaalde set van sleutels die betrekking hebben op Rusland vergelijken, zal dit veel sneller zijn.
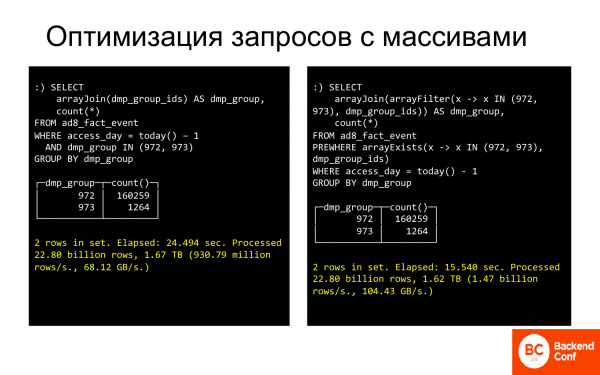
Er zijn veel van zulke trucs. En ze kunnen de queries die je denkt dat al snel werken, of omgekeerd, langzaam werken, aanzienlijk versnellen. Ze kunnen nog sneller worden gemaakt.
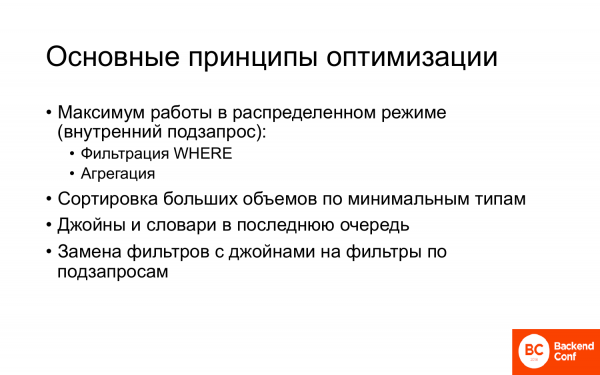
- Maximale prestaties in gedistribueerde modus.
- Sorteren op minimale types, zoals ik het deed met integers.
- Als er joins zijn, of woordenboeken, is het beter om die zo laat mogelijk uit te voeren, wanneer de data ten minste gedeeltelijk is gegroepeerd, dan zal de join-operatie of het aanroepen van het woordenboek minder vaak worden uitgevoerd en dat is sneller.
- Vervangen van filters.
Er zijn nog andere technieken, niet alleen diegene die ik heb gedemonstreerd. En al deze kunnen soms de uitvoering van queries aanzienlijk versnellen.
Laten we naar het volgende voorbeeld gaan. Bedrijf X uit de VS. Wat doet het?
Er was een taak:
- Offline koppeling van advertentietransacties.
- Modelleren van verschillende koppelingmodellen.
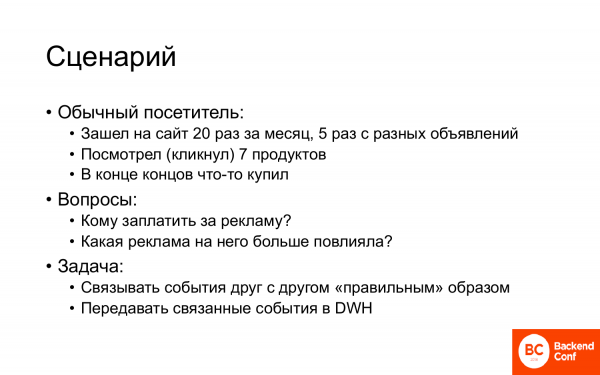
Waaruit bestaat het scenario?
Een gewone bezoeker komt bijvoorbeeld 20 keer per maand op de website, via verschillende advertenties of gewoon af en toe zonder enige advertentie, omdat hij zich deze website herinnert. Hij bekijkt een aantal producten, voegt ze aan zijn winkelwagentje toe, haalt ze eruit. En uiteindelijk koopt hij iets.
Redelijke vragen zijn: ‘Wie moet er betalen voor de advertentie, als dat nodig is?’ en ‘Welke advertentie heeft invloed gehad, als die er was?’. Dat wil zeggen, waarom heeft hij gekocht en hoe kunnen we ervoor zorgen dat mensen die op deze persoon lijken, ook kopen?
Om dit probleem op te lossen, moet je de evenementen die op de website plaatsvinden op de juiste manier met elkaar verbinden, dat wil zeggen, een connectie tussen hen opbouwen. Vervolgens moeten ze worden doorgegeven voor analyse in de DWH. En op basis van deze analyse worden modellen gebouwd, wie welke reclame moet krijgen.
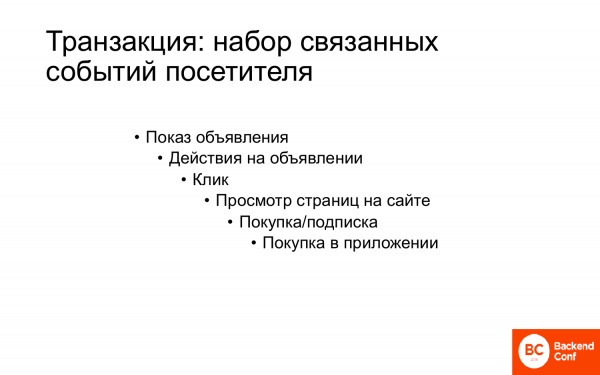
Een reclame-transactie is een set van verbonden gebruikersgebeurtenissen die begint met het weergeven van een advertentie, daarna gebeurt er iets, misschien een aankoop, en daarna kunnen er aankopen bij de aankoop zijn. Bijvoorbeeld, als het een mobiele applicatie of een mobiele game is, gebeurt de installatie van de applicatie meestal gratis, maar als er daarna iets gebeurt, kan daar geld voor nodig zijn. En hoe meer iemand in de applicatie uitgeeft, hoe waardevoller hij is. Maar hiervoor moet alles met elkaar verbonden worden.
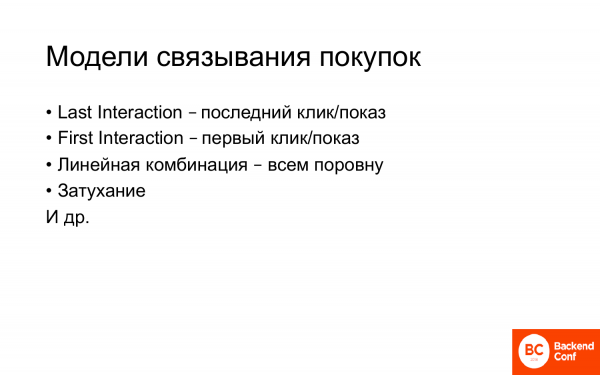
Er zijn veel modellen voor het verbinden.
De populairste zijn:
- Last Interaction, waarbij interaction een klik of een weergave is.
- First Interaction, dat wil zeggen, het eerste wat iemand naar de website bracht.
- Lineaire combinatie – iedereen krijgt hetzelfde.
- Verwatering.
- En andere.
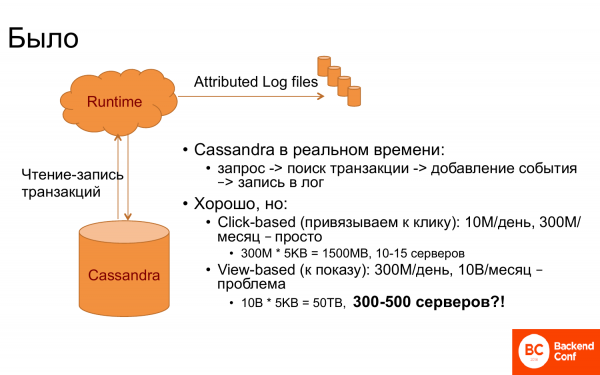
En hoe werkte dit allemaal oorspronkelijk? Er was Runtime en Cassandra. Cassandra werd gebruikt als transaction storage, dat wil zeggen, daarin werden alle verbonden transacties opgeslagen. En wanneer er een gebeurtenis in Runtime binnenkomt, bijvoorbeeld een paginaweergave of iets anders, wordt er een verzoek naar Cassandra gedaan – is er deze persoon of niet. Vervolgens werden de transacties opgehaald die betrekking op hem hadden. En er werd verbinding gemaakt.
En als je geluk had dat er een transaction id in het verzoek staat, is dat gemakkelijk. Maar meestal heb je geen geluk. Daarom moest je de laatste transactie of de transactie met de laatste klik vinden, enz.
En dit werkte heel goed zolang de koppeling op de laatste klik was. Want als je 10 miljoen klikken per dag hebt, dan zijn dat 300 miljoen per maand, als je een maand als venster neemt. En omdat dit in Cassandra allemaal in het geheugen moet staan om snel te kunnen functioneren, aangezien de runtime snel moet reageren, waren ongeveer 10-15 servers nodig.
Maar toen we de transacties aan de weergave wilden koppelen, werd het meteen minder leuk. Waarom? Het is duidelijk dat er 30 keer meer gebeurtenissen moeten worden opgeslagen. En dus zijn er ook 30 keer meer servers nodig. En dat blijkt een astronomisch cijfer te zijn. Tot 500 servers nodig hebben om koppelingen te maken, terwijl er in runtime aanzienlijk minder servers zijn, dat lijkt ons een onjuiste factor. Dus we gingen denken over wat we moesten doen.
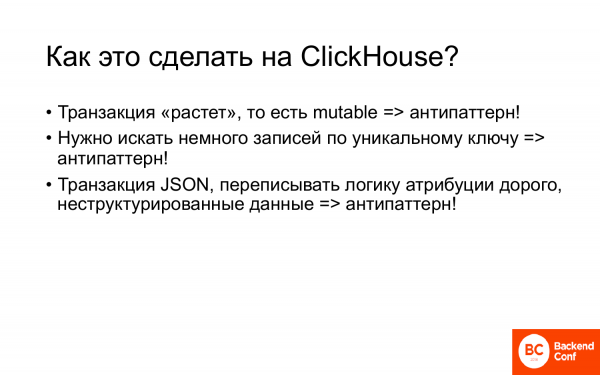
Toen kwamen we bij ClickHouse. Maar hoe doen we dat met ClickHouse? Op het eerste gezicht lijkt het een verzameling antipatterns te zijn.
- De transactie groeit, we koppelen er steeds nieuwe gebeurtenissen aan, d.w.z. het is mutabel, en ClickHouse functioneert niet goed met mutabele objecten.
- Wanneer een bezoeker bij ons komt, moeten we zijn transacties ophalen op basis van een sleutel, zijn visit id. Dit is ook een point query, wat gewoonlijk niet zo in ClickHouse gedaan wordt. Gewoonlijk worden er grote scanoperaties in ClickHouse uitgevoerd, maar hier moeten we enkele records ophalen. Dat is ook een antipattern.
- Bovendien was de transactie in json, maar we wilden niet herschrijven, dus wilden we json ongestructureerd opslaan en indien nodig eruit halen wat nodig was. Dit is ook een antipattern.
Dat is dus een verzameling antipatterns.
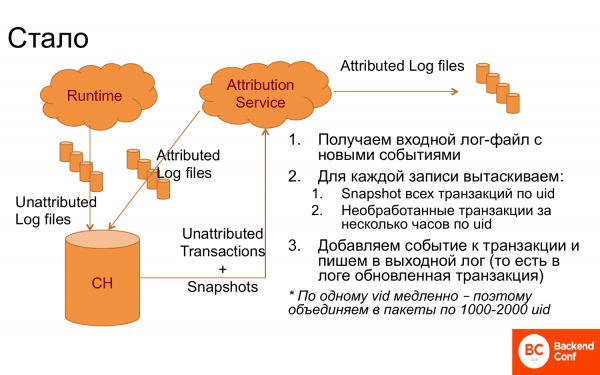
Toch is het gelukt om een systeem te maken dat zeer goed functioneerde.
Wat is er gedaan? ClickHouse werd geïntroduceerd, waarin de logs werden opgenomen, onderverdeeld in records. Er verscheen een attributed service die logs uit ClickHouse ontving. Daarna haalde het voor elke record op basis van visit id de transacties op, die mogelijk nog niet verwerkt waren en plus snapshots, dat wil zeggen, de transacties die al gekoppeld waren, namelijk het resultaat van het vorige werk. Hieruit werd de logica gevormd, de juiste transactie geselecteerd, nieuwe gebeurtenissen gekoppeld. Het werd opnieuw in de log geschreven. De log ging terug naar ClickHouse, dat is dus een continue cyclische systeem. Daarnaast werd het naar DWH gestuurd om daar te analyseren.
In deze vorm werkte het niet zo goed. Om het ClickHouse gemakkelijker te maken bij het uitvoeren van een verzoek op visit id, werden deze verzoeken gegroepeerd in blokken van 1.000-2.000 visit id's, en voor 1.000-2.000 mensen werden alle transacties opgehaald. Toen werkte alles.
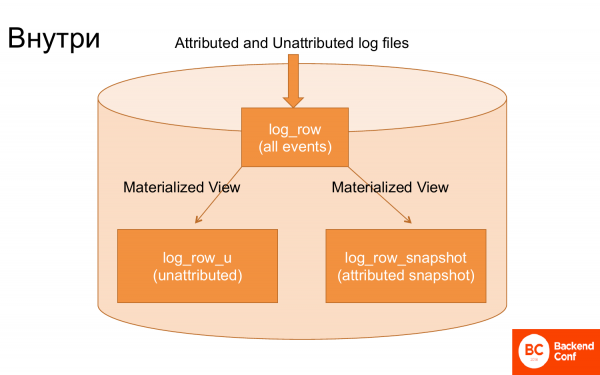
Als je naar binnen kijkt in ClickHouse, zijn er maar 3 hoofdtabellen die dit allemaal ondersteunen.
De eerste tabel waarin de logs worden geladen, wordt praktisch zonder verwerking geladen.
De tweede tabel. Via een materialized view werden uit deze logs de niet-attributed events gehaald, dat wil zeggen onbevoegde gebeurtenissen. En via een materialized view werden uit deze logs de transacties gehaald om een snapshot op te bouwen. Met andere woorden, een speciale materialized view bouwde het snapshot, namelijk de laatste accumulatie van de staat van de transacties.
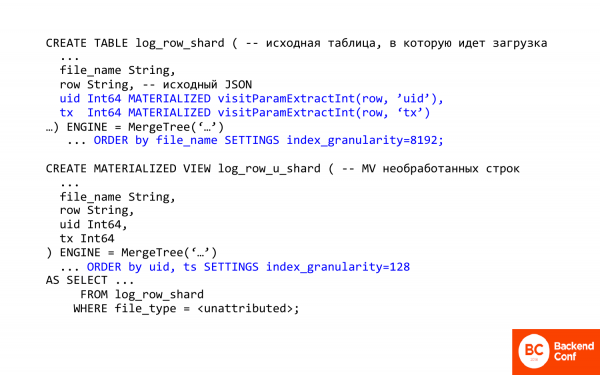
Hier is tekst geschreven in SQL. Ik wil graag een paar belangrijke dingen daarin toelichten.
Het eerste belangrijke punt is de mogelijkheid in ClickHouse om kolommen uit JSON te extraheren, dat wil zeggen dat ClickHouse enkele methoden heeft voor het werken met JSON. Ze zijn erg primitief.
visitParamExtractInt stelt in staat om attributen uit JSON te extraheren, dat wil zeggen, de eerste match wordt getriggerd. En zo kan je transaction id of visit id extraheren. Dit is één.
Ten tweede is hier gebruik gemaakt van een slimme materialized column. Wat betekent dit? Dit betekent dat je het niet in de tabel kunt invoegen, dat wil zeggen, het wordt niet ingevoegd, het wordt berekend en bij het invoegen opgeslagen. Bij het invoegen doet ClickHouse het werk voor je. En dan wordt er uit JSON gehaald wat je later nodig hebt.
In dit geval is de materialized view voor onbewerkte rijen. En de eerste tabel met vrijwel rauwe logs wordt gebruikt. Wat doet het? Allereerst verandert het de sortering, dat wil zeggen, de sortering gaat nu op visit id, omdat we snel de transactie van een specifieke persoon willen ophalen.
Het tweede belangrijke punt is de index_granularity. Als je MergeTree hebt gezien, staat de index_granularity meestal standaard op 8192. Wat is dat? Dit is een parameter voor de spaarzaamheid van de index. In ClickHouse is de index spaarzaam, hij indexeert nooit elke record. Hij doet dit elke 8192. Dit is goed als veel gegevens moeten worden geteld, maar slecht als het maar een beetje is, omdat er veel overhead is. En als je de index granulariteit verlaagt, verlaag je de overhead. Je kunt het niet tot één verlagen, omdat je dan mogelijk niet genoeg geheugen hebt. De index wordt altijd in geheugen opgeslagen.
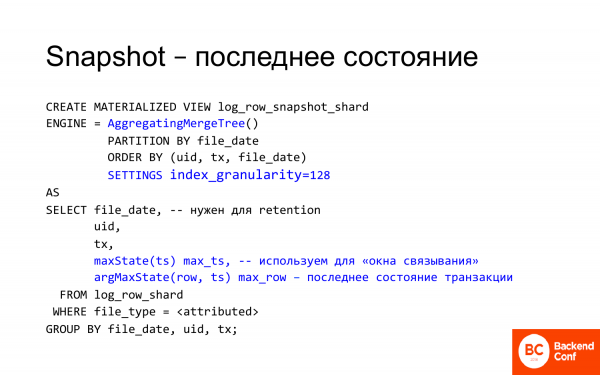
Een snapshot gebruikt nog enkele interessante functies van ClickHouse.
Ten eerste is er AggregatingMergeTree. In AggregatingMergeTree wordt argMax opgeslagen, dat wil zeggen, dit is de status van de transactie die overeenkomt met de laatste timestamp. Nieuwe transacties worden continu gegenereerd voor deze bezoeker. En in de meest recente status van deze transactie hebben we een evenement toegevoegd en kregen we een nieuwe status. Deze is opnieuw in ClickHouse opgenomen. En via argMax in deze gematerialiseerde weergave kunnen we altijd de actuele status verkrijgen.
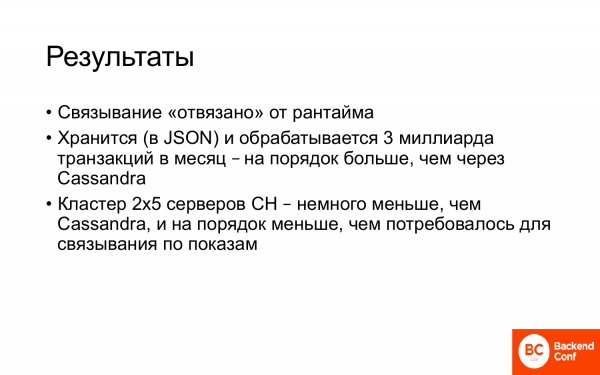
- De binding is 'ontkoppeld' van Runtime.
- Tot 3 miljard transacties per maand worden opgeslagen en verwerkt. Dit is een orde van grootte groter dan in Cassandra, dat wil zeggen, in een typische transactionele systeem.
- Cluster van 2x5 ClickHouse-servers. 5 servers waarbij elke server een replica heeft. Dit is zelfs minder dan in Cassandra om op klik gebaseerde attributie te maken, terwijl we hier impression gebaseerde attributie hebben. Dat wil zeggen, in plaats van het aantal servers met 30 keer te verhogen, konden ze worden verminderd.
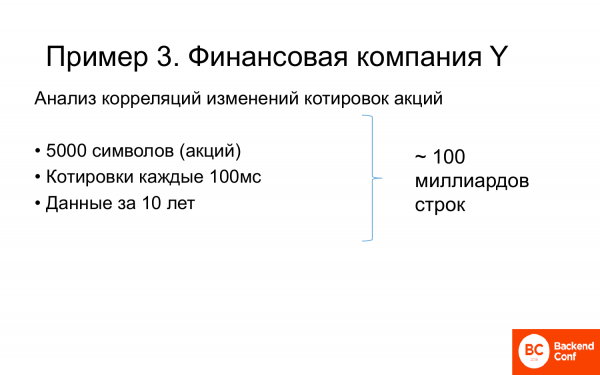
Een laatste voorbeeld is de financiële onderneming Y, die correlaties van wijzigingen in aandelenkoersen analyseerde.
En de uitdaging was als volgt:
- Er zijn ongeveer 5.000 aandelen.
- Koersen zijn elke 100 milliseconden bekend.
- Gegevens zijn over 10 jaar verzameld. Waarschijnlijk voor sommige bedrijven meer, voor andere minder.
- In totaal ongeveer 100 miljard regels.
En het moest de correlatie van veranderingen worden berekend.
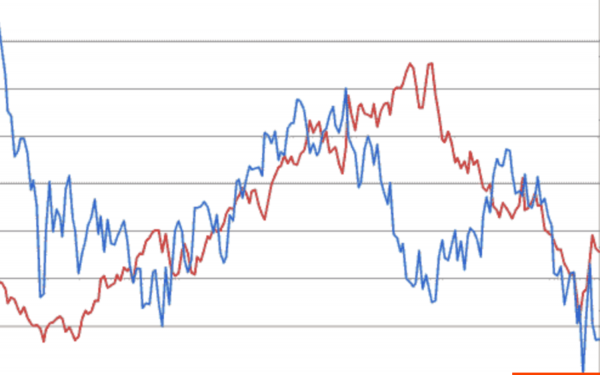
Hier zijn twee aandelen en hun koersen. Als de ene stijgt en de andere ook, dan is dat een positieve correlatie, dat wil zeggen, als de één groeit, groeit de andere. Als de ene stijgt, zoals aan het einde van de grafiek, en de andere daalt, dan is dat een negatieve correlatie, dat wil zeggen, wanneer de één groeit, valt de ander.
Door deze wederzijdse veranderingen te analyseren, kunnen voorspellingen op de financiële markt worden gedaan.
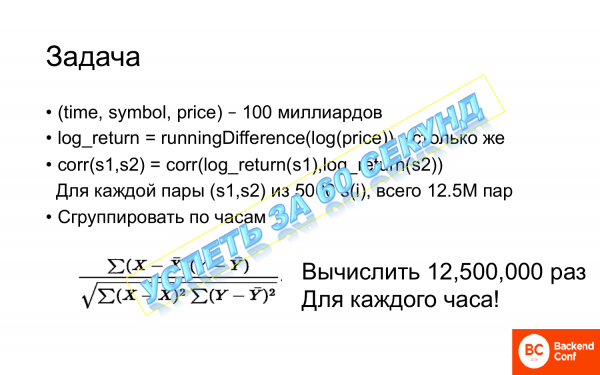
Maar de taak is moeilijk. Wat wordt er gedaan? We hebben 100 miljard records, waarin tijd, aandeel en prijs zijn opgenomen. We moeten eerst 100 miljard keer de runningDifference van het prijsalgoritme berekenen. RunningDifference is een functie in ClickHouse die het verschil tussen twee regels achtereenvolgens berekent.
Daarna moet de correlatie worden berekend, en de correlatie moet voor elk paar worden berekend. Voor 5.000 aandelen zijn er 12,5 miljoen paren. En dat is veel, dat wil zeggen, 12,5 keer moet zo'n correlatiefunctie worden berekend.
En mocht iemand vergeten zijn, dan zijn x en y het wiskundig gemiddelde van de steekproef. Dat betekent dat niet alleen de wortels en sommen moeten worden berekend, maar dat ook opnieuw sommen binnen die sommen moeten worden gemaakt. Er moeten heel veel berekeningen worden uitgevoerd, 12,5 miljoen keer, en dat nog eens gegroepeerd per uur. We hebben al heel wat uren. En we moeten het binnen 60 seconden voor elkaar hebben. Dit is een grap.
We moesten op de een of andere manier op tijd zijn, want het werkte allemaal heel, heel langzaam, voordat ClickHouse kwam.
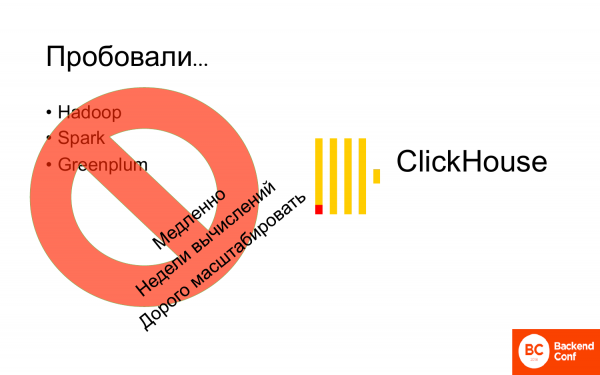
Ze hebben geprobeerd dit te berekenen op Hadoop, op Spark, op Greenplum. En het was allemaal heel traag of duur. Je kon het op een bepaalde manier berekenen, maar het was daarna duur.
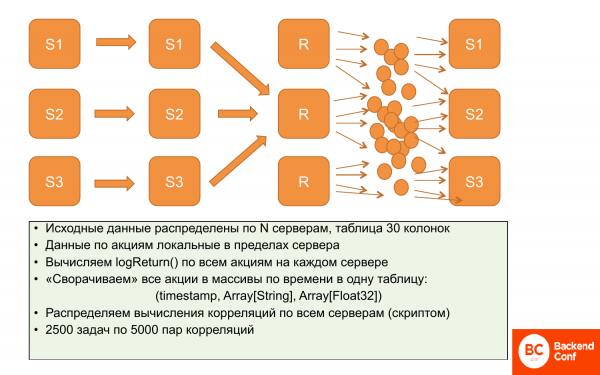
En toen kwam ClickHouse en alles werd veel beter.
Ter herinnering, we hebben een probleem met de lokaliteit van gegevens, daarom kunnen correlaties niet gelokaliseerd worden. We kunnen niet een deel van de gegevens op de ene server en een deel op de andere server stapelen en optellen, we moeten al onze gegevens overal hebben.
Wat hebben ze gedaan? Aanvankelijk zijn de gegevens gelokaliseerd. Op elke server zijn de gegevens opgeslagen volgens de prijsstelling van een bepaald aantal aandelen. En ze overlappen elkaar niet. Daarom kunnen we logReturn parallel en onafhankelijk berekenen, alles gebeurt terwijl het parallel en verdeeld is.
Vervolgens besloten ze deze gegevens te verkleinen, zonder expressiviteit te verliezen. Verminderen met behulp van arrays, dat wil zeggen, voor elk tijdssegment een array van aandelen en een array van prijzen maken. Op deze manier nemen de gegevens veel minder ruimte in. En het is iets gemakkelijker om ermee te werken. Dit zijn bijna parallelle operaties, dat wil zeggen, we berekenen deels parallel en schrijven het daarna naar de server.
Daarna kan dit gerepliceerd worden. De letter 'r' betekent dat we deze gegevens hebben gerepliceerd. Dat wil zeggen, we hebben op alle drie de servers dezelfde gegevens - deze arrays.
En met een speciaal script kunnen we uit deze set van 12,5 miljoen correlaties, die moeten worden berekend, pakketten maken. Dat wil zeggen, 2.500 taken van 5.000 paren correlaties. En deze taak berekenen op een specifieke ClickHouse-server. Hij heeft al zijn gegevens, want de gegevens zijn identiek en hij kan ze sequentieel berekenen.
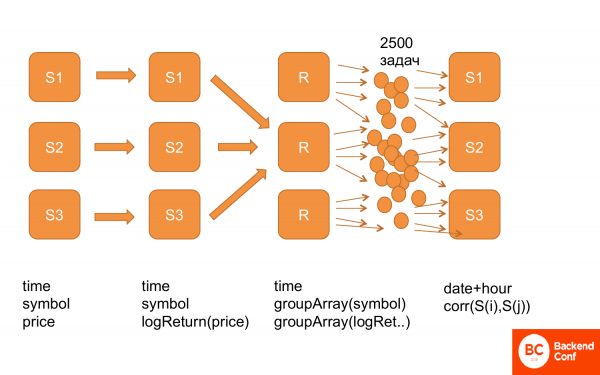
Nogmaals, hoe dit eruit ziet. Eerst hebben we alle gegevens in deze structuur: tijd, aandelen, prijs. Daarna hebben we logReturn berekend, oftewel de gegevens van dezelfde structuur, maar in plaats van de prijs hebben we logReturn. Vervolgens hebben we ze opnieuw ingericht, dus we hebben tijd en groupArray per aandelen en prijzen gekregen. We hebben ze samengevoegd. En daarna hebben we een heleboel taken gegenereerd en deze aan ClickHouse gevoed, zodat het deze kon verwerken. En dit werkt.
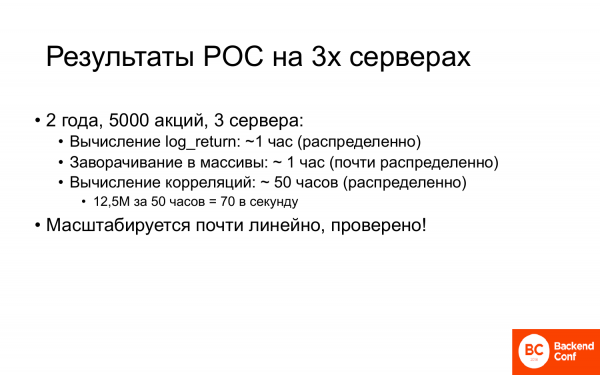
Bij het proof of concept was de taak een subtaak, oftewel we hebben minder gegevens genomen. En dat allemaal op drie servers.
De eerste twee fasen: het berekenen van Log_return en het in arrays wikkelen, duurden ongeveer een uur elk.
De berekening van de correlatie duurde ongeveer 50 uur. Maar 50 uur is weinig, want eerder duurde het weken. Dit was een groot succes. En als je het bekijkt, werd alles 70 keer per seconde op dit cluster berekend.
Maar het belangrijkste is dat dit systeem praktisch geen knelpunten heeft, oftewel het schaalt praktisch lineair. En dat hebben ze geverifieerd. Ze hebben het met succes opgeschaald.
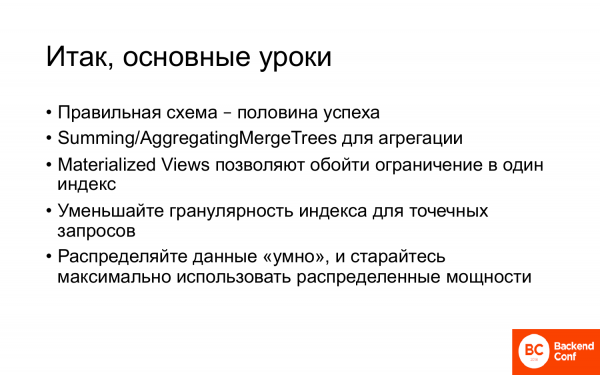
- Een goed schema is de helft van het succes. En een goed schema is het gebruik van alle nodige ClickHouse-technologieën.
- Summing/AggregatingMergeTrees zijn technologieën die het mogelijk maken om te aggregeren of een snapshot state als een speciaal geval te tellen. En dit vereenvoudigt veel dingen aanzienlijk.
- Materialized Views maken het mogelijk om de beperking van één index te omzeilen. Misschien heb ik dit niet erg duidelijk uitgelegd, maar toen we de logs laadden, waren de ruwe logs in een tabel met één index, terwijl de attributelogs in een tabel waren, dus dezelfde gegevens, maar gefilterd, maar met een totaal andere index. Het waren wel dezelfde gegevens, maar met een andere sortering. En Materialized Views maakt het mogelijk, als je dit nodig hebt, zo'n beperking van ClickHouse te omzeilen.
- Verklein de granulariteit van de index voor gerichte queries.
- En verdeel de gegevens slim, probeer de gegevens zo lokaal mogelijk binnen de server te houden. En zorg ervoor dat de queries ook die lokalisatie gebruiken waar mogelijk.
Samenvattend kan worden gezegd dat ClickHouse nu stevig terrein heeft ingenomen in zowel commerciële databases als open source databases, met name voor analytische doeleinden. Het past geweldig in dit landschap. Sterker nog, het begint langzaam andere systemen te verdringen, want met ClickHouse heb je InfiniDB niet meer nodig. Vertica is misschien binnenkort ook niet meer nodig, als ze goede SQL-ondersteuning bieden. Maak er gebruik van!
—Bedankt voor de presentatie! Erg interessant! Waren er enige vergelijkingen met Apache Phoenix?
- Nee, ik heb niet gehoord dat iemand dergelijke vergelijkingen heeft gemaakt. Wij bij Yandex proberen alle vergelijkingen van ClickHouse met verschillende databases bij te houden. Want als er iets ineens sneller blijkt te zijn dan ClickHouse, kan Alexey Milovidov 's nachts niet slapen en begint hij het snel te versnellen. Ik heb niet gehoord van een dergelijke vergelijking.
(Alexey Milovidov) Apache Phoenix is een SQL-engine op HBase. HBase is voornamelijk bedoeld voor key-value werkscenario's. In elke rij kan een willekeurig aantal kolommen met willekeurige namen zijn. Dit geldt voor systemen zoals HBase en Cassandra. Zware analytische queries zullen daar niet goed werken. Of je kunt denken dat ze goed werken, als je geen ervaring hebt met ClickHouse.
Dank
Goedemiddag! Ik ben al een tijdje erg geïnteresseerd in dit onderwerp, omdat ik een analytisch subsysteem heb. Maar als ik naar ClickHouse kijk, krijg ik de indruk dat ClickHouse heel goed geschikt is voor het analyseren van events, mutable. En als ik veel zakelijke gegevens met grote tabellen moet analyseren, is ClickHouse, zover ik begrijp, niet echt geschikt voor mij? Vooral als deze gegevens veranderen. Klopt dat of zijn er voorbeelden die het tegendeel bewijzen?
Dat klopt. En dat is de waarheid voor de meeste gespecialiseerde analytische databases. Ze zijn gericht op één of meerdere grote tabellen die veranderlijk zijn, en op veel kleine tabellen die langzaam veranderen. Dat wil zeggen, ClickHouse is niet zoals Oracle, waar je alles kunt opslaan en zeer complexe queries kunt bouwen. Om ClickHouse effectief te gebruiken, moet je het schema op een manier opbouwen die goed werkt in ClickHouse. Dat betekent dat je overmatige normalisatie moet vermijden, woordenboeken moet gebruiken, en probeert minder lange koppelingen te maken. Als je het schema op deze manier opbouwt, kunnen vergelijkbare zakelijke vraagstukken in ClickHouse veel efficiënter worden opgelost dan in een traditionele relationele database.
Dank u voor de presentatie! Ik heb een vraag over de laatste financiële case. Zij hadden analytics. Het moest worden vergeleken hoe ze omhoog en omlaag gingen. En ik begrijp dat u het systeem specifiek voor deze analyse heeft opgebouwd? Als ze morgen bijvoorbeeld een ander rapport over deze gegevens nodig hebben, moeten ze dan opnieuw het schema opbouwen en de gegevens laden? Dat wil zeggen, moet er enige preprocessing plaatsvinden om de query te krijgen?
Natuurlijk, dit is het gebruik van ClickHouse voor een heel specifieke taak. Deze zou traditioneel binnen Hadoop zijn opgelost. Voor Hadoop is dit een ideale taak. Maar het is heel langzaam op Hadoop. Mijn doel is om te demonstreren dat je met ClickHouse taken kunt oplossen die normaal gesproken met heel andere middelen worden opgelost, maar dit veel efficiënter kunt doen. Dit is gericht op een specifieke taak. Het is duidelijk dat als er een vergelijkbare taak is, deze op een vergelijkbare manier kan worden opgelost.
Ik begrijp het. U zei dat het 50 uur heeft geduurd om te verwerken. Is dat vanaf het begin, toen de gegevens werden geladen of toen de resultaten werden ontvangen?
Ja- ja.
Goed, heel erg bedankt.
Dit is op een cluster met 3 servers.
Hallo! Dank u voor de presentatie! Het is allemaal heel interessant. Ik wil iets vragen niet over de functionaliteit, maar over het gebruik van ClickHouse vanuit het oogpunt van stabiliteit. Zijn er situaties geweest dat u moest herstellen? Hoe gedraagt ClickHouse zich in dat geval? En is het ooit gebeurd dat uw replica ook uitviel? Wij hebben bijvoorbeeld met ClickHouse het probleem gehad dat het toch zijn limiet overschrijdt en crasht.
Natuurlijk bestaan er geen perfecte systemen. Ook ClickHouse heeft zijn eigen problemen. Maar heeft u ooit gehoord dat Yandex.Metrica lange tijd niet werkte? Waarschijnlijk niet. Het werkt al sinds 2012-2013 betrouwbaar met ClickHouse. Ook over mijn ervaring kan ik zeggen dat we nooit te maken hebben gehad met volledige uitval. Enkele gedeeltelijke problemen konden zich voordoen, maar ze waren nooit kritisch genoeg om een ernstige impact op het bedrijf te hebben. Dat is nooit voorgekomen. ClickHouse is behoorlijk betrouwbaar en valt niet zomaar uit. Daar hoeft u zich geen zorgen over te maken. Het is geen onvoltooid product. Dit is bewezen door vele bedrijven.
Hallo! U zei dat het belangrijk is om meteen goed over het datamodel na te denken. Maar als dat niet is gebeurd? Mijn gegevens stromen maar door. Na een half jaar realiseer ik me dat dit zo niet kan, ik moet de gegevens opnieuw uploaden en er iets mee doen.
Dat hangt natuurlijk af van uw systeem. Er zijn verschillende manieren om dit vrijwel zonder onderbrekingen te doen. U kunt bijvoorbeeld een Materialized View maken met een andere datastructuur, als deze eenduidig kan worden gemapt. Dat wil zeggen, als het mogelijk is om mapping te maken via ClickHouse, zoals het extraheren van bepaalde zaken, het veranderen van de primaire sleutel en het wijzigen van de partitie, dan kunt u een Materialized View maken. Daarin kunt u uw oude gegevens herschrijven, terwijl de nieuwe gegevens automatisch worden opgeslagen. Vervolgens schakelt u gewoon over naar het gebruik van de Materialized View, schakelt u de opslag om en verwijdert u de oude tabel. Dit is een manier zonder onderbrekingen.
We wachten op je in onze
Bron: habr.com
