

Het primaire doel van Patroni is het waarborgen van hoge beschikbaarheid voor PostgreSQL. Maar Patroni is slechts een sjabloon en geen kant-en-klaar hulpmiddel (wat ook in de documentatie staat vermeld). Bij een eerste blik, wanneer je Patroni in een testomgeving instelt, kun je zien hoe geweldig dit hulpmiddel is en hoe het onze pogingen om de cluster te laten falen, moeiteloos afhandelt. In de praktijk verloopt echter niet altijd alles zo mooi en elegant als in de testomgeving.
Laat ik iets over mezelf vertellen. Ik begon als systeembeheerder. Ik heb gewerkt in webontwikkeling. Sinds 2014 werk ik bij Data Egret. Het bedrijf houdt zich bezig met adviesdiensten op het gebied van Postgres. We bedienen specifiek Postgres en werken elke dag met Postgres, dus we hebben verschillende expertise met betrekking tot het gebruik.
Aan het einde van 2018 begonnen we langzaam Patroni te gebruiken. We hebben een zekere ervaring opgebouwd. We hebben het op een bepaalde manier gediagnosticeerd, geoptimaliseerd en zijn tot onze best practices gekomen. In deze presentatie zal ik hierover vertellen.
Naast Postgres hou ik van Linux. Ik vind het leuk om ermee te rommelen en het te verkennen, en ik verzamel graag kernels. Ik ben geïnteresseerd in virtualisatie, containers, Docker en Kubernetes. Dit interesseert me omdat oude beheerdersgewoonten me beïnvloeden. Ik hou ervan om me bezig te houden met monitoring. En ik geniet van de Postgres-dingen die met beheer te maken hebben, zoals replicatie en back-up. In mijn vrije tijd programmeer ik in Go. Ik ben geen software engineer, ik programmeer gewoon voor mezelf in Go. En dat vind ik leuk.
- Ik denk dat velen van jullie weten dat Postgres geen HA (Hoge Beschikbaarheid) uit de doos heeft. Om HA te krijgen, moet je iets installeren, configureren, inspanningen doen en het bereiken.
- Er zijn verschillende hulpmiddelen en Patroni is er een van die HA op een behoorlijk goede manier oplost. Maar als we dit alles in een testomgeving instellen en het uitvoeren, kunnen we zien dat alles werkt, kunnen we bepaalde problemen reproduceren en kijken hoe Patroni deze afhandelt. En we zullen zien dat alles prima functioneert.
- Maar in de praktijk zijn we tegen verschillende problemen aangelopen. Over deze problemen zal ik vertellen.
- Ik zal uitleggen hoe we dit diagnosticeerden, wat we hebben aangepast - of het ons heeft geholpen of niet.
- Ik ga niet uitleggen hoe je Patroni installeert, want je kunt het op internet vinden, of de configuratiebestanden bekijken om te begrijpen hoe het allemaal werkt en ingesteld wordt. Je kunt de schema's en architecturen begrijpen door daar informatie over op internet te zoeken.
- Ik zal niet vertellen over de ervaringen van anderen. Ik zal alleen de problemen bespreken waarmee wij zelf te maken hebben gehad.
- En ik zal niet praten over problemen die buiten Patroni en PostgreSQL vallen. Als er bijvoorbeeld problemen waren met de load balancing die ons cluster deden instorten, daar zal ik niet over vertellen.
En een kleine disclaimer voordat we beginnen met onze presentatie.
Al deze problemen waarmee we te maken hadden, deden zich voor in de eerste 6-7-8 maanden van onze exploitatie. In de loop van de tijd hebben we onze eigen interne best practices ontwikkeld. En de problemen zijn verdwenen. Daarom werd de presentatie ongeveer zes maanden geleden aangekondigd, toen alles nog vers in mijn geheugen was en ik het me goed herinnerde.
Tijdens de voorbereiding van de presentatie heb ik oude postmortems doorgenomen en naar logs gekeken. En sommige details kunnen vergeten zijn of niet volledig onderzocht tijdens het analyseren van de problemen, dus in sommige gevallen kan het lijken alsof de problemen niet volledig zijn behandeld, of dat er een gebrek aan informatie is. En daarom bied ik mijn excuses aan voor dit punt.
Wat is Patroni?
- Het is een sjabloon voor het opbouwen van HA. Zo staat het in de documentatie. En vanuit mijn perspectief is dat een heel juiste opmerking. Patroni is geen zilveren kogel die al je problemen oplost, dat wil zeggen dat je moeite moet doen om het aan de praat te krijgen en het nuttig te laten zijn.
- Het is een agendadienst die op elke service met een database is geïnstalleerd, en die een soort init-systeem voor je Postgres is. Het start Postgres, stopt het, herstart het, wijzigt de configuratie en verandert de topologie van je cluster.
- Om de status van het cluster op te slaan, de huidige weergave van hoe het eruit ziet, heb je een opslag nodig. En vanuit dat perspectief is Patroni de weg ingeslagen van het opslaan van de staat in een extern systeem. Dit is een systeem voor gedistribueerde configuratieopslag. Dit kunnen Etcd, Consul, ZooKeeper of Kubernetes' Etcd zijn, dat wil zeggen een van deze opties.
- Een van de kenmerken van Patroni is dat je de auto-failover direct out-of-the-box kunt gebruiken, zodra je het hebt ingesteld. Ter vergelijking, bij Repmgr komt de failover als een onderdeel. Met Repmgr krijgen we switchover, maar als we auto-failover willen, moet dat extra worden ingesteld. Bij Patroni is de auto-failover al standaard aanwezig.
- Er zijn nog veel andere zaken. Bijvoorbeeld het beheren van configuraties, het toevoegen van nieuwe replicas, back-ups, enzovoort. Maar dat valt buiten dit verslag, daarover ga ik niet vertellen.
Een kleine samenvatting is dat de belangrijkste taak van Patroni is om op een goede en betrouwbare manier auto-failover te realiseren, zodat ons cluster operationeel blijft en de applicatie geen veranderingen in de cluster-topologie opmerkt.
Maar wanneer we Patroni gaan gebruiken, wordt ons systeem iets complexer. Waar we voorheen Postgres hadden, krijgen we nu Patroni zelf, en we krijgen DCS waar de status wordt opgeslagen. Dit moet allemaal op een of andere manier werken. Dus, wat kan er misgaan?
Wat kan er misgaan:
- Postgres kan uitvallen. Dit kan de master of de replica zijn; een van deze kan defect raken.
- Patroni zelf kan ook falen.
- DCS kan falen, waar de status wordt opgeslagen.
- En het netwerk kan falen.
Al deze punten zal ik in mijn presentatie behandelen.
Ik zal de gevallen bekijken naarmate ze complexer worden, niet vanuit het perspectief dat de case veel componenten raakt, maar vanuit subjectieve ervaringen: welke cases voor mij uitdagend waren, moeilijk om te analyseren… en omgekeerd, welke cases makkelijk waren en eenvoudig te analyseren.
De eerste case is de eenvoudigste. Dit is de situatie waarin we een databasecluster hebben genomen en op datzelfde cluster onze DCS-opslag hebben uitgerold. Dit is de meest voorkomende fout. Het is een architecturale fout, d.w.z. het combineren van verschillende componenten op één plek.
Dus, er is een failover gebeurd, laten we onderzoeken wat er is gebeurd.
Hier zijn we geïnteresseerd in het moment waarop de failover plaatsvond. Dit is het moment in de tijd waarop de toestand van het cluster veranderde.
Maar de failover is niet altijd onmiddellijk; het neemt niet altijd een bepaalde tijd in beslag, het kan zich uitstrekken over een langere periode.
Daarom heeft het een start- en eindtijd, dat wil zeggen, dit is een doorlopend evenement. We verdelen alle evenementen in drie intervallen: we hebben tijd vóór de failover, tijdens de failover en na de failover. Dat wil zeggen, we beschouwen alle evenementen op deze tijdlijn.
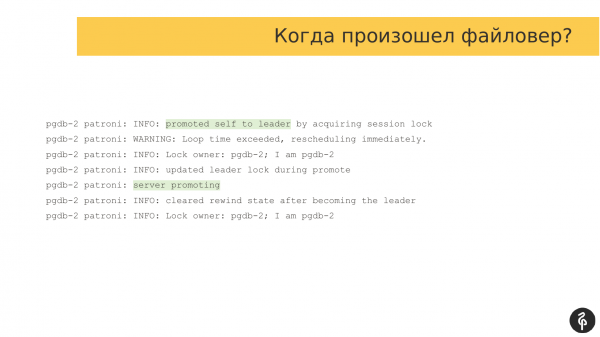
En het eerste wat we doen als de failover heeft plaatsgevonden, is de oorzaak onderzoeken van wat er is gebeurd, wat de oorzaak was van de failover.
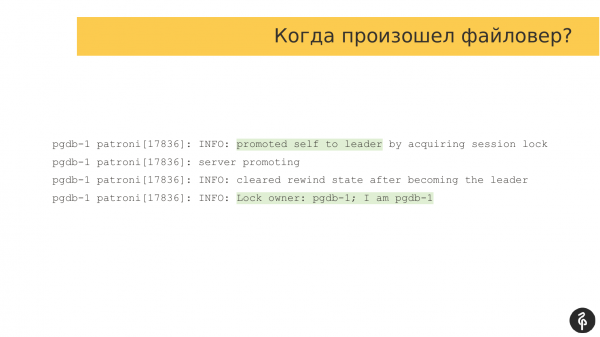
Als we naar de logs kijken, zijn dit de klassieke Patroni-logs. Hierin geeft het aan dat de server master is geworden, en de rol van master is naar deze node overgedragen. Dit is hier gemarkeerd.
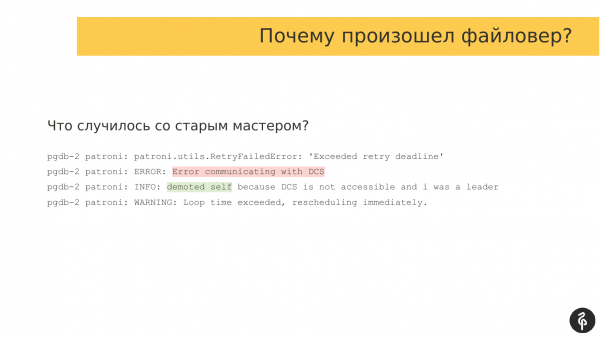
Vervolgens moeten we begrijpen waarom de failover heeft plaatsgevonden, dat wil zeggen, welke gebeurtenissen hebben ertoe geleid dat de rol van master van de ene node naar de andere is verhuisd. In dit geval is het heel eenvoudig. We hebben een fout in de interactie met het opslag systeem. De master begreep dat hij niet met de DCS kon werken, dat wil zeggen, er is een probleem ontstaan met de interactie. En hij zegt dat hij niet langer master kan zijn en geeft zijn macht op. Deze regel 'demoted self' spreekt precies hierover.
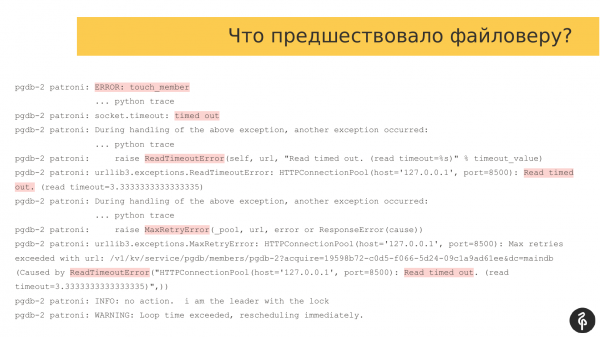
Als we kijken naar de gebeurtenissen die de failover hebben voorafgegaan, dan kunnen we de factoren zien die problemen veroorzaakten voor het blijven functioneren van de master.
Als we naar de Patroni-logs kijken, zien we dat er veel verschillende fouten en time-outs zijn, dat wil zeggen, de Patroni-agent kan niet met de DCS werken. In dit geval is het de Consul-agent waarmee communicatie plaatsvindt via poort 8500.
En het probleem hier is dat Patroni en de database op dezelfde host draaien. En op deze node draaide ook de Consul-servers. Door de belasting op de server hebben we ook problemen gecreëerd voor servers Consul. Ze konden niet normaal communiceren.
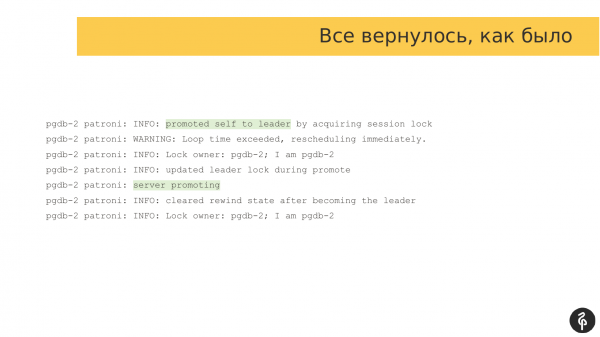
Na enige tijd, toen de belasting was afgenomen, kon onze Patroni weer communiceren met de agents. De normale werking werd hervat. En dezelfde server Pgdb-2 werd opnieuw master. Dat wil zeggen, er was een kleine flip, waardoor de node zijn master bevoegdheden opgaf, en later opnieuw aannam, dat wil zeggen, alles keerde terug zoals het was.
En dit kan worden beschouwd als een valse activering, of het kan worden opgevat dat Patroni alles correct deed. Dat wil zeggen, hij begreep dat hij de status van het cluster niet kon handhaven en gaf zijn bevoegdheden op.
En hier is het probleem ontstaan omdat de Consul-servers op dezelfde hardware draaien als de databases. Dienovereenkomstig heeft elke belasting, of het nu gaat om schijf- of CPU-belasting, ook invloed op de interactie met het Consul-cluster.
We hebben besloten dat dit niet samen moet bestaan, we hebben een apart cluster voor Consul toegewezen. En Patroni werkte met een aparte Consul, dat wil zeggen er was een apart Postgres-cluster en een apart Consul-cluster. Dit is de basisinstructie over hoe je al deze zaken moet scheiden en beheren zodat ze niet samenleven.
Als optie kun je de parameters ttl, loop_wait, retry_timeout aanpassen, dat wil zeggen proberen deze parameters te verhogen om deze kortdurende pieken in de belasting door te komen. Maar dit is niet de beste optie, omdat deze belasting ook langdurig kan zijn. En dan overschrijden we gewoon de limieten van deze parameters. Dit kan niet echt helpen.
Het eerste probleem, zoals je begrijpt, is eenvoudig. We hebben DCS samen met de database geplaatst, wat leidde tot een probleem.
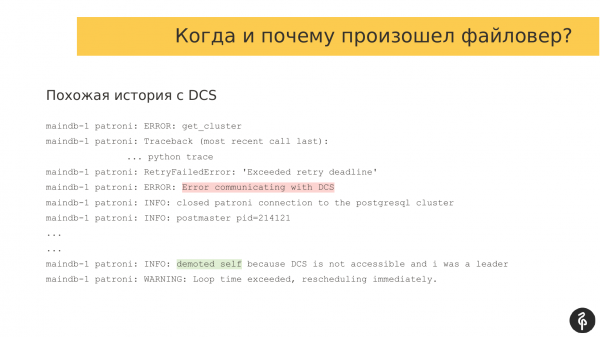
Het tweede probleem lijkt op de eerste. Het is vergelijkbaar omdat we opnieuw problemen hebben met de interactie met het DCS-systeem.
Als we naar de logs kijken, zien we opnieuw een communicatie-fout. En Patroni zegt dat hij niet kan communiceren met DCS, waardoor de huidige master in replica-modus gaat.
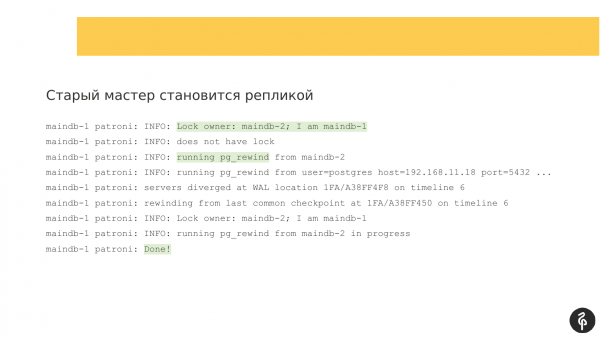
De oude master wordt een replica, hier werkt Patroni zoals het hoort. Hij start pg_rewind om het transactie-log terug te draaien en zich vervolgens aan te sluiten bij de nieuwe master en de nieuwe master in te halen. Hier werkt Patroni zoals het hoort.
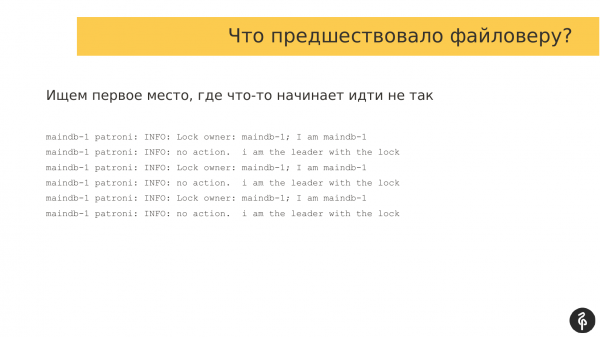
Hier moeten we de plek vinden die voorafging aan de file error, dat wil zeggen de fouten die de oorzaak waren van de file error. In dit opzicht is het werken met de logs van Patroni behoorlijk handig. Hij schrijft op geregelde tijdstippen dezelfde berichten. En als we de logs snel doorlopen, zien we dat de logs zijn veranderd, wat betekent dat er problemen zijn begonnen. We keren snel terug naar dit punt en kijken wat er aan de hand is.
In een normale situatie zien de logs er ongeveer zo uit. De eigenaar van de lock wordt gecontroleerd. En als de eigenaar bijvoorbeeld is veranderd, kunnen er bepaalde gebeurtenissen optreden waar Patroni op moet reageren. Maar in dit geval is alles in orde. We zoeken naar het punt waar de fouten zijn begonnen.
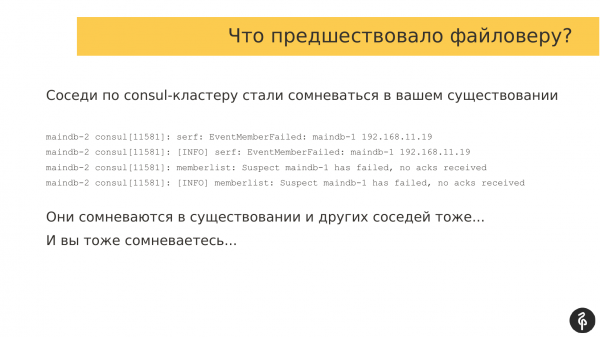
En wanneer we terugscrollen naar het punt waar de fouten begonnen te verschijnen, zien we dat er een auto-failover heeft plaatsgevonden. Aangezien onze fouten verband hielden met de interactie met DCS en we in ons geval Consul gebruikten, bekijken we ook de logs van Consul om te zien wat daar is gebeurd.
Door de tijd van de failover en de tijd in de logs van Consul ongeveer op elkaar af te stemmen, zien we dat onze buren in het Consul-cluster begonnen te twijfelen aan het bestaan van andere deelnemers in het Consul-cluster.
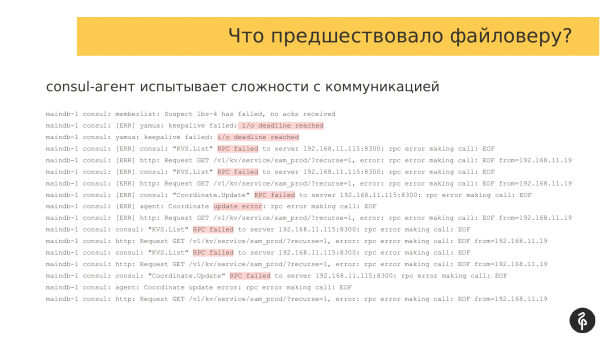
Als we ook de logs van andere Consul-agenten bekijken, blijkt daar ook dat er een netwerkstoring plaatsvindt. En alle deelnemers in het Consul-cluster twijfelen aan elkaars bestaan. Dit heeft geleid tot de failover.
Als we kijken naar wat er voor deze fouten is gebeurd, zien we verschillende soorten fouten, zoals deadline en RPC failed, dat wil zeggen, er is duidelijk een probleem bij de interactie tussen de deelnemers van het Consul-cluster.
Het eenvoudigste antwoord is: repareer het netwerk. Maar vanaf de spreekstoel klinkt dat gemakkelijk. De omstandigheden zijn echter zodanig dat de klant niet altijd kan veroorloven het netwerk te repareren. Hij kan in een datacenter zijn en misschien niet in staat zijn om het netwerk te repareren of invloed uit te oefenen op de apparatuur. Daarom zijn er andere opties nodig.
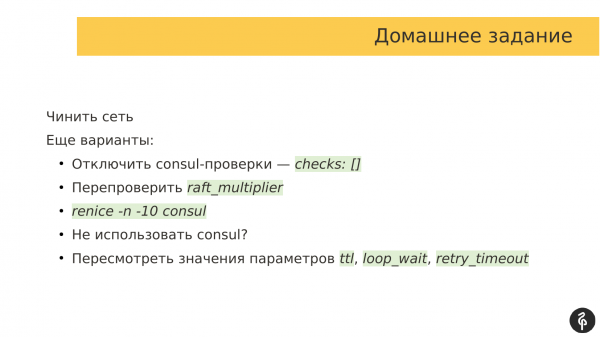
Er zijn opties:
- De eenvoudigste optie, die volgens mij zelfs in de documentatie staat, is om de Consul-controles uit te schakelen, dat wil zeggen simpelweg een lege array door te geven. En we vertellen de Consul-agent om geen controles te gebruiken. Door deze controles kunnen we deze netwerkstoringen negeren en geen failover initiëren.
- Een andere optie is om de raft_multiplier opnieuw te controleren. Dit is een parameter van de Consul-server zelf. Standaard is deze ingesteld op 5. Deze waarde wordt in de documentatie aanbevolen voor staging-omgevingen. In wezen beïnvloedt dit de frequentie van berichtenuitwisseling tussen de deelnemers van het Consul-netwerk. Deze parameter beïnvloedt dus de snelheid van de communicatie tussen de deelnemers in het Consul-cluster. Voor productieomgevingen wordt aanbevolen om deze te verlagen, zodat de knooppunten vaker berichten uitwisselen.
- Een andere optie die we zijn gaan gebruiken, is het verhogen van de prioriteit van Consul-processen ten opzichte van andere processen voor de procesplanner van het besturingssysteem. Er is zo'n parameter genaamd 'nice', die precies de prioriteit van processen definieert die door de OS-planner wordt meegenomen. We hebben de nice-waarde voor de Consul-agenten verlaagd, d.w.z. de prioriteit verhoogd, zodat het besturingssysteem meer tijd geeft aan de Consul-processen om hun code uit te voeren. In ons geval loste dit ons probleem op.
- Een andere optie is om Consul niet te gebruiken. Ik heb een vriend die een groot voorstander is van Etcd. We discussiëren regelmatig over wat beter is, Etcd of Consul. Maar wat betreft de vraag wat beter is, komen we vaak tot de conclusie dat Consul een agent heeft die op elke knoop met een database moet worden uitgevoerd. D.w.z. de interactie van Patroni met het Consul-cluster gaat via deze agent. En deze agent kan een knelpunt worden. Als er iets met de agent gebeurt, kan Patroni niet meer met het Consul-cluster werken. En dat vormt een probleem. In het geval van Etcd is er geen agent. Patroni kan direct werken met de lijst van Etcd-servers en daarmee communiceren. In dit opzicht, als je binnen je bedrijf Etcd gebruikt, zal Etcd waarschijnlijk een betere keuze zijn dan Consul. Maar bij onze klanten zijn we altijd beperkt door wat de klant heeft gekozen en gebruikt. En de meeste van onze klanten gebruiken Consul.
- En het laatste punt is om de parameterwaarden te herzien. We kunnen deze parameters verhogen in de hoop dat onze korte netwerproblemen kort zullen zijn en niet buiten het bereik van deze parameters vallen. Zo kunnen we de agressiviteit van Patroni verminderen bij het uitvoeren van automatische failsafes als er netwerproblemen optreden.
Ik denk dat velen die Patroni gebruiken bekend zijn met dit commando.
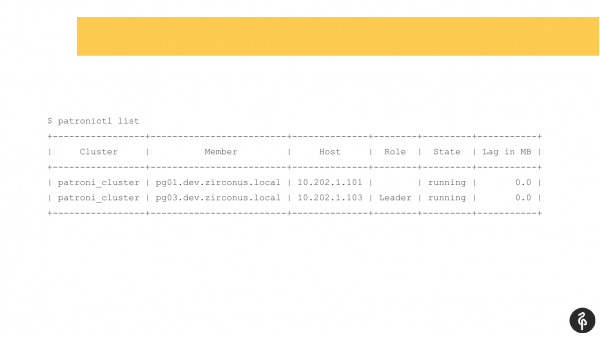
Dit commando toont de huidige status van het cluster. En op het eerste gezicht kan dit beeld normaal lijken. We hebben een master, we hebben een replica, er is geen reproductietraagheid. Maar dit beeld is normaal zolang we niet weten dat er drie knopen in dit cluster moeten zijn, en niet twee.
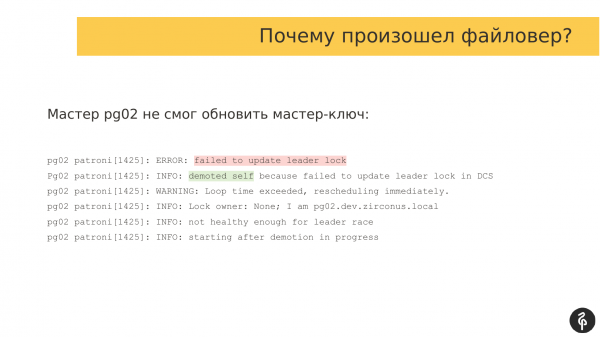
Dus er heeft zich automatisch failover voorgedaan. En na deze automatische failover hebben we een replica verloren. We moeten uitzoeken waarom deze is verdwenen en deze terughalen, herstellen. We gaan opnieuw de logs in en kijken waarom we een automatische failover hebben gehad.
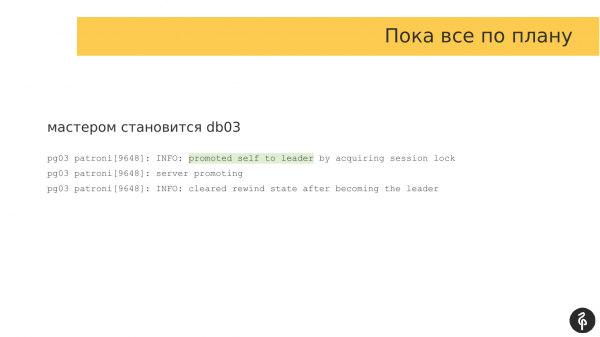
In dit geval is de tweede replica de master geworden. Hier is alles in orde.
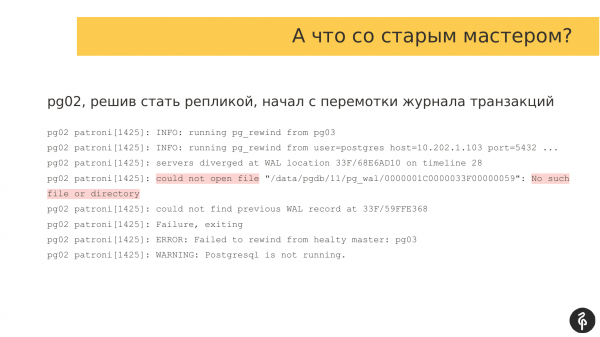
We moeten nu naar de replica kijken die is uitgevallen en die niet in het cluster zit. We openen de Patroni-logs en zien dat er een probleem is opgetreden tijdens het verbinden met het cluster op de pg_rewind-stap. Om verbinding te maken met het cluster moet het transactie-log worden teruggedraaid, de benodigde transactie-log van de master worden opgevraagd en op basis daarvan de master worden ingehaald.
In dit geval hebben we geen transactie-log en kan de replica niet opstarten. Dus stoppen we Postgres met een foutmelding. Vandaar dat het niet in het cluster zit.
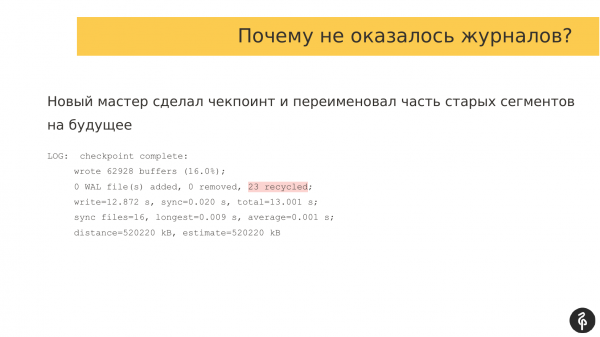
We moeten begrijpen waarom het er niet in het cluster is en waarom er geen logs zijn. We gaan naar de nieuwe master en kijken wat er in de logs staat. Het blijkt dat toen pg_rewind werd uitgevoerd, er een checkpoint is opgetreden. En een deel van de oude transactie-logs is eenvoudigweg hernoemd. Toen de oude master probeerde verbinding te maken met de nieuwe master en deze logs opvroeg, waren ze al hernoemd; ze waren gewoon niet beschikbaar.
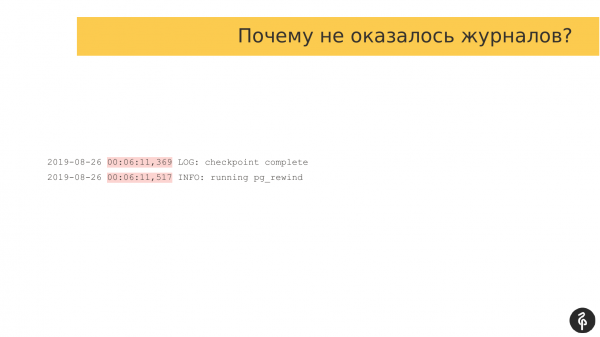
Ik heb de timestamps vergeleken toen deze gebeurtenissen plaatsvonden. En daar is het verschil slechts 150 milliseconden, dat wil zeggen, de checkpoint werd binnen 369 milliseconden voltooid, de WAL-segmenten werden hernoemd. En letterlijk na 517 milliseconden, na 150 milliseconden, begon de rewind op de oude replica. Met andere woorden, we hadden letterlijk 150 milliseconden genoeg om ervoor te zorgen dat de replica zich niet kon verbinden en operationeel kon worden.
De duurste en meest uitgebreide oplossing is Redis-Enterprise. Dit is een kant-en-klaar oplossing met volledige technische ondersteuning. Hoewel het technisch gezien ideaal lijkt, kwam het om ideologische redenen niet voor ons in aanmerking.
We hebben aanvankelijk replicatieslots gebruikt. We dachten dat dit goed zou zijn. Hoewel we in de beginfase de slots uitschakelden. We dachten dat als de slots veel WAL-segmenten zouden accumuleren, we de master zouden kunnen laten crashen. Die zou crashen. We hebben een tijdje zonder slots geworsteld. En we realiseerden ons dat we slots nodig hadden, dus hebben we de slots teruggebracht.
Maar hier is een probleem: wanneer de master overschakelt naar de replica, verwijdert hij de slots en daarmee ook de WAL-segmenten. Om dit probleem te voorkomen, besloten we de parameter wal_keep_segments te verhogen. Deze is standaard 8 segmenten. We hebben deze verhoogd naar 1.000 en gekeken hoeveel vrije ruimte we hadden. We hebben 16 gigabyte aan wal_keep_segments beschikbaar gemaakt. Dat wil zeggen, bij de overschakeling hebben we altijd op alle knooppunten een reserve van 16 gigabyte transactieprotocollen.
En bovendien is dit ook relevant voor langdurige onderhoudstaken. Stel dat we een van de replica's moeten bijwerken. We willen deze uitschakelen. We moeten de software bijwerken, misschien het besturingssysteem of iets anders. En wanneer we de replica uitschakelen, wordt er ook een slot voor deze replica verwijderd. En als we een kleine wal_keep_segments gebruiken, zullen de transactieprotocollen verloren gaan bij langdurige afwezigheid van de replica. We starten de replica opnieuw op, zij vraagt naar de transactieprotocollen waar zij is gestopt, maar op de master zijn deze misschien niet meer aanwezig. En de replica kan ook niet aansluiten. Daarom houden we een grote reserve van protocollen aan.
We hebben een productie-database. Daar draaien al projecten.
Er is een failover opgetreden. We hebben gekeken en alles is in orde, de replica's zijn aanwezig, er is geen replicatietraagheid. Er zijn ook geen fouten in de protocollen, alles is in orde.
Het productteam zegt dat er blijkbaar enkele gegevens zouden moeten zijn, maar we zien ze in één bron, terwijl we ze niet in de database zien. We moeten begrijpen wat er met hen is gebeurd.
Het is duidelijk dat pg_rewind ze heeft overschreven. We begrepen dat meteen, maar gingen kijken wat er was gebeurd.
In de logs kunnen we altijd vinden wanneer de failover heeft plaatsgevonden, wie de master werd en we kunnen bepalen wie de oude master was en wanneer hij een replica wilde worden. We hebben deze logs nodig om het volume van de verloren transactieprotocollen vast te stellen.
Onze oude master is opnieuw opgestart. En in de opstartconfiguratie stond Patroni vermeld. Patroni startte op. Direct daarna startte hij PostgreSQL. Precies vóór de start van PostgreSQL en voordat hij het als replica maakte, startte Patroni het pg_rewind-proces. Dienovereenkomstig overschreef hij een deel van de transactieprotocollen, downloadde nieuwe en verbond zich. Hier heeft Patroni uitstekend gewerkt, zoals het hoort. Ons cluster is hersteld. We hadden 3 knooppunten, na de failover zijn er 3 knooppunten – alles is geweldig.
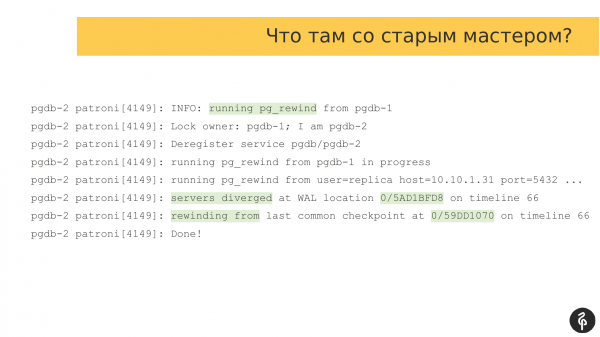
We hebben een deel van de gegevens verloren. We moeten begrijpen hoeveel we verloren zijn. We zijn op zoek naar het moment waarop de rewind plaatsvond. We kunnen dit vinden aan de hand van de logboekvermeldingen. De rewind is gestart, heeft iets gedaan en is afgelopen.
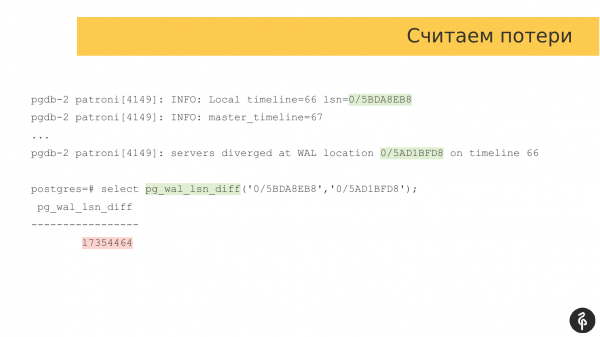
We moeten die positie in het transactie logboek vinden waar de oude master is gestopt. In dit geval is dat dit punt. En we hebben een tweede punt nodig, dat wil zeggen de afstand waar de oude master van de nieuwe afwijkt.
We nemen de gebruikelijke pg_wal_lsn_diff en vergelijken deze twee punten. In dit geval krijgen we 17 megabyte. Of dit veel of weinig is, moet iedereen voor zichzelf bepalen. Want voor de één is 17 megabyte weinig, voor de ander is het veel en onacceptabel. Dit moet elke persoon individueel beoordelen in overeenstemming met de zakelijke behoeften.
Maar wat hebben we voor onszelf vastgesteld?
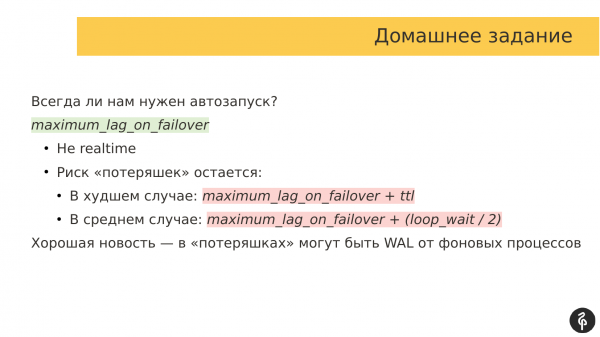
Ten eerste moeten we voor onszelf beslissen: hebben we altijd autostart van Patroni nodig na een systeemherstart? Vaak is het zo dat we de oude master moeten benaderen, moeten bekijken hoe ver hij is gegaan. Misschien moeten we de segmenten van het transactie logboek inspecteren en kijken wat daar is. En begrijpen of we deze gegevens kunnen verliezen of dat we de oude master in standalone-modus moeten opstarten om deze gegevens te verkrijgen.
En pas daarna moeten we beslissen of we deze gegevens kunnen laten vallen of dat we ze kunnen herstellen, door deze node als replica in ons cluster op te nemen.
Bovendien is er de parameter 'maximum_lag_on_failover'. Standaard, als ik het goed heb, heeft deze parameter een waarde van 1 megabyte.
Hoe werkt dit? Als onze replica 1 megabyte gegevens achterloopt door replicatie-lag, neemt deze replica niet deel aan de verkiezingen. En als er een failover plaatsvindt, kijkt Patroni welke replicas achterlopen. Als ze veel transactie logboeken achterlopen, kunnen ze geen master worden. Dit is een zeer goede beschermingsfunctie die voorkomt dat er veel gegevens verloren gaan.
Maar er is een probleem: de replicatie-lag in de Patroni-cluster en DCS wordt met een bepaalde interval bijgewerkt. Volgens mij is de standaard ttl-waarde 30 seconden.
Er kan een situatie zijn waarin de replicatiewerkzaamheden voor replica's in de DCS één zijn, terwijl er in werkelijkheid een heel andere vertraging kan zijn of er helemaal geen vertraging kan zijn, dat wil zeggen, dit is niet realtime. En het weerspiegelt niet altijd de werkelijke situatie. Het is niet verstandig om hierop een gecompliceerde logica te baseren.
En het risico op verlies blijft altijd bestaan. In het slechtste geval een formule, en in het gemiddelde geval een andere formule. Dat betekent dat wanneer we het implementeren van Patroni plannen en inschatten hoeveel gegevens we kunnen verliezen, we rekening moeten houden met deze formules en een idee moeten hebben van hoeveel gegevens we kunnen verliezen.
En er is goed nieuws. Wanneer de oude master vooruit loopt, kan dit gebeuren door bepaalde achtergrondprocessen. Dat wil zeggen, er was een autovacuüm dat gegevens heeft geschreven en deze in het transactie-log heeft opgeslagen. En deze gegevens kunnen we gewoon negeren en verliezen. Dit is geen probleem.
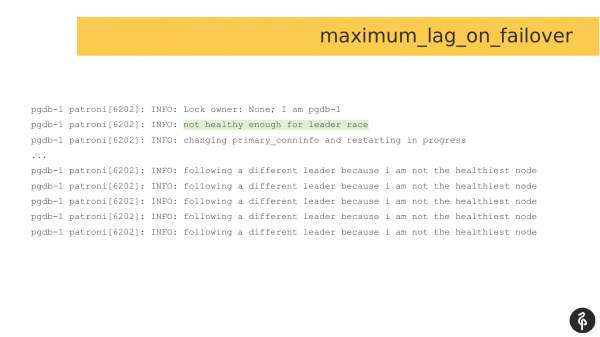
En zo zien de logs eruit in het geval dat maximum_lag_on_failover is ingesteld en er een failover heeft plaatsgevonden, en we een nieuwe master moeten kiezen. De replica beschouwt zichzelf als incapabel om deel te nemen aan de verkiezingen. En ze weigert deel te nemen aan de race om leader te worden. En ze wacht tot er een nieuwe master is gekozen om daarna verbinding te maken. Dit is een extra maatregel tegen gegevensverlies.
Hier hebben we het productteam dat meldt dat hun product problemen ondervindt bij het werken met Postgres. Bovendien is de master zelf niet bereikbaar omdat deze niet beschikbaar is via SSH. En er vindt ook geen automatische failover plaats.
Deze host is geforceerd opnieuw opgestart. Door de herstart vond er een automatische failover plaats, hoewel er ook een handmatige automatische failover had kunnen worden uitgevoerd, zoals ik nu begrijp. En na de herstart gaan we kijken wat er met de huidige master was.
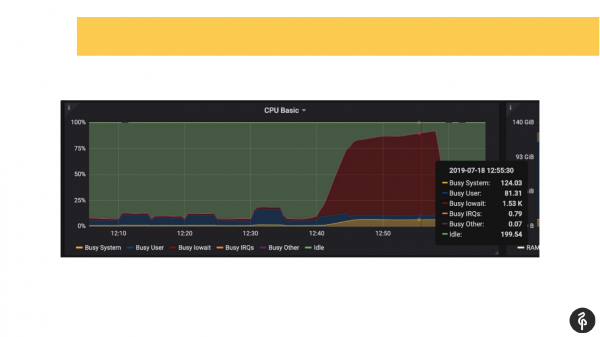
We wisten van tevoren dat we problemen hadden met de schijven, dat wil zeggen, we wisten al vanuit de monitoring waar we moesten graven en wat we moesten zoeken.
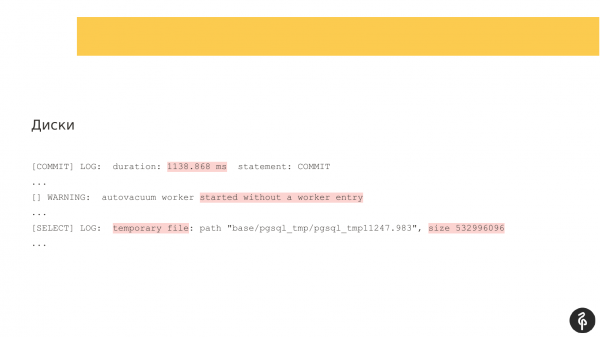
We hebben in de Postgres-log gekeken en begonnen te bekijken wat er aan de hand was. We zagen commits die één, twee of drie seconden duurden, wat helemaal niet normaal is. We zagen dat ons autovacuüm heel lang en vreemd opstartte. En we zagen tijdelijke bestanden op de schijf. Dit zijn allemaal indicatoren van problemen met de schijven.
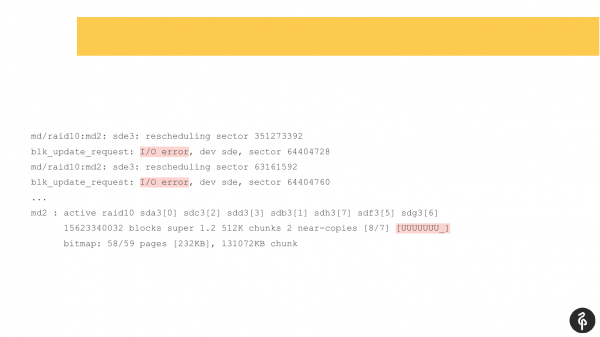
We checked the system dmesg (the kernel message log). And we saw that we have problems with one of the disks. The disk subsystem was a software RAID. We looked at /proc/mdstat and saw that we were missing one disk. That is, we have a RAID of 8 disks, and we are missing one. If you carefully examine the slide, you can see that sde is missing. So, one disk has dropped out. This triggered disk issues, and applications also experienced problems while working with the Postgres cluster.
In this case, Patroni would not have helped us, because Patroni does not track the server's status or the disk's status. We need to monitor such situations with external monitoring. We have quickly added disk monitoring to the external monitoring.
And there was this thought – could fencing or a software watchdog help us? We thought it would likely not help in this case because during the issues, Patroni continued to interact with the DCS cluster and did not see any problems. So, from DCS's and Patroni's perspective, everything seemed fine with the cluster, although there were indeed disk issues and database availability problems.
In my opinion, this is one of the strangest problems that I have investigated for a long time; I read through and sifted through many logs and named it the cluster-simulating problem.
The problem was that the old master could not become a normal replica, that is, Patroni started it, and Patroni indicated that this node was present as a replica, but at the same time, it was not a normal replica. You will see why shortly. This was saved from analyzing that issue.
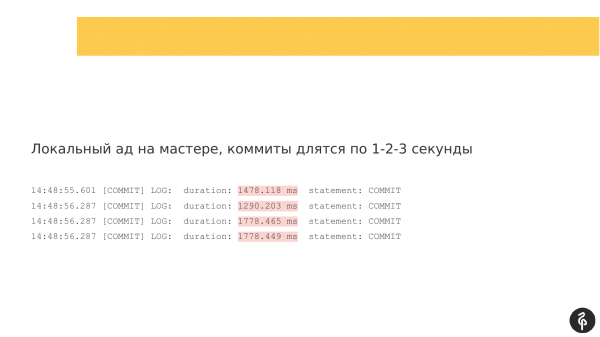
So, how did it all start? It started, like in the previous issue, with disk lags. We had commits of about one to two per second.
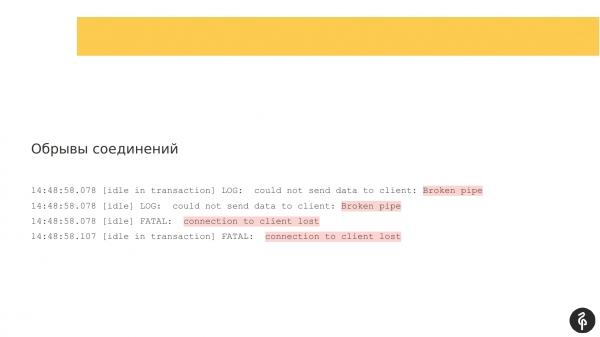
There were connection drops, that is, clients were disconnecting.
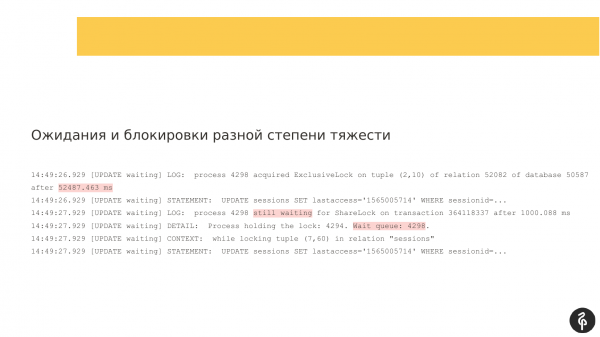
There were locks of varying severity.
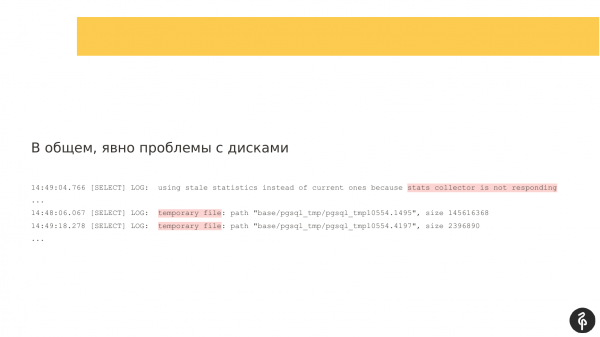
And, accordingly, the disk subsystem was not very responsive.
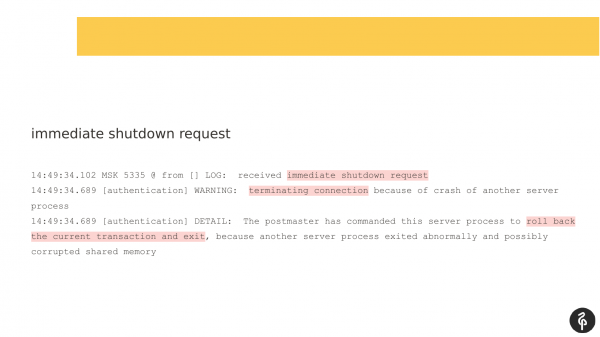
And the most mysterious part for me was the immediate shutdown request that arrived. Postgres has three shutdown modes:
- There is graceful, where we wait for all clients to disconnect on their own.
- There is fast, where we force clients to disconnect because we are shutting down.
- En immediate. In dit geval meldt immediate de klanten zelfs niet dat ze moeten uitschakelen, het schakelt simpelweg zonder waarschuwing uit. Een bericht RST (TCP-bericht dat de verbinding is verbroken en de klant niets meer te doen heeft) wordt naar alle klanten gestuurd door het besturingssysteem.
Wie heeft dit signaal gestuurd? Achtergrondprocessen van Postgres sturen elkaar dergelijke signalen niet, dat wil zeggen, dit is kill-9. Ze sturen dit niet naar elkaar, ze reageren alleen, wat betekent dat het een noodherstart van Postgres is. Wie het heeft gestuurd, weet ik niet.
Ik heb gekeken met het commando 'last' en ik zag één persoon die deze server ook had ingelogd samen met ons, maar ik schaamde me om de vraag te stellen. Misschien was het kill -9. Ik zou kill -9 in de logs hebben gezien, omdat Postgres aangeeft dat het kill -9 heeft ontvangen, maar ik zag dit niet in de logs.
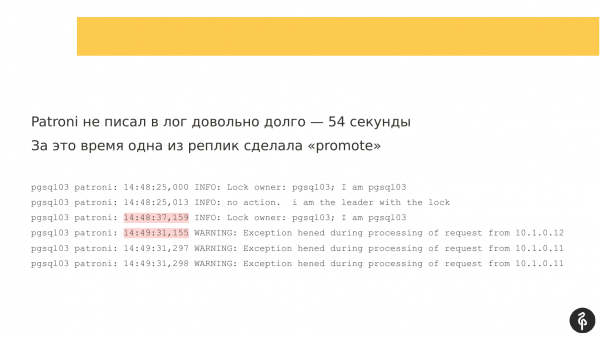
Bij verder onderzoek zag ik dat Patroni lange tijd niets in de log had geschreven – 54 seconden. En als je twee timestamp's vergelijkt, waren er ongeveer 54 seconden geen berichten.
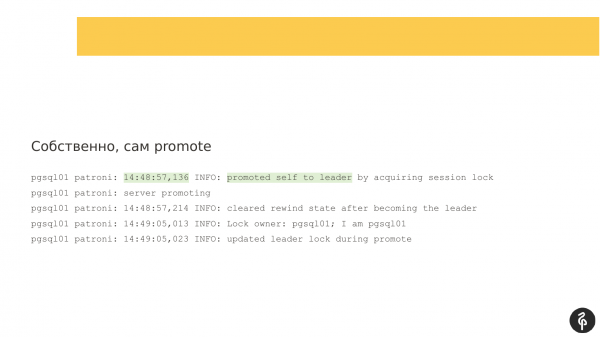
En in die tijd vond er een automatische failover plaats. Patroni heeft hier weer prachtig gewerkt. Onze oude master was niet beschikbaar, er gebeurde iets met hem. En de verkiezingen voor een nieuwe master begonnen. Hier werkte alles goed. Onze pgsql01 werd de nieuwe leider.
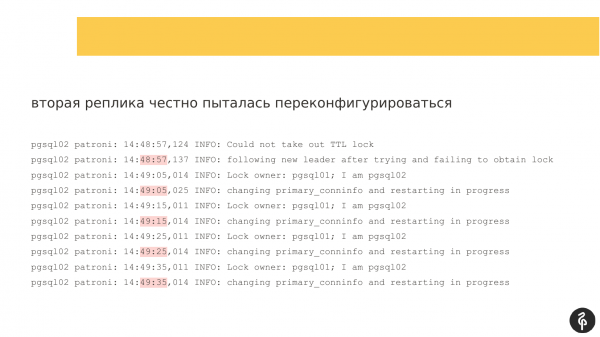
We hebben een replica die de master is geworden. En er is een tweede replica. En met de tweede replica waren er precies problemen. Het probeerde opnieuw te configureren. Zoals ik het begrijp, probeerde het recovery.conf te wijzigen, Postgres opnieuw op te starten en verbinding te krijgen met de nieuwe master. Het schrijft elke 10 seconden berichten dat het het probeert, maar het lukt niet.
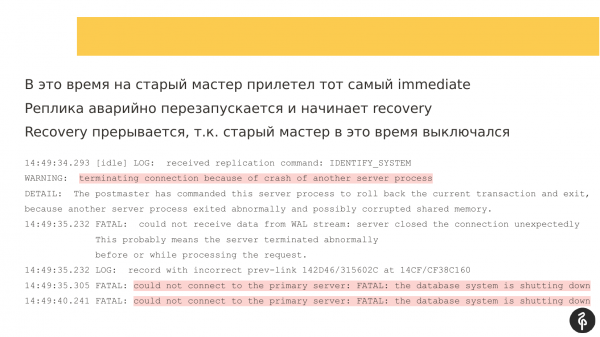
En tijdens deze pogingen ontvangt de oude master een immediate-shutdown signaal. De master start opnieuw op. En het herstel stopt ook, omdat de oude master opnieuw opstart. Dat wil zeggen, de replica kan zich niet aansluiten omdat hij in de uitschakelmodus is.
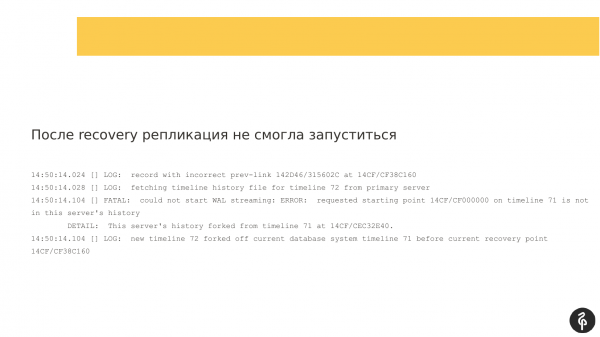
Op een gegeven moment werkte het, maar de replicatie startte niet.
Ik heb slechts één hypothese, dat in recovery.conf het adres van de oude master stond. En toen de nieuwe master verscheen, probeerde de tweede replica nog steeds verbinding te maken met de oude master.
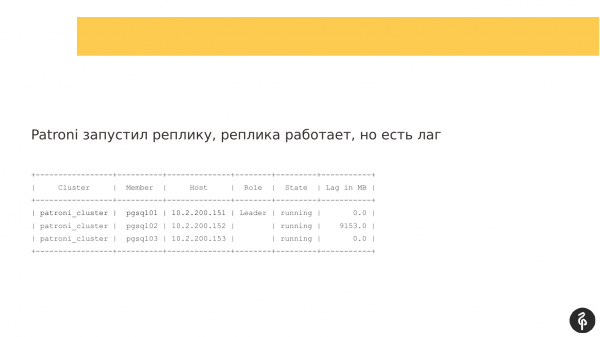
Toen Patroni op de tweede replica startte, startte de node op, maar kon niet aansluiten via replicatie. En er ontstond een replicatielag die er ongeveer zo uitzag. Dat wil zeggen, alle drie de nodes waren aanwezig, maar de tweede node liep achter.
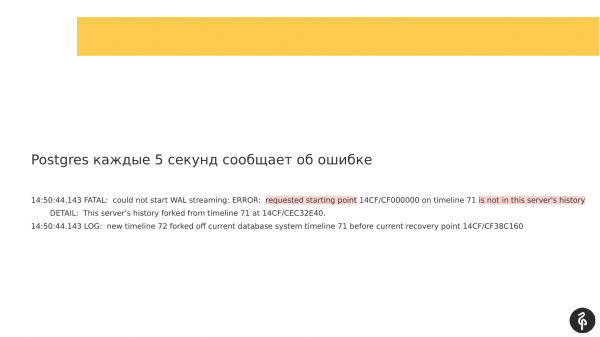
Toen ik naar de logs keek, die werden geschreven, kon ik zien dat de replicatie niet kon starten omdat de transactie-logboeken verschilden. En de transactie-logboeken die de master aanbiedt, die zijn vermeld in recovery.conf, passen gewoon niet bij onze huidige node.
En hier heb ik een fout gemaakt. Ik had moeten controleren wat er in recovery.conf stond om mijn hypothese te verifiëren dat we niet met die specifieke master verbonden waren. Maar ik was daar net mee bezig en het kwam niet in me op, of ik zag dat de replicatie achterliep en dat het misschien opnieuw moest worden ingeladen, dus ik heb het vrij slordig aangepakt. Dat was mijn fout.
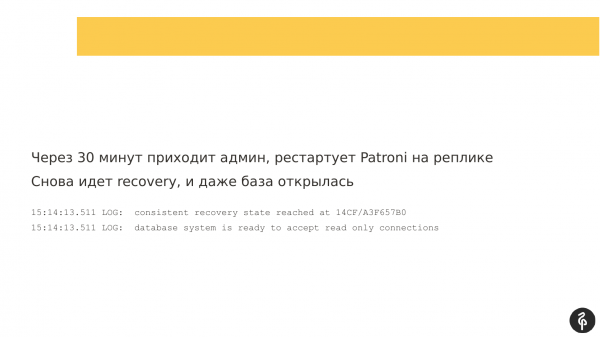
Na 30 minuten kwam de admin eraan, dat wil zeggen, ik had Patroni op de replicatie opnieuw gestart. Ik had de hoop op die node al opgegeven, ik dacht dat ik het opnieuw moest inladen. En ik dacht – laat ik Patroni opnieuw starten, misschien komt er iets goeds uit. De recovery startte op. En de database opende zelfs, ze was klaar om verbindingen te accepteren.
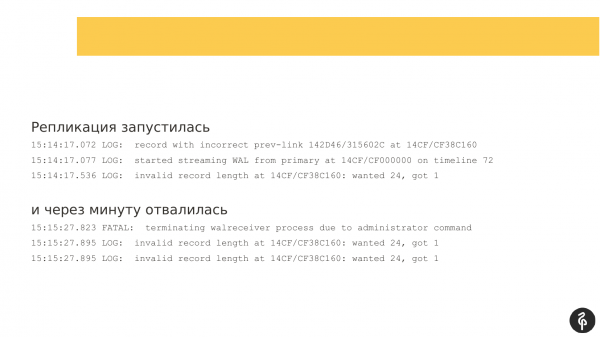
De replicatie is gestart. Maar na een minuut viel deze uit met een foutmelding dat de transactie-logboeken niet geschikt waren.
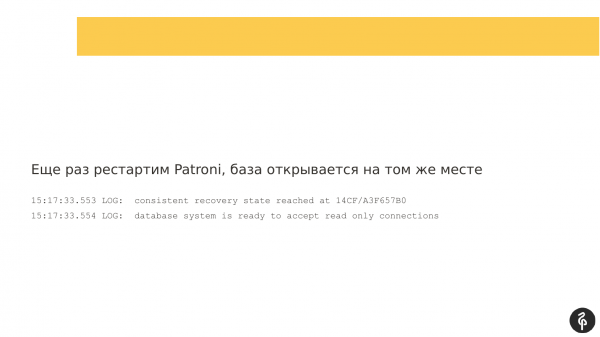
Ik dacht dat ik het nogmaals opnieuw zou starten. Ik herstartte Patroni nog een keer, maar ik herstartte Postgres niet, ik herstartte specifiek Patroni in de hoop dat hij de database op magische wijze zou starten.
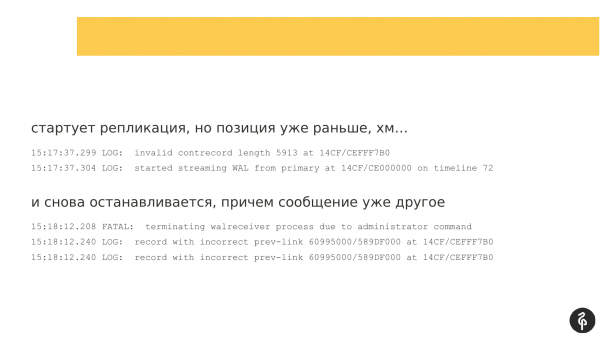
De replicatie startte opnieuw, maar de markeringen in de transactie-logboeken verschilden, ze waren niet die welke bij de vorige startpoging waren. De replicatie stopte opnieuw. En het bericht was al iets anders. En het was voor mij niet echt informatief.
En toen kwam het in me op – wat als ik Postgres opnieuw opstart, terwijl ik op de huidige master een checkpoint maak, zodat ik het punt in de transactie-logboeken iets verder naar voren schuif, zodat de recovery met een ander moment begint? Bovendien hadden we daar ook nog WAL-reserves.
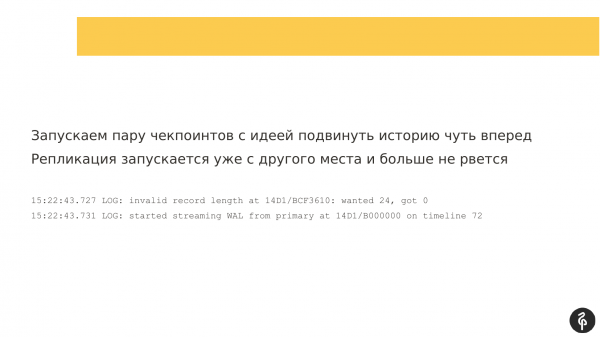
Ik herstartte Patroni, maakte een paar checkpoints op de master, een paar restart-punten op de replicatie, toen deze openging. En dat hielp. Ik heb lange tijd nagedacht waarom dat hielp en hoe dat werkte. En de replicatie opgestart. En de replicatie viel niet meer uit.
Dit probleem blijft een van de meest mysterieuze voor mij, waar ik nog steeds over nadenk wat er eigenlijk aan de hand was.
Wat zijn de conclusies hier? Patroni kan functioneren zoals bedoeld, zonder fouten. Maar dat biedt geen 100% garantie dat alles goed is. Een replica kan opstarten, maar kan zich in een semi-functionele staat bevinden, en de applicatie mag niet met zo'n replica werken, omdat daar oude gegevens aanwezig zijn.
En na een failover moet je altijd controleren of alles in orde is met het cluster, dat wil zeggen, of er het juiste aantal replicas is en of er geen replicatievertraging is.
Tijdens het bekijken van deze problemen formuleer ik aanbevelingen. Ik heb geprobeerd ze in twee dia's te groeperen. Waarschijnlijk konden alle verhalen in twee dia's worden samengevoegd en alleen deze worden verteld.
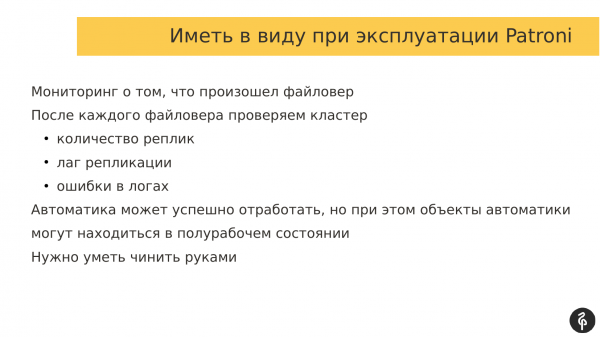
Wanneer je Patroni gebruikt, moet er altijd monitoring zijn. Je moet altijd weten wanneer er een automatische failover heeft plaatsgevonden, want als je niet weet dat er een automatische failover is geweest, heb je het cluster niet onder controle. En dat is slecht.
Na elke failover moeten we altijd handmatig het cluster controleren. We moeten ervoor zorgen dat we altijd het actuele aantal replicas hebben, dat er geen replicatievertraging is, en dat er geen fouten in de logs staan met betrekking tot streaming replicatie, Patroni of het DCS-systeem.
Automatisering kan succesvol werken, Patroni is een zeer goed hulpmiddel. Het kan functioneren, maar dat brengt het cluster niet in de gewenste staat. En als we daar niet achter komen, hebben we problemen.
En Patroni is geen zilveren kogel. We moeten nog steeds begrijpen hoe Postgres werkt, hoe replicatie werkt en hoe Patroni samenwerkt met Postgres, evenals de interactie tussen de knooppunten. Dit is nodig om handmatig de opkomende problemen te kunnen oplossen.
Hoe pak ik het diagnosticeren aan? Het is zo dat we met verschillende klanten werken en niemand heeft een ELK-stack, waardoor we in de logs moeten kijken, met 6 consoles en 2 tabbladen open. In het ene tabblad bevinden zich de logs van Patroni voor elke knoop, in het andere tabblad de logs van Consul, of Postgres indien nodig. Dit is zeer moeilijk te diagnosticeren.
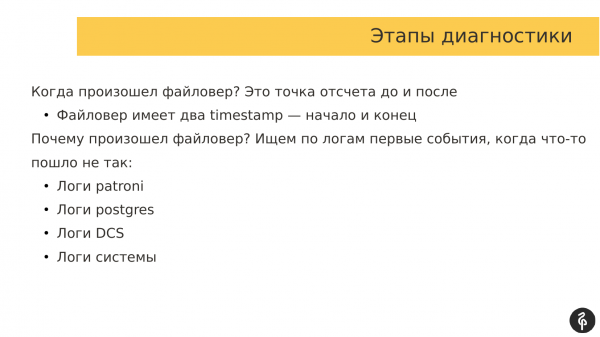
Welke aanpakken heb ik ontwikkeld? Ten eerste kijk ik altijd wanneer de failover heeft plaatsgevonden. Voor mij is dit een scheidslijn. Ik kijk naar wat er is gebeurd vóór de failover, tijdens de failover en na de failover. Een failover heeft twee markeringen: het tijdstip van begin en eind.
Daarna kijk ik in de logs naar de gebeurtenissen vóór de failover, dus ik zoek naar de redenen waarom de failover heeft plaatsgevonden.
Dit geeft een beeld van wat er is gebeurd en wat we in de toekomst kunnen doen om dergelijke situaties te voorkomen (en als gevolg daarvan een failover te vermijden).
En waar kijken we normaal gesproken? Ik kijk naar:
- Eerst in de Patroni-logs.
- Daarna kijk ik in de Postgres-logs, of in de DCS-logs, afhankelijk van wat ik in de Patroni-logs heb gevonden.
- En ook systeemlogs geven soms inzicht in wat de oorzaak van de failover was.
Hoe denk ik over Patroni? Ik ben zeer positief over Patroni. Naar mijn mening is het het beste dat vandaag de dag beschikbaar is. Ik ken veel andere producten zoals Stolon, Repmgr, Pg_auto_failover, PAF. Vier tools. Ik heb ze allemaal geprobeerd. Patroni bevalt me het meest.
Als me gevraagd wordt: 'Zou ik Patroni aanbevelen?' zeg ik ja, omdat ik Patroni leuk vind. En ik heb het gevoel dat ik heb geleerd hoe ik het moet installeren.
Als je geïnteresseerd bent in andere problemen met Patroni, naast de problemen die ik heb genoemd, kun je altijd de pagina bezoeken op GitHub. Daar zijn veel verschillende verhalen en worden veel interessante problemen besproken. Uiteindelijk zijn er een aantal bugs gerapporteerd en opgelost, dus het is interessant leesvoer.
Daar zijn interessante verhalen over hoe mensen zichzelf in de voet schieten. Het is heel leerzaam. Je leest het en begrijpt dat je dat niet moet doen. Ik heb het genoteerd.
Ik wil Zalando bedanken voor het ondersteunen van dit project, met name Alexander Kukushkin en Alexey Klyukin. Alexey Klyukin is een van de medeoprichters, hij werkt al niet meer bij Zalando, maar dit zijn de twee mensen die met dit product zijn begonnen.
Ik beschouw Patroni als een geweldig stuk software. Ik ben blij dat het bestaat, het is interessant om mee te werken. En een grote dank aan alle bijdragers die patches voor Patroni schrijven. Ik hoop dat Patroni met de jaren volwassener, beter en functioneler zal worden. Het is al functioneel, maar ik hoop dat het nog beter wordt. Dus als je van plan bent om Patroni te gebruiken, maak je geen zorgen. Het is een goede oplossing, je kunt het implementeren en gebruiken.
Dat is alles. Als je vragen hebt, stel ze dan gerust.
Vragen
Bedankt voor de presentatie! Als we na de failover nog steeds heel nauwkeurig moeten kijken, waarom hebben we dan een automatische failover?
Omdat het een nieuwe techniek is. We werken hier pas een jaar mee. Het is beter om het zekere voor het onzekere te nemen. We willen inloggen en controleren of alles echt werkt zoals het moet. Dit is een niveau van volwassen wantrouwen – beter dubbelchecken en kijken.
Bijvoorbeeld, we logden vanmorgen in en keken, nietwaar?
Niet in de ochtend, we krijgen meestal vrijwel onmiddellijk notificaties over de failover. We zien dat er een failover heeft plaatsgevonden. We loggen eigenlijk meteen in en kijken. Maar al deze controles moeten op het niveau van monitoring worden uitgevoerd. Als we Patroni via de REST API aanroepen, is er geschiedenis. Op basis van die geschiedenis kunnen we de tijdstempels bekijken wanneer de failover plaatsvond. Op basis daarvan kunnen we monitoring uitvoeren. We kunnen de geschiedenis bekijken, hoeveel gebeurtenissen er zijn geweest. Als er meer gebeurtenissen zijn, betekent dit dat er een failover heeft plaatsgevonden. We kunnen inloggen en kijken. Of onze monitoring heeft geverifieerd dat alle replica’s aanwezig zijn, dat er geen lag is en dat alles goed is.
Bedankt!
Heel erg bedankt voor het geweldige verhaal! Als we de DCS-cluster ergens ver van de Postgres-cluster hebben geplaatst, moet die cluster dan ook regelmatig onderhouden worden? Wat zijn de best practices als het gaat om het uitschakelen van bepaalde delen van de DCS-cluster, wat moet er mee gebeuren, enzovoort? Hoe leven al deze constructies ondertussen?
Voor een bedrijf moesten we een probleematrix maken, wat er gebeurt als een of meerdere componenten uitvallen. Aan de hand van deze matrix nemen we alle componenten één voor één door en bouwen we scenario's voor het geval deze componenten uitvallen. Voor elk scenario van een uitval kan er een actieplan voor herstel zijn. En in het geval van DCS maakt dit deel uit van de standaardinfrastructuur. De beheerder beheert dit, en we vertrouwen al op de beheerders die dit beheren en op hun vermogen om dit te repareren in geval van een storing. Als DCS er helemaal niet is, dan zetten wij het op, maar we houden er niet echt toezicht op, omdat we niet verantwoordelijk zijn voor de infrastructuur, maar we geven aanbevelingen over wat en hoe te monitoren.
Met andere woorden, heb ik het goed begrepen dat ik Patroni moet uitschakelen, de failover moet uitschakelen en alles moet uitschakelen voordat ik iets met de hosts doe?
Dit hangt af van het aantal knooppunten in het DCS-cluster. Als er veel knooppunten zijn en we schakelen slechts één van de knooppunten (replica) uit, blijft de quorum in het cluster behouden. En Patroni blijft operationeel. En er wordt niets getriggerd. Als we complexe bewerkingen hebben die meer knooppunten beïnvloeden, waarvan het ontbreken de quorum kan laten vervallen, dan is het misschien zinnig om Patroni op pauze te zetten. Het heeft de bijbehorende opdracht – patronictl pause, patronictl resume. We zetten het gewoon op pauze, en de failover gebeurt niet in die tijd. We voeren onderhoud uit op het DCS-cluster, daarna nemen we de pauze op en gaan verder.
Heel erg bedankt!
Heel erg bedankt voor de presentatie! Hoe gaat het productteam om met het risico van gegevensverlies?
Het productteam maakt zich er niet druk om, maar de teamleiders maken zich zorgen.
Wat voor garanties zijn er?
Het is moeilijk om garanties te geven. Er is een presentatie van Alexander Kukushkin over hoe RPO en RTO te berekenen, dat is het herstel tijd en hoeveel gegevens we kunnen verliezen. Ik denk dat we die dia's moeten vinden en bestuderen. Voor zover ik me herinner, zijn er specifieke stappen om dit te berekenen. Hoeveel transacties we kunnen verliezen, hoeveel gegevens we kunnen verliezen. Als optie kunnen we synchronisatie-replicatie op het niveau van Patroni gebruiken, maar dat is een tweesnijdend zwaard: we hebben ofwel gegevensbetrouwbaarheid, of we verliezen snelheid. Er is synchronisatie-replicatie, maar ook dat garandeert geen 100% bescherming tegen gegevensverlies.
Alexey, bedankt voor de geweldige presentatie! Heb je ervaring met het gebruik van Patroni voor zero level protection? Dat wil zeggen, in combinatie met synchronische standby? Dit is de eerste vraag. En de tweede vraag. Jullie hebben verschillende oplossingen gebruikt. Wij hebben Repmgr gebruikt, maar zonder automatische failover en zijn nu van plan om automatische failover in te schakelen. We overwegen Patroni als alternatieve oplossing. Wat kun je zeggen als voordelen precies in vergelijking met Repmgr?
De eerste vraag ging over synchronisatie-replicaties. Niemand gebruikt synchronisatie-replicatie bij ons, omdat iedereen bang is (Enkele klanten gebruiken het al, we hebben in principe geen prestatietroubles opgemerkt — Opmerking van de spreker). Maar we hebben voor onszelf de regel ontwikkeld dat er minimaal drie knooppunten in een cluster voor synchronisatie-replicatie moeten zijn, omdat als we twee knooppunten hebben en de master of de replica faalt, Patroni dit knooppunt in de standalone-modus plaatst zodat de applicatie blijft functioneren. In dat geval zijn er risico's op gegevensverlies.
Met betrekking tot de tweede vraag: we hebben Repmgr gebruikt en gebruiken het nog steeds bij sommige klanten om historische redenen. Wat kunnen we zeggen? In Patroni is auto-failover standaard inbegrepen, in Repmgr is auto-failover al een extra functie die moet worden ingeschakeld. We moeten de Repmgr-daemon op elk knooppunt starten en dan kunnen we auto-failover instellen.
Repmgr controleert of de Postgres-knopen leven. De Repmgr-processen controleren het bestaan van elkaar, wat niet bijzonder efficiënt is, omdat er ingewikkelde gevallen van netwerksisolatie kunnen zijn waarbij een grote Repmgr-cluster kan uiteenvallen in verschillende kleine en doorgaan met werken. Ik volg Repmgr al een tijd niet, misschien hebben ze dit opgelost... of misschien ook niet. Maar het verplaatsen van informatie over de status van het cluster naar de DCS, zoals Stolon en Patroni doen, is de meest levensvatbare optie.
Alexey, ik heb een vraag, misschien een domme. In een van de eerste voorbeelden verplaatste je DCS van een lokale machine naar een extern knooppunt. We begrijpen dat een netwerk dingen heeft met zijn eigen bijzonderheden, het leeft op zichzelf. En wat gebeurt er als om een bepaalde reden de DCS-cluster niet bereikbaar is? Ik zal de redenen niet noemen, er kunnen veel zijn: van onhandige netwerkmensen tot echte problemen.
Ik heb dit niet hardop gezegd, maar de DCS-cluster moet ook fouttolerant zijn, dat wil zeggen dat het een oneven aantal knooppunten moet hebben, zodat er een quorum kan worden bereikt. Wat gebeurt er als de DCS-cluster niet bereikbaar is of als er geen quorum kan worden bereikt, bijvoorbeeld door een netwerk-split of knooppuntfalen? In dat geval schakelt de Patroni-cluster over naar lees-only modus. De Patroni-cluster kan de status van het cluster niet bepalen en wat hij moet doen. Hij kan geen contact maken met de DCS en de nieuwe status van het cluster daar opslaan, daarom schakelt de hele cluster over naar lees-only. En wacht of op handmatige tussenkomst van de operator of totdat de DCS hersteld is.
Met andere woorden, wordt DCS voor ons net zo'n belangrijke service als de database zelf?
Ja, ja. In veel moderne bedrijven is Service Discovery een onmisbaar onderdeel van de infrastructuur. Het wordt zelfs geïmplementeerd voordat er een database in de infrastructuur aanwezig is. Om het simpel te zeggen, je start de infrastructuur, zet het op in een datacenter, en heb je meteen Service Discovery. Als het Consul is, kan zelfs DNS daarop worden gebouwd. Als het Etcd is, kan het deel uitmaken van een Kubernetes-cluster waarin alles al wordt uitgerold. Ik denk dat Service Discovery inmiddels een integraal onderdeel van moderne infrastructuren is. Men denkt er veel eerder aan dan aan databases.
Bedankt!
Bron: habr.com
