

We hebben nieuwe diensten gelanceerd, het verkeer groeide, we vervingen servers, verbonden nieuwe locaties en herbouwden datacenters - en nu vertellen we dit verhaal, waarvan we u vijf jaar geleden al op de hoogte stelden..
Vijf jaar is een kenmerkende periode voor het maken van tussenresultaten. Daarom hebben we besloten om te vertellen over de ontwikkeling van onze infrastructuur, die in de afgelopen vijf jaar een bijzonder interessante ontwikkeling heeft doorgemaakt, waar we trots op zijn. De kwantitatieve veranderingen die we hebben doorgevoerd, zijn geëvolueerd naar kwalitatieve verbeteringen, nu kan de infrastructuur werken in modi die in het midden van het afgelopen decennium als fantasie leken.
We ondersteunen de werking van de meest complexe projecten met strenge betrouwbaarheidseisen en hoge belasting, waaronder PREMIER en Match TV. Voor sportuitzendingen en de premiere van populaire series is er een dataverkeer vereist van terabits per seconde, wat wij gemakkelijk realiseren, en dat zo vaak dat het werken met dergelijke snelheden voor ons al routine is geworden. Vijf jaar geleden was het zwaarste project dat op onze systemen draaide Rutube, dat sindsdien is gegroeid, het volume en het verkeer heeft vergroot, wat bij het plannen van lasten in aanmerking moest worden genomen.
We hebben verteld over hoe we de 'hardware' van onze infrastructuur hebben ontwikkeld () en het systeem hebben ontwikkeld dat verantwoordelijk is voor de video-uitzending (), maar sinds het schrijven van deze teksten is er veel tijd verstreken, zijn er veel andere oplossingen ontwikkeld en geïmplementeerd, waarvan de resultaten ons in staat stellen om aan de moderne eisen te voldoen en flexibel genoeg te zijn om ons aan te passen aan nieuwe taken.
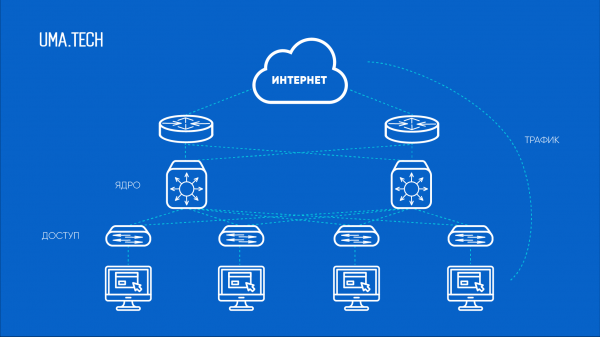
De netwerkkern ontwikkelen we voortdurend. We zijn in 2015 overgestapt op Cisco-apparatuur, waar we in het vorige artikel al over hebben gesproken. Toen waren het dezelfde 10/40G, maar om begrijpelijke redenen hebben we enkele jaren later de bestaande chassis geüpgraded, en nu gebruiken we ook actief 25/100G.
100G-links zijn al geruime tijd geen luxe meer (het is eerder een dringende eis van deze tijd in onze sector) en ook geen zeldzaamheid (steeds meer providers bieden verbinding met deze snelheden aan). Echter, 10/40G blijft relevant: via deze links blijven we providers aansluiten met een klein verbruik, waarvoor het momenteel niet zinvol is om een krachtiger poort te gebruiken.
De netwerkstructuur die we hebben opgezet, verdient een aparte bespreking en zal later het onderwerp van een apart artikel worden. Daar zullen we dieper ingaan op de technische details en de logica van onze acties bij de oprichting. Maar nu blijven we de infrastructuur schematisch schetsen, aangezien uw aandacht, gewaardeerde lezers, niet onbeperkt is.
Videoafleveringsservers ontwikkelen zich snel, waarvoor we veel inspanningen leveren. Waar we voorheen voornamelijk 2U-servers gebruikten met 4-5 netwerkkaarten, waarbij elke kaart twee 10G-poorten had, wordt nu het grootste deel van het verkeer geleverd met 1U-servers, waarin 2-3 kaarten met elk twee 25G-poorten zitten. De kosten van 10G- en 25G-kaarten zijn praktisch gelijk, en snellere oplossingen stellen ons in staat om zowel op 10G als op 25G te leveren. Dit heeft geleid tot duidelijke besparingen: minder servercomponenten en kabels voor aansluiting – lagere kosten (en hogere betrouwbaarheid), en de componenten nemen minder ruimte in beslag in de rek – wat het mogelijk maakte om meer servers per oppervlak te plaatsen en dus de huurkosten te verlagen.
Maar belangrijker is de winst in snelheid! Nu kunnen we met 1U meer dan 100G afleveren! En dit terwijl sommige grote Russische projecten een 'prestatie' noemen om 40G met 2U af te leveren. Wij zouden hun problemen willen hebben!
Laten we opmerken dat we nog steeds de generatie netwerkkaarten gebruiken die alleen op 10G kan werken. Deze apparatuur functioneert stabiel en is ons goed bekend, dus we hebben het niet weggegooid, maar hebben er een nieuwe toepassing voor gevonden. Deze componenten hebben we geïnstalleerd in video-opslagservers, waar één of twee 1G-interfaces duidelijk niet voldoende zijn voor effectieve werking; hier zijn 10G-kaarten relevant gebleken.
Opslagsystemen groeien ook. In de afgelopen vijf jaar zijn ze van twaalf schijven (12x HDD 2U) naar zesendertig schijven (36x HDD 4U) gegaan. Dergelijke volumineuze 'kapsels' worden door sommigen gevreesd, omdat bij een defect van zo'n chassis de prestaties – of zelfs de werking! – van het hele systeem in gevaar kan komen. Maar dat zal bij ons niet gebeuren: we hebben redundantie gegarandeerd op het niveau van geo-gedistribueerde gegevenskopieën. We hebben de chassis verspreid over verschillende datacenters – in totaal maken we gebruik van drie – en dat voorkomt problemen zowel bij chassis-fouten als bij het uitvallen van een locatie.
Dit heeft natuurlijk hardware RAID overbodig gemaakt, waar we van af hebben gezien. Door overbodigheid te elimineren, hebben we tegelijkertijd de betrouwbaarheid van het systeem verbeterd, de oplossing vereenvoudigd en een van de potentiële faalpunten verwijderd. Ter herinnering, onze opslagsystemen zijn 'op maat gemaakt'. We hebben deze keuze bewust gemaakt en het resultaat bevalt ons volledig.
Datacentra hebben we in de afgelopen vijf jaar meerdere keren vervangen. Sinds het schrijven van het vorige artikel hebben we alleen het datacenter DataLine niet veranderd – de rest vereiste vervanging naarmate onze infrastructuur zich ontwikkelde. Alle verhuizingen tussen locaties waren gepland.
Twee jaar geleden hebben we binnen MMTS-9 gemigreerd, waarbij we naar een locatie met een kwaliteitsrenovatie, een goed koelsysteem, stabiele voeding en zonder stof zijn verhuisd, dat vroeger in dikke lagen op alle oppervlakken lag en de interne onderdelen van onze apparatuur grotendeels verstopte. De keuze voor kwaliteitsdiensten – en een stofvrije omgeving! – was de reden voor onze verhuizing.
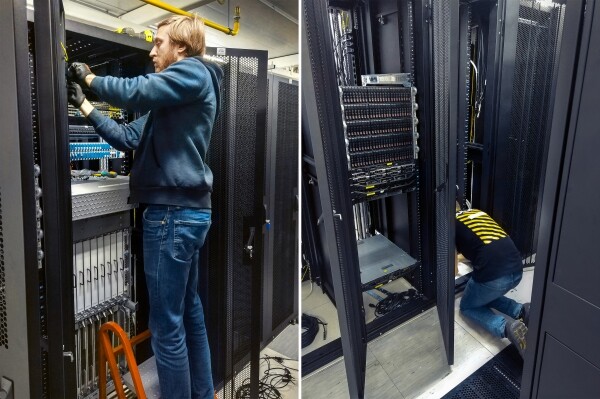
Bijna altijd geldt: 'één verhuizing is gelijk aan twee branden', maar de problemen bij migratie zijn elke keer anders. Dit keer werd de belangrijkste uitdaging van de verhuizing binnen hetzelfde datacenter veroorzaakt door de optische crossconnects – hun overvloed tussen de verdiepingen zonder een enkele crossconnect van de telecomoperatoren. Het actueel maken en opnieuw aanleggen van de crossconnects (waarbij de ingenieurs van MMTS-9 ons hielpen), was misschien wel de moeilijkste fase van de migratie.
De tweede migratie vond een jaar geleden plaats, in 2019 verhuisden we van een niet al te goed datacenter naar O2xygen. De redenen voor de verhuizing waren vergelijkbaar met die hierboven besproken, maar daar kwam het probleem bij dat het oorspronkelijke datacenter niet aantrekkelijk was voor telecomoperatoren – veel providers moesten we met eigen middelen 'bijhouden' naar deze locatie.
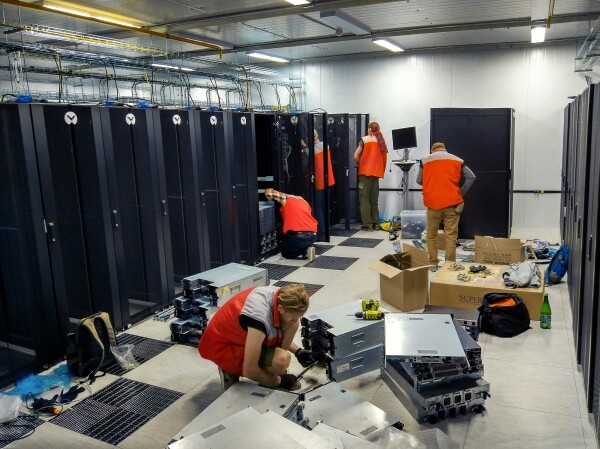
De migratie van 13 racks naar een kwalitatieve locatie in MMTS-9 maakte het mogelijk om deze locatie niet alleen als een operationele vestiging (een paar racks en doorverbindingen van operatoren) te ontwikkelen, maar ook als een van de belangrijkste te gebruiken. Dit vereenvoudigde de migratie vanuit een niet al te goed datacenter – de meeste apparatuur hebben we naar een andere locatie overgebracht, en O2xygen kreeg de rol van een groeiende omgeving, waarbij we ook daar 5 racks met apparatuur naartoe stuurden.
Vandaag de dag is O2xygen al een volwaardige locatie waar de benodigde operatoren 'gekomen zijn' en nieuwe zich blijven aansluiten. Voor operatoren bleek O2xygen ook aantrekkelijk te zijn in termen van strategische ontwikkeling.
De belangrijkste fase van de verhuizing voeren we altijd 's nachts uit, en bij migraties binnen MMTS-9 en naar O2xygen hielden we ons aan deze regel. We benadrukken dat de regel van 'verhuizing in één nacht' strikt wordt nageleefd, ongeacht het aantal racks! Er was zelfs een precedent waarin we 20 racks verplaatst hebben, en dat deden we ook in één nacht. Migratie is een relatief eenvoudig proces dat nauwkeurigheid en opvolging vereist, maar er zijn ook enkele trucs in het voorbereidingsproces, bij de verhuizing en bij het opzetten op de nieuwe locatie. Over de details van de migratie zijn we bereid uitvoerig te vertellen, mocht je geïnteresseerd zijn.
Resultaten We houden van vijfjarige ontwikkelingsplannen. We hebben de bouw van een nieuwe fouttolerante infrastructuur, verspreid over drie datacenters, afgerond. We hebben de dichtheid van de dataverkeer-output drastisch verhoogd – als we recent nog blij waren met 40-80G met 2U, is het nu normaal voor ons om 100G met 1U te leveren. Nu wordt zelfs een terabit aan verkeer door ons als dagelijkse kost gezien. We zijn bereid om onze infrastructuur verder te ontwikkelen, die nu flexibel en schaalbaar is.
Vraag: Waarover moeten we u in de volgende teksten vertellen, geachte lezers? Waarom we zijn begonnen met het maken van zelfgebouwde opslagoplossingen? Over de netwerkinfrastructuur en zijn kenmerken? Over de trucs en nuances van migratie tussen datacenters? Over het optimaliseren van oplossingen voor uitgifte door componenten zorgvuldig te selecteren en parameters fijn af te stemmen? Over het creëren van robuuste oplossingen door middel van meervoudige back-ups en horizontale schaalmogelijkheden binnen datacenters, die zijn gerealiseerd in een structuur van drie datacenters?
Auteur: Peter Vinogradov — Technisch Directeur van Uma.Tech
Bron: habr.com
