

ansible devops codestyle
Hey! Mijn naam is ik werk als ingenieur in de afdeling voor automatisering van ontwikkelingsprocessen. Elke dag worden nieuwe applicaties uitgerold op honderden servers van het bedrijf. In dit artikel deel ik mijn ervaringen met het gebruik van Ansible voor deze doeleinden.
Deze gids biedt een manier om variabelen te organiseren in de deployment. Deze gids is bedoeld voor degenen die al rollen gebruiken in hun playbooks en die , maar tegen soortgelijke problemen aanlopen:
- Wanneer je een variabele in de code vindt, is het niet meteen duidelijk waarvoor deze dient;
- Er zijn verschillende rollen, en variabelen moeten aan één waarde worden gekoppeld, maar dat lukt niet;
- Er zijn moeilijkheden bij het uitleggen aan anderen hoe de logica van de variabelen in jouw playbooks is opgebouwd.
Met deze problemen zijn we tegengekomen in projecten binnen ons bedrijf, wat ons heeft geleid tot regels voor het structureren van variabelen in onze playbooks, die de problemen in zekere mate hebben opgelost.
Variabelen in rollen
Een rol is een afzonderlijk object in het deployingsysteem. Net als elk object in het systeem, moet het een interface hebben voor interactie met de rest van het systeem. Deze interface bestaat uit de rolvariabelen.
Laten we als voorbeeld een rol nemen api, die een Java-applicatie op de server installeert. Welke variabelen kan deze rol hebben?
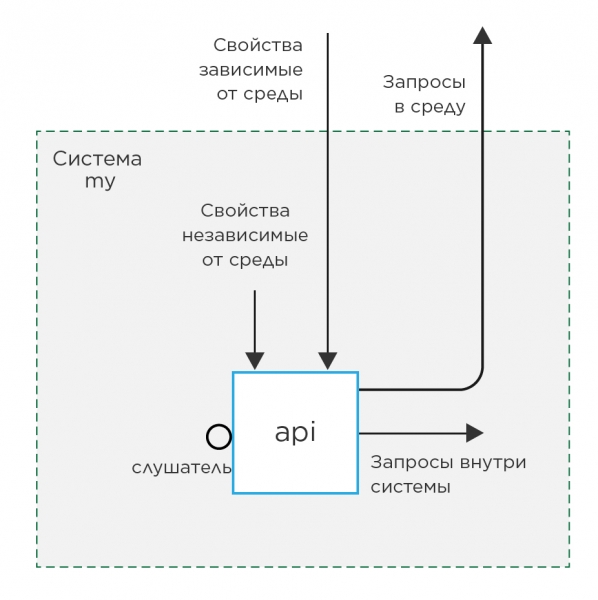
Rolvariabelen kunnen worden onderverdeeld in 2 types:
1. Eigenschappen
    a) ongeacht de omgeving
    b) afhankelijk van de omgeving
2. Verbindingen
    a) luisteraars
    b) verzoeken binnen het systeem
    c) verzoeken naar de omgeving
Eigenschap variabelen zijn variabelen die het gedrag van de rol bepalen.
Verzoekvariabelen zijn variabelen waarvan de waarde wordt gebruikt om externe, ten opzichte van de rol, bronnen aan te duiden.
Luiter variabelen zijn variabelen waarvan de waarde wordt gebruikt voor het vormen van verzoekvariabelen.
Aan de andere kant zijn 1a, 2a, 2b - dit zijn variabelen die niet van de omgeving afhankelijk zijn (hardware, externe bronnen, etc.) en kunnen worden gevuld met standaardwaarden in de defaults van de rol. Echter, variabelen van type 1b en 2c kunnen behalve met 'example' niet met andere waarden worden ingevuld, omdat deze zullen variëren van stand naar stand, afhankelijk van de omgeving.
Code stijl
- De naam van de variabele moet beginnen met de naam van de rol. Dit zorgt ervoor dat je later gemakkelijk kunt begrijpen uit welke rol de variabele komt en waarvoor deze dient.
- Bij het gebruik van variabelen in rollen moet je noodzakelijkerwijs het principe van encapsulatie volgen en variabelen gebruiken die ofwel in de rol zelf zijn gedefinieerd, of in de rollen waarvan de huidige afhankelijk is.
Probeer geen woordenboeken voor variabelen te gebruiken. Ansible maakt het niet gemakkelijk om afzonderlijke waarden in een woordenboek te overschrijven.
Voorbeeld van een slechte variabele:
myrole_user:
    login: admin
    password: admin
Hier is login een omgevingsonafhankelijke variabele, terwijl password afhankelijk is. Maar
aangezien ze in een woordenboek zijn samengevoegd, moet je deze altijd volledig instellen,
wat erg onhandig is. Het is beter zo:myrole_user_login: admin myrole_user_password: admin
Variabelen in deployment playbooks
Bij het samenstellen van een deployment playbook (hierna playbook genoemd), houden we ons aan de regel dat dit in een aparte repository moet worden geplaatst. Net als de rollen: elke in zijn eigen git-repository. Dit maakt het duidelijk dat rollen en playbooks verschillende onafhankelijke objecten van het deploymentsysteem zijn, en wijzigingen in het ene object mogen de werking van het andere niet beïnvloeden. Dit wordt bereikt door de standaardwaarden van de variabelen te veranderen.
Bij het samenstellen van het playbook, samengevat, is het mogelijk om de standaardwaarden van rolvariabelen op twee plaatsen te overschrijven: in de variabelen van het playbook en in de inventarisvariabelen.
mydeploy                        # Deployment map
├── deploy.yml                  # Deployment playbook
├── group_vars                  # Map voor playbook variabelen
│   ├── all.yml                 # Bestand voor variabelen van het hele systeem
│   └── myapi.yml               # Bestand voor variabelen van de groep myapi
└── inventories                 #
    └── prod                    # Prod omgeving map
        ├── prod.ini            # Inventarisbestand
        └── group_vars          # Map voor inventarisvariabelen
            └── myapi           #
                ├── vars.yml    # Omgevingsonafhankelijke variabelen van de groep myapi
                └── vault.yml   # Geheimen (altijd omgevingsafhankelijk) *
* —
Het verschil is dat de playbook-variabelen altijd worden gebruikt bij het aanroepen van playbooks die zich op hetzelfde niveau bevinden. Dit betekent dat deze variabelen uitstekend geschikt zijn voor het wijzigen van de standaardwaarden van omgevingsonafhankelijke variabelen. Aan de andere kant worden inventarisvariabelen alleen gebruikt voor specifieke omgevingen, wat perfect is voor omgevingsafhankelijke variabelen.
Het is belangrijk op te merken dat de prioriteit van variabelen je niet toelaat om variabelen eerst in de playbook-variabelen en daarna apart in een inventory te overschrijven.
Dit betekent dat je op dit punt al moet beslissen of de variabele afhankelijk van de omgeving is of niet en deze op de juiste plaats moet plaatsen.
Bijvoorbeeld, in een project was de variabele die verantwoordelijk was voor het inschakelen van SSL lange tijd omgeving-afhankelijk, omdat we SSL om redenen die niet in onze macht lagen niet konden inschakelen op een van de omgevingen. Nadat we dit probleem hadden opgelost, werd het omgeving-onafhankelijk en verhuisde het naar de playbook-variabelen.
Eigenschappenvariabelen voor groepen
Laten we ons model in afbeelding 1 uitbreiden door 2 groepen servers toe te voegen met een andere Java-toepassing, maar met verschillende instellingen.
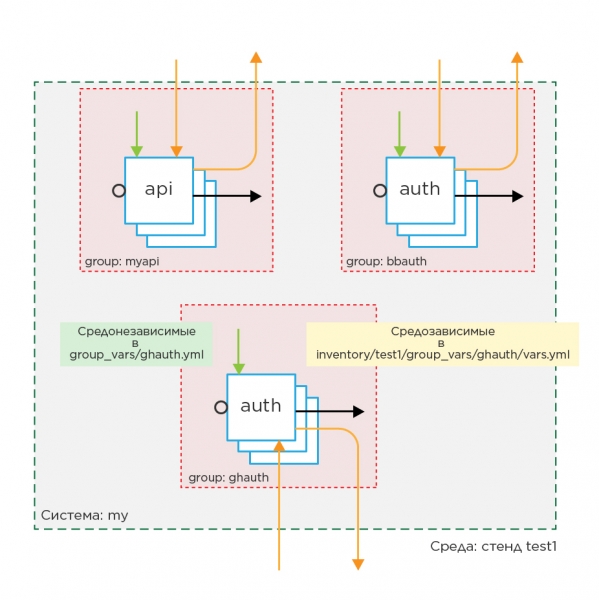
Laten we zien hoe de playbook er in dit geval uit zou zien:
- hosts: myapi
  roles:
    - api

- hosts: bbauth
  roles:
    - auth

- hosts: ghauth
  roles:
    - auth
We hebben drie groepen in de playbook, dus het is aan te raden om evenveel groepsbestanden in group_vars voor de inventory-variabelen en de playbook-variabelen te maken. Eén groepsbestand beschrijft in dit geval één component van de hogere toepassing in de playbook. Wanneer je het groepsbestand in de playbook-variabelen opent, zie je meteen alle verschillen ten opzichte van het standaardgedrag van de op de groep geïnstalleerde rollen. In de inventory-variabelen: de verschillen in gedrag van de groep van omgeving tot omgeving.
Code Stijl
- Probeer over het algemeen geen host_vars-variabelen te gebruiken, omdat deze het systeem niet beschrijven, maar slechts een specifiek geval, wat op de lange termijn zal leiden tot vragen als: "Waarom verschilt deze host van de anderen?", een antwoord dat niet altijd gemakkelijk te vinden is.
Verbindingsvariabelen
Dat betreft echter de eigenschappenvariabelen, maar hoe zit het met de verbindingsvariabelen?
Het verschil is dat zij dezelfde waarde moeten hebben in verschillende groepen.
In het begin was er gebruik maken van een monsterachtige constructie als:
hostvars[groups['bbauth'][0]]['auth_bind_port'], maar dat werd al snel afgewezen
omdat het nadelen heeft. Ten eerste, de omvang. Ten tweede, de afhankelijkheid van een specifieke host in de groep. Ten derde, het is noodzakelijk om feiten van alle hosts te verzamelen voordat je met de uitrol begint, als we geen foutmelding voor een ongedefinieerde variabele willen krijgen.
Uiteindelijk is besloten om verbindingsvariabelen te gebruiken.
Verbindingsvariabelen — dit zijn variabelen die behoren tot de playbook en nodig zijn voor de verbinding tussen systeemobjecten.
De verbindingsvariabelen worden ingevuld in de algemene systeemvariabelen group_vars/all/vars en ontstaan door alle variabelen van luisteraars uit elke groep te extraheren en de groepsnaam vooraan de variabele toe te voegen waarin de luisteraar is geëxtraheerd.
Op deze manier wordt consistentie en het vermijden van overlapping in namen gewaarborgd.
Laten we de variabelen uit het bovenstaande voorbeeld verbinden:
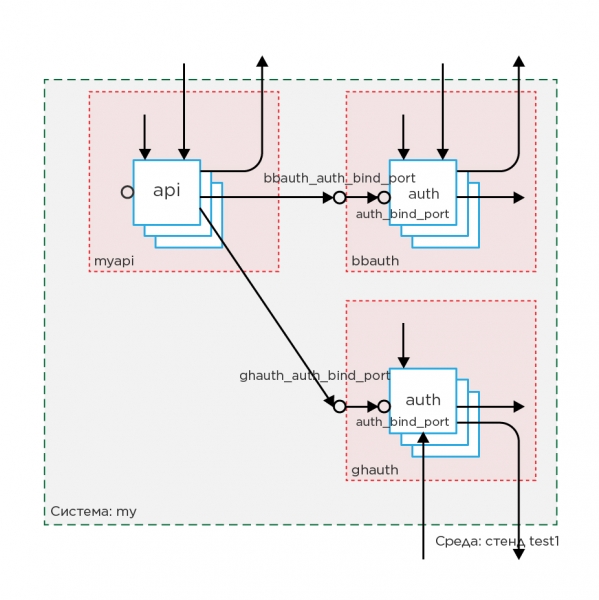
Stel dat we variabelen hebben die van elkaar afhankelijk zijn:
# roles/api/defaults:
# Переменная запроса
api_auth1_address: "http://example.com:80"
api_auth2_address: "http://example2.com:80"

# roles/auth/defaults:
# Переменная слушатель
auth_bind_port: "20000"
Laten we alle luisteraars in de algemene variabelen extraheren group_vars/all/vars en de groepsnaam aan de naam toevoegen:
# group_vars/all/vars
bbauth_auth_bind_port: "20000"
ghauth_auth_bind_port: "30000"

# group_vars/bbauth/vars
auth_bind_port: "{{ bbauth_auth_bind_port }}"

# group_vars/ghauth/vars
auth_bind_port: "{{ ghauth_auth_bind_port }}"

# group_vars/myapi/vars
api_auth1_address: "http://{{ bbauth_auth_service_name }}:{{ bbauth_auth_bind_port }}"
api_auth2_address: "http://{{ ghauth_auth_service_name }}:{{ ghauth_auth_bind_port }}"
Nu kunnen we, door de waarde van de connector te veranderen, zeker zijn dat de aanvraag naar dezelfde locatie gaat waar de poort zich bevindt.
Code Stijl
- Aangezien rollen en groepen verschillende objecten in het systeem zijn, moeten ze verschillende namen hebben, zodat de verbindingsvariabelen duidelijk aangeven dat ze behoren tot een specifieke groep servers, en niet tot een rol in het systeem.
Omgevingsafhankelijke bestanden
In rollen kunnen bestanden worden gebruikt die van omgeving tot omgeving verschillen.
Een voorbeeld van dergelijke bestanden zijn SSL-certificaten. Het is niet erg handig om ze in tekstvorm
in een variabele op te slaan. Het is echter handig om het pad naar hen binnen een variabele op te slaan.
Gebruik bijvoorbeeld de variabele api_ssl_key_file: "/path/to/file".
Aangezien het duidelijk is dat het certificaat van de sleutel zal veranderen afhankelijk van de omgeving, is dit een omgevingsafhankelijke variabele, en moet deze dus in het bestand
group_vars/myapi/vars van variabelen worden opgeslagen, met als waarde ‘ter illustratie’.
In dit geval is het het handigst om het sleutelbestand in de playbook-repository op te slaan op het pad
files/prod/certs/myapi.key, waardoor de waarde van de variabele wordt:
api_ssl_key_file: "prod/certs/myapi.key". Het voordeel is dat de mensen die verantwoordelijk zijn voor het uitrollen van het systeem op een specifieke stand ook een eigen plek in de repository hebben voor het opslaan van hun bestanden. Tegelijkertijd blijft de mogelijkheid bestaan om het absolute pad naar het certificaat op de server op te geven, voor het geval de certificaten door een ander systeem worden geleverd.
Meerdere stands in één omgeving
Er is vaak behoefte om meerdere vrijwel identieke omgevingen in één omgeving met minimale verschillen te implementeren. In dat geval splitsen we omgevingsgebonden variabelen op in die welke niet veranderen binnen deze omgeving en die welke wel veranderen. We plaatsen de laatste rechtstreeks in de inventarissbestanden. Na deze manipulatie is het mogelijk om nog een inventaris te maken in de omgeving directory.
Het zal de inventaris group_vars hergebruiken en ook de mogelijkheid hebben om enkele variabelen direct naar behoefte te overschrijven.
De definitieve mappenstructuur voor het implementatieproject:
mydeploy                        # Implementatiedirectory
├── deploy.yml                  # Implementatieplaybook
├── files                       # Directory voor implementatiefiles
│   ├── prod                    # Directory voor omgevingsgebonden files van stand prod
│   │   └── certs               #
│   │       └── myapi.key       #
│   └── test1                   # Directory voor omgevingsgebonden files van stand test1
├── group_vars                  # Directory van variabelen van het playbook
│   ├── all.yml                 # Bestand voor systeemoverkoepelende variabelen
│   ├── myapi.yml               # Bestand voor variabelen van de groep myapi
│   ├── bbauth.yml              #
│   └── ghauth.yml              #
└── inventories                 #
    ├── prod                    # Directory voor omgeving prod
    │   ├── group_vars          # Directory voor inventarisvariabelen
    │   │   ├── myapi           #
    │   │   │   ├── vars.yml    # Omgevingsgebonden variabelen van de groep myapi
    │   │   │   └── vault.yml   # Geheimen (altijd omgevingsgebonden)
    │   │   ├── bbauth          #
    │   │   │   ├── vars.yml    #
    │   │   │   └── vault.yml   #
    │   │   └── ghauth          #
    │   │       ├── vars.yml    #
    │   │       └── vault.yml   #
    │   └── prod.ini            # Inventaris van stand prod
    └── test                    # Directory voor omgeving test
        ├── group_vars          #
        │   ├── myapi           #
        │   │   ├── vars.yml    #
        │   │   └── vault.yml   #
        │   ├── bbauth          #
        │   │   ├── vars.yml    #
        │   │   └── vault.yml   #
        │   └── ghauth          #
        │       ├── vars.yml    #
        │       └── vault.yml   #
        ├── test1.ini           # Inventaris van stand test1 in omgeving test
        └── test2.ini           # Inventaris van stand test2 in omgeving test
Samenvatting
Na het organiseren van de variabelen volgens het artikel: elk bestand met variabelen is verantwoordelijk voor een bepaalde taak. En aangezien een bestand specifieke taken heeft, is het mogelijk om iemand verantwoordelijk te stellen voor de juistheid van elk bestand. Bijvoorbeeld, de ontwikkelaar van de systeemimplementatie is verantwoordelijk voor de juiste invulling van de playbook-variabelen, terwijl de beheerder die het in de inventaris beschreven stand onderhoudt, verantwoordelijk is voor de invulling van de inventarisvariabelen.
Rollen zijn een zelfstandige eenheid van ontwikkeling geworden met een eigen interface, wat de ontwikkelaar van de rol in staat stelde om mogelijkheden te ontwikkelen in plaats van de rol aan het systeem aan te passen. Dit probleem deed zich vooral voor bij gemeenschappelijke rollen voor alle systemen binnen de organisatie.
Systeembeheerders hoeven zich niet langer in de code van de implementatie te verdiepen. Alles wat ze nodig hebben voor een succesvolle implementatie is het invullen van bestanden met omgeving-specifieke variabelen.
Literatuur
Auteur
Kaljuzhny Denis Alexandrovich
Bron: habr.com
