

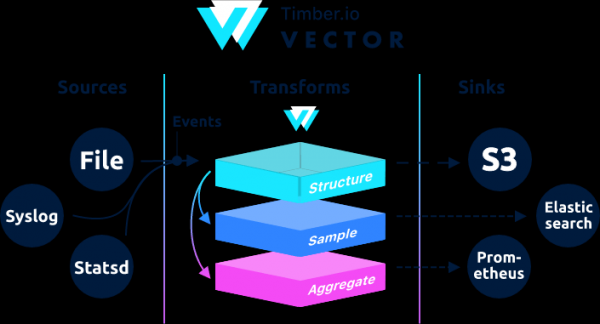
, bedoeld om gegevens van logs, metrics en evenementen te verzamelen, om te zetten en te verzenden.
→
Schreven in de programmeertaal Rust, onderscheidt het zich door hoge prestaties en laag geheugengebruik in vergelijking met alternatieven. Bovendien is er veel aandacht besteed aan functies gerelateerd aan correctheid, met name de mogelijkheid om niet-verzonden gebeurtenissen in een buffer op schijf op te slaan en bestanden te roteren.
Architectonisch gezien is Vector een evenementenrouter die berichten van één of meerdere bronnen, optioneel toepassen van transformaties, en deze naar één of meerdere stroombronnen.
Vector is een vervanging voor filebeat en logstash, het kan beide rollen vervullen (logs ontvangen en verzenden), meer hierover in hun .
Als in Logstash de keten is opgebouwd als input → filter → output, dan is dat in Vector → →
Voorbeelden zijn te vinden in de documentatie.
Deze handleiding is een herschreven versie van . In de origineel handleiding is er geoip verwerking. Tijdens mijn test met geoip vanuit het interne netwerk gaf Vector een foutmelding.
Aug 05 06:25:31.889 DEBUG transform{name=nginx_parse_rename_fields type=rename_fields}: vector::transforms::rename_fields: Veld bestaat niet veld=«geoip.country_name» rate_limit_secs=30Als iemand geoip moet verwerken, neem dan contact op met de originele handleiding van .
We gaan de koppeling Nginx (Access logs) → Vector (Client | Filebeat) → Vector (Server | Logstash) → apart in Clickhouse en apart Elasticsearch instellen. We installeren 4 servers. Hoewel we met 3 servers kunnen afkomen.
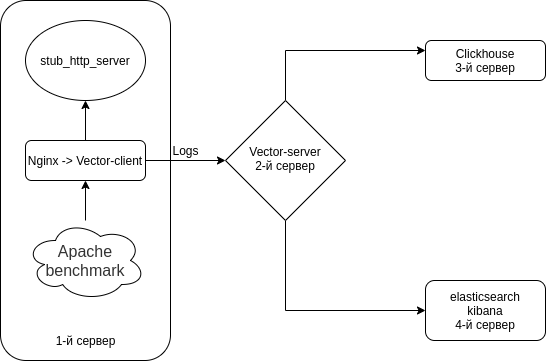
Het schema ziet er ongeveer zo uit.
Schakel Selinux uit op al uw servers
sed -i 's/^SELINUX=.*\/SELINUX=disabled\/g' \/etc\/selinux\/config
reboot
Installeer de HTTP-server emulatie + hulpprogramma's op alle servers
We gaan gebruikmaken van een HTTP-server emulator: van
Nodejs-stub-server heeft geen rpm. maken we een rpm. De rpm zal worden gebouwd met behulp van
Voeg de repository antonpatsev/nodejs-stub-server toe
yum -y install yum-plugin-copr epel-release
yes | yum copr enable antonpatsev/nodejs-stub-server
Installeer nodejs-stub-server, Apache benchmark en de terminal multiplexer screen op alle servers
yum -y install stub_http_server screen mc httpd-tools screenIk heb de responstijd van stub_http_server in het bestand \/var\/lib\/stub_http_server\/stub_http_server.js aangepast zodat er meer logs zijn.
var max_sleep = 10;Laten we stub_http_server starten.
systemctl start stub_http_server
systemctl enable stub_http_serverop server 3
ClickHouse maakt gebruik van de SSE 4.2 instructieset, dus tenzij anders vermeld, wordt ondersteuning op de gebruikte processor een aanvullende systeemvereiste. Hier is de opdracht om te controleren of de huidige processor SSE 4.2 ondersteunt:
grep -q sse4_2 /proc/cpuinfo && echo "SSE 4.2 ondersteund" || echo "SSE 4.2 niet ondersteund"Eerst moet je het officiële repository inschakelen:
sudo yum install -y yum-utils
sudo rpm --import https://repo.clickhouse.tech/CLICKHOUSE-KEY.GPG
sudo yum-config-manager --add-repo https://repo.clickhouse.tech/rpm/stable/x86_64
Voer de volgende commando's uit om de pakketten te installeren:
sudo yum install -y clickhouse-server clickhouse-clientSta clickhouse-server toe om de netwerkinterface te beluisteren in het bestand /etc/clickhouse-server/config.xml
0.0.0.0Wijzig het loggingniveau van trace naar debug
debug
De compressie-instellingen zijn standaard:
min_compress_block_size  65536
max_compress_block_size  1048576
Voor het activeren van Zstd-compressie wordt aangeraden de configuratie niet te wijzigen, maar beter DDL toe te passen.
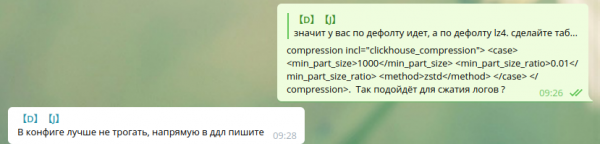
Ik heb geen informatie gevonden over hoe je zstd-compressie via DDL kunt toepassen. Daarom heb ik het gewoon gelaten zoals het was.
Collega's, als er iemand zstd-compressie in Clickhouse gebruikt — deel alsjeblieft de instructies.
Om de server als daemon te starten, voer je uit:
service clickhouse-server startLaten we nu doorgaan naar de Clickhouse-configuratie
We loggen in op Clickhouse
clickhouse-client -h 172.26.10.109 -m172.26.10.109 — IP van de server waar Clickhouse is geïnstalleerd.
Laten we de database vector aanmaken
CREATE DATABASE vector;Laten we controleren of de database bestaat.
show databases;We maken de tabel vector.logs aan.
/* Это таблица где хранятся логи как есть */

CREATE TABLE vector.logs
(
    `node_name` String,
    `timestamp` DateTime,
    `server_name` String,
    `user_id` String,
    `request_full` String,
    `request_user_agent` String,
    `request_http_host` String,
    `request_uri` String,
    `request_scheme` String,
    `request_method` String,
    `request_length` UInt64,
    `request_time` Float32,
    `request_referrer` String,
    `response_status` UInt16,
    `response_body_bytes_sent` UInt64,
    `response_content_type` String,
    `remote_addr` IPv4,
    `remote_port` UInt32,
    `remote_user` String,
    `upstream_addr` IPv4,
    `upstream_port` UInt32,
    `upstream_bytes_received` UInt64,
    `upstream_bytes_sent` UInt64,
    `upstream_cache_status` String,
    `upstream_connect_time` Float32,
    `upstream_header_time` Float32,
    `upstream_response_length` UInt64,
    `upstream_response_time` Float32,
    `upstream_status` UInt16,
    `upstream_content_type` String,
    INDEX idx_http_host request_http_host TYPE set(0) GRANULARITY 1
)
ENGINE = MergeTree()
PARTITION BY toYYYYMMDD(timestamp)
ORDER BY timestamp
TTL timestamp + toIntervalMonth(1)
SETTINGS index_granularity = 8192;
Laten we controleren of de tabellen zijn aangemaakt. We starten clickhouse-client en voeren een query uit.
Laten we naar de database vector gaan.
use vector;

Ok.

0 rows in set. Elapsed: 0.001 sec.
Laten we de tabellen bekijken.
show tables;

┌─name────────────────┐
│ logs                │
└─────────────────────┘
Installatie van Elasticsearch op de vierde server voor het verzenden van dezelfde gegevens naar Elasticsearch ter vergelijking met Clickhouse
Voeg de publieke rpm sleutel toe
rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearchLaten we 2 repositories aanmaken:
/etc/yum.repos.d/elasticsearch.repo
[elasticsearch]
name=Elasticsearch repository voor 7.x pakketten
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=0
autorefresh=1
type=rpm-md
/etc/yum.repos.d/kibana.repo
[kibana-7.x]
name=Kibana repository voor 7.x pakketten
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md
Laten we Elasticsearch en Kibana installeren
yum install -y kibana elasticsearchOmdat het een exemplaar zal zijn, moet je in het bestand /etc/elasticsearch/elasticsearch.yml toevoegen:
discovery.type: single-nodeOm ervoor te zorgen dat vector gegevens naar Elasticsearch kan verzenden vanaf een andere server, wijzigen we network.host.
network.host: 0.0.0.0Om verbinding te maken met Kibana, wijzigen we de parameter server.host in het bestand /etc/kibana/kibana.yml
server.host: "0.0.0.0"We starten en zetten Elasticsearch in de autostart
systemctl enable elasticsearch
systemctl start elasticsearch
en Kibana
systemctl enable kibana
systemctl start kibana
Configuratie van Elasticsearch voor single-node modus 1 shard, 0 replica. Waarschijnlijk heb je een cluster met veel servers en hoef je dit niet te doen.
Voor toekomstige indexen vernieuwen we het standaard sjabloon:
curl -X PUT http://localhost:9200/_template/default -H 'Content-Type: application/json' -d '{"index_patterns": ["*"],"order": -1,"settings": {"number_of_shards": "1","number_of_replicas": "0"}}' Installatie als vervanging voor Logstash op server 2
yum install -y https://packages.timber.io/vector/0.9.X/vector-x86_64.rpm mc httpd-tools screenWe zullen Vector instellen als vervanging voor Logstash. We bewerken het bestand /etc/vector/vector.toml
# /etc/vector/vector.toml

data_dir = "/var/lib/vector"

[sources.nginx_input_vector]
  # General
  type                          = "vector"
  address                       = "0.0.0.0:9876"
  shutdown_timeout_secs         = 30

[transforms.nginx_parse_json]
  inputs                        = [ "nginx_input_vector" ]
  type                          = "json_parser"

[transforms.nginx_parse_add_defaults]
  inputs                        = [ "nginx_parse_json" ]
  type                          = "lua"
  version                       = "2"

  hooks.process = """
  function (event, emit)

    function split_first(s, delimiter)
      result = {};
      for match in (s..delimiter):gmatch("(.-)"..delimiter) do
          table.insert(result, match);
      end
      return result[1];
    end

    function split_last(s, delimiter)
      result = {};
      for match in (s..delimiter):gmatch("(.-)"..delimiter) do
          table.insert(result, match);
      end
      return result[#result];
    end

    event.log.upstream_addr             = split_first(split_last(event.log.upstream_addr, ', '), ':')
    event.log.upstream_bytes_received   = split_last(event.log.upstream_bytes_received, ', ')
    event.log.upstream_bytes_sent       = split_last(event.log.upstream_bytes_sent, ', ')
    event.log.upstream_connect_time     = split_last(event.log.upstream_connect_time, ', ')
    event.log.upstream_header_time      = split_last(event.log.upstream_header_time, ', ')
    event.log.upstream_response_length  = split_last(event.log.upstream_response_length, ', ')
    event.log.upstream_response_time    = split_last(event.log.upstream_response_time, ', ')
    event.log.upstream_status           = split_last(event.log.upstream_status, ', ')

    if event.log.upstream_addr == "" then
        event.log.upstream_addr = "127.0.0.1"
    end

    if (event.log.upstream_bytes_received == "-" or event.log.upstream_bytes_received == "") then
        event.log.upstream_bytes_received = "0"
    end

    if (event.log.upstream_bytes_sent == "-" or event.log.upstream_bytes_sent == "") then
        event.log.upstream_bytes_sent = "0"
    end

    if event.log.upstream_cache_status == "" then
        event.log.upstream_cache_status = "DISABLED"
    end

    if (event.log.upstream_connect_time == "-" or event.log.upstream_connect_time == "") then
        event.log.upstream_connect_time = "0"
    end

    if (event.log.upstream_header_time == "-" or event.log.upstream_header_time == "") then
        event.log.upstream_header_time = "0"
    end

    if (event.log.upstream_response_length == "-" or event.log.upstream_response_length == "") then
        event.log.upstream_response_length = "0"
    end

    if (event.log.upstream_response_time == "-" or event.log.upstream_response_time == "") then
        event.log.upstream_response_time = "0"
    end

    if (event.log.upstream_status == "-" or event.log.upstream_status == "") then
        event.log.upstream_status = "0"
    end

    emit(event)

  end
  """

[transforms.nginx_parse_remove_fields]
    inputs                              = [ "nginx_parse_add_defaults" ]
    type                                = "remove_fields"
    fields                              = ["data", "file", "host", "source_type"]

[transforms.nginx_parse_coercer]

    type                                = "coercer"
    inputs                              = ["nginx_parse_remove_fields"]

    types.request_length = "int"
    types.request_time = "float"

    types.response_status = "int"
    types.response_body_bytes_sent = "int"

    types.remote_port = "int"

    types.upstream_bytes_received = "int"
    types.upstream_bytes_send = "int"
    types.upstream_connect_time = "float"
    types.upstream_header_time = "float"
    types.upstream_response_length = "int"
    types.upstream_response_time = "float"
    types.upstream_status = "int"

    types.timestamp = "timestamp"

[sinks.nginx_output_clickhouse]
    inputs   = ["nginx_parse_coercer"]
    type     = "clickhouse"

    database = "vector"
    healthcheck = true
    host = "http://172.26.10.109:8123" #  Адрес Clickhouse
    table = "logs"

    encoding.timestamp_format = "unix"

    buffer.type = "disk"
    buffer.max_size = 104900000
    buffer.when_full = "block"

    request.in_flight_limit = 20

[sinks.elasticsearch]
    type = "elasticsearch"
    inputs   = ["nginx_parse_coercer"]
    compression = "none"
    healthcheck = true
    # 172.26.10.116 - сервер где установен elasticsearch
    host = "http://172.26.10.116:9200"
    index = "vector-%Y-%m-%d"
U kunt de sectie transforms.nginx_parse_add_defaults aanpassen.
Aangezien gebruikt deze configuraties voor een kleine CDN en daar kunnen in upstream_* meerdere waarden binnenkomen
Bijvoorbeeld:
"upstream_addr": "128.66.0.10:443, 128.66.0.11:443, 128.66.0.12:443"
"upstream_bytes_received": "-, -, 123"
"upstream_status": "502, 502, 200"
Als dit niet uw situatie is, kan deze sectie worden vereenvoudigd
Laten we de service-instellingen voor systemd aanmaken /etc/systemd/system/vector.service
# /etc/systemd/system/vector.service

[Unit]
Description=Vector
After=network-online.target
Requires=network-online.target

[Service]
User=vector
Group=vector
ExecStart=/usr/bin/vector
ExecReload=/bin/kill -HUP $MAINPID
Restart=no
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=vector

[Install]
WantedBy=multi-user.target
Na het aanmaken van de tabellen kan Vector worden gestart
systemctl enable vector
systemctl start vector
De logs van vector kunnen als volgt worden bekeken
journalctl -f -u vectorDe logs moeten dergelijke vermeldingen bevatten
INFO vector::topology::builder: Healthcheck: Geslaagd.
INFO vector::topology::builder: Healthcheck: Geslaagd.
Aan de client (Webserver) — server 1
Op de server met nginx moet ipv6 worden uitgeschakeld, omdat in de tabel logs in clickhouse het veld upstream_addr IPv4 wordt gebruikt, omdat ik ipv6 niet binnen het netwerk gebruik. Als ipv6 niet wordt uitgeschakeld, komen er fouten:
DB::Exception: Ongeldig IPv4-waarde.: (terwijl het waarde van sleutel upstream_addr werd gelezen)Misschien willen lezers ipv6-ondersteuning toevoegen.
We maken het bestand /etc/sysctl.d/98-disable-ipv6.conf aan
net.ipv6.conf.all.disable_ipv6 = 1
net.ipv6.conf.default.disable_ipv6 = 1
net.ipv6.conf.lo.disable_ipv6 = 1
Pas instellingen toe
sysctl --systemLaten we nginx installeren.
Ik heb het repository-bestand van nginx toegevoegd /etc/yum.repos.d/nginx.repo
[nginx-stable]
name=nginx stable repo
baseurl=http://nginx.org/packages/centos/$releasever/$basearch/
gpgcheck=1
enabled=1
gpgkey=https://nginx.org/keys/nginx_signing.key
module_hotfixes=true
Laten we het nginx-pakket installeren
yum install -y nginxAls eerste moeten we het logformaat in Nginx instellen in het bestand /etc/nginx/nginx.conf
user  nginx;
# u moet het aantal werkprocessen instellen op basis van uw CPU-kernen, nginx heeft geen baat bij meer dan dat
worker_processes auto; # sommige laatste versies berekenen dit automatisch

# aantal bestandsdescriptors dat door nginx wordt gebruikt
# de limiet voor de maximale FDs op de server wordt meestal door het besturingssysteem ingesteld.
# als u geen FD's instelt, worden de instellingen van het besturingssysteem gebruikt, wat standaard 2000 is
worker_rlimit_nofile 100000;

error_log  \/var\/log\/nginx\/error.log warn;
pid        \/var\/run\/nginx.pid;

# biedt de configuratiebestandscontext waarin de richtlijnen die verband houden met de connectieverwerking zijn gespecificeerd.
events {
    # bepaalt hoeveel clients per worker zullen worden bediend
    # max clients = worker_connections * worker_processes
    # max clients is ook beperkt door het aantal socketverbindingen dat beschikbaar is op het systeem (~64k)
    worker_connections 4000;

    # geoptimaliseerd om veel clients met elke thread te bedienen, essentieel voor linux -- voor testomgeving
    use epoll;

    # accepteer zoveel mogelijk verbindingen als mogelijk, kan workerverbindingen overstromen als ingesteld te laag -- voor testomgeving
    multi_accept on;
}

http {
    include       \/etc\/nginx\/mime.types;
    default_type  application\/octet-stream;

    log_format  main  '$remote_addr - $remote_user [$time_local] "$request" '
                      '$status $body_bytes_sent "$http_referer" '
                      '"$http_user_agent" "$http_x_forwarded_for"';

log_format vector escape=json
    '{'
        '"node_name":"nginx-vector",'
        '"timestamp":"$time_iso8601",'
        '"server_name":"$server_name",'
        '"request_full": "$request",'
        '"request_user_agent":"$http_user_agent",'
        '"request_http_host":"$http_host",'
        '"request_uri":"$request_uri",'
        '"request_scheme": "$scheme",'
        '"request_method":"$request_method",'
        '"request_length":"$request_length",'
        '"request_time": "$request_time",'
        '"request_referrer":"$http_referer",'
        '"response_status": "$status",'
        '"response_body_bytes_sent":"$body_bytes_sent",'
        '"response_content_type":"$sent_http_content_type",'
        '"remote_addr": "$remote_addr",'
        '"remote_port": "$remote_port",'
        '"remote_user": "$remote_user",'
        '"upstream_addr": "$upstream_addr",'
        '"upstream_bytes_received": "$upstream_bytes_received",'
        '"upstream_bytes_sent": "$upstream_bytes_sent",'
        '"upstream_cache_status":"$upstream_cache_status",'
        '"upstream_connect_time":"$upstream_connect_time",'
        '"upstream_header_time":"$upstream_header_time",'
        '"upstream_response_length":"$upstream_response_length",'
        '"upstream_response_time":"$upstream_response_time",'
        '"upstream_status": "$upstream_status",'
        '"upstream_content_type":"$upstream_http_content_type"'
    '}';

    access_log  \/var\/log\/nginx\/access.log  main;
    access_log  \/var\/log\/nginx\/access.json.log vector;      # Nieuwe log in json-formaat

    sendfile        on;
    #tcp_nopush     on;

    keepalive_timeout  65;

    #gzip  on;

    include \/etc\/nginx\/conf.d\/*.conf;
}
Om uw huidige configuratie niet te verstoren, staat Nginx meerdere richtlijnen access_log toe.
access_log  \/var\/log\/nginx\/access.log  main;            # Standaard log
access_log  \/var\/log\/nginx\/access.json.log vector;      # Nieuwe log in json-formaat
Vergeet niet een regel toe te voegen in logrotate voor nieuwe logs (als het logbestand niet eindigt op .log).
Verwijder default.conf uit \/etc\/nginx\/conf.d\/
rm -f \/etc\/nginx\/conf.d\/default.confVoeg virtuele host toe \/etc\/nginx\/conf.d\/vhost1.conf
server {
    listen 80;
    server_name vhost1;
    location \/ {
        proxy_pass http:\/\/172.26.10.106:8080;
    }
}
We voegen een virtuele host toe \/etc\/nginx\/conf.d\/vhost2.conf
server {
    listen 80;
    server_name vhost2;
    location \/ {
        proxy_pass http:\/\/172.26.10.108:8080;
    }
}
We voegen een virtuele host toe \/etc\/nginx\/conf.d\/vhost3.conf
server {
    listen 80;
    server_name vhost3;
    location \/ {
        proxy_pass http:\/\/172.26.10.109:8080;
    }
}
We voegen een virtuele host toe \/etc\/nginx\/conf.d\/vhost4.conf
server {
    listen 80;
    server_name vhost4;
    location \/ {
        proxy_pass http:\/\/172.26.10.116:8080;
    }
}
We voegen de virtuele hosts toe in het bestand \/etc\/hosts (172.26.10.106 ip van de server waar nginx is geïnstalleerd) op alle servers:
172.26.10.106 vhost1
172.26.10.106 vhost2
172.26.10.106 vhost3
172.26.10.106 vhost4
En als alles gereed is, dan
nginx -t
systemctl restart nginx
Laten we nu de software installeren
yum install -y https:\/\/packages.timber.io\/vector\/0.9.X\/vector-x86_64.rpmWe creëren een configuratiebestand voor systemd \/etc\/systemd\/system\/vector.service
[Unit]
Description=Vector
After=network-online.target
Requires=network-online.target

[Service]
User=vector
Group=vector
ExecStart=\u002Fusr\u002Fbin\u002Fvector
ExecReload=\u002Fbin\u002Fkill -HUP $MAINPID
Restart=no
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=vector

[Install]
WantedBy=multi-user.target
En we configureren de vervangingen voor Filebeat in de configuratie \/etc\/vector\/vector.toml. Het IP-adres 172.26.10.108 is het IP-adres van de log server (Vector-Server)
data_dir = "\/var\/lib\/vector"

[sources.nginx_file]
  type                          = "file"
  include                       = [ "\/var\/log\/nginx\/access.json.log" ]
  start_at_beginning            = false
  fingerprinting.strategy       = "device_and_inode"

[sinks.nginx_output_vector]
  type                          = "vector"
  inputs                        = [ "nginx_file" ]

  address                       = "172.26.10.108:9876"
Vergeet niet de gebruiker vector toe te voegen aan de juiste groep zodat hij de logbestanden kan lezen. Bijvoorbeeld, nginx in centos maakt logs met de groep adm rechten.
usermod -a -G adm vectorLaten we de vector service starten
systemctl enable vector
systemctl start vector
De logs van vector kunnen als volgt worden bekeken
journalctl -f -u vectorIn de logs moet er een dergelijke vermelding zijn
INFO vector::topology::builder: Healthcheck: Geslaagd.Belastingstest
De test wordt uitgevoerd met behulp van Apache benchmark.
Op alle servers is het pakket httpd-tools geïnstalleerd
We starten de test met behulp van Apache benchmark vanaf 4 verschillende servers in screen. We starten eerst de terminal multiplexer screen, en daarna starten we de test met behulp van Apache benchmark. Hoe je met screen werkt vind je in .
Vanaf server 1
while true; do ab -H "User-Agent: 1server" -c 100 -n 10 -t 10 http:\/\/vhost1\/[; sleep 1; doneVanaf server 2
while true; do ab -H "User-Agent: 2server" -c 100 -n 10 -t 10 http:\/\/vhost2\/[; sleep 1; doneVanaf server 3
while true; do ab -H "User-Agent: 3server" -c 100 -n 10 -t 10 http:\/\/vhost3\/[; sleep 1; doneVanaf server 4
while true; do ab -H "User-Agent: 4server" -c 100 -n 10 -t 10 http:\/\/vhost4\/[; sleep 1; doneLaten we de gegevens controleren in Clickhouse
We loggen in op Clickhouse
clickhouse-client -h 172.26.10.109 -mWe voeren een SQL-query uit
SELECT * FROM vector.logs;

┌─node_name────┬───────────timestamp─┬─server_name─┬─user_id─┬─request_full───┬─request_user_agent─┬─request_http_host─┬─request_uri─┬─request_scheme─┬─request_method─┬─request_length─┬─request_time─┬─request_referrer─┬─response_status─┬─response_body_bytes_sent─┬─response_content_type─┬───remote_addr─┬─remote_port─┬─remote_user─┬─upstream_addr─┬─upstream_port─┬─upstream_bytes_received─┬─upstream_bytes_sent─┬─upstream_cache_status─┬─upstream_connect_time─┬─upstream_header_time─┬─upstream_response_length─┬─upstream_response_time─┬─upstream_status─┬─upstream_content_type─┐
│ nginx-vector │ 2020-08-07 04:32:42 │ vhost1      │         │ GET \/ HTTP\/1.0 │ 1server            │ vhost1            │ \/           │ http           │ GET            │             66 │        0.028 │                  │             404 │                       27 │                       │ 172.26.10.106 │       45886 │             │ 172.26.10.106 │             0 │                     109 │                  97 │ DISABLED              │                     0 │                0.025 │                       27 │                  0.029 │             404 │                       │
└──────────────┴─────────────────────┴─────────────┴─────────┴────────────────┴────────────────────┴───────────────────┴─────────────┴────────────────┴────────────────┴────────────────┴──────────────┴──────────────────┴─────────────────┴──────────────────────────┴───────────────────────┴───────────────┴─────────────┴─────────────┴───────────────┴───────────────┴─────────────────────────┴─────────────────────┴───────────────────────┴───────────────────────┴──────────────────────┴──────────────────────────┴────────────────────────┴─────────────────┴───────────────────────
Laten we de grootte van tabellen in Clickhouse bekijken
select concat(database, '.', table)                         as table,
       formatReadableSize(sum(bytes))                       as size,
       sum(rows)                                            as rows,
       max(modification_time)                               as latest_modification,
       sum(bytes)                                           as bytes_size,
       any(engine)                                          as engine,
       formatReadableSize(sum(primary_key_bytes_in_memory)) as primary_keys_size
from system.parts
where active
group by database, table
order by bytes_size desc;
Laten we bekijken hoeveel ruimte de logs in Clickhouse innemen.
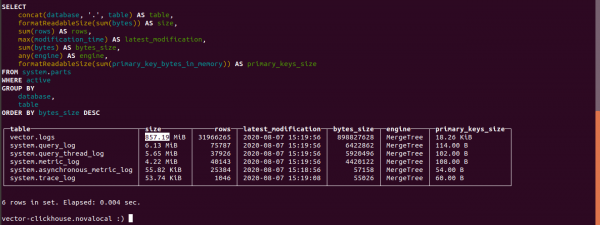
De grootte van de tabel logs is 857,19 MB.
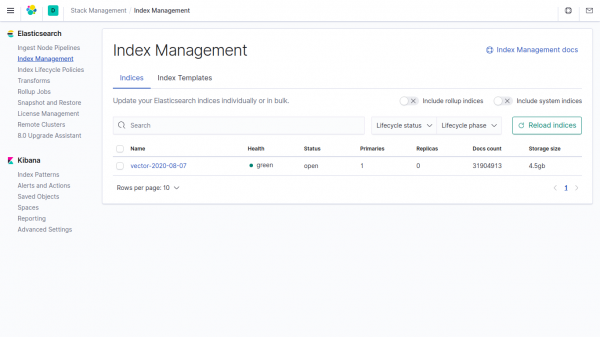
Dezelfde gegevens in de index in Elasticsearch nemen 4,5 GB in beslag.
Als je niet aangeeft dat vector in de parameters in Clickhouse gegevens in beslag neemt, is dat 4500/857,19 = 5,24 keer minder dan in Elasticsearch.
In het vector veld wordt compressie standaard gebruikt.
Telegram-chat over
Telegram-chat over
Telegram-chat over ""
Bron: habr.com
