

Aangezien ClickHouse een gespecialiseerd systeem is, is het belangrijk om rekening te houden met de kenmerken van de architectuur bij het gebruik ervan. In deze presentatie zal Alexey voorbeelden geven van typische fouten bij het gebruik van ClickHouse die kunnen leiden tot inefficiëntie. Aan de hand van praktijkvoorbeelden wordt aangetoond hoe de keuze voor een bepaalde gegevensverwerkingsschema de prestaties aanzienlijk kan beïnvloeden.
Hallo allemaal! Mijn naam is Alexey, en ik maak ClickHouse.
Allereerst wil ik jullie geruststellen, ik ga jullie vandaag niet vertellen wat ClickHouse is. Eerlijk gezegd, ben ik daar een beetje moe van. Ik vertel elke keer wat het is. En waarschijnlijk weet iedereen het al.
In plaats daarvan ga ik het hebben over de mogelijke valkuilen, dat wil zeggen, hoe je ClickHouse verkeerd kunt gebruiken. Je hoeft daar niet bang voor te zijn, want we ontwikkelen ClickHouse als een systeem dat eenvoudig, gebruiksvriendelijk en out-of-the-box werkt. Gewoon installeren en klaar, geen problemen.
Toch moet je rekening houden met het feit dat dit een gespecialiseerd systeem is en je gemakkelijk kunt tegenkomen dat je in een ongebruikelijk gebruiksscenario terechtkomt, dat dit systeem uit zijn comfortzone haalt.
Dus, wat zijn de valkuilen? Voor het grootste deel zal ik het hebben over voor de hand liggende dingen. Voor iedereen is het duidelijk, iedereen begrijpt het en kan zich verheugen dat ze zo slim zijn, en wie het niet begrijpt, zal iets nieuws leren.
Het eerste en eenvoudigste voorbeeld, dat helaas vaak voorkomt, is een grote hoeveelheid inserts met kleine batches, dat wil zeggen, een groot aantal kleine inserts.
Als we kijken naar hoe ClickHouse een insert uitvoert, kun je met één verzoek een datastroom van een terabyte verzenden. Dat is geen probleem.
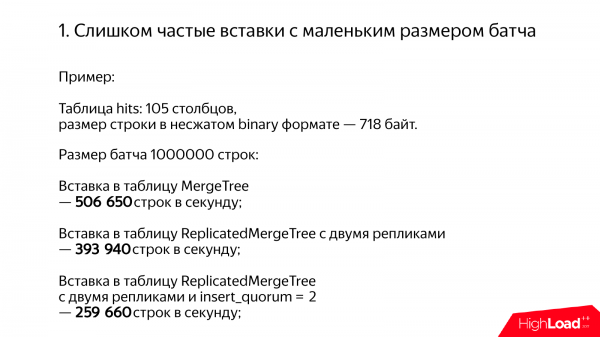
Laten we eens kijken naar wat de typische prestaties zouden zijn. Bijvoorbeeld, we hebben een tabel met gegevens van Yandex.Metrica. Hits. 105 kolommen. 700 bytes in ongecomprimeerde vorm. We zullen op een goede manier batches van één miljoen rijen invoegen.
We voegen in een MergeTree-tabel in, dat resulteert in een snelheid van een half miljoen rijen per seconde. Geweldig. In een gerepliceerde tabel is het iets minder, ongeveer 400.000 rijen per seconde.
En als je quorum-insert inschakelt, krijg je iets minder, maar nog steeds een behoorlijke prestatie van 250.000 rijen per seconde. Quorum-insert is een niet-gedocumenteerde mogelijkheid in ClickHouse*.
* voor de status in 2020, .
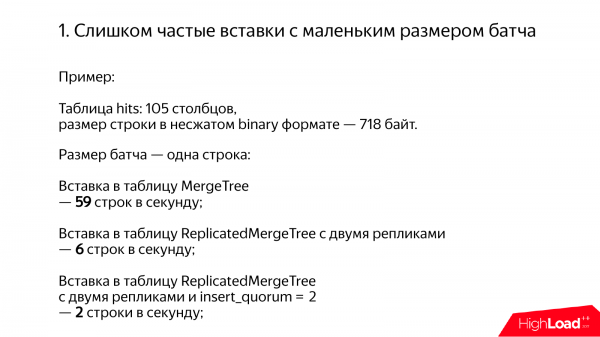
Wat gebeurt er als je het slecht doet? We voegen één regel tegelijk toe aan de MergeTree-tabel en dat levert 59 rijen per seconde op. Dat is 10.000 keer traag. In ReplicatedMergeTree – 6 rijen per seconde. En als er ook nog een quorumsysteem inschakelt, dan krijg je slechts 2 rijen per seconde. Voor mijn gevoel is dat gewoon belachelijk. Hoe kan je zo vertragen? Zelfs op mijn T-shirt staat dat ClickHouse niet traag moet zijn. Maar het gebeurt toch af en toe.
Eigenlijk is dit onze tekortkoming. We hadden dit gewoon goed kunnen doen zodat alles normaal werkte, maar dat hebben we niet gedaan. En we hebben dat niet gedaan omdat het voor onze situatie niet nodig was. We hadden al batches. Gewoon, we kregen batches binnen en alles werkte prima. Maar natuurlijk zijn er allerlei scenario's mogelijk. Bijvoorbeeld, als je een hoop servers hebt waarop gegevens worden gegenereerd. En ze voegen gegevens niet zo vaak toe, maar er zijn nog steeds frequente invoegingen. En je moet dat op de een of andere manier vermijden.
Technisch gezien komt het erop neer dat wanneer je een insert in ClickHouse doet, de gegevens niet in een memtable komen. We hebben zelfs geen echte log structure MergeTree, maar gewoon een MergeTree, omdat er geen log of memTable is. We schrijven de gegevens gewoon direct naar het bestandssysteem, al gespreid over kolommen. En als je 100 kolommen hebt, moet je meer dan 200 bestanden in een aparte directory schrijven. Dit is behoorlijk zwaar.
En dan rijst de vraag: "Hoe doe je het goed?", als er zo'n situatie is dat je toch gegevens in ClickHouse moet opslaan.
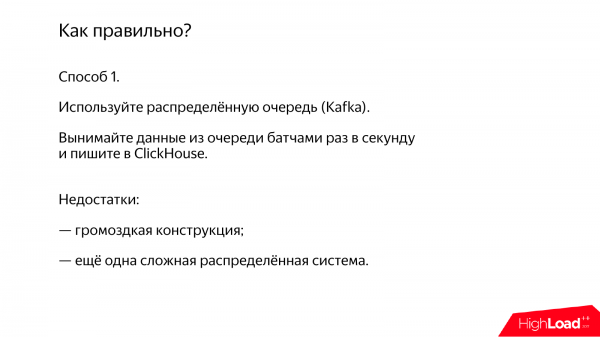
Methode 1. Dit is de eenvoudigste manier. Gebruik een of andere gedistribueerde queue. Bijvoorbeeld, Kafka. Je haalt gewoon gegevens uit Kafka, batcht het om de seconde. En alles zal goed zijn, je schrijft het en alles werkt normaal.
De nadelen zijn dat Kafka nog een andere complexe gedistribueerde systeem is. Ik begrijp het nog als je al Kafka in je bedrijf hebt. Dat is goed, dat is handig. Maar als je het niet hebt, moet je drie keer nadenken voordat je nog een gedistribueerd systeem in je project sleurt. Daarom is het de moeite waard om alternatieven te overwegen.
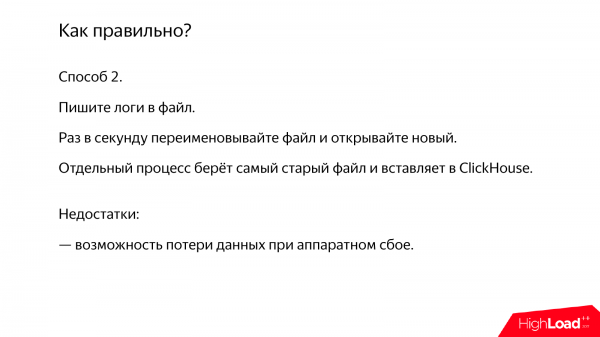
Methode 2. Dit is zo'n old-school alternatief en tegelijkertijd heel eenvoudig. U heeft een server die uw logs genereert. Deze server schrijft uw logs naar een bestand. En eens per seconde hernoemen we bijvoorbeeld dit bestand en openen een nieuw bestand. Een afzonderlijk script, hetzij via cron, hetzij een daemon, pakt het oudste bestand en schrijft het naar ClickHouse. Als we logs elke seconde schrijven, zal alles perfect zijn.
Maar het nadeel van deze methode is dat als uw server waarop de logs worden gegenereerd ergens verdwijnt, de gegevens ook verloren gaan.
Methode 3. Er is nog een interessante manier die helemaal zonder tijdelijke bestanden werkt. Bijvoorbeeld, u heeft een soort advertentie-draaier of een andere interessante daemon die gegevens genereert. U kunt een batch gegevens verzamelen direct in het RAM, in de buffer. En wanneer er voldoende tijd verstreken is, legt u deze buffer opzij, maakt u een nieuwe aan, en in een aparte thread voegt u wat al is verzameld in ClickHouse in.
Aan de andere kant verdwijnen gegevens ook bij kill -9. Als uw server crasht, verliest u deze gegevens. En er is nog een probleem: als u niet in de database kunt schrijven, zullen de gegevens accumuleren in het RAM. En ofwel raakt het RAM vol, of u verliest gewoon de gegevens.
Methode 4. Nog een interessante manier. U heeft een of andere server-proces. En deze kan gegevens onmiddellijk naar ClickHouse sturen, maar dit moet in één verbinding gebeuren. Bijvoorbeeld, u stuurt een http-verzoek met transfer-encoding: chunked met een insert. En genereert chunks niet te vaak, het is mogelijk om elke regel te verzenden, hoewel er overhead zal zijn bij het framen van deze gegevens.
Maar desondanks worden in dit geval de gegevens onmiddellijk naar ClickHouse gestuurd. En ClickHouse zal ze zelf buffer.
Maar ook hier ontstaan problemen. Nu verliest u gegevens, onder andere wanneer uw proces crasht en, als het ClickHouse-proces crasht, omdat dit een onafgemaakte insert zal zijn. Inserts in ClickHouse zijn atomair tot een bepaalde gespecificeerde drempel in aantal rijen. In principe is het een interessante manier. Dit kan ook worden gebruikt.
Methode 5. Hier is nog een interessante methode. Dit is een door de community ontwikkelde server voor batchgegevensverwerking. Ik heb het zelf niet bekeken, dus ik kan niets garanderen. Overigens worden er ook geen garanties gegeven voor ClickHouse zelf. Dit is ook open source, maar aan de andere kant, u kunt gewend zijn geraakt aan een bepaalde kwaliteitsnorm die wij proberen te waarborgen. Maar voor dit ding – ik weet het niet, ga naar GitHub, bekijk de code. Misschien hebben ze iets goeds geschreven.
* per de status in 2020, moet ook worden overwogen .
Methode 6. Een andere methode is het gebruik van buffer-tabellen. De voordelen van deze methode zijn dat het erg eenvoudig is om te beginnen. U maakt een buffer-tabel aan en voegt daar gegevens aan toe.
Maar het nadeel is dat het probleem niet volledig wordt opgelost. Als u bij het invoeren van MergeTree-type gegevens per batch per seconde moet groeperen, moet u bij het invoeren in een buffer-tabel ten minste tot enkele duizenden per seconde groeperen. Als het meer dan 10.000 per seconde is, gaat het nog steeds slecht. En als u in batches invoert, ziet u dat het daar honderden duizenden rijen per seconde oplevert. En dat is al met behoorlijk zware gegevens.
En ook buffer-tabellen hebben geen log. Als er iets misgaat met uw server, gaan de gegevens verloren.
En als een bonus hebben we onlangs in ClickHouse de mogelijkheid gekregen om gegevens uit Kafka te halen. Er is een tabelengine – Kafka. U maakt het eenvoudigweg aan. En u kunt materialized views eraan koppelen. In dat geval haalt het zelf gegevens uit Kafka en voegt ze toe aan de tabellen die u nodig heeft.
En wat deze mogelijkheid vooral leuk maakt, is dat we het niet zelf hebben gedaan. Dit is een community-functie. En wanneer ik zeg "community-functie", zeg ik dat zonder enige minachting. We hebben de code gelezen, we hebben reviews gedaan, het moet normaal werken.
* per de status in 2020, was er vergelijkbare ondersteuning voor .
Wat kan nog ongemakkelijk of onverwacht zijn bij het invoeren van gegevens? Als u een insert values-query uitvoert en in de values bepaalde berekende expressies invoert. Bijvoorbeeld, now() – dit is ook een berekende expressie. En in dat geval moet ClickHouse de interpreter van deze expressies voor elke regel starten, en de prestaties zullen aanzienlijk afnemen. Het is beter om dit te vermijden.
* Momenteel is het probleem volledig opgelost, er is geen prestatie regressie meer bij het gebruik van expressies in VALUES.
Een ander voorbeeld waarin er mogelijk problemen kunnen optreden, is wanneer uw gegevens in één batch betrekking hebben op meerdere partities. Standaard zijn de partities in ClickHouse per maand. En als u een batch van een miljoen regels invoert en de gegevens over meerdere jaren verspreid zijn, dan heeft u tientallen partities. Dit is equivalent aan het hebben van batches van meerdere tientallen keren kleinere omvang, omdat ze binnen elkaar altijd eerst worden opgedeeld per partitie.
* Recentelijk is ondersteuning voor een compact formaat van stukjes en stukken in het geheugen met een write-ahead log in ClickHouse in experimentele modus toegevoegd, wat het probleem bijna volledig oplost.
Laten we nu naar het tweede soort probleem kijken - dat is datatypes.
Datatypes kunnen strikt of string zijn. String is wanneer u simpelweg hebt aangegeven dat al uw velden van het type string zijn. Dat is slecht. Dat moet je niet doen.
Laten we kijken hoe we het goed doen in gevallen waarin we willen zeggen dat een bepaald veld een string is en laat ClickHouse het zelf maar uitzoeken, ik maak me daar niet druk om. Maar het is nog steeds de moeite waard om enige inspanning te leveren.
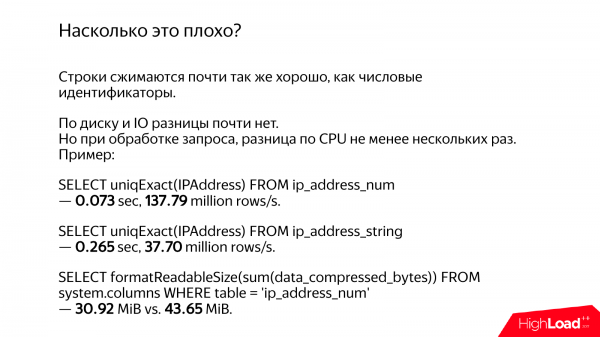
Bijvoorbeeld, we hebben een IP-adres. In het ene geval hebben we het als een string opgeslagen. Bijvoorbeeld, 192.168.1.1. En in het andere geval is het een getal van het type UInt32*. 32 bits is genoeg voor een IPv4-adres.
Ten eerste, vreemd genoeg, zullen de gegevens ongeveer even snel worden gecomprimeerd. Er zal een verschil zijn, natuurlijk, maar niet zo groot. Dus er zijn geen grote problemen met schijfinvoer en -uitvoer.
Maar er is een aanzienlijk verschil in de verweringstijd en de tijd die nodig is om de query uit te voeren.
Laten we het aantal unieke IP-adressen berekenen als ze als getallen worden opgeslagen. Dat resulteert in 137 miljoen rijen per seconde. Als hetzelfde in de vorm van strings is, dan 37 miljoen rijen per seconde. Ik weet niet waarom dit toeval zo is. Ik heb zelf deze queries uitgevoerd. Maar desalniettemin is het ongeveer 4 keer langzamer.
En als we de verschil in schijfruimte berekenen, is er ook een verschil. En het verschil is ongeveer een kwart, omdat er genoeg unieke IP-adressen zijn. En als er hier rijen waren met een klein aantal verschillende waarden, zouden ze zich in wezen in dezelfde ruimte door een woordenboek kunnen comprimeren.
En een viervoudig tijdsverschil op de weg ligt er niet zomaar. Misschien interesseert het je helemaal niet, maar als ik zo'n verschil zie, word ik er eerlijk gezegd een beetje treurig van.
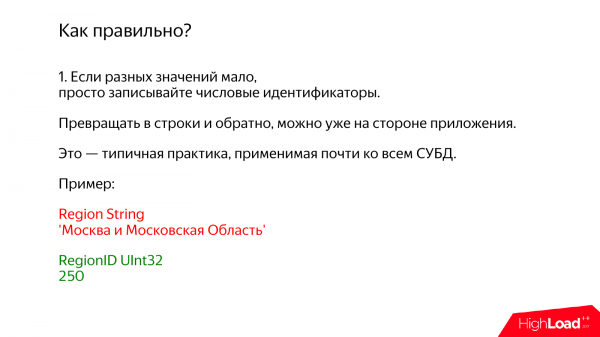
Laten we verschillende gevallen bekijken.
1. Een geval waarin je niet veel verschillende unieke waarden hebt. In dit geval gebruiken we een eenvoudige praktijk die je waarschijnlijk kent en die je voor elke database kunt toepassen. Dit is niet alleen relevant voor ClickHouse. Je schrijft simpelweg numerieke identificaties in de database. En het omzetten naar strings en weer terug kan al aan de kant van jouw applicatie gebeuren.
Stel dat je een regio hebt. En je probeert deze als een string op te slaan. En het zal er als volgt uitzien: Moskou en MO. En als ik zie dat er 'Moskou' staat, dan is dat nog niet zo erg, maar als daar ook MO bijstaat, dan wordt het een beetje treurig. Hoeveel bytes is dat wel niet?
In plaats daarvan schrijven we gewoon het getal Ulnt32 en 250. Wij hebben 250 in Yandex, en misschien heb jij iets anders. Voor de duidelijkheid, ClickHouse heeft een ingebouwde functie om met gegegevens te werken. Je schrijft gewoon een gids met regio's, inclusief hiërarchisch, d.w.z. je hebt Moskou, MO en alles wat je nodig hebt. En je kunt converteren op het niveau van de query.
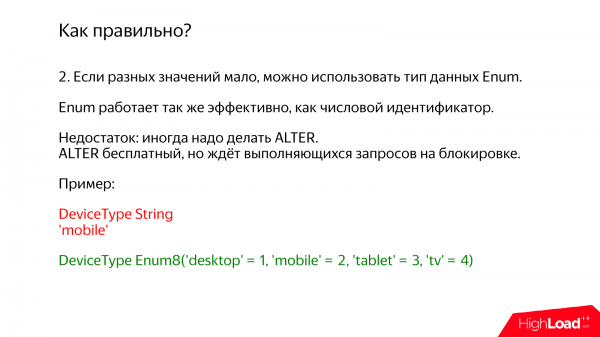
De tweede optie is ongeveer hetzelfde, maar met ondersteuning binnen ClickHouse. Dit is het datatype Enum. Je schrijft gewoon alle benodigde waarden binnen de Enum. Bijv. het type apparaat en daar schrijf je: desktop, mobiel, tablet, televisie. In totaal zijn er 4 opties.
Een nadeel is dat je periodiek moet alteren. Je hebt slechts één optie toegevoegd. Wevoeren alter table uit. Eigenlijk is alter table in ClickHouse gratis. Vooral gratis voor Enum, omdat de data op de schijf niet verandert. Maar desondanks blokkeert alter de tabel en moet wachten tot alle selects zijn uitgevoerd. Pas daarna wordt alter uitgevoerd, d.w.z. er zijn toch enkele ongemakken.
* In recente versies van ClickHouse is ALTER volledig niet-blokkerend gemaakt.
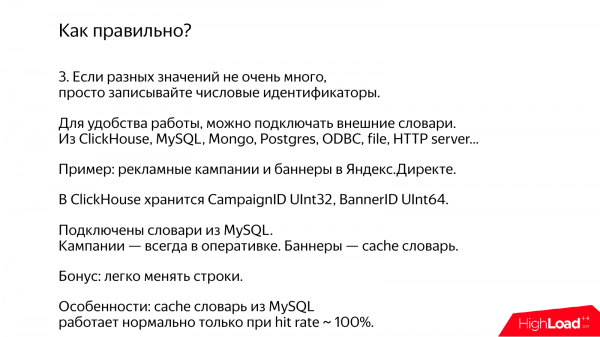
Een andere vrij unieke optie voor ClickHouse is het verbinden van externe woordenboeken. Je kunt getallen in ClickHouse schrijven, terwijl je jouw gidsen in elk systeem dat je handig vindt kunt bewaren. Voorbeelden zijn: MySQL, Mongo, Postgres. Je kunt zelfs je eigen microservice bouwen die deze gegevens via http levert. En op het niveau van ClickHouse schrijf je een functie die deze gegevens omzet van getallen naar strings.
Dit is een gespecialiseerde, maar zeer effectieve manier om een join met een externe tabel uit te voeren. Er zijn echter twee opties. In de ene optie zullen deze gegevens volledig worden gecached, volledig in het geheugen aanwezig zijn en met een zekere periodiciteit worden bijgewerkt. In de andere optie, als deze gegevens niet in het geheugen passen, kunnen ze gedeeltelijk worden gecached.
Hier is een voorbeeld. Er is Yandex.Direct. En daar is een advertentiecampagne en banners. Er zijn waarschijnlijk tientallen miljoenen advertentiecampagnes. En die passen ongeveer in het geheugen. Maar er zijn miljarden banners, die passen niet. En we gebruiken een cacheerbaar woordenboek uit MySQL.
Het enige probleem is dat het cacheerbare woordenboek normaal zal werken als de hitrate dicht bij 100% ligt. Als het minder is, moet je bij het verwerken van verzoeken voor elke batch gegevens daadwerkelijk de ontbrekende sleutels ophalen en de gegevens uit MySQL halen. Ik kan met zekerheid zeggen dat ClickHouse niet traag is, maar ik wil niet over andere systemen spreken.
Als bonus geldt dat woordenboeken een zeer eenvoudige manier zijn om gegevens in ClickHouse achteraf bij te werken. Dat wil zeggen, als je een rapport had voor advertentiecampagnes, kan de gebruiker eenvoudig de advertentiecampagne wijzigen en in alle oude gegevens, in alle rapporten, worden deze gegevens ook gewijzigd. Als je de rijen direct in de tabel schrijft, is het onmogelijk om ze bij te werken.
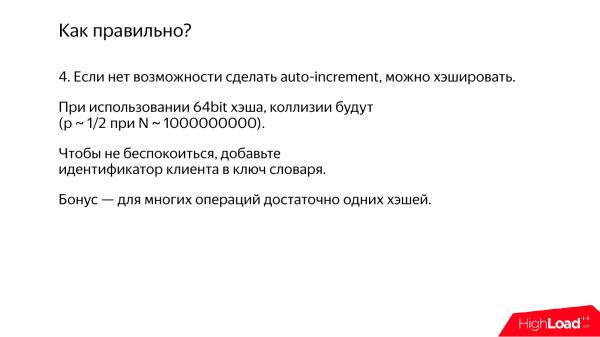
Een andere manier, wanneer je niet weet waar je de identificatoren voor je rijen vandaan moet halen, is simpelweg te hashen. Het eenvoudigste alternatief is om een 64-bits hash te nemen.
Het enige probleem is dat als de hash 64-bits is, je vrijwel zeker botsingen zult krijgen. Want als er een miljard rijen zijn, wordt de kans al aanzienlijk.
En het zou niet zo goed zijn om de namen van advertentiecampagnes zo te hashen. Als de advertentiecampagnes van verschillende bedrijven door elkaar worden gehaald, levert dat verwarring op.
Er is een eenvoudige truc. Het is misschien niet erg geschikt voor gevoelige data, maar als het om minder belangrijke zaken gaat, voeg dan eenvoudigweg de klant-ID toe aan de sleutel van de woordenlijst. Dan kun je wel degelijk tegenstrijdigheden hebben, maar alleen binnen dezelfde klant. Deze methode gebruiken wij voor de linkmap in Yandex.Metrica. We hebben daar URL's, we slaan hashes op. We weten dat er zeker tegenstrijdigheden zijn. Maar als de pagina wordt weergegeven, is de kans klein dat dezelfde gebruiker op één pagina meerdere URL's tegenkomt die samenvallen en dit zal opvallen, dus dit kun je negeren.
Als bonus – voor veel operaties zijn alleen hashes al voldoende en hoeven de eigenlijke strings nergens opgeslagen te worden.
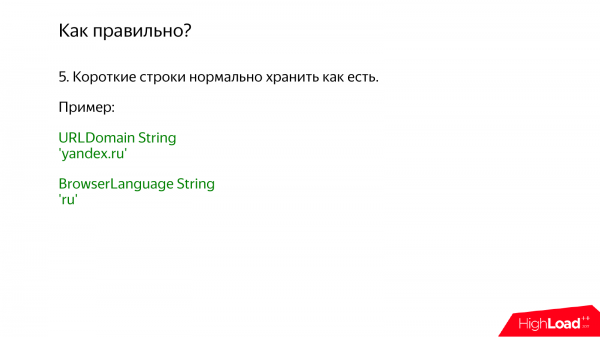
Een ander voorbeeld is wanneer de strings kort zijn, zoals de domeinen van websites. Die kun je gewoon opslaan zoals ze zijn. Of bijvoorbeeld, de taal van de browser ru – 2 bytes. Natuurlijk vind ik het erg zonde van de bytes, maar maak je geen zorgen, 2 bytes zijn niet erg. Bewaar ze gewoon zoals ze zijn, maak je geen zorgen.
Een ander geval is wanneer er juist heel veel strings zijn en een groot aantal daarvan uniek is, mogelijk zelfs onbeperkt. Een typisch voorbeeld zijn zoekzinnen of URL's. Zoekzinnen, ook vanwege typfouten. Laten we eens kijken hoeveel unieke zoekzinnen er per dag zijn. Het blijkt dat ze bijna de helft van alle gebeurtenissen uitmaken. In dit geval zou je kunnen denken dat je de data moet normaliseren, identificatoren moet tellen en in een aparte tabel moet opslaan. Maar dat hoeft niet. Bewaar deze strings gewoon zoals ze zijn.
Beter is het om niets uit te denken, want als je ze apart opslaat, heb je een join nodig. En die join is in het beste geval willekeurige toegang in het geheugen, als het al in het geheugen past. Als dat niet zo is, ontstaan er eigenlijk problemen.
Als de data in place worden opgeslagen, worden ze simpelweg in de juiste volgorde uit het bestandssysteem gelezen en is alles in orde.
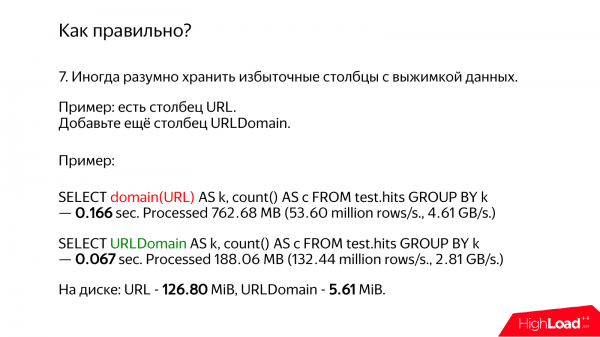
Als je URL's of een andere complexe lange string hebt, is het de moeite waard om na te denken of je niet van tevoren een samenvatting kunt berekenen en in een aparte kolom kunt opslaan.
Voor URL's kun je bijvoorbeeld het domein apart opslaan. En als je dat domein echt nodig hebt, gebruik dan gewoon deze kolom, terwijl de URL's opgeslagen blijven en je er zelfs niet bij hoeft te komen.
Laten we eens kijken wat het verschil is. In ClickHouse is er een gespecialiseerde functie die het domein berekent. Deze is heel snel, we hebben deze geoptimaliseerd. En ik moet eerlijk zeggen, deze voldoet zelfs niet aan de RFC, maar desondanks berekent hij alles wat we nodig hebben.
In één geval zullen we gewoon de URL's ophalen en het domein berekenen. Dit resulteert in 166 milliseconden. Als we echter het kant-en-klare domein nemen, krijgen we slechts 67 milliseconden, wat bijna drie keer sneller is. Dit is niet sneller omdat we enige berekeningen moeten uitvoeren, maar omdat we minder gegevens lezen.
Toch lijkt het alsof één van de tragere verzoeken meer gigabytes per seconde haalt. Dit komt omdat hij meer gigabytes leest. Dit zijn volledig overbodige gegevens. Het verzoek werkt sneller, maar duurt langer om uit te voeren.
Als we echter de hoeveelheid gegevens op de schijf bekijken, blijkt dat de URL 126 megabyte is, terwijl het domein slechts 5 megabyte is. Dat is 25 keer minder. Desondanks wordt het verzoek slechts 4 keer sneller uitgevoerd. Maar dat komt omdat de gegevens 'heet' zijn. Als ze 'koud' waren, zou het zeker 25 keer sneller zijn geweest vanwege de schijfinvoer- en uitvoer.
Overigens, als we beoordelen hoeveel kleiner het domein is dan de URL, blijkt dat dit ongeveer 4 keer zo is. Maar om de een of andere reden nemen de gegevens op de schijf 25 keer minder ruimte in. Waarom? Vanwege compressie. Zowel de URL als het domein worden gecomprimeerd. Maar vaak bevat de URL een hoop rommel.
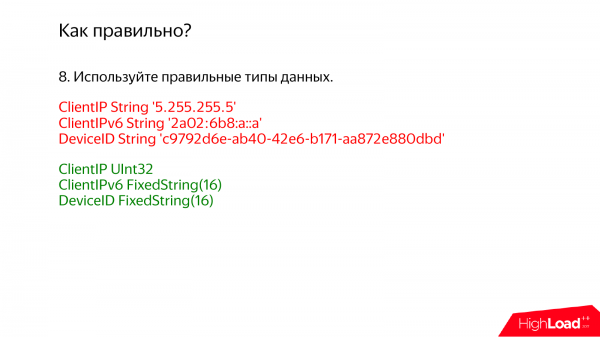
En het is natuurlijk belangrijk om de juiste datatypes te gebruiken die speciaal bedoeld zijn voor de benodigde waarden of die geschikt zijn. Als je IPv4 gebruikt, sla dan UInt32* op. Voor IPv6, gebruik FixedString(16), want een IPv6-adres is 128 bits, dat wil zeggen, sla het direct in binaire vorm op.
Wat als je soms IPv4-adressen en soms IPv6 hebt? Ja, je kunt beide opslaan. Eén kolom voor IPv4, de andere voor IPv6. Natuurlijk is er de optie om IPv4 naar IPv6 te mappen. Dat zal ook werken, maar als je vaak IPv4-adressen nodig hebt in je verzoeken, is het beter om deze in een aparte kolom te plaatsen.
* Nu heeft ClickHouse aparte datatypes voor IPv4, IPv6, die gegevens net zo efficiënt opslaan als getallen, maar ze ook net zo handig weergeven als strings.
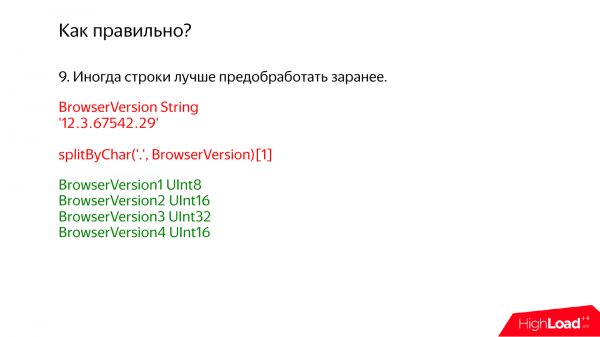
Het is ook belangrijk op te merken dat je de gegevens van tevoren moet voorbewerken. Bijvoorbeeld, als je wat ruwe logbestanden ontvangt. Het lijkt misschien verleidelijk om ze direct in ClickHouse te stoppen, omdat het simpel lijkt, maar het is beter om eerst de berekeningen uit te voeren die mogelijk zijn.
Neem bijvoorbeeld de browserversie. In een ander nabijgelegen gedeelte, waar ik niet per se naar wil wijzen, wordt de browserversie op deze manier opgeslagen, dus als een string: 12.3. En vervolgens, om een rapport te maken, splitsen ze deze string en nemen ze het eerste element van de array. Uiteraard vertraagt dat alles. Ik vroeg waarom ze dat zo doen. Ze antwoordden dat ze geen premature optimalisatie houden. Maar ik houd niet van premature pessimisatie.
In dit geval is het beter om het in 4 kolommen te splitsen. Wees hier niet bang voor, omdat dit ClickHouse is. ClickHouse is een kolomgebaseerde database. En hoe meer nette kleine kolommen, hoe beter. Als er 5 BrowserVersion zijn, maak dan 5 kolommen. Dat is prima.
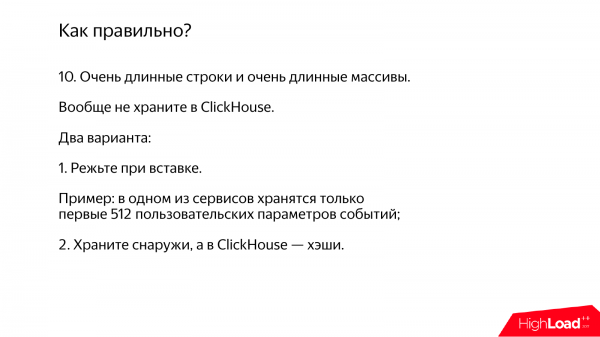
Laten we nu bekijken wat te doen als je veel zeer lange strings of arrays hebt. Je hoeft ze helemaal niet in ClickHouse op te slaan. In plaats daarvan kun je alleen een identificator in ClickHouse opslaan. En stop die lange strings in een ander systeem.
Bijvoorbeeld, in een van onze analytische diensten zijn er bepaalde gebeurtenisparameters. Als er veel parameters voor gebeurtenissen zijn, slaan we gewoon de eerste 512 op die we tegenkomen. Want 512 is geen probleem.
Als je niet zeker weet wat je gegevenstypen zijn, kun je ook gegevens in ClickHouse opslaan, maar in een tijdelijke tabel van het type Log, speciaal voor tijdelijke gegevens. Daarna kun je analyseren hoe je waardeverdeling is, wat er überhaupt is en de juiste types samenstellen.
* momenteel heeft ClickHouse een gegevenstype dat het efficiënt opslaan van strings met lagere werkbelasting mogelijk maakt.
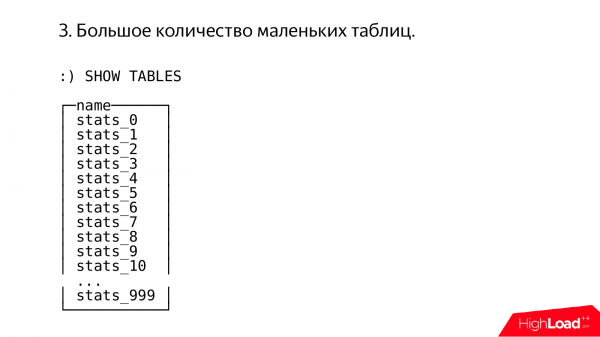
Laten we nu nog een interessant geval bekijken. Soms werkt het allemaal een beetje vreemd bij mensen. Ik kom binnen en zie dit. En het voelt alsof een zeer ervaren, slimme admin, met veel ervaring in de configuratie van MySQL versie 3.23, dit heeft gedaan.
Hier zien we duizend tabellen, waarin elk een restwaarde van een onduidelijke deling door duizend bevat.
In principe respecteer ik de ervaringen van anderen, en begrijp ik ook welke pijn deze ervaringen hebben gekost.
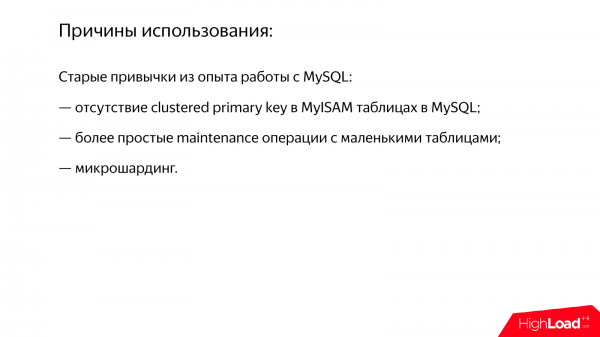
De redenen zijn meer of minder begrijpelijk. Dit zijn oude stereotypen die zich hebben kunnen opbouwen tijdens het werken met andere systemen. Bijvoorbeeld, in MyISAM tabellen is er geen cluster primair sleutel. Deze manier van gegevensscheiding kan een wanhopige poging zijn om dezelfde functionaliteit te verkrijgen.
Een andere reden is dat operaties zoals alter moeilijk uit te voeren zijn op grote tabellen. Alles wordt geblokkeerd. Hoewel in de moderne versies van MySQL dit probleem al niet zo ernstig meer is.
Of bijvoorbeeld microsharding, maar daarover later meer.
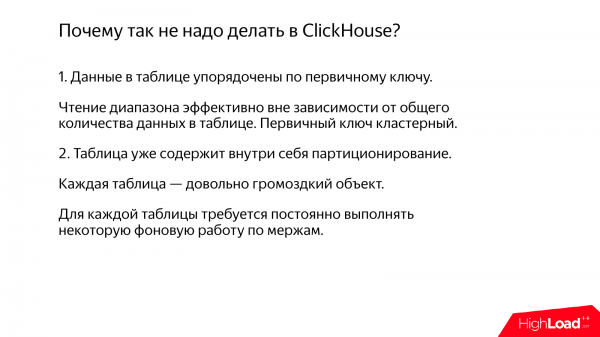
In ClickHouse hoeft dit niet, omdat, ten eerste, de primaire sleutel geclusterd is en de gegevens zijn geordend op de primaire sleutel.
Soms vragen mensen mij: "Hoe verandert de prestatie van bereikquery's in ClickHouse met de grootte van de tabel?" Ik zeg dat het helemaal niet verandert. Bijvoorbeeld, als je een tabel hebt met een miljard rijen en je leest een bereik van één miljoen rijen. Alles is in orde. Als de tabel een triljoen rijen bevat en je leest één miljoen rijen, is het bijna hetzelfde.
Ten tweede zijn handmatige partitietools niet nodig. Als je gaat kijken wat er op het bestandssysteem staat, zie je dat de tabel een behoorlijk serieuze structuur heeft. En daarbinnen zijn er dingen die vergelijkbaar zijn met partitities. Dat wil zeggen, ClickHouse doet alles voor jou en je hoeft er niet voor te lijden.
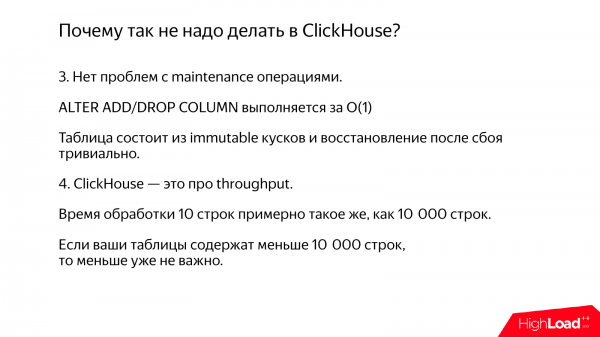
Alter in ClickHouse is gratis, als het gaat om alter add/drop column.
En kleine tabellen zijn niet nodig, want of je nu 10 rijen of 10.000 rijen in een tabel hebt, dat maakt helemaal niet uit. ClickHouse is een systeem dat throughput optimaliseert, niet latency, dus het heeft geen zin om 10 rijen te verwerken.
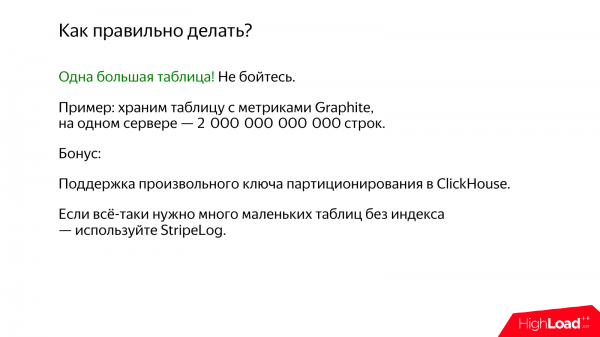
Het is beter om één grote tabel te gebruiken. Verlies de oude stereotypen, alles komt goed.
Als bonus hebben we in de laatste versie de mogelijkheid toegevoegd om een willekeurige partitiet sleutel te maken, zodat je allerlei onderhoudsoperaties kunt uitvoeren op afzonderlijke partitities.
Bijvoorbeeld, als je veel kleine tabellen nodig hebt, zoals wanneer er behoefte is aan de verwerking van tussenliggende gegevens, krijg je chunks en moet je transformaties uitvoeren voordat je deze in de uiteindelijke tabel schrijft. Voor deze situatie is er een geweldige tabelmotor – StripeLog. Dit is ongeveer zoals TinyLog, maar beter.
* nu heeft ClickHouse ook .
Een ander anti-patroon is micro-sharding. Bijvoorbeeld, je moet je gegevens sharden en je hebt 5 servers, maar morgen zijn dat er 6. En je vraagt je af hoe je die gegevens opnieuw kunt balanceren. In plaats daarvan verdeel je ze niet in 5 shards, maar in 1.000 shards. En vervolgens wijs je elk van deze micro-shards toe aan een aparte server. En je zou bijvoorbeeld 200 ClickHouse-instanties op één server hebben. aparte instanties op verschillende poorten of aparte databases.
Maar in ClickHouse is dit niet zo goed. Want zelfs één ClickHouse-instantie probeert alle beschikbare serverbronnen te gebruiken voor het verwerken van één verzoek. Dat wil zeggen, stel dat je een server hebt met bijvoorbeeld 56 CPU-kernen. Je voert een verzoek uit dat één seconde duurt, en het zal 56 kernen gebruiken. En als je daar 200 ClickHouse-instanties op één server hebt, betekent dit dat er 10.000 threads worden gestart. Kortom, dat zal heel slecht zijn.
Een andere reden is dat de werkverdeling over deze instanties ongelijkmatig zal zijn. De een zal eerder eindigen, de ander later. Als dit allemaal in één instantie had plaatsgevonden, dan zou ClickHouse zelf hebben uitgevonden hoe de gegevens correct over threads te verdelen.
En nog een reden is dat je inter-process communicatie via TCP hebt. Gegevens moeten geserialiseerd en gedeserialiseerd worden en dat is een enorme hoeveelheid micro-shards. Het zal gewoon niet efficiënt werken.
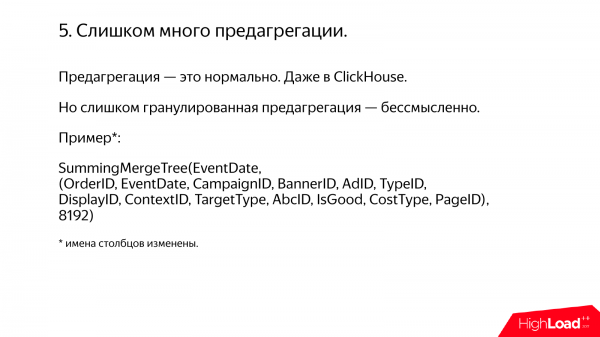
Een ander anti-patroon, hoewel het moeilijk is om het zo te noemen. Dit is een groot aantal pre-agregaties.
Over het algemeen is pre-agregatie goed. Je had een miljard rijen, je hebt deze geaggregeerd tot 1.000 rijen, en nu wordt het verzoek onmiddellijk uitgevoerd. Dat is geweldig. Dat kan je doen. En daarvoor is er zelfs in ClickHouse een speciaal type tabel, AggregatingMergeTree, dat incrementele aggregatie uitvoert naarmate gegevens worden ingevoegd.
Maar er zijn gevallen waarin je denkt dat we de gegevens op deze manier gaan aggregeren en vervolgens nog zo gaan aggregeren. En in een of ander aangrenzend departement, waar ik niet wil zeggen welk, gebruiken ze SummingMergeTree-tabellen om te aggregeren op de primaire sleutel, en als primaire sleutel gebruiken ze zo’n 20 van deze kolommen. Voor de duidelijkheid heb ik enkele kolomnamen veranderd voor de geheimhouding, maar zo is het ongeveer.
En dan ontstaan er zulke problemen. Ten eerste, de hoeveelheid gegevens vermindert niet al te veel. Bijvoorbeeld, het vermindert met drie keer. Drie keer zou een mooie prijs zijn om jezelf onbeperkte analytische mogelijkheden te bieden, die ontstaan als je gegevens niet geaggregeerd zijn. Als de gegevens geaggregeerd zijn, krijg je in plaats van analytics alleen maar schamele statistieken.
En wat is er vooral irritant? Dat die mensen uit het aangrenzende departement soms komen vragen om een extra kolom aan de primaire sleutel toe te voegen. Dat wil zeggen, we hebben de gegevens zo geaggregeerd, en nu willen we iets meer. Maar in ClickHouse kunnen we de primaire sleutel niet wijzigen. Daarom moet er wat C++-scripts worden geschreven. En ik houd niet van scripts, ook al zijn ze in C++.
En als je kijkt waarvoor ClickHouse is gemaakt, dan zijn niet-geaggregeerde gegevens precies het scenario waarvoor het is geboren. Als je ClickHouse gebruikt voor niet-geaggregeerde gegevens, dan doe je alles goed. Als je aggregeert, is dat soms vergeven.
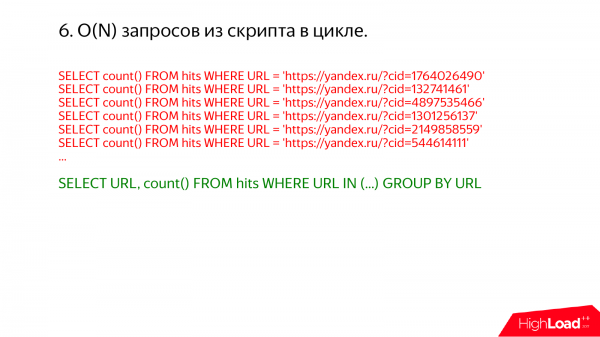
Een ander interessant geval – zijn verzoeken in een oneindige lus. Soms kijk ik op een productie-server en bekijk ik de show processlist. En elke keer ontdek ik dat er iets vreselijks aan de hand is.
Bijvoorbeeld dit. Hier is meteen duidelijk dat je alles in één enkele aanvraag kon uitvoeren. Schrijf gewoon url in en de lijst.
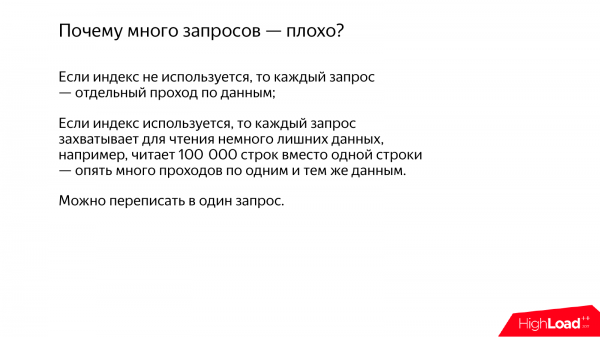
Waarom zijn zoveel van deze verzoeken in een oneindige lus slecht? Als de index niet wordt gebruikt, dan zal je veel door dezelfde gegevens moeten gaan. Maar als de index wel wordt gebruikt, bijvoorbeeld, je hebt een primaire sleutel op ru en je schrijft url = iets daar. En je denkt dat het specifiek zal worden gelezen uit de tabel als één url, dat alles goed zal zijn. Maar dat is in werkelijkheid niet zo. Omdat ClickHouse alles in batches doet.
Wanneer het nodig is om een gegevensbereik te lezen, leest hij iets meer, omdat de index in ClickHouse een sparce index is. Deze index laat je geen individuele rij in de tabel vinden, alleen een bepaald bereik. En de gegevens worden in blokken gecomprimeerd. Om één rij te lezen, moet je een heel blok nemen en dit decomprimeren. En als je veel verzoeken doet, heb je veel overlappingen, en er zal veel werk opnieuw en opnieuw uitgevoerd worden.
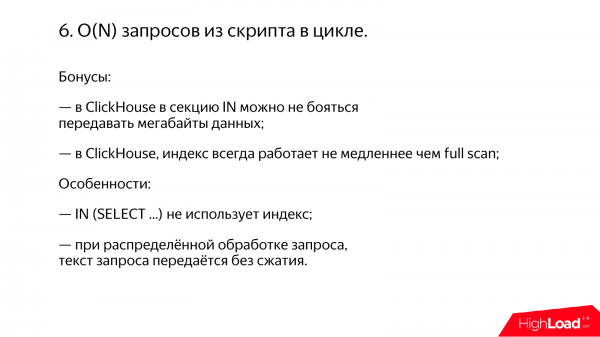
En als bonus kan opgemerkt worden dat je in ClickHouse niet bang hoeft te zijn om zelfs megabytes en honderden megabytes naar de IN-sectie te sturen. Ik herinner me uit onze praktijk dat als we in MySQL een hoop waarden naar de IN-sectie sturen, bijvoorbeeld 100 megabytes aan nummers, MySQL dan 10 gigabyte aan geheugen verbruikt en verder gebeurt er niets, alles functioneert slecht.
En het tweede is dat, als je vragen gebruikt in ClickHouse die de index gebruiken, het altijd niet trager is dan een full scan. Dat wil zeggen, als je bijna de hele tabel moet lezen, zal hij het sequentieel doen en de hele tabel lezen. In het algemeen, zal het zelf wel uitkomen.
Maar er zijn toch enkele complicaties. Bijvoorbeeld dat IN met een subquery de index niet gebruikt. Maar dat is ons probleem en dat moeten we oplossen. Hier is niets fundamenteels aan de hand. We zullen het oplossen.
En nog een interessant feit is dat als je een zeer lange query hebt en de verwerking van de queries gedistribueerd gebeurt, deze zeer lange query naar elke server zal worden verzonden zonder compressie. Bijvoorbeeld, 100 megabytes en 500 servers. En dus zal er 50 gigabyte over het netwerk worden verzonden. Het zal worden verzonden en alles zal vervolgens succesvol worden uitgevoerd.
* Het wordt al gebruikt; alles is gerepareerd, zoals beloofd.
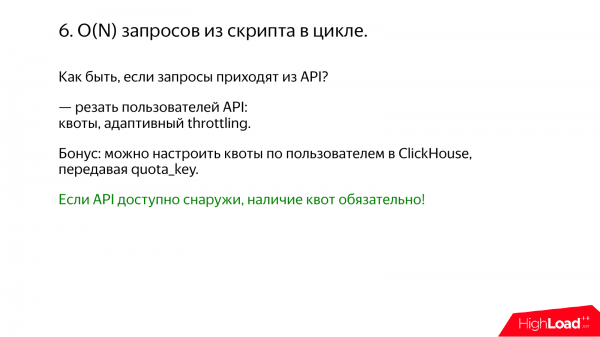
En een vrij voorkomende situatie is dat de verzoeken uit de API komen. Bijvoorbeeld, je hebt een eigen service gemaakt. En als je service door iemand nodig is, heb je de API geopend en letterlijk twee dagen later zie je dat er iets vreemds gebeurt. Alles is overbelast en er komen afschuwelijke verzoeken binnen die er nooit hadden moeten zijn.
En er is één oplossing. Als je de API hebt geopend, moet je deze gaan beperken. Bijvoorbeeld, door bepaalde quota in te voeren. Er zijn geen andere normale opties. Anders zullen ze onmiddellijk een script schrijven en zullen er problemen zijn.
ClickHouse heeft een speciale functie: het tellen van quota. Je kunt zelf je quota-sleutel doorgeven, zoals een interne gebruikersidentifier. De quota worden onafhankelijk voor elk van hen geteld.
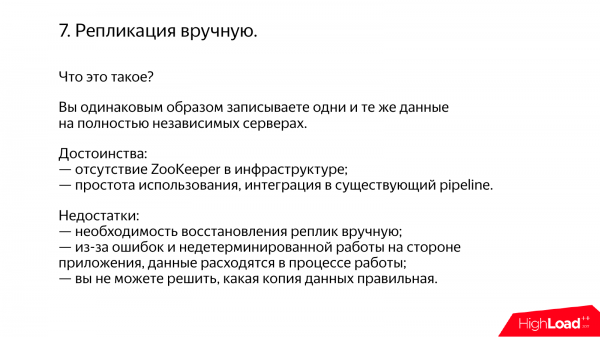
Nu is er nog iets interessants. Dit is replicatie met een handmatige aansturing.
Ik ken veel gevallen waarin, ondanks de ingebouwde ondersteuning voor replicatie in ClickHouse, mensen ClickHouse handmatig repliceren.
Wat is het principe? Je hebt een dataverwerkingspipeline die onafhankelijk werkt, bijvoorbeeld in verschillende datacentra. Je schrijft dezelfde gegevens op dezelfde manier in ClickHouse. Maar in de praktijk blijkt dat de gegevens vanwege bepaalde kenmerken in je code alsnog uit elkaar lopen. Ik hoop dat dit bij jou niet het geval is.
En af en toe moet je alsnog handmatig synchroniseren. Bijvoorbeeld één keer per maand voeren beheerders rsync uit.
Het is eigenlijk veel eenvoudiger om de ingebouwde replicatie van ClickHouse te gebruiken. Maar er kunnen enkele bezwaren zijn, omdat je daarvoor ZooKeeper moet gebruiken. Ik ga niets slechts over ZooKeeper zeggen; in principe is het een werkende systeem, maar soms gebruiken mensen het niet vanwege een 'java-fobie', omdat ClickHouse een fantastisch systeem is dat in C++ is geschreven en heel goed functioneert. ZooKeeper is echter op Java. En op de een of andere manier wil je er niet naar kijken, maar dan kun je ook replicatie met een handmatige aansturing gebruiken.
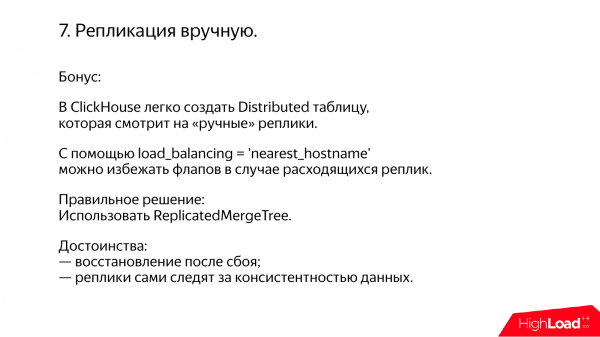
ClickHouse is een praktische systeem. Het houdt rekening met jouw behoeften. Als je handmatige replicatie hebt, kun je een Distributed tabel creëren die naar je handmatige replica's kijkt en zelf failover tussen hen uitvoert. Er is zelfs een speciale optie die je helpt om flaps te vermijden, zelfs als je replica's systematisch uit elkaar lopen.
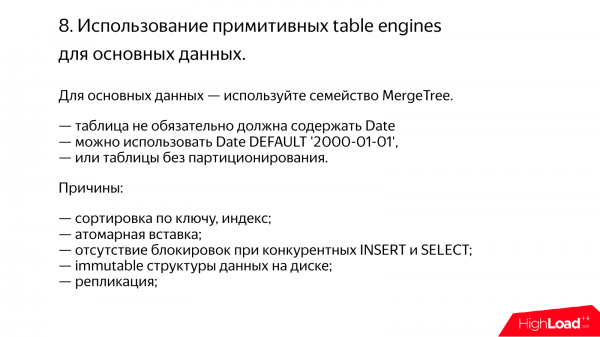
Daarna kunnen er problemen ontstaan als je primitieve table engines gebruikt. ClickHouse is zoals een bouwpakket met veel verschillende table engines. Voor alle serieuze gevallen, zoals in de documentatie staat, gebruik je tabellen van de MergeTree-familie. De andere zijn voor specifieke gevallen of tests.
In een MergeTree-tabel is het niet noodzakelijk dat je een bepaalde datum en tijd hebt. Je kunt deze toch gebruiken. Als er geen datum en tijd is, geef dan default - het jaar 2000 aan. Dit zal werken en zal geen middelen vereisen.
In de nieuwe versie van de server kun je zelfs aangeven dat je aangepaste partitionering zonder partition sleutel wilt hebben. Het zal hetzelfde zijn.
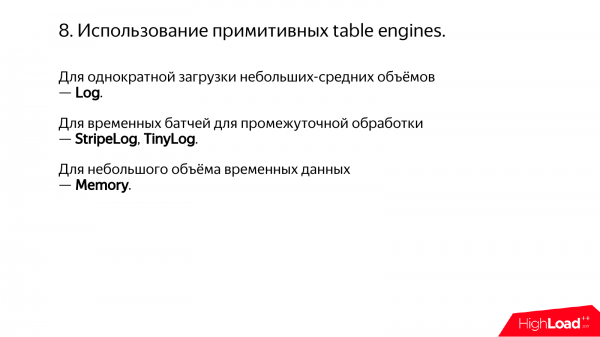
Aan de andere kant kun je primitieve tabelmotoren gebruiken. Bijvoorbeeld, je kunt gegevens één keer laden en vervolgens bekijken, draaien en verwijderen. Je kunt Log gebruiken.
Of opslag van kleine hoeveelheden voor tussentijdse verwerking - dat is StripeLog of TinyLog.
Memory kan worden gebruikt als er een kleine hoeveelheid gegevens is en je gewoon iets in het geheugen wilt draaien.
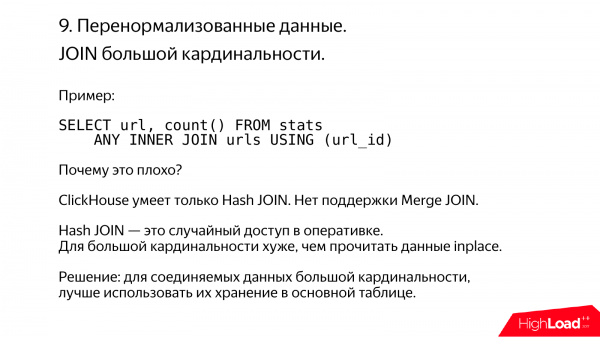
ClickHouse houdt niet van te veel genormaliseerde gegevens.
Hier is een typisch voorbeeld. Dit is een enorme hoeveelheid URL's. Je hebt ze in een aangrenzende tabel gestopt. En toen besloot je om een JOIN met hen te maken, maar dat zal meestal niet werken, omdat ClickHouse alleen Hash JOIN ondersteunt. Als er niet genoeg geheugen is voor de vele gegevens waarmee je moet verbinden, dan zal de JOIN niet kunnen worden uitgevoerd*.
Als de gegevens een hoge kardinaliteit hebben, maak je geen zorgen, sla ze op in een denormaliseerde vorm, de URL's gewoon inplace in de hoofdtabel.
* maar nu heeft ClickHouse ook merge join en dat werkt in situaties waarin de tussengegevens niet in het geheugen passen. Maar dit is inefficiënt en het advies blijft hetzelfde.
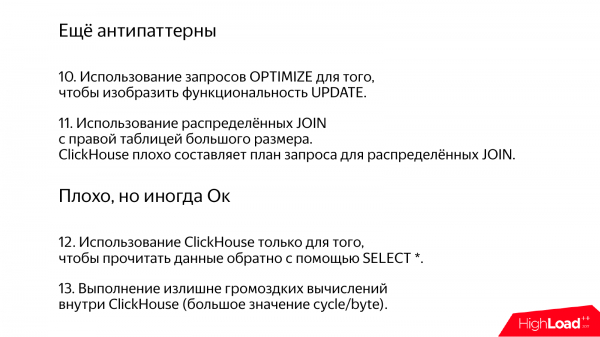
Nog een paar voorbeelden, maar ik begin te twijfelen of ze antypatronen zijn of niet.
ClickHouse heeft één bekend nadeel. Het kan geen updates*. In zekere zin is dat zelfs goed. Als je belangrijke gegevens hebt, bijvoorbeeld boekhouding, dan kan niemand ze verzenden, omdat er geen updates zijn.
* ondersteuning voor update en delete in batchmodus is al geruime tijd toegevoegd.
Maar er zijn enkele bijzondere methoden die updates "achtergrond kunnen" uitvoeren. Bijvoorbeeld, tabellen van het type ReplaceMergeTree. Ze doen updates tijdens achtergrond merges. Je kunt dit forceren met optimize table. Maar doe dit niet te vaak, want dat zal een volledige herschrijving van de partitie zijn.
Gedistrubueerde JOIN in ClickHouse wordt ook slecht behandeld door de query planner.
Slecht, maar soms oké.
Het gebruik van ClickHouse alleen om gegevens terug te lezen met behulp van select*.
Ik zou ClickHouse niet aanbevelen voor zware berekeningen. Maar dat is niet helemaal juist, want we waren al op weg om deze aanbeveling te herzien. Onlangs hebben we de mogelijkheid toegevoegd om machine learning-modellen in ClickHouse toe te passen - Catboost. En dat baart me zorgen, omdat ik denk: 'Wat een ramp. Hoeveel cycli per byte is dat wel niet!?'. Ik vind het erg zonde om cycli op bytes te verspillen.
Maar wees niet bang, installeer ClickHouse, alles komt goed. Als er iets is, hebben we een gemeenschap. Trouwens, die gemeenschap bent u. En als u problemen heeft, kunt u in ieder geval onze chat binnenlopen, en hopelijk kunnen ze u helpen.
Vragen
Dank u voor de presentatie! Waar kan ik klagen over het uitvallen van ClickHouse?
U kunt mij persoonlijk nu klaagt geven.
Ik ben onlangs begonnen met het gebruiken van ClickHouse. Ik heb meteen de cli-interface laten crashen.
U heeft geluk.
Even later heb ik de server laten crashen met een kleine select.
U heeft talent.
Ik heb een bug op GitHub gemeld, maar die werd genegeerd.
Laten we afwachten.
Alexey heeft me met een truc naar de presentatie gelokt door te beloven me te vertellen hoe jullie de data comprimeren.
Heel eenvoudig.
Dat heb ik gisteren al begrepen. Meer specificiteit.
Er zijn geen verschrikkelijke trucs. Het is gewoon compressie per blok. Standaard wordt LZ4 gebruikt, en je kunt ZSTD inschakelen*. Blokken variëren van 64 kilobyte tot 1 megabyte.
* er is ook ondersteuning voor gespecialiseerde compressiecodecs die in combinatie met andere algoritmes kunnen worden gebruikt.
Zijn de blokken gewoon rauwe data?
Niet helemaal rauw. Het zijn arrays. Als je een kolom met getallen hebt, zijn die getallen achtereenvolgens in een array geplaatst.
Begrijpelijk.
Alexey, het voorbeeld dat met uniqExact over IP-adressen ging, d.w.z. dat uniqExact over strings langzamer is dan over getallen, enzovoort. En wat als we een truc gebruiken en tijdens het uitlezen casten? D.w.z. u zei toch dat het op de schijf niet veel verschilt. Als we strings van de schijf lezen en casten, zijn onze aggregaten dan sneller of niet? Of winnen we hier nog steeds onbeduidend? Het lijkt me dat u dit heeft getest, maar om de een of andere reden niet in de benchmark heeft vermeld.
Ik denk dat het langzamer zal zijn dan zonder cast. In dat geval moet het IP-adres uit de string worden geparsed. Uiteraard is het parseren van IP-adressen in ClickHouse ook geoptimaliseerd. We hebben ons best gedaan, maar de cijfers zijn in tienduizendformat geschreven. Heel onhandig. Aan de andere kant zal de functie uniqExact langzamer werken op strings, niet alleen omdat het strings zijn, maar ook omdat een andere specialisatie van het algoritme wordt gekozen. Strings worden gewoon op een andere manier verwerkt.
En wat als we een meer primitieve datatypes nemen? Bijvoorbeeld, we hebben de user id die we hebben, en we hebben deze als string geschreven, en dan gecast. Zou dat leuker zijn of niet?
Ik betwijfel het. Ik denk dat het zelfs treuriger zal zijn, omdat het parseren van cijfers een serieus probleem is. Ik geloof dat deze collega zelfs een presentatie heeft gegeven over hoe moeilijk het is om cijfers in tienduizendformaat te parseren, of misschien ook niet.
Alexey, dank je wel voor de presentatie! En nogmaals bedankt voor ClickHouse! Ik heb een vraag over de plannen. Is er een functie in de planning om woordenboeken gedeeltelijk bij te werken?
Dus een gedeeltelijke herstart?
Ja, ja. Een mogelijkheid om daar een MySQL-veld in te stellen, dat wil zeggen, een update te doen voor 'after', zodat alleen deze gegevens worden geladen als het woordenboek erg groot is.
Een zeer interessante functie. En volgens mij heeft iemand het in onze chat voorgesteld. Misschien was jij het zelfs.
Ik denk het niet.
Geweldig, nu zijn er dus twee verzoeken. En we kunnen rustig beginnen met de implementatie. Maar ik wil je meteen waarschuwen dat deze functie vrij eenvoudig te implementeren is. Dat wil zeggen, je hoeft alleen maar het versienummer in de tabel te schrijven en dan te zeggen: versie is minder dan die versie. En dat betekent dat we waarschijnlijk voorstellen om dit aan enthousiastelingen te geven. Ben jij een enthousiasteling?
Ja, maar helaas niet in C++.
Kunnen je collega's in C++ schrijven?
Ik zal iemand vinden.
Geweldig*.
* de functie werd twee maanden na de presentatie toegevoegd – deze werd ontwikkeld door de auteur van de vraag en verzonden .
Bedankt!
Hallo! Bedankt voor de presentatie! U zei dat ClickHouse erg goed gebruikmaakt van alle beschikbare middelen. De spreker naast Luxoft praatte over zijn oplossing voor de Post Rossii. Hij zei dat ze erg tevreden waren met ClickHouse, maar dat ze het niet in plaats van hun belangrijkste concurrent hebben gebruikt, omdat het de hele CPU opvrat. En ze konden het niet integreren in hun architectuur, in hun ZooKeeper met Docker-containers. Is er een manier om ClickHouse te beperken zodat het niet al zijn beschikbare middelen verbruikt?
Ja, dat kan en het is heel eenvoudig. Als u wilt dat het minder cores gebruikt, schrijft u gewoon set max_threads = 1. En dat is alles, het voert de query uit op één core. U kunt zelfs verschillende instellingen voor verschillende gebruikers opgeven. Dus geen problemen. En laat uw collega's bij Luxoft weten dat het niet goed is dat ze deze instelling niet in de documentatie hebben gevonden.
Alexey, hallo! Ik zou graag een vraag willen stellen. Ik hoor steeds vaker dat velen ClickHouse als opslag voor logboeken beginnen te gebruiken. U zei in uw presentatie dat men dat niet moet doen, dat wil zeggen dat lange regels niet moeten worden opgeslagen. Wat is uw mening hierover?
Ten eerste zijn logs meestal geen lange regels. Natuurlijk zijn er uitzonderingen. Bijvoorbeeld, als een service geschreven in Java een uitzondering gooit, wordt dit gelogd. En dit gebeurt in een oneindige lus, waardoor de schijfruimte opraakt. De oplossing is heel eenvoudig. Als de regels erg lang zijn, snijd ze dan af. En wat betekent lang? Tientallen kilobytes – dat is slecht*.
* in de recente versies van ClickHouse is "adaptieve granulariteit van de index" ingeschakeld, wat het probleem van lange regels in veel gevallen oplost.
Is een kilobyte normaal?
Normaal.
Hallo! Bedankt voor de presentatie! Ik heb hier al eerder in de chat naar gevraagd, maar ik weet niet meer of ik een antwoord heb gekregen. Is er een plan om de WITH-sectie uit te breiden, vergelijkbaar met CTE?
Tot nu toe niet. De WITH-sectie is bij ons een beetje onbelangrijk. Het is voor ons meer een klein functie.
Ik begrijp het. Bedankt!
Dank u voor de presentatie! Zeer interessant! Een globale vraag. Is het mogelijk om, misschien in de vorm van enkele placeholders, een wijziging van dataverwijdering te maken?
Zeker. Dit is onze hoogste prioriteit in onze planning. We hebben momenteel actief nagedacht over hoe we alles goed kunnen doen. En we kunnen beginnen met typen*.
* we hebben op de knoppen van het toetsenbord gedrukt en alles gedaan.
Zal dit de systeemprestaties beïnvloeden of niet? Blijft de invoer even snel als nu?
Misschien zijn de deletes en updates zelf erg zwaar, maar dit heeft geen invloed op de prestaties van selects en inserts.
Nog een klein vraagje. Tijdens de presentatie sprak je over de primaire sleutel. Dus, we hebben partitionering die standaard maandelijks is, klopt dat? En wanneer we een datumbereik opgeven dat binnen een maand valt, wordt alleen deze partitie gelezen, klopt dat?
Ja.
Een vraag. Als we geen primaire sleutel kunnen toewijzen, is het dan juist om deze te maken op basis van het veld ‘Datum’, zodat er in de achtergrond minder herschikking van deze gegevens plaatsvindt en ze meer geordend zijn? Als je geen bereikvragen hebt en je kunt zelfs geen enkele primaire sleutel kiezen, moet je dan de datum in de primaire sleutel opnemen?
Ja.
Misschien is het zinvol om een veld in de primaire sleutel op te nemen waarvoor de gegevens beter kunnen worden samengevoegd als ze op dit veld zijn gesorteerd. Bijvoorbeeld, de gebruikers-id. De gebruiker bezoekt bijvoorbeeld dezelfde website. In dit geval voeg je de gebruikers-id en tijd toe. Dan zullen je gegevens beter samengevoegd worden. Wat betreft de datum, als je echt geen en nooit bereikvragen naar data hebt, dan is het niet nodig om de datum in de primaire sleutel op te nemen.
Goed, heel erg bedankt!
Bron: habr.com
