

We started thinking about creating a monitoring system during the formation of our product teams. It became clear that our role — operations — does not fall within these teams at all. Why is that?
The issue is that all our teams are built around separate information systems, microservices, and front-ends, so they do not see the overall health of the entire system. For example, they might not realize how a small component in the deep backend affects the front-end. Their area of interest is limited to the systems with which their system is integrated. If a team and its service A are almost unrelated to service B, then such a service is almost invisible to the team.
Our team, in turn, works with systems that are heavily integrated with each other: there are many connections between them, making up a considerable infrastructure. The operation of the online store depends on all these systems (which, by the way, there are a huge number of).
Thus, our department does not belong to any specific team, but rather sits somewhat apart. In this whole scenario, our task is to understand comprehensively how the information systems operate, their functionality, integrations, software, networks, hardware, and how all of this is interconnected.
The platform on which our online stores operate looks like this:
- front
- middle-office
- back-office
As much as we would like it to be otherwise, it is impossible for all systems to operate smoothly and flawlessly. The issue, again, lies in the number of systems and integrations — with a setup like ours, certain incidents are inevitable, regardless of testing quality. This applies both within a specific system and in terms of their integration. It is necessary to monitor the state of the entire platform comprehensively, not just some isolated part of it.
Ideally, monitoring the health of the entire platform needs to be automated. We have come to monitoring as an inevitable part of this process. Initially, it was built only for the front-end, while specific monitoring systems by layers existed and still exist for network operators, software administrators, and hardware. All these individuals monitored only at their level, and no one had a comprehensive understanding.
Bijvoorbeeld, als een virtuele machine uitvalt, is het meestal alleen de beheerder die verantwoordelijk is voor de hardware en de virtuele machine die hiervan op de hoogte is. Het frontteam heeft in dergelijke gevallen alleen gezien dat de applicatie is uitgevallen, maar had geen gegevens over de uitval van de virtuele machine. De beheerder weet misschien wie de klant is en kan ongeveer inschatten wat er op die virtuele machine draait, op voorwaarde dat het om een groot project gaat. Voor kleinere projecten weet hij dit waarschijnlijk niet. Hoe dan ook, de beheerder moet naar de eigenaar gaan om te vragen wat er op deze machine was, wat er hersteld moet worden en wat er veranderd moet worden. En als er iets ernstigs kapot ging, begon de chaos — omdat niemand het systeem als geheel kon zien.
Uiteindelijk beïnvloeden zulke fragmentarische verhalen de gehele frontend, de gebruikers en onze belangrijkste bedrijfsfunctie — internetverkoop. Omdat we niet in de teams zitten, maar verantwoordelijk zijn voor de exploitatie van alle e-commerce-applicaties binnen de webwinkel, hebben we de taak op ons genomen om een uitgebreid monitoringssysteem voor het e-commerceplatform te creëren.
Structuur van het systeem en de stack
We begonnen met het identificeren van verschillende monitoringlagen voor onze systemen, waar we metrics moesten verzamelen. En al dit moest samengevoegd worden, wat we in de eerste fase hebben gedaan. Momenteel werken we aan de meest kwalitatieve verzameling van metrics over al onze lagen, zodat we correlaties kunnen opstellen en begrijpen hoe de systemen elkaar beïnvloeden.
Het ontbreken van een uitgebreid monitoringsysteem in de beginfase van de lancering van applicaties (aangezien we begonnen met de bouw ervan toen het grootste deel van de systemen al in gebruik was) heeft geleid tot een aanzienlijke technische schuld in het instellen van monitoring voor het gehele platform. We konden ons niet veroorloven om ons te concentreren op het instellen van de monitoring voor slechts één informatiesysteem en dit grondig uit te werken, omdat de andere systemen enige tijd zonder monitoring zouden blijven. Om dit probleem op te lossen, hebben we een lijst samengesteld van de meest noodzakelijke metrics voor de beoordeling van de status van het informatiesysteem per laag en begonnen we deze te implementeren.
Daarom besloten we de olifant stuk voor stuk op te eten.
Ons systeem bestaat uit:
- hardware;
- besturingssysteem;
- software;
- UI-onderdelen in de monitoringapplicatie;
- bedrijfsmetrics;
- integratieapplicaties;
- informatiebeveiliging;
- netwerken;
- verkeersbalancer.
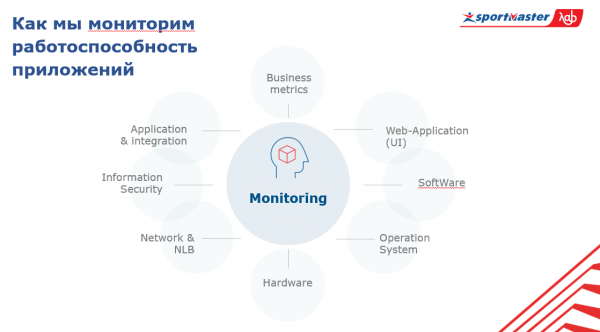
Het hart van dit systeem is de monitoring zelf. Om de status van het gehele systeem goed te begrijpen, is het nodig te weten wat er met de applicaties op al deze lagen gebeurt en met het totaal aantal applicaties.
Dus, over de stack.
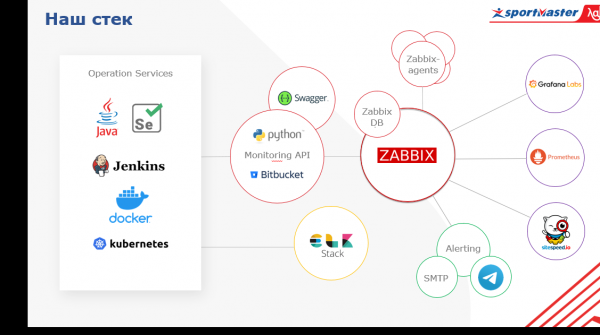
We gebruiken open source software. Centraal hebben we Zabbix, dat we in de eerste plaats als alertsysteem gebruiken. Het is algemeen bekend dat het perfect is voor het monitoren van infrastructuur. Wat wordt daarmee bedoeld? Precies die laagdrempelige metrics die elke onderneming heeft die een eigen datacenter beheert (en Sportmaster heeft zijn eigen datacenters) — servertemperatuur, geheugentoestand, RAID-status, metrics van netwerkapparaten.
We hebben Zabbix geïntegreerd met de messenger Telegram en Microsoft Teams, die veel worden gebruikt in teams. Zabbix dekt de laag van de feitelijke netwerken, hardware en deels software, maar dat is geen wondermiddel. We verrijken deze data met enkele andere services. Bijvoorbeeld, voor hardware-informatie verbinden we ons direct via API met ons virtualisatiesysteem en halen we de gegevens op.
Wat nog meer. Naast Zabbix gebruiken we Prometheus, waarmee we metrics in een dynamische omgeving kunnen monitoren. Dat betekent dat we metrics van applicaties via een HTTP-endpoint kunnen ontvangen en ons geen zorgen hoeven te maken over welke metrics we moeten laden en welke niet. Op basis van deze gegevens kunnen we analytische verzoeken ontwikkelen.
De gegevensbronnen voor de andere lagen, zoals bedrijfsmetrics, zijn onderverdeeld in drie onderdelen.
Ten eerste zijn er externe bedrijfsystemen, Google Analytics, waar we metrics uit logs verzamelen. Hieruit halen we gegevens over actieve gebruikers, conversie en alles wat met het bedrijf te maken heeft. Ten tweede is er het systeem voor UI-monitoring. Dit moet uitgebreider worden besproken.
Ooit zijn we begonnen met handmatige testen en dit is geëvolueerd naar geautomatiseerde tests van functionaliteit en integraties. Hieruit hebben we de monitoring opgebouwd, waarbij we alleen de basisfunctionaliteit hebben behouden en ons hebben verbonden met markers die maximaal stabiel zijn en niet vaak veranderen in de loop van de tijd.
De nieuwe teamsstructuur houdt in dat alle activiteiten rond applicaties zich richten op productteams, waardoor we zijn gestopt met puur testen. In plaats daarvan hebben we van tests UI-monitoring gemaakt, geschreven in Java, Selenium en Jenkins (gebruik als aanroep- en rapportagesysteem).
We hadden veel tests, maar uiteindelijk hebben we besloten om ons te richten op de hoofdweg, een bovenliggende metriek. En als we veel specifieke tests zouden hebben, zou het moeilijk zijn om de actualiteit van de gegevens te onderhouden. Elke volgende release zou het hele systeem aanzienlijk breken, en dan zouden we alleen bezig zijn met het repareren ervan. Daarom hebben we ons gefocust op fundamentele zaken die zelden veranderen en monitoren we alleen die.
Ten slotte, als derde, is de gegevensbron een gecentraliseerd logging-systeem. Voor logs gebruiken we Elastic Stack, en vervolgens kunnen we deze gegevens in ons monitoring systeem voor zakelijke metrics trekken. Daarnaast werkt onze eigen Monitoring API-service, geschreven in Python, die via de API elk service ondervraagt en gegevens van hen in Zabbix haalt.
Een ander onmisbaar attribuut van monitoring is visualisatie. Deze bouwen wij op basis van Grafana. In vergelijking met andere visualisatiesystemen valt het op dat we op het dashboard metrics uit verschillende gegevensbronnen kunnen visualiseren. We kunnen bovenliggende metrics van een webwinkel samenbrengen, bijvoorbeeld het aantal bestellingen dat in het laatste uur is geplaatst, uit de database, de prestatiemetrics van het besturingssysteem waarop deze webwinkel draait, uit Zabbix, en de metrics van de instanties van deze applicatie uit Prometheus. En dat alles op één dashboard. Overzichtelijk en toegankelijk.
Ik wil iets zeggen over veiligheid - we zijn momenteel bezig met het verbeteren van het systeem, dat we later zullen integreren met het globale monitoring systeem. Naar mijn mening zijn de belangrijkste problemen waarmee e-commerce in de informatieveiligheid te maken heeft, gerelateerd aan bots, parsers en brute force-aanvallen. We moeten hierop letten, omdat dit een kritieke impact kan hebben op zowel de werking van onze applicaties als op de reputatie vanuit zakelijk perspectief. En met de gekozen stack dekken we deze taken succesvol af.
Een ander belangrijk punt is dat de applicatieniveaus worden verzameld door Prometheus. Deze is ook geïntegreerd met Zabbix. Daarnaast hebben we sitespeed, een dienst die ons in staat stelt om parameters zoals de laadsnelheid van onze pagina, bottlenecks, de rendering van de pagina, scriptload en meer te bekijken, ook geïntegreerd via API. Dus de metrics worden verzameld in Zabbix en we ontvangen hier ook de alerts vanuit. Alle alerts worden vooralsnog verzonden via de belangrijkste verzendmethoden (momenteel email en telegram, recentelijk hebben we MS Teams toegevoegd). We zijn van plan om de alerting te verbeteren, zodat slimme bots als een dienst kunnen functioneren en informatie over monitoring aan productteams kunnen verstrekken.
Voor ons zijn metrics niet alleen belangrijk voor afzonderlijke informatiesystemen, maar ook voor de algemene metrics van de hele infrastructuur die door de applicaties wordt gebruikt: clusters fysieke servers, waarop virtuele machines draaien, load balancers, Network Load Balancers, het netwerk zelf, en het gebruik van de communicatielijnen. Bovendien zijn er metrics over onze eigen datacenters (we hebben er verschillende en de infrastructuur is van aanzienlijke grootte).
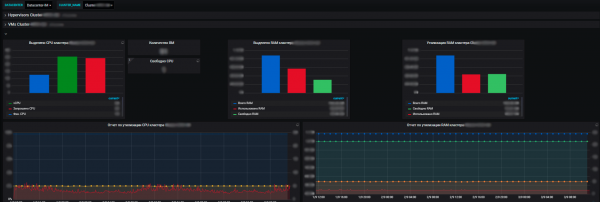
De voordelen van ons monitoringssysteem zijn dat we de staat van de functionaliteit van alle systemen kunnen zien, hun invloed op elkaar en op de algemene bronnen kunnen beoordelen. Uiteindelijk stelt het ons in staat om de middelen te plannen, wat ook binnen onze verantwoordelijkheden valt. We beheren serverresources - een pool binnen e-commerce, brengen oude apparatuur in- en uit gebruik, kopen nieuwe aan, voeren een audit uit van het gebruik van middelen en meer. Elk jaar plannen teams nieuwe projecten, ontwikkelen ze hun systemen, en is het belangrijk dat wij hen van middelen voorzien.
Met behulp van metrics zien we de trends in het middelenverbruik door onze informatiesystemen. En op basis daarvan kunnen we al iets plannen. Op het niveau van virtualisatie verzamelen we gegevens en zien we informatie over de beschikbare hoeveelheid resources per datacenter. En binnen het datacenter zien we zowel de benutting als de feitelijke distributie en het verbruik van resources. Dit geldt zowel voor standalone servers als voor virtuele machines en clusters van fysieke servers, waarop deze virtuele machines soepel draaien.
Vooruitzichten
We hebben nu de kern van het systeem in zijn geheel klaar, maar er zijn nog genoeg zaken waar we aan moeten werken. Ten minste de laag voor informatiebeveiliging, maar het is ook belangrijk om het netwerk te bereiken, de alerting te ontwikkelen en het probleem van correlatie op te lossen. We hebben veel lagen en systemen, en op elke laag zijn er nog talloze metrics. Het is een Matroesjka in de graad van Matroesjka's.
Onze taak is uiteindelijk om de juiste alerts te genereren. Bijvoorbeeld, als er een probleem is met de hardware, weer met de virtuele machine, waar een belangrijke applicatie op draaide en de service niet was gereserveerd. We ontdekken dat de virtuele machine is uitgevallen. Vervolgens zullen de zakelijke metrics worden gealarmeerd: gebruikers zijn ergens verdwenen, er zijn geen conversies, de UI is niet toegankelijk, en software en services zijn ook uitgevallen.
Bij zo'n scenario krijgen we spam uit alerts, en dat past al niet in het format van een goed monitoringsysteem. De vraag naar correlatie komt op. Daarom moet ons monitoringssysteem idealiter zeggen: "Jongens, jullie fysieke machine is uitgevallen, en samen met deze machine zijn deze applicatie en dergelijke metrics" met één enkele alert in plaats van ons te overladen met honderden alerts. Het moet het belangrijkste rapporteren — de oorzaak van het probleem, wat bijdraagt aan de snelheid van probleemoplossing door het te lokaliseren.
Ons waarschuwing- en alertverwerkingsysteem is gebouwd rond een 24/7 hulplijnservice. Alle alerts die wij als must-have beschouwen en die in de checklist staan, worden daarheen doorgestuurd. Elke alert moet per se een beschrijving hebben: wat er is gebeurd, wat dit eigenlijk betekent, waar het invloed op heeft. En ook een link naar het dashboard en instructies over wat te doen in dit geval.
Dit is alles wat betreft de eisen voor het opzetten van alerting. Vervolgens kan de situatie zich in twee richtingen ontwikkelen — of er is een probleem dat moet worden opgelost, of er is een storing in het monitoringssysteem. Maar in elk geval moet je gaan en het uitzoeken.
Gemiddeld ontvangen we nu ongeveer honderd alerts per dag, dit met inachtneming dat de correlatie van alerts nog niet goed is ingesteld. En als we technische werkzaamheden moeten uitvoeren en we iets geforceerd uitschakelen, stijgt hun aantal exponentieel.
Naast het monitoren van de systemen die we exploiteren en het verzamelen van metrics die wij als belangrijk beschouwen, stelt het monitorsysteem ons in staat om gegevens te verzamelen voor productteams. Zij kunnen invloed uitoefenen op de samenstelling van de metrics binnen de informatiediensten die bij ons worden gemonitord.
Onze collega kan komen en vragen om een metric toe te voegen die zowel voor ons als voor het team nuttig blijkt te zijn. Of bijvoorbeeld, het team heeft mogelijk niet genoeg van de basismetrics die wij hebben, ze moeten iets specifieks volgen. In Grafana creëren we een ruimte voor elk team en geven we adminrechten. Ook, als het team dashboards nodig heeft en ze zelf niet kunnen of niet weten hoe dat moet, helpen we hen.
Aangezien we buiten stroom van waardecreatie van het team, hun releases en planning zijn, komen we geleidelijk tot het punt dat de releases van alle systemen naadloos zijn en dagelijks kunnen worden uitgerold zonder dat ze met ons hoeven af te stemmen. Voor ons is het belangrijk om deze releases te volgen, omdat ze mogelijk invloed kunnen hebben op de werking van de applicatie en iets kunnen breken, wat kritiek is. Voor releasebeheer gebruiken we Bamboo, van waaruit we gegevens via de API verkrijgen en kunnen zien welke releases in welke informatiesystemen zijn uitgevoerd en hun status. En het belangrijkste is: op welk tijdstip. We leggen markers voor de releases op de belangrijkste kritieke metrics, wat visueel zeer inzichtelijk is in geval van problemen.
Op deze manier kunnen we de correlatie zien tussen nieuwe releases en opkomende problemen. Het belangrijkste idee is om te begrijpen hoe het systeem op alle lagen werkt, snel een probleem te lokaliseren en net zo snel op te lossen. Vaak blijkt dat het meeste tijd niet wordt besteed aan het oplossen van het probleem, maar aan het zoeken naar de oorzaak.
En deze richting willen we in de toekomst ons richten op proactiviteit. Idealiter zouden we graag vooraf op de hoogte zijn van een op handen zijnde probleem, in plaats van achteraf, zodat we ons kunnen richten op het voorkomen ervan in plaats van het oplossen. Soms komen er valse alarmen van het monitoringssysteem, zowel door menselijke fouten als door veranderingen in de applicatie. En we werken hieraan, we optimaliseren en proberen gebruikers die het monitoringssysteem samen met ons gebruiken, van tevoren te waarschuwen voor elke manipulatie van het systeem, of deze activiteiten in een onderhoudsraam te laten plaatsvinden.
Dus, het systeem is gelanceerd en werkt succesvol sinds het begin van de lente... en genereert een realistische winst. Natuurlijk is dit niet de definitieve versie, we zullen nog veel nuttige functies implementeren. Maar op dit moment, met zoveel integraties en applicaties, is automatisering van monitoring absoluut noodzakelijk.
Als je ook grote projecten met een serieus aantal integraties monitort — laat in de reacties weten welke 'zilveren kogel' je hiervoor hebt gevonden.
Bron: habr.com
