

Laten we bespreken waarom CI-tools en CI totaal verschillend zijn.
Welke problemen moet CI oplossen, waar komt het idee vandaan, wat zijn de laatste bevestigingen dat het werkt, en hoe begrijp je dat je daadwerkelijk praktijk hebt en niet gewoon een geïnstalleerde Jenkins.
Het idee om een presentatie over Continuous Integration te geven, kwam al een jaar geleden toen ik op sollicitatiegesprekken ging op zoek naar werk. Ik sprak met 10-15 bedrijven, en slechts één kon op een duidelijke manier uitleggen wat CI is en hoe ze begrepen dat ze dit niet hadden. De anderen kwamen met onduidelijke nonsens over Jenkins 🙂 'Nou, we hebben Jenkins, het doet builds, CI!' Tijdens de presentatie zal ik proberen uit te leggen wat Continuous Integration werkelijk is en waarom Jenkins en soortgelijke tools hier een zeer zwakke relatie mee hebben.
Dus, wat schiet er meestal in je hoofd als je het woord CI hoort? Voor de meeste mensen zal dat Jenkins, Gitlab CI, Travis, enz. zijn.
Zelfs als we googelen, zullen we deze tools te zien krijgen.
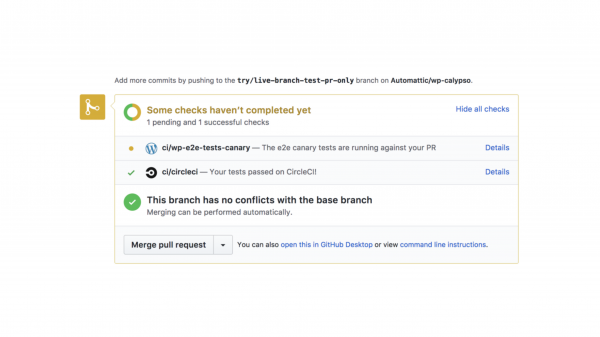
Als je vraagt of ze vertrouwd zijn met CI, zullen ze meteen na het opsommen van de tools vertellen dat CI betekent dat je in een Pull Request op een commit een build en test uitvoeren.
Continuous Integration gaat niet om tools, niet om builds met tests in een branch! Continuous Integration is de praktijk van zeer frequente integratie van nieuwe code, en voor het toepassen ervan is het helemaal niet nodig om Jenkins, GitLab, enz. te gebruiken.
Voordat we kijken naar hoe een volledige CI eruitziet, laten we eerst de context van de mensen die dit hebben bedacht verkennen en voelen welke pijn ze probeerden op te lossen.
En ze probeerden de pijn van teamwerk op te lossen!
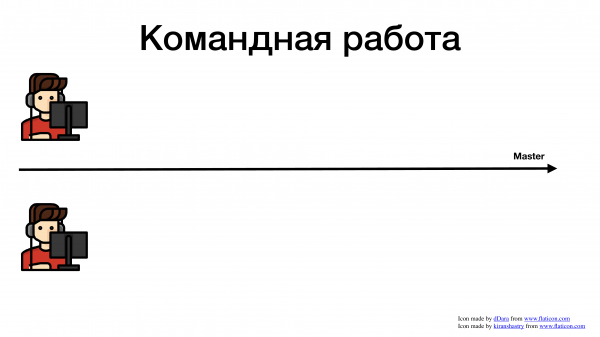
Laten we kijken aan de hand van voorbeelden met welke problemen ontwikkelaars worden geconfronteerd bij teamontwikkeling. Stel dat we een project hebben, de master-branch in git en twee ontwikkelaars.
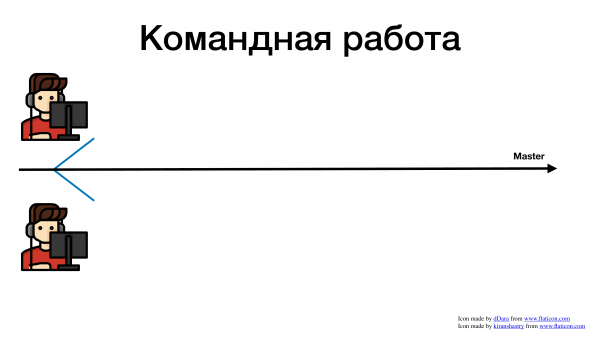
Ze beginnen te werken zoals we allemaal gewend zijn. Ze nemen een taak in Jira aan, maken een feature branch aan en schrijven code.
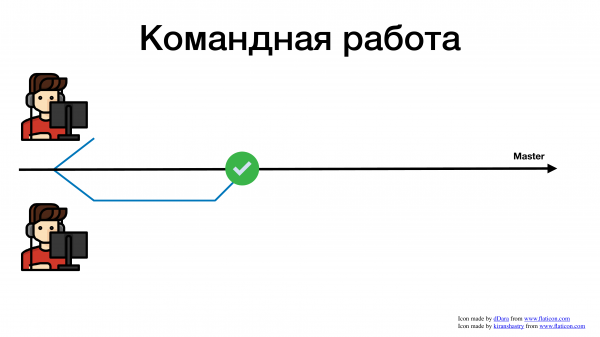
De ene ontwikkelaar voltooide de feature sneller en voegde deze samen met de master.
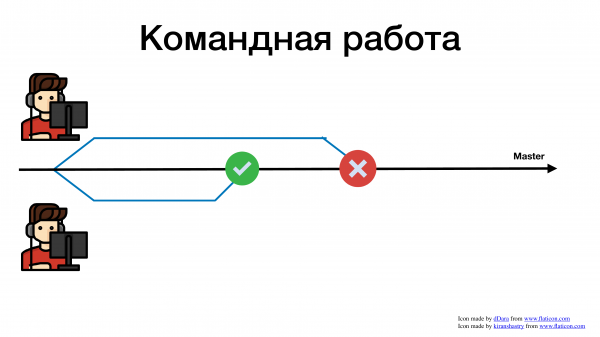
De andere had meer tijd nodig, voegde later samen en kreeg een conflict. Nu, in plaats van de nodige features voor het bedrijf te schrijven, besteed de ontwikkelaar zijn tijd en moeite aan het oplossen van conflicten.
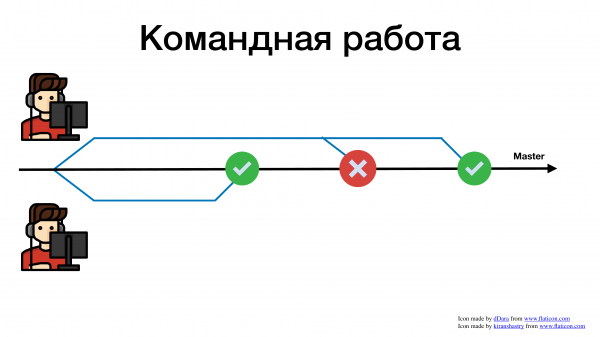
Hoe ingewikkelder het is om je functie te combineren met de hoofdversie, hoe meer tijd we eraan besteden. En dit is nog een relatief eenvoudig voorbeeld. Dit is een voorbeeld waarin er maar 2 ontwikkelaars zijn. Stel je voor dat er 10, 15 of 100 mensen in het bedrijf in dezelfde repository werken. Je zou gek worden van het oplossen van al die conflicten.
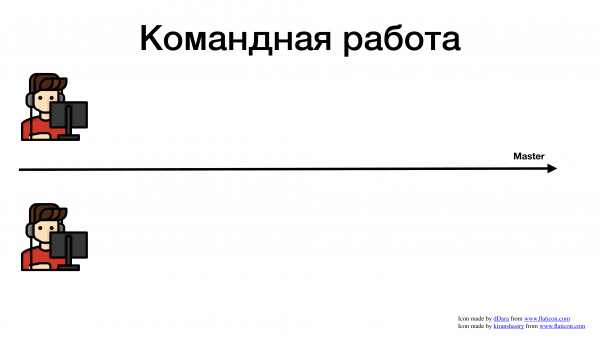
Er is een iets andere situatie. We hebben een master en verschillende ontwikkelaars die iets doen.
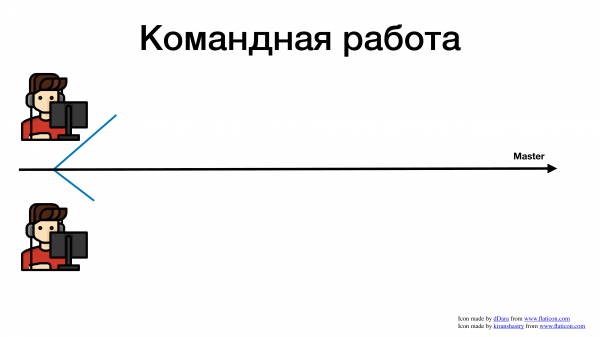
Ze hebben elk een tak gemaakt.
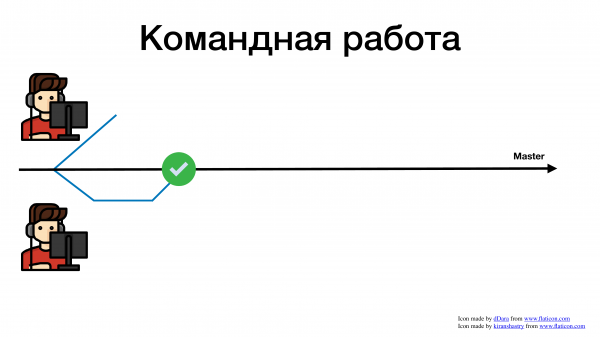
De ene heeft gemerged, alles was goed, en heeft de taak ingeleverd.
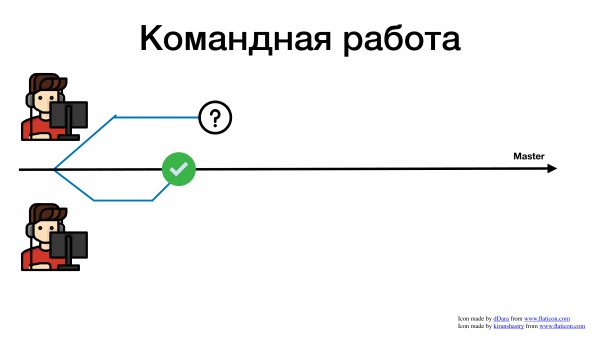
De tweede ontwikkelaar heeft ondertussen zijn taak ingeleverd. Laten we zeggen dat hij het ter beoordeling heeft ingeleverd. In veel bedrijven is er de praktijk van reviewen. Aan de ene kant is deze praktijk goed en nuttig, aan de andere kant kan het ons in veel opzichten vertragen. Laten we daar niet te diep op ingaan, maar hier is een uitstekend voorbeeld van wat een kromme geschiedenis met reviews kan veroorzaken. Je hebt een pull request ter beoordeling ingediend. De ontwikkelaar heeft verder niets te doen. Wat begint hij te doen? Hij gaat andere taken oppakken.
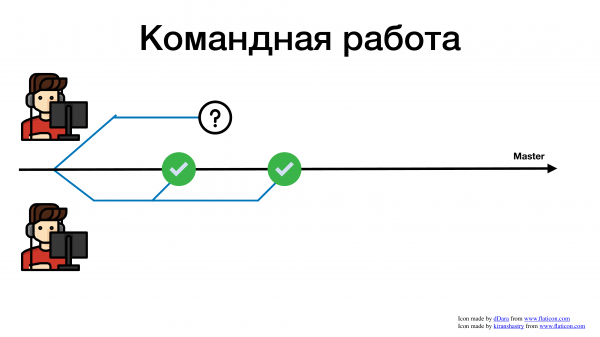
In die tijd heeft de tweede ontwikkelaar nog iets gedaan.
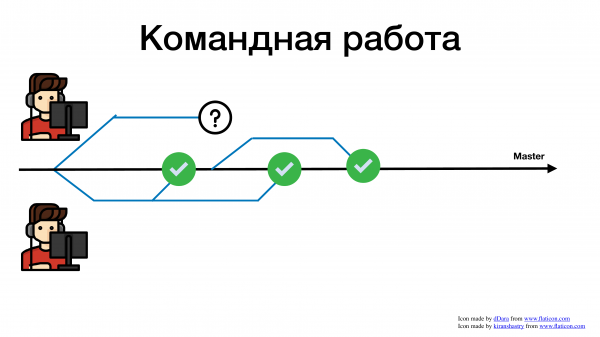
De eerste heeft de derde taak uitgevoerd.
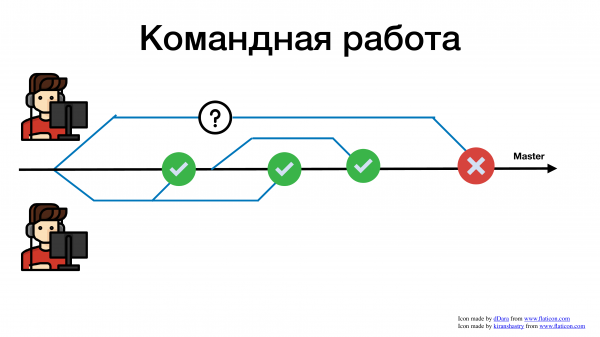
En na een bepaalde tijd is zijn review goedgekeurd en probeert hij te mergent. En wat gebeurt er? Hij krijgt een enorm aantal conflicten. Waarom? Omdat er, terwijl zijn pull request ter beoordeling stond, al veel veranderd is in de code.
Naast het probleem van conflicten is er ook het probleem van communicatie. Terwijl jouw tak ter beoordeling staat, terwijl deze iets afwacht, terwijl je lang aan een functie werkt, stop je met het volgen van wat er nog meer in de codebasis van jouw service verandert. Misschien hebben ze wat je nu probeert op te lossen, gister al opgelost en kun je een bepaalde methode hergebruiken. Maar dat zie je niet, omdat je altijd met een verouderde tak werkt. En die verouderde tak leidt er altijd toe dat je een merge-conflict moet oplossen.
Het blijkt dat als we in een team werken, dus niet één persoon in de repository prutsen, maar 5-10 mensen, hoe langer we onze code niet in de hoofdversie toevoegen, hoe meer we lijden onder het feit dat we uiteindelijk iets moeten samenvoegen. En hoe meer conflicten we hebben, hoe ouder de versie is waarmee we werken, hoe meer problemen we hebben.
Samen iets doen is pijnlijk! We hinderen elkaar altijd.
Dit probleem werd meer dan 20 jaar geleden opgemerkt. De eerste vermelding van de praktijk Continuous Integration vond ik in extreme programming.
Extreme programming is het eerste agile framework. De pagina verscheen in 1996. Het idee was om bepaalde programmeer- en planningspraktijken toe te passen, zodat de ontwikkeling zo flexibel mogelijk zou zijn, zodat we sneller konden reageren op veranderingen en eisen van onze klanten. En 24 jaar geleden begonnen ze te beseffen dat als je iets heel lang en apart doet, je daar meer tijd aan kwijt bent, vanwege conflicten.
Laten we nu de combinatie "Continuous Integration" woord voor woord ontleden. Als je het letterlijk vertaalt, krijg je continue integratie. Maar hoe continu het is, is niet echt duidelijk; het is behoorlijk discontinu. Maar hoeveel 'integration' ook echt is, is ook niet zo voor de hand liggend.
Daarom geef ik je nu citaten uit extreme programming. En we zullen beide woorden afzonderlijk bespreken.
Integration - zoals ik al zei, streven we ernaar dat elke engineer met de meest actuele versie van de code werkt, zodat hij zijn code zo vaak mogelijk in de gezamenlijke tak toevoegt, zodat dit kleine takken zijn. Want als ze groot zijn, kunnen we gemakkelijk een week vast komen te zitten met mergeconflicten. Vooral als we een lange ontwikkelingscyclus hebben, zoals waterfall, waarbij de ontwikkelaar een maand weg is om een enorme functie te ontwikkelen. En bij de integratiefase kan hij heel lang vast komen te zitten.
Integration is wanneer we onze tak nemen en deze integreren met de master; we mergen deze. Er is een ultieme variant waarbij we transbase developer zijn, waarbij we ernaar streven om direct in de master te schrijven zonder overbodige takken.
Over het algemeen is integration het nemen van je code en deze naar de master brengen.
Wat wordt hier bedoeld met het woord 'continue', wat is continuïteit? De praktijk houdt in dat een ontwikkelaar zijn code zo snel mogelijk probeert te integreren. Dit is zijn doel bij het uitvoeren van elke taak - ervoor zorgen dat zijn code zo snel mogelijk in de master verschijnt. In een ideale wereld zullen ontwikkelaars dit elke paar uur doen. Dat wil zeggen, je neemt een kleine taak, voegt deze samen met de master. Alles is geweldig. Hier streef je naar. En je moet dit continu doen. Zodra je iets hebt gedaan, voeg je het direct toe aan de master.
En de ontwikkelaar die iets doet, is verantwoordelijk voor wat hij heeft gedaan, zodat het werkt en niets kapot gaat. Hier komt meestal het verhaal met de tests naar voren. We willen een aantal tests draaien op onze commit, op onze merge, om ervoor te zorgen dat dit werkt. En hier kan Jenkins je juist helpen.
Maar met verhalen zoals: laten we de wijzigingen klein houden, laten we de taken klein houden, laten we de taak doen en onmiddellijk proberen deze in de master te mergen - hier zullen geen Jenkins helpen. Omdat Jenkins je alleen helpt met het uitvoeren van de tests.
Je kunt ook zonder hen. Dit zal je helemaal niet in de weg staan. Omdat het doel van de praktijk is om zo vaak mogelijk te mergen, zodat je in de toekomst geen enorme hoeveelheid tijd verliest aan conflicten.
Laten we ons voorstellen dat we in 2020 om de een of andere reden zonder internet zitten. En we werken lokaal. We hebben geen Jenkins. Dat is prima. Je kunt nog steeds een lokale tak maken. Je hebt daarin wat code geschreven. Je hebt een taak gemaakt in 3-4 uur. Je schakelt over naar master, doet een git pull, en voegt je tak samen. Klaar. Als je dit vaak doet - gefeliciteerd, je hebt Continuous Integration!
Wat zijn de bewijzen in de moderne wereld dat het de moeite waard is om hier energie in te steken? Want over het geheel genomen is het ingewikkeld. Als je probeert zo te werken, zul je merken dat je aan planning moet doen, dat je meer tijd moet besteden aan het decomponeren van taken. Want als je man... doet, zul je niet snel kunnen mergen en kom je in de problemen. Je zult geen praktijk meer hebben.
En dat zal duur zijn. Het is niet mogelijk om vanaf morgen met Continuous Integration te werken. Jullie zullen allemaal heel lang moeten wennen, heel lang moeten leren om taken te decomposeren, en heel lang moeten leren om de reviewpraktijk aan te passen, als die er is. Omdat ons doel is dat het vandaag samengevoegd wordt. En als je de review drie dagen lang doet, heb je problemen en dan werkt Continuous Integration niet.
Maar hebben we op dit moment actuele bewijzen die ons vertellen dat investeren in deze praktijk zinvol is?
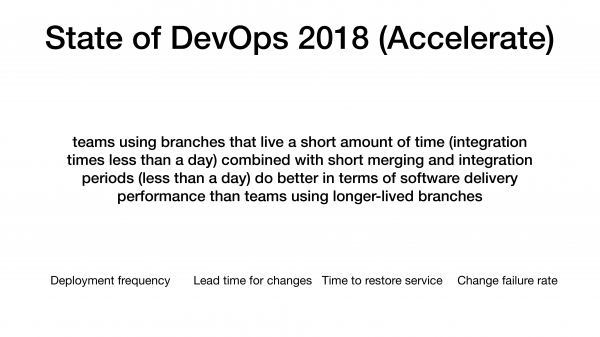
Het eerste dat in me opkwam, is de State of DevOps. Dit is een onderzoek dat het team al 7 jaar uitvoert. Ze doen het nu als een onafhankelijke organisatie, maar onder Google.
Hun onderzoek in 2018 toonde een correlatie aan tussen bedrijven die proberen korte levensduur branches te gebruiken, die snel en vaak integreren; zij hebben veel betere prestatiestatistieken voor IT.
Wat zijn deze statistieken? Het zijn 4 metrics die ze verzamelen van alle bedrijven in hun enquêtes: frequentie van deployments, doorlooptijd voor veranderingen, tijd om de service te herstellen, en faalkans van veranderingen.
Allereerst is er deze correlatie: we weten dat bedrijven die vaak integreren, veel betere metrics hebben. Ze hebben bedrijven onderverdeeld in verschillende categorieën: trage bedrijven die langzaam produceren, medium performers, high performers en de elite. De elite zijn Netflix, Amazon, die super snel zijn, alles snel, mooi en van hoge kwaliteit doen.
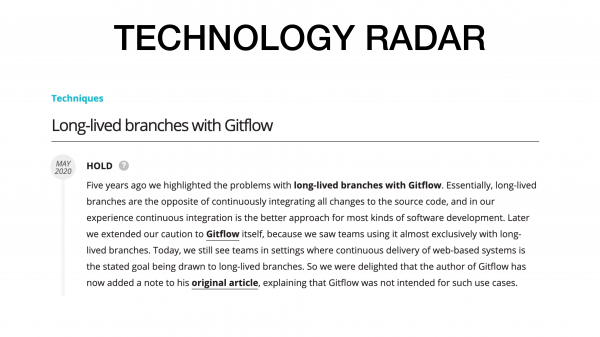
Het tweede verhaal dat letterlijk een maand geleden gebeurde. In de Technology Radar verscheen een geweldige opmerking over Gitflow. Gitflow verschilt van de andere doordat zijn branches lang leven. Er zijn release branches die lang blijven bestaan en feature branches die ook lang blijven bestaan. Deze praktijk is in de Technology Radar naar HOLD verplaatst. Waarom? Omdat mensen kampen met integratieproblemen.
Als je branch heel lang leeft, raakt deze verouderd, en we gaan meer tijd besteden aan het aanbrengen van veranderingen.
En onlangs zei de auteur van Gitflow dat als je streeft naar Continuous Integration, als je zo vaak mogelijk wilt integreren, Gitflow een slechte keuze is. Hij voegde in een apart artikel toe dat als je een backend hebt waar je naar kunt streven, Gitflow overbodig voor je is, omdat Gitflow je zal vertragen en problemen zal veroorzaken bij de integratie.
Dit betekent niet dat Gitflow slecht is en dat je het niet moet gebruiken. Het is voor andere situaties. Bijvoorbeeld wanneer je meerdere versies van een dienst of applicatie moet ondersteunen, dat is, wanneer je gedurende een langere periode moet ondersteunen.
Maar als je spreekt met mensen die zulke diensten ondersteunen, dan hoor je veel klachten over het feit dat versie 3.2, die vier maanden geleden was, deze fix niet bevatte en nu, om dit aan te brengen, er een heleboel wijzigingen moeten worden doorgevoerd. En dan zitten ze weer vast en zijn ze een week bezig om een nieuwe functie te integreren.
Zoals Alexander Kovalev terecht opmerkte in de chat, is correlatie niet hetzelfde als causale relatie. Dat klopt. Dat wil zeggen, er is geen directe relatie dat als je Continuous Integration hebt, al je metrics geweldig zullen zijn, nee. Maar er is een positieve correlatie dat als het ene er is, het andere waarschijnlijk ook het geval is. Niet zeker, maar waarschijnlijk. Het is slechts correlatie.
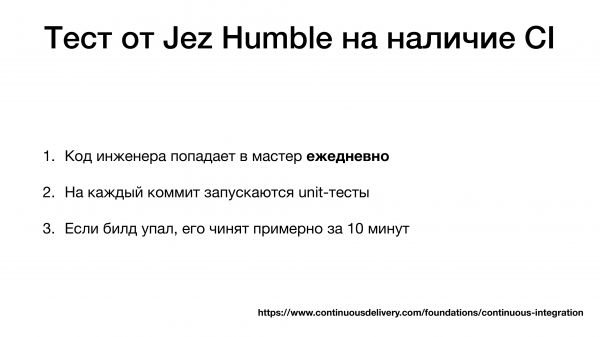
We lijken al iets te doen, we lijken al te integreren, maar hoe weten we dat we echt Continuous Integration hebben en dat we vaak genoeg integreren?
Jez Humble is de auteur van het Handboek, Accelerate, de website Continuous Delivery en het boek 'Continuous Delivery'. Hij stelt de volgende test voor:
- De code van de ingenieur komt dagelijks in de master.
- Bij elke commit voer je unit tests uit.
- De build in de master is mislukt, maar werd binnen ongeveer 10 minuten hersteld.
Hij stelt voor om deze test te gebruiken om ervoor te zorgen dat je deze praktijk echt toepast.
Het laatste vind ik een beetje discutabel. Dat wil zeggen, als je het in 10 minuten kunt oplossen, heb je Continuous Integration, wat een beetje vreemd klinkt, maar er zit wel zin in. Waarom? Omdat als je vaak merge'd, dat betekent dat je veranderingen klein zijn. Als een kleine wijziging de build van de master breekt, kun je snel het probleem vinden, omdat de wijziging klein is. Stel, je had een kleine merge waarbij 20-30 regels zijn veranderd. Je kunt dus snel begrijpen wat de oorzaak was, omdat de wijzigingen minimaal zijn, je hebt een zeer kleine zoekopdracht naar het probleem.
En zelfs als onze productie na de release in elkaar stort, als we de praktijk van Continuous Integration hebben, is het veel eenvoudiger om te handelen, omdat de wijzigingen klein zijn. Ja, dit zal invloed hebben op de planning. Het zal pijnlijk zijn. En waarschijnlijk is het moeilijkste aan deze praktijk om te leren taken op te splitsen, dat wil zeggen, hoe je iets kunt nemen en dit in een paar uur kunt doen en daarbij door een review kunt komen, als je deze hebt. Review is een aparte pijn.
Unit tests zijn gewoon een hulpmiddel dat je helpt te begrijpen of jouw integratie succesvol is verlopen, of er niets is gebroken. Naar mijn mening is dit ook niet echt een verplicht punt, want het doel van de praktijk ligt daar niet.
Dit is in het kort over Continuous Integration. Dit is alles wat er in deze praktijk is. Ik sta klaar voor vragen.
Even kort samenvattend:
- Continuous Integration is niet Jenkins, het is niet Gitlab.
- Het is geen tool, het is een praktijk waarbij we onze code zo vaak mogelijk in de master samenvoegen.
- We doen dit om de enorme pijn te vermijden die in de toekomst ontstaat bij merges, dat wil zeggen, we ervaren nu een kleine pijn om in de toekomst geen grote te hebben. Dat is waar het om gaat.
- Aan de zijkant verloopt de communicatie via code, maar ik zie dit zelden, maar hiervoor is het ook bedoeld.
Vragen
Wat te doen met niet-gecompartimenteerde taken?
Compartmentaliseer. Wat is het probleem? Kun je een voorbeeld geven van een taak die niet te compartimenteren is?
Er zijn taken die helemaal niet te compartimenteren zijn, zoals die welke zeer diepe expertise vereisen en die echt maanden kunnen duren om tot een acceptabel resultaat te komen.
Als ik je goed begrijp, is er een grote en complexe taak waarvan het resultaat pas over een maand zichtbaar zal zijn?
Ja, dat klopt. Ja, je kunt het resultaat pas eerder dan over een maand beoordelen.
Goed. In principe is dit geen probleem. Waarom? Omdat we in dit geval, als we het over takken hebben, niet praten over een tak met een functie. Functies kunnen groot en complex zijn. Ze kunnen een groot aantal componenten omvatten. En mogelijk kunnen we ze niet volledig in één tak implementeren. Dat is normaal. We moeten dit verhaal gewoon opsplitsen. Als de functie niet volledig klaar is, betekent dat niet dat bepaalde delen van de code niet kunnen worden samengevoegd. Je hebt bijvoorbeeld een migratie toegevoegd en binnen de functie zijn er bepaalde fasen. Je hebt bijvoorbeeld de fase - maak de migratie, voeg een nieuwe methode toe. En die dingen kun je al dagelijks samenvoegen.
Goed. Wat is dan de zin hiervan?
Wat is de zin van het dagelijks samenvoegen van kleine dingen?
Ja.
Als ze iets voor je kapot maken, zie je dat meteen. Je hebt een klein stuk dat iets heeft verbroken, het is gemakkelijker om dit te repareren. Het idee is dat het nu veel eenvoudiger is om een klein stuk samen te voegen dan om iets groots over een paar weken samen te voegen. En het derde punt is dat andere ingenieurs zullen werken met de actuele versie van de code. Ze zullen zien dat hier bepaalde migraties zijn toegevoegd, en hier is een nieuwe methode verschenen die ze ook mogelijk willen gebruiken. Iedereen kan zien wat er in je code gebeurt. Het is precies om deze drie dingen dat deze praktijk wordt gedaan.
Dank je, vraag gesloten!
(Oleg Soroka) Mag ik iets toevoegen? Je hebt helemaal gelijk, ik wil alleen één zin toevoegen.
Oké.
Bij Continuous Integration wordt de code samengevoegd in de gezamenlijke tak niet wanneer de functie volledig klaar is, maar wanneer de build is gestabiliseerd. En je kunt gerust zoveel als je wilt per dag naar master committen. Het tweede aspect – als je om een of andere reden een maand lange taak niet kunt opsplitsen in taken van minstens drie dagen, ik zeg niet over drie uur, dan heb je een enorm probleem. En het feit dat je geen Continuous Integration hebt, is het minste van deze problemen. Het betekent dat je problemen hebt met de architectuur en dat de engineerpraktijken op nul staan. Want zelfs als het onderzoek is, moet het toch worden geformuleerd in de vorm van hypothesen of cycli.
We talked about 4 metrics that distinguish successful companies from lagging ones. You still need to live up to these 4 metrics. If a typical task takes a month, I would first focus on that metric. I would initially reduce it to 3 days. After that, I would start thinking about Continuous.
Did I understand you correctly that you think investing in engineering practices makes no sense if any task takes a month?
You have Continuous Integration. And there's this aspect where you either fix a bug or roll it back in 10 minutes. Imagine you deployed it. In fact, you have continuous deployment, you rolled it out to production and only afterwards noticed that something went wrong. Now you need to roll it back, but your database migration has already occurred. Your database schema is already on the next version, moreover, a backup has also happened, and data has been recorded there.
And what alternatives do you have? If you roll back the code, it may no longer work with this updated database.
The database only moves forward, yes.
People with poor engineering practices probably have not read a thick book about... either. What to do with backups? If you restore from a backup, you lose the data accumulated during that time. For example, you worked for three hours with the new version of the database, and users registered there. You revert to an old backup because the new version’s schema doesn’t work, and thus, you lose those users. And they are unhappy, they are complaining.
Om het volledige spectrum aan praktijken te beheersen die Continuous Integration en Continuous Delivery ondersteunen, is het niet genoeg om simpelweg te leren schrijven... Ten eerste kunnen het er erg veel worden, wat onpraktisch zou zijn. Bovendien zijn er tal van andere praktijken, zoals Scientific. Er is een praktijk die GitHub op een gegeven moment populair heeft gemaakt. Dit is wanneer je zowel oude code als nieuwe code tegelijkertijd uitvoert. Dit gebeurt als je een onvoltooide functie maakt die een waarde kan retourneren: hetzij als functie, hetzij als Rest API. Je voert zowel de nieuwe als de oude code uit en vergelijkt het verschil hiertussen. En als er een verschil is, log je dat evenement. Op deze manier weet je dat je nieuwe functie klaar is om bovenop de oude uitgerold te worden, zolang er gedurende een bepaalde tijd geen verschillen zijn tussen deze twee.
Er zijn honderden van dergelijke praktijken. Ik zou voorstellen te beginnen met transbase development. Het is niet 100% op Continuous Integration gebaseerd, maar de praktijken zijn hetzelfde, het een kan niet zonder het ander.
Heb je transbase development als voorbeeld genoemd waar mensen de praktijken kunnen bekijken, of stel je voor dat ze transbase development gaan gebruiken?
Kijken, want ze zullen het niet kunnen gebruiken. Om het te kunnen gebruiken, moet je veel lezen. En als iemand vraagt: "Wat te doen met een functie die een maand in beslag neemt?", betekent dat dat diegene niet heeft gelezen over transbase development. Ik zou het op dit moment ook niet aanraden. Ik zou aanraden me uitsluitend te concentreren op het correct architectonisch splitsen van grote taken in kleinere. Dat is de essentie van decompositie.
Decompositie is een van de hulpmiddelen van de architect. We maken eerst een analyse, dan decompositie, vervolgens synthese, en dan integratie. Op deze manier voegen we alles samen. En je moet eerst doorgroeien naar Continuous Integration via decompositie. Vragen in de eerste fase ontstaan, terwijl we al over de vierde fase praten, dat wil zeggen, hoe vaker je integreert, hoe beter. Het is nog te vroeg om het te doen; het zou goed zijn om eerst je monolith te splitsen.
Er moeten een aantal pijlen en vierkanten op een of andere diagram worden getekend. Je kunt niet zeggen dat ik nu het architecturale diagram van de nieuwe applicatie laat zien en één vierkant toon, waarin een groene knop voor de applicatie zit. Hoe dan ook, er zullen meer vierkanten en pijlen zijn. In elk diagram dat ik heb gezien, waren er meer dan één. En de decompositie op grafisch niveau vindt al plaats. Daarom kunnen de vierkanten onafhankelijk worden gemaakt. Als dat niet mogelijk is, dan heb ik grote vragen aan de architect.
Er is een vraag uit de chat: "Als de review verplicht is en lang duurt, ergens een dag of meer?".
Je hebt problemen met de praktijk. Een review mag niet een dag of meer duren. Dit is dezelfde kwestie als de vorige vraag, maar iets minder streng. Als de review een dag duurt, betekent dat hoogstwaarschijnlijk dat het een review is van een zeer grote verandering. Dat moet smaller worden gemaakt. In de transbase development, die Oleg heeft aanbevolen, is er zo'n methode die continuous review wordt genoemd. Het idee is dat we opzettelijk zo klein mogelijke pull requests doen, omdat we steeds proberen te mergen, beetje bij beetje. Hierdoor verandert de pull request één abstractie of 10 regels. Hierdoor neemt de review slechts een paar minuten in beslag.
Als de review een dag of meer duurt, betekent dat dat er iets niet klopt. Ten eerste kunnen er problemen zijn met de architectuur. Of het is een groot stuk code, bijv. 1.000 regels. Of je hebt zo'n complexe architectuur dat iemand het niet begrijpt. Dit is een probleem aan de zijkant, maar dat moet ook worden opgelost. Misschien is een review helemaal niet nodig. Daar moet ook over worden nagedacht. Review is datgene wat je vertraagt. Het heeft zijn voordelen in het algemeen, maar je moet begrijpen waarom je het doet. Is het voor jou een manier om snel informatie door te geven, is het voor jou een manier om bepaalde standaarden binnen te stellen of wat? Waarom heb je het nodig? Omdat de review ofwel heel snel moet zijn, of helemaal moet worden geannuleerd. Dit is zoals de transbase development – een zeer mooie methode, maar alleen voor volwassen mensen.
Wat betreft de 4 metrics, zou ik aanbevelen om ze toch te laten meten om te begrijpen wat het oplevert. Kijk naar de cijfers, bekijk de afbeelding, hoe slecht het is.
(Dmitri) Ik ben bereid om hierover met jou in discussie te gaan. Cijfers en statistieken zijn geweldig, praktische toepassingen zijn geweldig. Maar het is belangrijk om te begrijpen of dit nuttig is voor het bedrijf. Er zijn bedrijven die niet zo snel veranderingen nodig hebben. Ik ken bedrijven waar je niet elke 15 minuten wijzigingen kunt aanbrengen. Niet omdat ze slecht zijn, maar omdat dat de levenscyclus is. En om functies zoals branches en toggles te implementeren, zijn diepgaande kennis nodig.
Het is moeilijk. Als je de geschiedenis van de functie toggle uitgebreider wilt lezen, raad ik het ten zeerste aan. . En er is een geweldig artikel van Martin Fowler over functie toggles: over de verschillende typen, levenscycli, enzovoort. Functie toggles zijn ingewikkeld.
En je hebt nog steeds de vraag niet beantwoord: ‘Is Jenkins noodzakelijk of niet?’
Jenkins is eigenlijk in geen enkel geval noodzakelijk. Als ik serieus ben, bieden tools zoals Jenkins en Gitlab je gemak. Je zult zien of de build geslaagd is of niet. Ze kunnen je helpen, maar ze zorgen niet voor de praktijk. Ze geven je alleen een cirkeltje – Oké, niet Oké. En dat is alleen als je ook tests schrijft, want als je geen tests hebt, is het bijna zinloos. Dus het is nodig omdat het handiger is, maar in het algemeen kun je ook zonder leven, je verliest niet veel.
Dus als je praktijken hebt, betekent dat dat je het niet nodig hebt?
Inderdaad. Ik raad de test van Jez Humble aan. Ik heb gemengde gevoelens over het laatste punt. Maar over het algemeen, als je drie dingen hebt: je mergeert continu, je voert tests uit bij commits in de master, en je repareert snel builds in de master, dan heb je misschien verder niets meer nodig.
Terwijl we wachten op vragen van de deelnemers, heb ik een vraag. We hebben het nu gehad over productcode. Heb je dezelfde principes ook toegepast op infrastructuurcode? Is dat dezelfde code, zijn het dezelfde principes en dezelfde levenscyclus, of zijn er andere levenscycli en principes? Gewoonlijk, als iedereen het heeft over Continuous Integration en Development, vergeten ze dat er ook infrastructuurcode is. En de laatste tijd wordt dat steeds belangrijker. Moeten we al deze regels daar ook toepassen?
Het is niet zozeer dat we het MOETEN doen, het zou geweldig zijn, omdat het het leven zeker zou vereenvoudigen. Zodra we met code werken, niet met bash-scripts, maar met normale code.
Stop-stop, een bash-script is ook code. Raak mijn oude liefde niet aan.
Goed, ik zal je herinneringen niet verstoren. Ik heb een persoonlijke afkeer van bash. Het breekt altijd op een lelijke en angstaanjagende manier. En het breekt vaak onvoorspelbaar, daarom heb ik er een hekel aan. Maar goed, laten we aannemen dat je code in bash hebt. Misschien begrijp ik er echt niets van en zijn er fatsoenlijke testframeworks. Ik ben er gewoon niet in thuis. En we krijgen dezelfde voordelen.
Zodra we met infrastructuur als code werken, krijgen we dezelfde problemen als ontwikkelaars. Enkele maanden geleden kreeg ik een situatie waarbij een collega me een pull request van 1000 regels in bash stuurde. En je blijft 4 uur hangen in de review. De problemen zijn dezelfde. Het is nog steeds code. En nog steeds samenwerking. We blijven steken met pull requests en het aanpakken van dezelfde merge-conflicten in bash, bijvoorbeeld.
Ik kijk nu heel actief naar dit hele gebeuren met de mooiste programmatuur van infrastructuur. Ik heb Pulumi in de infrastructuur ingebracht. Dit is pure programmatuur. Het is nog aantrekkelijker omdat ik alle mogelijkheden van de programmeertaal heb, d.w.z. ik heb met dezelfde if-declaraties prachtige toggles gemaakt en alles is goed. Mijn wijziging is al in de master. Iedereen ziet het al. Andere ingenieurs zijn zich ervan bewust. Het heeft al invloed gehad op iets. Maar het is niet voor alle infrastructuren ingeschakeld. Het is ingeschakeld voor mijn testopstellingen, bijvoorbeeld. Dus om je vraag nog een keer te beantwoorden: ja, het maakt ons leven als ingenieurs die met code werken zeker eenvoudiger.
Zijn er nog vragen van anderen?
Ik heb een vraag. Ik wil de discussie met Oleg voortzetten. Over het algemeen denk ik dat je gelijk hebt, dat als een taak een maand in beslag neemt, er een probleem met de architectuur is, een probleem met analyse, decompositie, planning, enz. Maar ik heb het gevoel dat als je probeert te leven volgens Continuous Integration, je de pijnpunten met planning begint op te lossen, omdat je nergens anders heen kunt.
(Oleg) Ja, dat klopt. Wat betreft de werklast is deze praktijk vergelijkbaar met elke andere serieuze praktijk die de cultuur verandert. Het moeilijkste om te overwinnen zijn gewoontes, vooral slechte gewoontes. En als er een ingrijpende verandering van gewoontes van de omringenden nodig is, zoals developers, het management, productmanagers, dan staan er je verrassingen te wachten.
Wat voor verrassingen kunnen er zijn? Stel je voor, je hebt besloten om vaker integraties uit te voeren. En aan de integratie zijn nog andere zaken verbonden, bijvoorbeeld artefacten. En in jouw bedrijf is er een beleid dat elk artefact op een bepaalde manier geregistreerd moet worden in een systeem voor artefactopslag. Dit kost tijd. Een persoon moet bevestigen dat hij, als release-manager, dit artefact heeft goedgekeurd voor de uitrol naar productie. Als dit 5-10-15 minuten kost, maar je doet eenmaal per week een uitrol, dan kost een half uur per week een relatief kleine belasting.
Als je Continuous Integration 10 keer per dag doet, dan moet je 10 keer 30 minuten vermenigvuldigen. En dat overschrijdt de beschikbare werktijd van deze release-manager. Hij raakt simpelweg moe van het doen hiervan. Er zijn constante kosten verbonden aan bepaalde praktijken. En dat is het.
En je moet ofwel deze regel intrekken zodat je je niet meer bezig houdt met onzin, dat wil zeggen, je kent niet handmatig de mate van overeenstemming van iets met iets anders toe. Je vertrouwt volledig op een geautomatiseerde set van tests voor gereedheid.
En als je een goedkeuring van iemand nodig hebt, zodat de leidinggevende ondertekent, en je komt niet in de productie zonder dat Vasya zegt dat het goed is, dan staat al die onzin praktische zaken in de weg. Want als er activiteiten zijn die als belasting fungeren, dan wordt alles 100 keer moeilijker. Daarom zal een verandering vaak niet door iedereen met vreugde worden ontvangen. Want het is moeilijk om de gewoontes van mensen te veranderen.
Wanneer iemand zijn gebruikelijke werk doet, doet hij dat praktisch onbewust. De cognitieve belasting daarvan is nul. Hij werkt gewoon verder op wat er klaar is, hij heeft al een checklist in zijn hoofd, hij heeft het duizend keer gedaan. En zodra je komt en zegt: 'Laten we deze praktijk annuleren en vanaf maandag een nieuwe invoeren', wordt dat voor hem een enorme cognitieve last. En die komt meteen voor iedereen tegelijk.
Daarom is het misschien het eenvoudigst, hoewel niet iedereen zich deze luxe kan veroorloven, maar ik doe het altijd zo: als er een nieuw project begint, worden meestal meteen alle ongeteste praktijken in dat project gestopt. Zolang het project jong is, riskeren we niet veel. Er is nog geen productie, er is niet veel te verliezen. Dus dat kan als training worden gebruikt. Deze aanpak werkt. Maar niet alle bedrijven hebben de mogelijkheid om vaak zulke projecten te starten. Hoewel dat ook een beetje vreemd is, omdat we nu in een periode van digitale transformatie zitten, waarbij iedereen experimenten moet uitvoeren om bij de concurrenten in de pas te blijven.
Hier loop je tegen het feit aan dat je eerst moet begrijpen wat je moet doen. De wereld is niet perfect, productie is ook niet perfect.
Ja, deze dingen zijn met elkaar verbonden.
Bedrijven hebben ook niet altijd inzicht in wat ze nodig hebben en waarbij ze heen moeten.
Er is een situatie waarin helemaal geen veranderingen mogelijk zijn. Dit is een situatie waarin er meer druk op het team komt. Het team is al behoorlijk uitgeput. Ze hebben geen tijd voor experimenten. Ze zijn de hele dag bezig met het ontwikkelen van features. En het management vindt dat nooit genoeg. Er worden steeds meer eisen gesteld. In zo'n situatie zijn er helemaal geen veranderingen mogelijk. Het team kan alleen te horen krijgen dat ze morgen hetzelfde moeten doen als gisteren, maar met nog iets meer features. Geen enkele overgang naar andere praktijken is in dit opzicht mogelijk. Dit is een klassieke situatie waarin er geen tijd is om een bijl te slijpen, men moet bomen kappen, dus men kapt met een botte bijl. Hier zijn geen eenvoudige adviezen.
(Dmitry) Ik zal een aanvulling uit de chat voorlezen: "Maar er moet wel veel dekking zijn met testen op verschillende niveaus. Hoeveel tijd wordt eraan besteed? Het is behoorlijk prijzig; het kost veel tijd."
(Oleg) Dit is een klassiek misverstand. Er moeten genoeg tests zijn om jou zelfverzekerd te maken. Continuous Integration is geen kwestie van eerst 100% van de tests uitvoeren en pas dan beginnen met deze praktijk. Continuous Integration vermindert de cognitieve belasting voor jou omdat elk van de veranderingen die je met je ogen ziet, zo duidelijk is dat je begrijpt of het iets zal breken of niet, ook al zijn er geen tests. Je kunt dit snel in je hoofd testen omdat de veranderingen klein zijn. Zelfs als je alleen handmatige testers hebt, is het gemakkelijker voor hen. Je hebt het uitgerold en zegt: 'Kijk eens, is er niets kapot?'. Zij controleren en zeggen: 'Nee, er is niets kapot'. Omdat de tester weet waar ze moeten kijken. Je hebt één commit die verbonden is met één fragment van de code. En dit wordt geëxploiteerd door specifiek gedrag.
Hier heb je, natuurlijk, wat opgepoetst.
(Dmitry) Hier ga ik niet mee akkoord. Er is een praktijk - testen door ontwikkeling - die je hier precies van redt.
(Oleg) Dit heb ik nog niet bereikt. De eerste illusie is dat je precies 100% van de tests moet schrijven of helemaal niets moet doen met Continuous Integration. Dat is onwaar. Dit zijn twee parallelle praktijken en ze zijn niet rechtstreeks afhankelijk van elkaar. Jouw testdekking moet optimaal zijn. Optimaal betekent dat je zelf overtuigd bent dat de kwaliteit van de master, die na de commit is overgebleven, je in staat stelt om met vertrouwen op de knop 'Deploy' te drukken op vrijdagavond, ook als je iets te veel gedronken hebt. Hoe bereik je dat? Door middel van reviews, dekking en goede monitoring.
Goede monitoring is niet te onderscheiden van tests. Als je tests één keer uitvoert op pre-prod, dan controleren ze al je gebruikersscenario's maar één keer. Maar als je ze in een oneindige cyclus uitvoert, dan is dat je uitgebreide monitoringsysteem, dat continu alles test - of het is gevallen of niet. In dit geval is het verschil slechts de enkelvoudigheid of meervoudigheid. Een zeer goede set tests..., die continu worden uitgevoerd, is monitoring. En goede monitoring zou zo moeten zijn.
En dus, hoe je die staat precies bereikt, waarin je op vrijdagavond kunt deployen en naar huis kunt gaan, is een andere vraag. Misschien ben je gewoon een onverschrokken avonturier.
Laten we even teruggaan naar Continuous Integration. We zijn net iets te ver afgedwaald naar een andere complexe praktijk.
En de tweede illusie is dat je MVP snel moet maken, dus zijn tests helemaal niet nodig. Dat is niet helemaal waar. Het gaat erom dat wanneer je een user story voor een MVP schrijft, je deze ofwel zomaar kunt ontwikkelen — je hoort dat er een user story is en begint direct te coderen — of je kunt werken met TDD. En volgens de praktijk van TDD kost het niet meer tijd, dat wil zeggen, tests zijn een bijeffect. De essentie van TDD is niet om te testen. Ondanks de naam Test Driven Development gaat het daar in feite helemaal niet om tests. Het is eerder een architectonische benadering. Het is een benadering om precies dat te schrijven wat nodig is en niet te schrijven wat niet nodig is. Deze praktijk richt zich op de volgende iteratie van je denkproces bij het creëren van de architectuur van de applicatie.
Daarom is het niet zo eenvoudig om van deze illusies af te komen. MVP en tests sluiten elkaar niet uit. Sterker nog, als je een MVP maakt volgens de praktijk van TDD, dan doe je het beter en sneller dan wanneer je er helemaal geen praktijk in betrekt, maar zomaar begint.
Dit is een zeer onduidelijke en complexe gedachte. Wanneer je hoort dat je nu ook tests gaat schrijven en tegelijkertijd iets sneller kan doen, klinkt dat absoluut niet logisch.
(Dmitry) Veel mensen, als ze MVP noemen, zijn lui om iets fatsoenlijks te schrijven. Dit zijn toch echt verschillende dingen. Je moet MVP niet omtoveren tot iets slechts dat niet werkt.
Ja, ja, je hebt gelijk.
En dan plotseling de MVP in productie.
Voor altijd.
TDD klinkt heel vreemd wanneer je hoort dat je tests schrijft en blijkbaar meer werk doet. Het klinkt heel vreemd, maar in werkelijkheid gaat het sneller en prettiger. Wanneer je een test schrijft, denk je al veel na over welke code en hoe deze zal worden aangeroepen, evenals welk gedrag we ervan verwachten. Je zegt niet gewoon dat je een functie hebt geschreven en dat deze iets doet. Je denkt eerst na over de voorwaarden, hoe deze zal worden aangeroepen. Je dekt dit af met tests en daaruit begrijp je hoe je interfaces binnen je code eruit zullen zien. Dit heeft een grote invloed op de architectuur. Je code wordt automatisch meer modulair, omdat je eerst probeert te begrijpen hoe je het gaat testen, en pas daarna schrijf je het.
Mijn ervaring met TDD was zo dat ik op een gegeven moment een mentor voor Ruby heb ingehuurd, terwijl ik nog een Ruby-ontwikkelaar was. Hij zei: "Laten we jou TDD laten toepassen." Ik dacht: "Oh nee, moet ik nu weer extra schrijven." We kwamen overeen dat ik binnen twee weken al mijn werkende code in Python volgens TDD zou schrijven. Na twee weken realiseerde ik me dat ik niet meer terug wilde. Door het TDD-concept twee weken lang toe te passen, begreep ik hoezeer het zelfs het denken vergemakkelijkte. Het is niet voor de hand liggend, daarom raad ik iedereen aan dat als je het gevoel hebt dat TDD moeilijk, tijdrovend en overbodig is, je het toch twee weken moet proberen. Voor mij waren die twee weken genoeg om overtuigd te raken.
(Dmitry) We kunnen deze gedachte uitbreiden vanuit het perspectief van infrastructuurbeheer. Voordat we iets nieuws lanceren, zorgen we voor monitoring, en pas daarna starten we. In dit geval wordt onze monitoring een normale test. En er is ontwikkeling via monitoring. Maar bijna iedereen zegt dat het te lang duurt, dat ze geen zin hebben, en dat ze een tijdelijke ruwe versie hebben gemaakt. Als we een goede monitoring hebben opgezet, begrijpen we de status van het CI-systeem. En in een CI-systeem is er veel monitoring. We begrijpen de staat van het systeem en wat er intern gebeurt. Tijdens de ontwikkeling bouwen we het systeem zo dat het de gewenste staat bereikt.
Deze praktijken zijn al lang bekend. We hebben dit ongeveer vier jaar geleden besproken. Maar in de afgelopen vier jaar is er eigenlijk niets veranderd.
Maar ik stel voor om deze officiële discussie hier te beëindigen.
Video (ingevoegd als media-element, maar om een of andere reden werkt het niet):
Bron: habr.com
