

Met de lancering van de cursus We hebben nog een nuttige vertaling voor je voorbereid.
Grafdatabases zijn een belangrijke technologie voor database-experts. Ik probeer op de hoogte te blijven van innovaties en nieuwe technologieën in dit gebied en, na het werken met relationele en NoSQL-databases, zie ik dat de rol van grafdatabases steeds groter wordt. Bij het werken met complexe hiërarchische gegevens zijn traditionele databases en zelfs NoSQL vaak niet efficiënt. Vaak, naarmate het aantal niveaus in de relaties en de grootte van de database toeneemt, zien we een daling in de prestaties. En met de toenemende complexiteit van de onderlinge relaties neemt ook het aantal JOINs toe.
Natuurlijk zijn er in het relationele model oplossingen voor het werken met hiërarchieën (bijvoorbeeld met behulp van recursieve CTE's), maar dit blijft nog steeds een omweg. Tegelijkertijd stelt de functionaliteit van grafdatabases in SQL Server je in staat om eenvoudig met meerdere niveaus van hiërarchie om te gaan. Zowel het datamodel als de queries worden eenvoudiger, wat hun efficiëntie verhoogt. De hoeveelheid code wordt aanzienlijk verminderd.
Grafdatabases zijn een krachtige taal voor het representeren van complexe systemen. Deze technologie wordt al vrij breed toegepast in de IT-industrie in gebieden zoals sociale netwerken, fraudepreventiesystemen, IT-netwerkanalyse, sociale aanbevelingen, productaanbevelingen en contentaanbevelingen.
De functionaliteit van grafdatabases in SQL Server is geschikt voor scenario's waarin de gegevens sterk met elkaar verbonden zijn en duidelijke relaties hebben.
Grafdatamodel
Een graf is een verzameling knopen (nodes) en verbindingen (edges). Knopen vertegenwoordigen entiteiten, terwijl verbindingen de relaties zijn waarin informatie kan worden opgeslagen.
Een grafdatabase modelleert entiteiten in de vorm van een graf zoals gedefinieerd in de grafentheorie. De datastructuren zijn knopen en verbindingen. Attributen zijn de eigenschappen van knopen en verbindingen. Een verbinding is een koppeling tussen knopen.
In tegenstelling tot andere datamodellen zijn in grafdatabases de onderlinge relaties tussen entiteiten van prioriteit. Daarom is het niet nodig om relaties te berekenen met behulp van externe sleutels of andere methoden. Je kunt complexe datamodellen creëren met alleen abstracties van knopen en verbindingen.
In de moderne wereld vereist het modelleren van relaties steeds complexere methoden. Voor het modelleren van relaties biedt SQL Server 2017 mogelijkheden van grafdatabases. Hoofden en randen van de grafiek worden weergegeven als nieuwe tabeltypes: NODE en EDGE. Voor de verzoeken naar de grafiek wordt een nieuwe T-SQL functie genaamd MATCH() gebruikt. Aangezien deze functionaliteit is ingebouwd in SQL Server 2017, kan het worden gebruikt in uw bestaande databases zonder dat hiervoor enige conversie nodig is.
Voordelen van het grafmodel
Tegenwoordig vereisen bedrijven en gebruikers applicaties die omgaan met steeds grotere hoeveelheden gegevens, terwijl ze een hoge prestaties en betrouwbaarheid verwachten. Het presenteren van gegevens in de vorm van een graf biedt handige middelen voor het verwerken van complexe relaties. Deze benadering helpt bij het oplossen van vele problemen en helpt om resultaten te behalen binnen de gegeven context.
Over het algemeen zullen in de toekomst veel applicaties profiteren van het gebruik van grafdatabases.
Gegevensmodellering: van relationeel model naar grafmodel
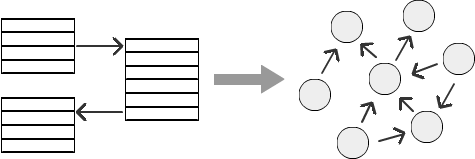
Voorbeeld
Laten we een voorbeeld van een organisatiestructuur met een hiërarchie van medewerkers bekijken: een medewerker valt onder een manager, de manager onder een senior manager, en ga zo verder. Afhankelijk van het specifieke bedrijf kan er in deze hiërarchie een onbeperkt aantal niveaus zijn. Maar naarmate het aantal niveaus toeneemt, wordt het berekenen van de relaties in een relationele database steeds moeilijker. Het is vrij lastig om de hiërarchie van medewerkers, de hiërarchie in marketing of relaties in sociale netwerken voor te stellen. Laten we eens bekijken hoe we met SQL Graph het probleem van het verwerken van verschillende hiërarchieniveaus kunnen oplossen.
Voor dit voorbeeld maken we een eenvoudig datamodel. We creëren een medewerkerstabel EMP met een identificatienummer EMPNO en een kolom MGR, die verwijst naar de identificatie van de leidinggevende (manager) van de medewerker. Alle informatie over de hiërarchie wordt in deze tabel opgeslagen en kan worden opgevraagd met behulp van de kolommen. EMPNO en MGR.
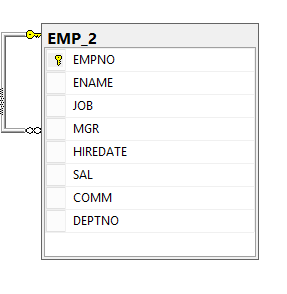
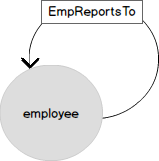
In het volgende diagram is ook hetzelfde model van de organisatiestructuur met vier niveaus van inspringen weergegeven in een meer gebruikelijke opmaak. Medewerkers zijn de hoofden van de grafiek uit de tabel EMP. De entiteit ‘werknemer’ is met zichzelf verbonden door de relatie ‘valt onder’ (ReportsTo). In grafische termen is een relatie een rand (EDGE) die knooppunten (NODE) van medewerkers verbindt.
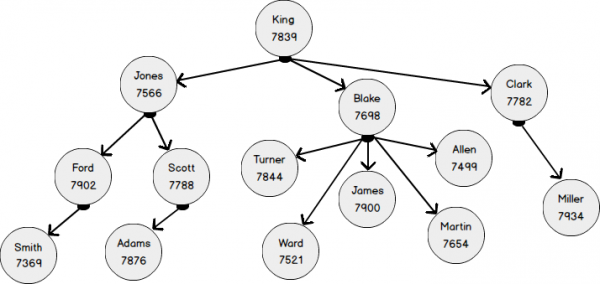
Laten we een reguliere tabel maken EMP en voegen we waarden toe volgens het hierboven gegeven diagram.
CREATE TABLE EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

INSERT INTO EMP VALUES
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
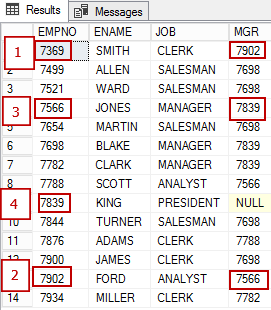
De medewerkers zijn weergegeven in de onderstaande afbeelding:
- de medewerker met EMPNO 7369 rapporteert aan 7902;
- de medewerker met EMPNO 7902 rapporteert aan 7566
- de medewerker met EMPNO 7566 rapporteert aan 7839
Laten we nu kijken naar de weergave van dezelfde gegevens als een grafiek. De knoop EMPLOYEE heeft verschillende attributen en is verbonden met zichzelf via de relatie 'rapporteert aan' (EmplReportsTo). EmplReportsTo is de naam van de relatie.
In de tabel met randen (EDGE) kunnen ook attributen aanwezig zijn.
Laten we de knoottabel EmpNode aanmaken
De syntaxis voor het creëren van een knoop is vrij eenvoudig: aan de verklaring CREATE TABLE wordt aan het einde 'AS NODE' toegevoegd.
CREATE TABLE dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) AS NODE;
Laten we nu de gegevens van de reguliere tabel naar de grafiek converteren. De volgende INSERT voegt gegevens in vanuit de relationele tabel EMP.
INSERT INTO EmpNode(EMPNO,ENAME,MGR,DNO) select empno,ename,MGR,dno from emp 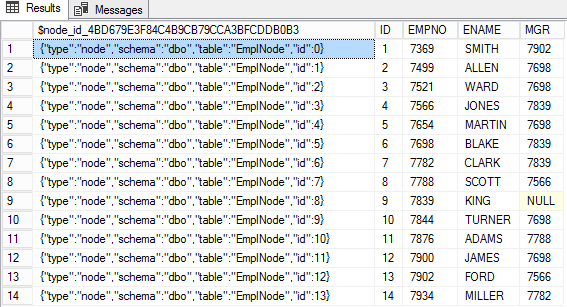
In de knoottabel wordt de speciale kolom $node_id_* gebruik om de knoop-ID op te slaan in JSON-formaat. In de andere kolommen van deze tabel staan de attributen van de knoop.
Laten we randen (EDGE) aanmaken
Het creëren van de tabel met randen is zeer vergelijkbaar met het creëren van de tabel met knopen, met uitzondering van het feit dat het sleutelwoord 'AS EDGE' wordt gebruikt.
CREATE TABLE empReportsTo(Deptno int) AS EDGE 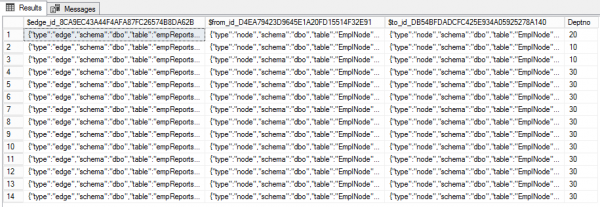
Laten we nu de relaties tussen de medewerkers definiëren met behulp van de kolommen EMPNO en MGR. In het organigram is goed zichtbaar hoe dit moet worden opgeschreven. INSERT.
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 1),
   	(SELECT $node_id FROM EmpNode WHERE id = 13),20);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 2),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 3),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10)
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 4),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 5),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 6),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 7),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 8),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 9),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 10),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 11),
   	(SELECT $node_id FROM EmpNode WHERE id = 8),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 12),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 13),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo  VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 14),
   	(SELECT $node_id FROM EmpNode WHERE id = 7),30);
De standaard randen tabel bestaat uit drie kolommen. De eerste, $edge_id — de identificatie van de rand in JSON-vorm. De twee andere ($from_id en $to_id) vertegenwoordigen de relatie tussen knooppunten. Bovendien kunnen randen aanvullende eigenschappen hebben. In ons geval is dat Deptno.
Systeemweergaven
In de systeemweergave sys.tables zijn er twee nieuwe kolommen toegevoegd:
- is_edge
- is_node
SELECT t.is_edge,t.is_node,*
FROM sys.tables t
WHERE name like 'emp%' 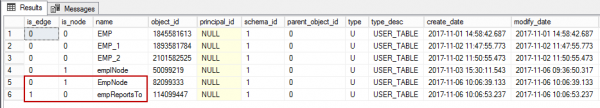
SSMS
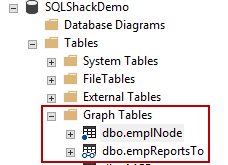
Objecten gerelateerd aan grafen bevinden zich in de map Graph Tables. Het pictogram van de knooppuntentabel is gemarkeerd met een punt, terwijl de randen tabellen — twee verbonden cirkels hebben (wat een beetje op een bril lijkt).
De MATCH-uitdrukking
De uitdrukking MATCH is ontleend aan CQL (Cypher Query Language). Dit is een efficiënte manier om naar graf-eigenschappen te query'en. CQL begint met de uitdrukking MATCH.
Syntax
MATCH (<graph_search_pattern>)

<graph_search_pattern>::=
    {<node_alias> {
                 	{ <-( <edge_alias> )- }
               	| { -( <edge_alias> )-> }
             	<node_alias>
             	}
 	}
 	[ { AND } { ( <graph_search_pattern> ) } ]
 	[ ,...n ]

<node_alias> ::=
    node_table_name | node_alias

<edge_alias> ::=
    edge_table_name | edge_alias
Voorbeelden
Laten we een aantal voorbeelden bekijken.
De onderstaande query toont de medewerkers die onder Smith vallen en zijn manager.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
FROM
    empnode e, empnode e1, empReportsTo m
WHERE
    MATCH(e-(m)->e1)
and e.ENAME='SMITH' 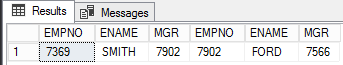
De volgende query is bedoeld om medewerkers en managers van het tweede niveau voor Smith te zoeken. Als we de zin weghalen, WAAR, dan worden alle medewerkers weergegeven.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 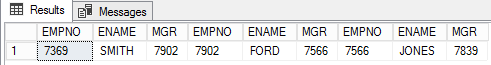
En tot slot, de query voor medewerkers en managers van het derde niveau.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Laten we nu de richting veranderen om de leidinggevenden van Smith te krijgen.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 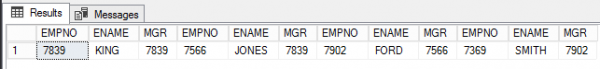
Conclusie
SQL Server 2017 heeft zich bewezen als een volwaardig enterprise-oplossing voor verschillende IT-taken van bedrijven. De eerste versie van SQL Graph is veelbelovend. Ook al zijn er enkele beperkingen, er is al voldoende functionaliteit om de mogelijkheden van grafen te verkennen.
De functionaliteit van SQL Graph is volledig geïntegreerd in de SQL-engine. Zoals eerder gezegd, zijn er in SQL Server 2017 de volgende beperkingen:
Geen ondersteuning voor polymorfisme.
- Alleen unidirectionele relaties worden ondersteund.
- Randen kunnen de kolommen $from_id en $to_id niet via UPDATE bijwerken.
- Transitive closure wordt niet ondersteund, maar kan worden verkregen via CTE.
- Beperkte ondersteuning voor In-Memory OLTP-objecten.
- Temporale tabellen (System-Versioned Temporal Table), tijdelijke lokale en globale tabellen worden niet ondersteund.
- Tabeltypes en tabelvariabelen kunnen niet als NODE of EDGE worden gedeclareerd.
- Queries tussen databases (cross-database queries) worden niet ondersteund.
- Er is geen directe manier of wizard voor het omzetten van gewone tabellen naar grafen.
- Er is geen GUI voor het weergeven van grafen, maar Power BI kan worden gebruikt.
Lees meer:
Bron: habr.com
