

VictoriaMetrics — een snelle en schaalbare database voor het opslaan en verwerken van gegevens in de vorm van tijdreeksen (een opname creëert tijd en een set bijbehorende waarden, bijvoorbeeld verkregen via periodieke metingen van sensoren of het verzamelen van metrics).
Mijn naam is Kolobaev Pavel. DevOps, SRE, LeroyMerlin, alles als code – dat is waar wij voor staan: voor mij en voor andere medewerkers van LeroyMerlin.
Er is een cloud gebaseerd op OpenStack. Hier is een korte link naar de tech radar.
Het is gebouwd op de hardware van Kubernetes, evenals op alle bijbehorende services van OpenStack en logging.
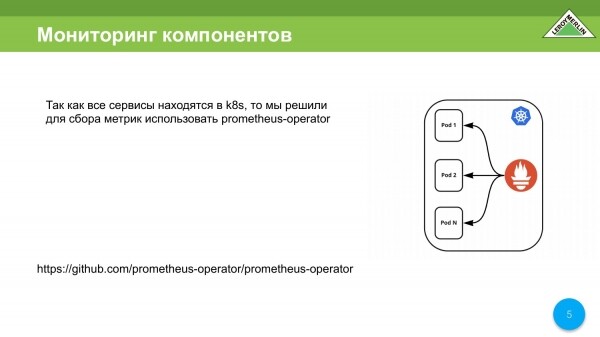
De opzet was als volgt tijdens de ontwikkeling. Toen we dit allemaal ontwikkelden, hadden we een Prometheus-operator die gegevens opsloeg binnen het K8s-cluster zelf. Hij vindt automatisch wat hij moet scrapen en verzamelt het, om zo te zeggen, onder zijn voeten.
We moeten alle gegevens buiten het Kubernetes-cluster halen, want als er iets gebeurt, moeten we begrijpen wat er is en waar.
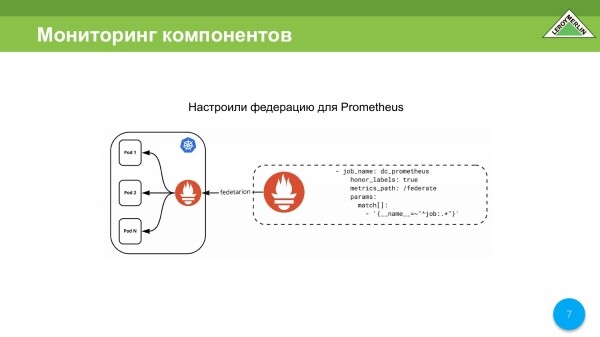
De eerste oplossing is dat we federation gebruiken, wanneer we een externe Prometheus hebben, en wanneer we naar het Kubernetes-cluster gaan via het federation-mechanisme.
Maar hier ontstaan kleine problemen. In ons geval begonnen de problemen toen we 250.000 metrics hadden, en toen het 400.000 metrics werden, realiseerden we ons dat we zo niet konden werken. We hebben de scrape_timeout verhoogd naar 25 seconden.
Waarom moesten we dit doen? Prometheus begint de tijd van de timeout te tellen vanaf het moment van ophalen. Het maakt niet uit dat de gegevens nog steeds binnenkomen. Als de gegevens in deze opgegeven tijdsspanne niet zijn verzameld en de sessie niet wordt gesloten via http, wordt de sessie als mislukt beschouwd en komen de gegevens niet in Prometheus.
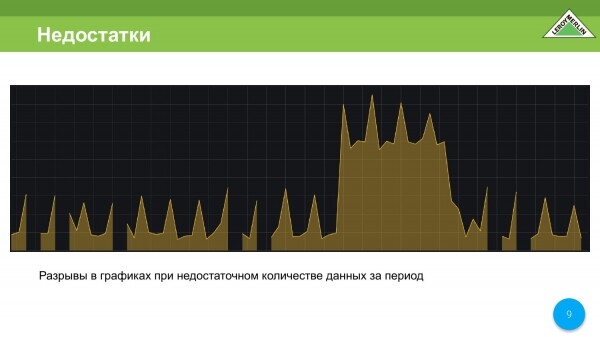
Iedereen kent de grafieken die we krijgen wanneer een deel van de gegevens ontbreekt. De grafieken zijn gebroken en dat is ons niet acceptabel.
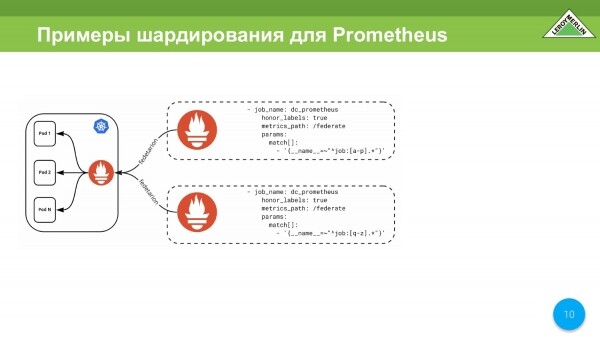
De volgende optie is shard-verdelen op basis van twee verschillende Prometheus-instanties door middel van hetzelfde federation-mechanisme.
Bijvoorbeeld, gewoon de gegevens op naam te shard-verdelen. Dit kan ook worden gebruikt, maar we besloten verder te gaan.
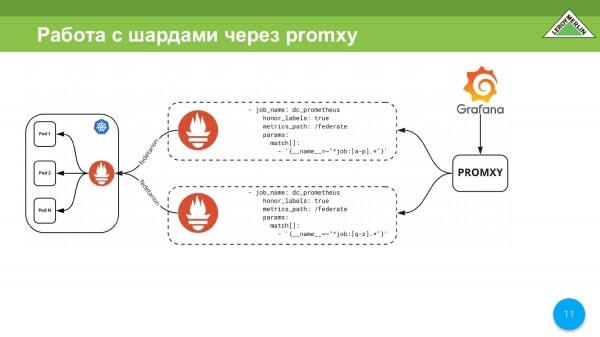
We zullen nu deze shards op een of andere manier moeten verwerken. We kunnen promxy gebruiken, dat naar het shard-gebied gaat en gegevens multiplixeert. Het werkt met twee shards als één toegangspunt. Dit kan via promxy worden gerealiseerd, maar het is nog te complex.
De eerste optie is dat we willen afzien van het federation-mechanisme, omdat het erg traag is.
De ontwikkelaars van Prometheus zeggen duidelijk: "Jongens, gebruik andere TimescaleDB, want we zullen de langdurige opslag van metrics niet ondersteunen." Het is niet hun taak. 
We noteren op papier dat we externe export nodig hebben, zodat we niet alles op één plek opslaan.
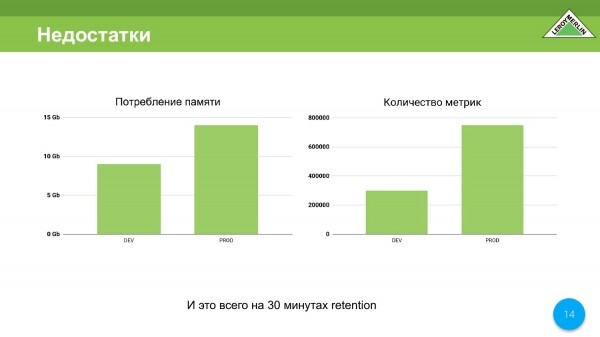
Een ander nadeel is het geheugenverbruik. Ja, ik begrijp dat velen zullen zeggen dat een paar gigabyte geheugen in 2020 nauwelijks wat kost, maar toch.
Momenteel hebben we een dev- en prod-omgeving. In dev is dat ongeveer 9 gigabyte voor 350.000 metrics. In prod is dat iets meer dan 14 gigabyte voor 780.000 metrics. Daarbij hebben we een retentietijd van slechts 30 minuten. Dat is slecht. En ik zal uitleggen waarom.
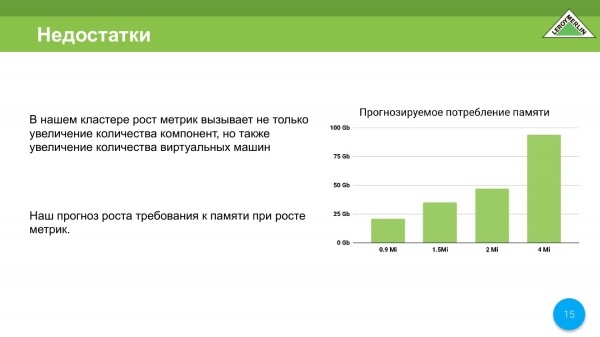
We maken een berekening, dat wil zeggen, met anderhalve miljoen metrics, en we zijn daar al dichtbij, krijgen we in de ontwerpfase al 35-37 gigabyte geheugen. Maar bij 4 miljoen metrics is al ongeveer 90 gigabyte geheugen nodig. Dit is berekend volgens de formule die de ontwikkelaars van Prometheus bieden. We hebben de correlatie bekeken en begrepen dat we niet een paar miljoen willen betalen voor een server die alleen voor monitoring is.
Niet alleen neemt het aantal machines toe, we monitoren ook de virtuele machines zelf. Hoe meer virtuele machines, hoe meer verschillende metrics, enzovoort. We verwachten daarom een speciale groei van ons cluster wat betreft metrics.
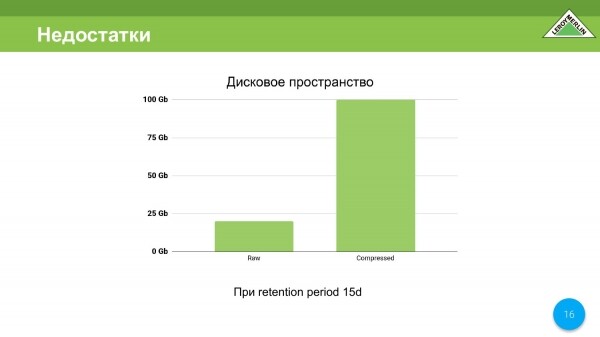
Wat opslagruimte betreft is het hier niet zo slecht, maar we willen het verbeteren. We hebben in 15 dagen in totaal 120 gigabyte gekregen, waarvan 100 gigabyte gecomprimeerde data is en 20 gigabyte niet-gecomprimeerde data, maar we willen altijd minder.
Daarom voegen we nog een punt toe – dat is het hoge verbruik van middelen dat we eigenlijk willen besparen, omdat we niet willen dat ons monitoringcluster meer middelen gebruikt dan ons cluster dat OpenStack beheert.
Er is nog een ander nadeel van Prometheus dat we hebben ontdekt, namelijk dat er enige beperking op het geheugen is. Met Prometheus is dit veel erger, omdat er helemaal geen dergelijke mogelijkheden zijn. Het gebruik van beperkingen in docker is ook geen optie. Als uw RAF bijvoorbeeld is neergestort en er 20-30 gigabyte is, dan zal het heel lang duren voordat het weer opstart.
Dit is nog een reden waarom Prometheus niet geschikt voor ons is, namelijk dat we het geheugenverbruik niet kunnen beperken.
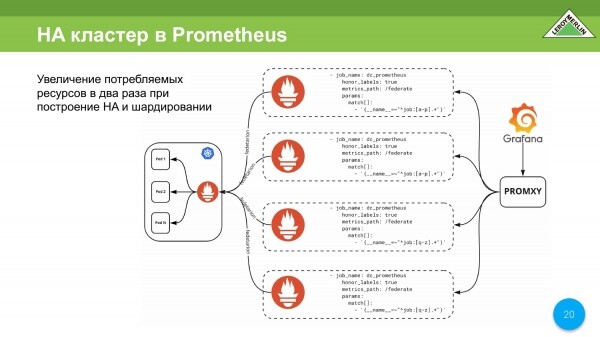
We could adopt such a scheme. This scheme is necessary for us to organize an HA cluster. We want our metrics to be always and everywhere accessible, even in case of a server failure that stores these metrics. Thus, we have to build such a scheme.
This scheme states that we will have shard duplication, and consequently, duplication of resource consumption. It can be scaled almost horizontally, but nonetheless, resource consumption will be tremendous.
The disadvantages in the order we outlined for ourselves:
- Metrics need to be exported externally.
- High resource consumption.
- Memory consumption cannot be limited.
- Complex and resource-intensive implementation of HA.
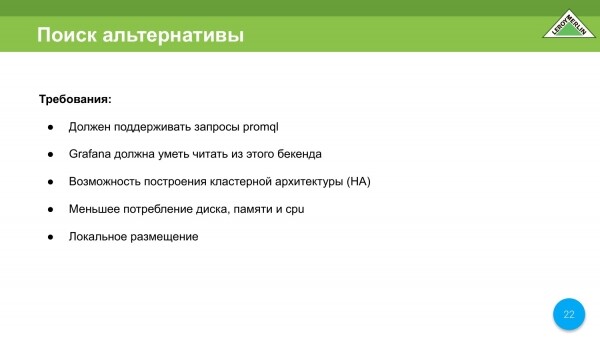
We decided to move away from Prometheus as a storage solution.
We have defined additional requirements that we need. They are:
- Support for promql, because a lot has already been written for Prometheus: queries, alerts.
- And then we have Grafana, which is also written for Prometheus as the backend. We do not want to rewrite dashboards.
- We want to build a proper HA architecture.
- We want to reduce the consumption of any resources.
- There is one small nuance. We cannot use various cloud metrics collection systems. We do not know what will go into these metrics yet. And since anything can go there, we have to limit ourselves to local deployment.
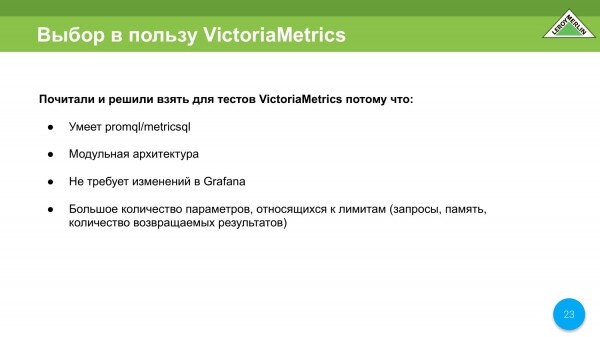
The choice was small. We gathered everything we had experience with. We looked at the Prometheus integration page, read a lot of articles, checked what is available. And we chose VictoriaMetrics as a replacement for Prometheus.
Why? Because:
- It supports promql.
- It has a modular architecture.
- It does not require changes in Grafana.
- And most importantly – we may provide metrics storage within our company as a service, so we are proactively considering various limitations to allow users to use all cluster resources in a limited fashion, since there is a chance that it will be multitenancy.
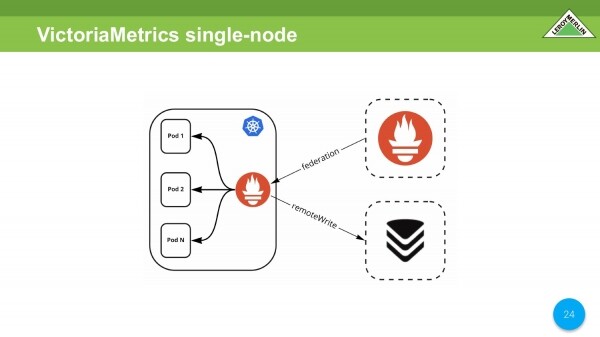
We make the first comparison. We take the same Prometheus inside the cluster, and an external Prometheus queries it. We add VictoriaMetrics via remoteWrite.
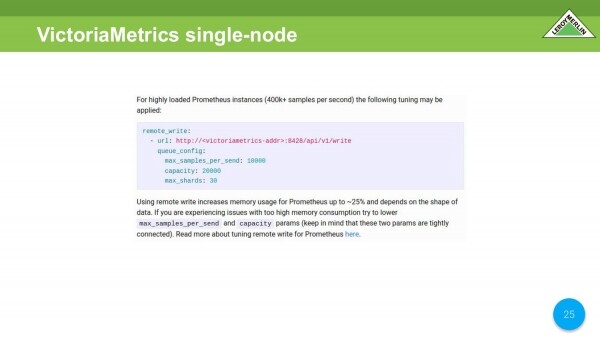
Ik wil meteen verduidelijken dat we hier een kleine toename in CPU-verbruik van VictoriaMetrics hebben opgemerkt. Op de VictoriaMetrics-wiki staat welke parameters het beste passen. We hebben ze gecontroleerd. Ze hebben het CPU-verbruik aanzienlijk verminderd.
In ons geval is het geheugengebruik van Prometheus, dat zich in een Kubernetes-cluster bevindt, niet significant toegenomen.
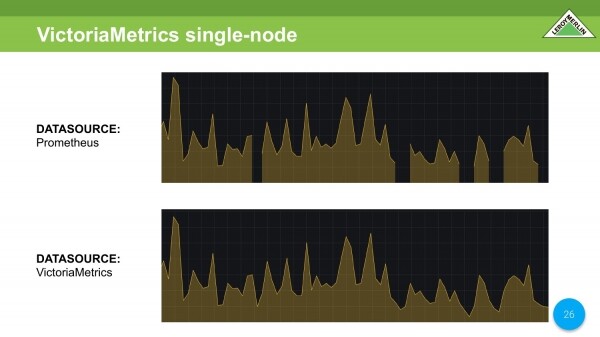
We vergelijken twee data sources met dezelfde gegevens. In Prometheus zien we al die ontbrekende gegevens. In VictoriaMetrics is alles goed.
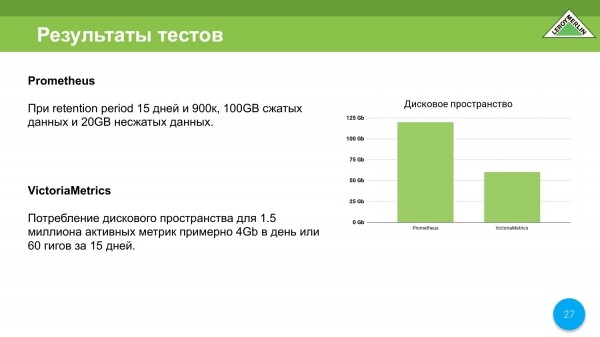
Resultaten van de tests met opslagcapaciteit. We hebben in Prometheus in totaal 120 gigabytes gekregen. In VictoriaMetrics krijgen we al 4 gigabytes per dag. Daar is het mechanisme een beetje anders dan wat we gewend zijn in Prometheus. Dat wil zeggen, de gegevens worden al goed gecomprimeerd over een dag, zelfs over een half uur. Ze zijn al goed gecomprimeerd, ondanks dat er later nog gegevens samengevoegd zullen worden. Uiteindelijk hebben we op opslagruimte bespaard.
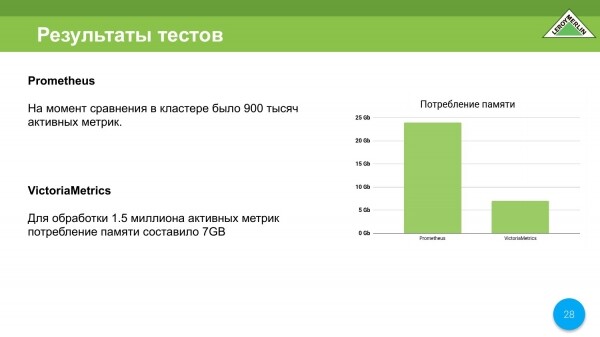
We besparen ook op het geheugengebruik. Bij de tests was Prometheus uitgerold op een virtuele machine – 8 cores, 24 gigabytes. Prometheus verbruikt bijna alles. Het viel onder de OOM Killer. Ondertussen had het slechts 900.000 actieve metrics. Dit is ongeveer 25.000-27.000 metrics per seconde.
VictoriaMetrics draaide op een dual-core virtuele machine met 8 gigabytes RAM. We hebben het voor elkaar gekregen om VictoriaMetrics goed te laten werken door enkele dingen op de 8-gigabyte machine aan te passen. Uiteindelijk waren we onder de 7 gigabytes. Tegelijkertijd kregen we een hogere doorvoersnelheid van content, dat wil zeggen metrics, dan bij Prometheus.
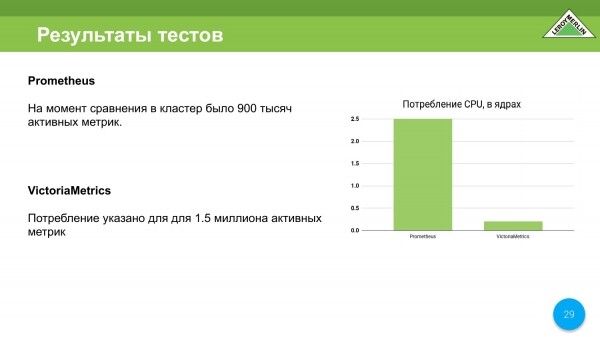
Het CPU-gebruik is veel beter ten opzichte van Prometheus. Hier verbruikt Prometheus 2,5 cores, terwijl VictoriaMetrics slechts 0,25 core verbruikt. Bij de start is dat 0,5 core. Tijdens het samenvoegen bereikt het soms één core, maar dat is uiterst zeldzaam.
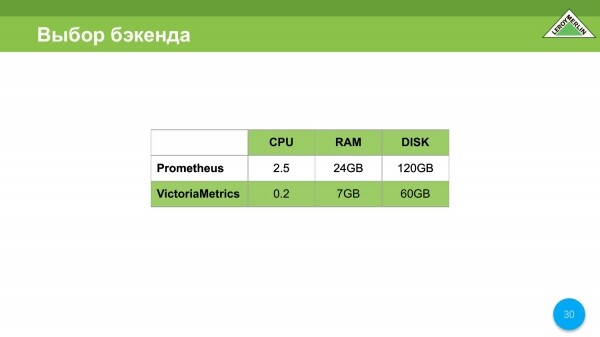
In ons geval viel de keuze op VictoriaMetrics om begrijpelijke redenen, we wilden besparen en dat is gelukt.
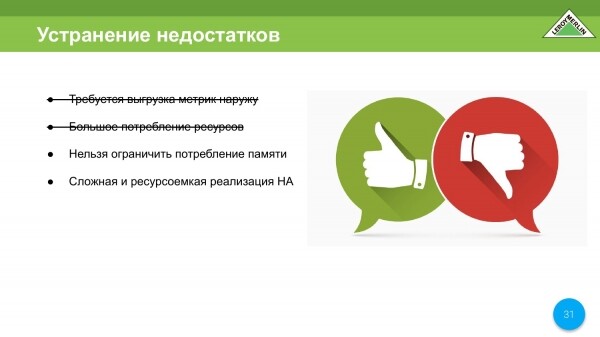
We schrapen meteen twee punten – dat is het exporteren van metrics en het hoge verbruik van bronnen. We moeten nog twee punten oplossen die we voor onszelf hebben overgelaten.
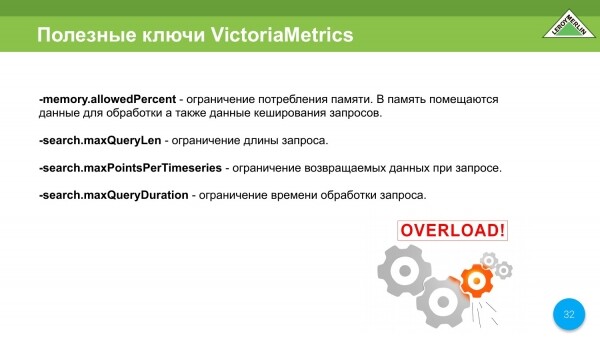
Hier wil ik meteen verduidelijken, we beschouwen VictoriaMetrics als een metrics opslag. Maar omdat we VictoriaMetrics waarschijnlijk als opslag voor alles Leroy gaan aanbieden, moeten we degenen die deze cluster zullen gebruiken beperken, zodat ze ons niet in de problemen brengen.
Er is een geweldige parameter die de tijd, datavolume en uitvoeringstijd kan beperken.
Ook is er een uitstekende optie waarmee geheugenverbruik kan worden beperkt, zodat we de juiste balans kunnen vinden die ons normale werkingssnelheid en een adequaat middelenverbruik biedt.
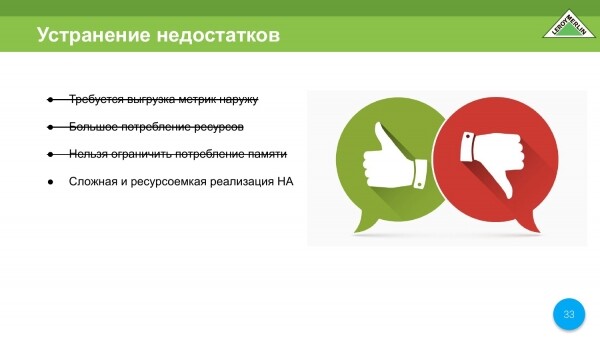
Een nadeel is dat we geen geheugenverbruik kunnen beperken.
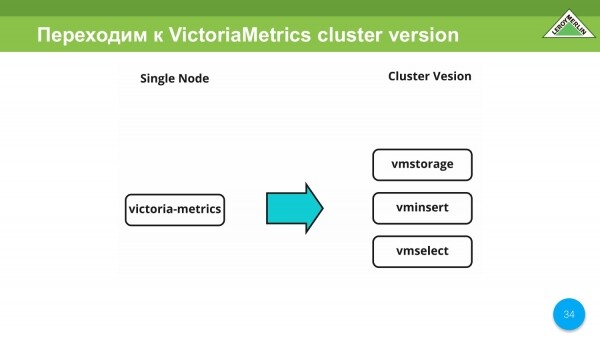
In de eerste iteraties hebben we VictoriaMetrics Single Node getest. Vervolgens gaan we over op de Cluster Versie van VictoriaMetrics.
Hier kunnen we verschillende services van VictoriaMetrics scheiden op basis van waar ze op draaien en welke middelen ze verbruiken. Dit is een zeer flexibele en handige oplossing. We hebben het zelf gebruikt.
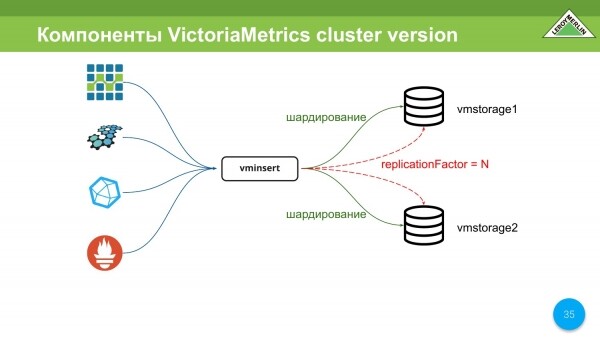
De belangrijkste componenten van de Cluster Versie van VictoriaMetrics zijn vmstorage. Er kunnen er N aantal zijn. In ons geval zijn dat er voorlopig 2.
En er is vminsert. Dit is een proxyserver die ons in staat stelt om sharding te organiseren tussen alle storages die we hebben aangegeven, en het biedt ook replicatie, dus je hebt zowel sharding als replicatie.
Vminsert ondersteunt de protocollen OpenTSDB, Graphite, InfluxDB en remoteWrite van Prometheus.
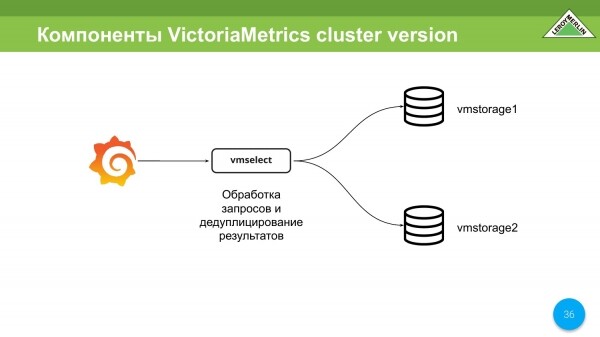
Er is ook vmselect. De belangrijkste taak hiervan is om naar vmstorage te gaan, gegevens van hen te verkrijgen, deze gegevens te dedupliceren en aan de klant te leveren.
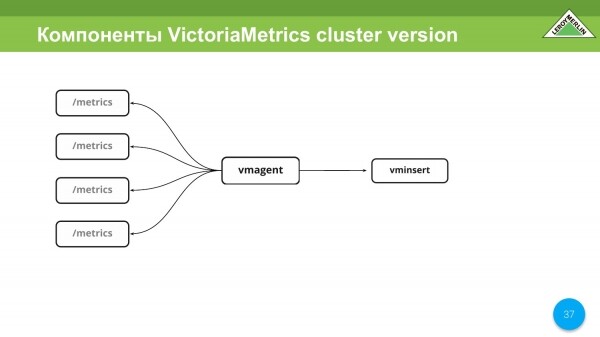
Er is een geweldige tool genaamd vmagent. We zijn er erg blij mee. Het stelt je in staat om te configureren net als Prometheus en doet alles precies zoals Prometheus. Het verzamelt metrics van verschillende entiteiten en services en stuurt ze naar vminsert. Daarna hangt alles van jou af.
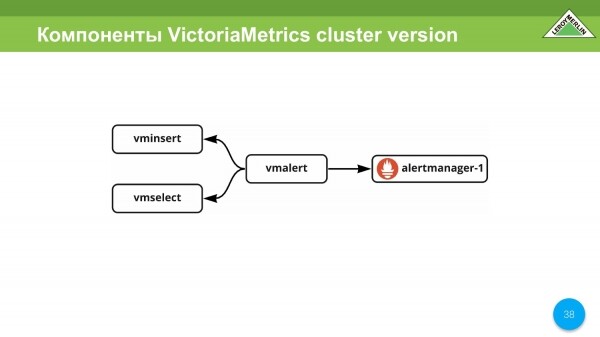
Een andere geweldige service is vmalert, die VictoriaMetrics als backend gebruikt, gegevens van vminsert ontvangt en verwerkte gegevens naar vmselect stuurt. Het verwerkt de alerts en de regels. In het geval van alerts krijgen we een alert via de alertmanager.
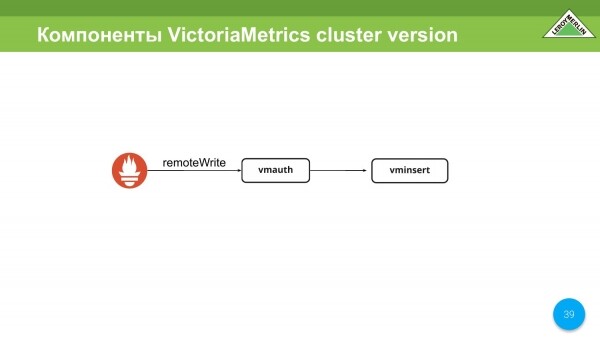
Er is de component wmauth. Deze zullen we mogelijk gebruiken, maar misschien ook niet (we hebben hier nog geen beslissing over genomen) als een autorisatiesysteem voor de multitenancy versie van de clusters. Het ondersteunt remoteWrite voor Prometheus en kan autoriseren op basis van de url, specifiek het tweede deel ervan, naar waar je wel of niet kunt schrijven.
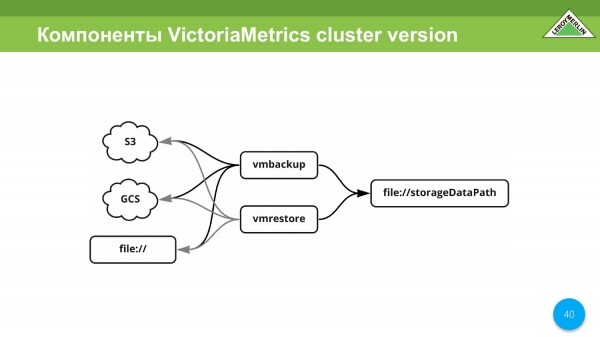
Er zijn ook vmbackup en vmrestore. Dit is in wezen herstel en backup van alle gegevens. Het ondersteunt S3, GCS, bestand.
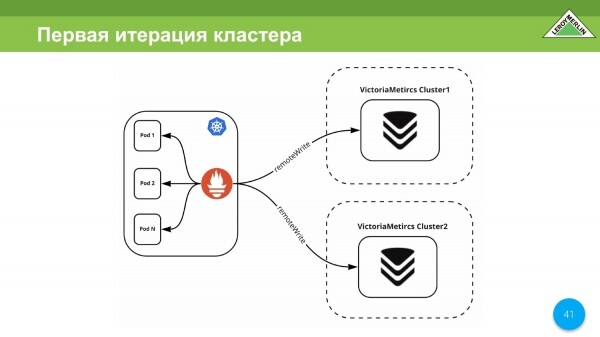
De eerste iteratie van onze cluster vond plaats tijdens de lockdown. Op dat moment was er geen replica, dus onze iteratie bestond uit twee verschillende en onafhankelijke clusters, waarvan we gegevens via remoteWrite ontvingen.
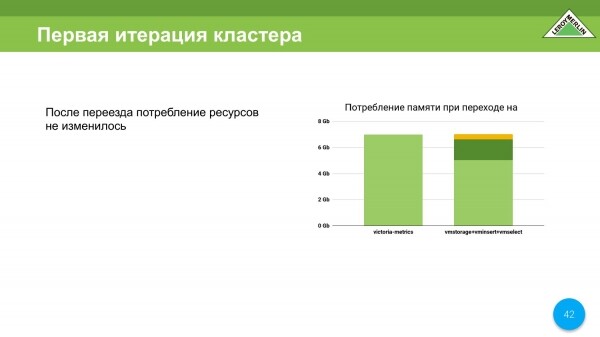
Hier wil ik opmerken dat toen we overstapten van VictoriaMetrics Single Node naar VictoriaMetrics Cluster Version, we nog steeds binnen dezelfde bronnen bleven, dat wil zeggen voornamelijk het geheugen. Zo zijn onze gegevens verdeeld, dat wil zeggen het gebruik van bronnen.
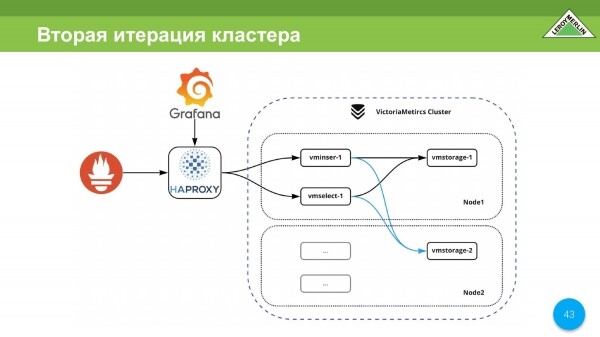
Hier was al een replica toegevoegd. We hebben dit allemaal samengevoegd in één relatief groot cluster. Alle gegevens worden zowel geshard als gerepliceerd.
Het hele cluster heeft N toegangspunten, dat wil zeggen dat Prometheus gegevens kan toevoegen via HAPROXY. Dit is onze toegangspunt. En via dit toegangspunt kan je inloggen met Grafana.
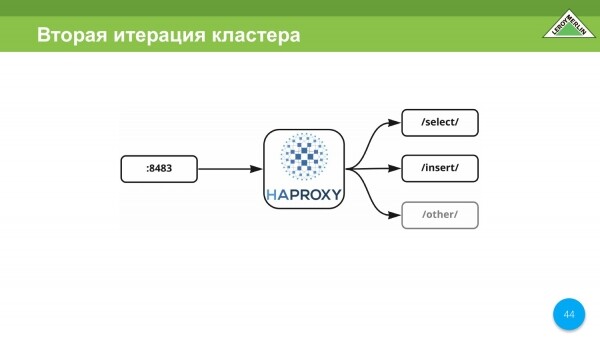
In ons geval is HAPROXY de enige poort die select, insert en andere services naar binnen in dit cluster proxy't. In ons geval was het niet mogelijk om één adres te maken; we moesten meerdere toegangspunten creëren, omdat de virtuele machines waarop de VictoriaMetrics-cluster draait zich in verschillende zones van één cloudprovider bevinden, dat wil zeggen niet binnen onze cloud, maar buiten.
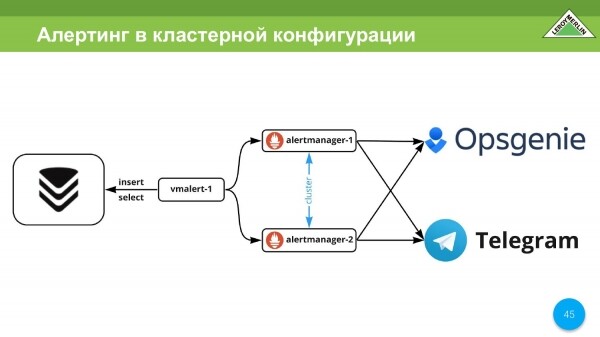
We hebben alerting. We gebruiken het. We gebruiken de alertmanager van Prometheus. Voor het leveren van alerts gebruiken we Opsgenie en Telegram. In Telegram komen alerts binnen van dev, misschien iets van prod, maar vooral statistische zaken die nodig zijn voor ingenieurs. Opsgenie is kritisch. Dit zijn telefoontjes, incidentmanagement.
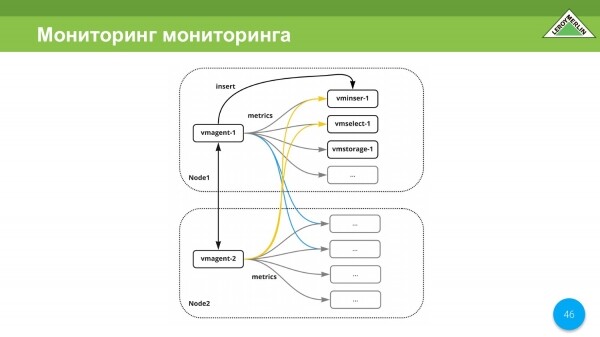
De eeuwige vraag: "Wie monitort de monitoring?" In ons geval monitort de monitoring zichzelf, omdat we vmagent op elke node gebruiken. En aangezien onze nodes verspreid zijn over verschillende datacenters van één provider, hebben we voor elk datacenter ons eigen kanaal; ze zijn onafhankelijk en zelfs als er een split brain optreedt, krijgen we alsnog alerts. Ja, er zullen er meer zijn, maar het is beter om meer alerts te krijgen dan helemaal geen.
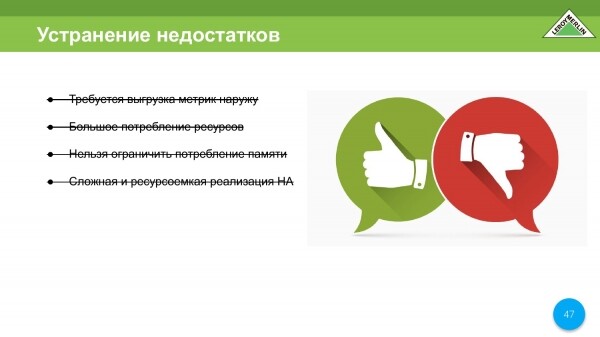
We beëindigen onze lijst met de implementatie van HA.
Verder wil ik de positieve ervaring met de VictoriaMetrics-community benadrukken. Het is erg positief geweest. De mensen zijn betrokken en proberen elk geval dat wordt voorgesteld te begrijpen.
Ik heb issues aangemaakt op GitHub. Deze werden heel snel opgelost. Er zijn nog een paar issues die niet helemaal zijn afgesloten, maar ik zie al aan de code dat er aan dit onderwerp wordt gewerkt.
Mijn grootste probleem tijdens de iteraties was dat als ik een node uitschakelde, mijn vminsert de eerste 30 seconden niet kon begrijpen dat de backend niet beschikbaar was. Dit is inmiddels opgelost. Nu worden de gegevens in slechts een seconde of twee van alle resterende nodes opgehaald, en de aanvraag stopt met wachten op die ontbrekende node.
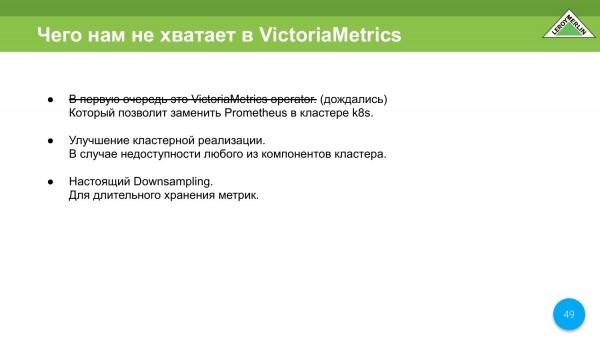
Op een gegeven moment wilden we dat het een VictoriaMetrics-operator zou zijn. We hebben erop gewacht. We zijn nu actief bezig met het bouwen van een omhulsel rond de VictoriaMetrics-operator om alle pre-calculating rules enzovoort van Prometheus over te nemen, omdat we behoorlijk actief gebruik maken van de regels die bij de Prometheus-operator komen.
Er zijn voorstellen voor verbeteringen van de clusterimplementatie. Ik heb ze hierboven uiteengezet.
En ik ben ook heel erg geïnteresseerd in downsampling. In ons geval is downsampling uitsluitend nodig voor het bekijken van trends. Grof gezegd, ik heb genoeg aan één metric gedurende de dag. Deze trends zijn nodig voor één jaar, drie jaar, vijf jaar, en tien jaar. Eén waarde van de metric is volledig voldoende.
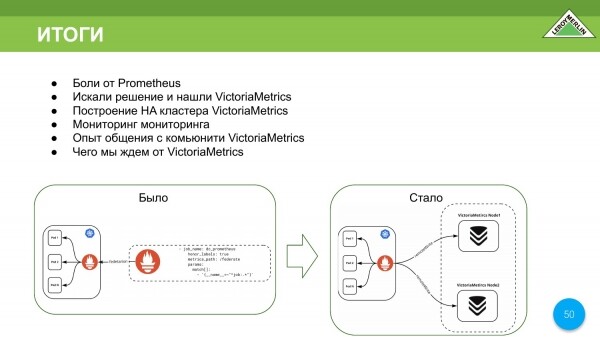
- Wij hebben de pijn ervaren, net als sommige van onze collega's, bij het gebruik van Prometheus.
- Wij hebben voor onszelf VictoriaMetrics gekozen.
- Het schaalt zowel verticaal als horizontaal behoorlijk goed.
- We kunnen verschillende componenten op verschillende aantallen nodes in het cluster verspreiden, hun geheugengebruik limiteren, geheugen toevoegen, enzovoort.
Wij zullen VictoriaMetrics intern gebruiken, omdat we er erg tevreden mee zijn. Dit is wat was en wat is geworden.
Een paar qr-codes voor de VictoriaMetrics-chat, mijn contacten, de techradar van LeroyMerlin.
Bron: habr.com
