

Hallo.
Ik besloot mijn ontdekking te delen - het resultaat van overpeinzing, experimenteren en fouten maken.
In wezen: dit is natuurlijk geen ontdekking - dit zou al lang bekend moeten zijn voor degenen die zich bezighouden met toegepaste statistische data-analyse en optimalisatie van systemen, niet noodzakelijkerwijs specifiek databasesystemen.
En: ja, mensen weten het, ze schrijven interessante artikelen over hun onderzoeken, (UPD.: in de opmerkingen wezen ze op een zeer interessant project: )
Aan de andere kant zie ik niet echt brede vermelding of verspreiding van zo'n aanpak op internet, onder IT-specialisten, DBA's.
Dus, naar de kern.
Stel dat we de taak hebben: een bepaald servicesysteem in te stellen voor het uitvoeren van een bepaalde taak.
Over deze taak is bekend: hoe deze is, op welke manier de kwaliteit van deze taak wordt gemeten en wat de criteria zijn voor het meten van deze kwaliteit.
Laten we ook aannemen dat, meer of minder bekend is: hoe precies de taak in (of met) dit servicesysteem wordt uitgevoerd.
"Meer of minder" betekent dat er een mogelijkheid is om een bepaalde tool, utiliteit of service voor te bereiden of ergens vandaan te halen waarmee we een testbelasting kunnen synthetiseren en aan het systeem kunnen aanbieden die voldoende representatief is voor wat er in productie zal zijn, onder redelijk dezelfde omstandigheden als in productie.
En laten we aannemen dat de set regelparameters van dit servicesysteem bekend is, waarmee we dit systeem kunnen instellen in termen van de productiviteit.
En waar is het probleem - er is geen voldoende volledig begrip van dit servicesysteem dat het mogelijk maakt om de instellingen van dit systeem deskundig af te stellen op de toekomstige belasting op dit platform en de nodige productiviteit van het systeem te behalen.
Nou, zo gaat het eigenlijk bijna altijd.
Wat kunnen we hier doen.
Nou, het eerste dat in me opkomt: kijk in de documentatie van dit systeem. Begrijp - wat zijn de toegestane bereiken voor de waarden van de regelparameters. En bijvoorbeeld, door middel van een coördinaatafdalingsmethode, waarden voor de parameters van het systeem afstemmen in tests.
Dus, de systeemconfiguratie instellen met een specifieke reeks waarden voor zijn regelparameters.
Testbelasting aanleveren met diezelfde tool-utiliteit, load-generator.
En de grootte – respons, of kwaliteitsscore van het systeem bekijken.
Een tweede gedachte zou kunnen zijn dat - dit is heel tijdrovend.
Dus, als er veel instelparameters zijn, de waarden die ze kunnen aannemen groot zijn, en elke afzonderlijke belastingstest veel tijd kost, dan: ja, dat kan onaanvaardbaar veel tijd in beslag nemen.
En hier kunnen we iets begrijpen en ons herinneren.
Er kan een vector worden vastgesteld in de verzameling waarden van de instelparameters van het servicesysteem, als een reeks bepaalde waarden.
Aan elke dergelijke vector, onder gelijke omstandigheden (waarbij deze vector geen invloed heeft), correspondeert een welbepaald waarde van de metriek - een kwaliteitsindicator van het functioneren van het systeem onder testbelasting.
Dus.
Laten we de vector van de systeemconfiguratie aanduiden als  , waar
 ; Waar
 — het aantal parameters van de systeemconfiguratie, hoeveel van deze parameters er zijn.
En de waarde van de metriek die overeenkomt met dit  noemen we
 , dan krijgen we een functie:

En dan: alles komt onmiddellijk neer op, in mijn geval: bijna vergeten algoritmen voor het zoeken naar extremen van een functie, sinds de studietijd.
Goed, maar hier rijst de organisatorische en praktische vraag: welk specifiek algoritme moet worden gebruikt.
- Dat wil zeggen - om zelf zo min mogelijk handmatig te coderen.
- En zodat het werkt, dat wil zeggen, het extremum vindt (als het er is), tenminste - sneller dan coördinatenafdalingen.
Het eerste punt geeft aan dat we moeten kijken naar bepaalde omgevingen waarin dergelijke algoritmen al zijn geïmplementeerd en in een of andere vorm klaar zijn voor gebruik in code.
Nou, ik ken python en cran-r
Het tweede punt betekent dat we iets moeten lezen over de algoritmen zelf, welke er zijn, wat hun vereisten en bijzondere kenmerken van hun werking zijn.
En wat ze opleveren, of nuttige bijwerkingen - resultaten kunnen zijn, of direct van het algoritme zelf.
Of ze kunnen worden verkregen uit de resultaten van de werking van het algoritme.
Hier hangt veel af van de invoervoorwaarden.
Als we bijvoorbeeld om een of andere reden sneller een resultaat moeten krijgen, moeten we in de richting van gradient descent-algoritmen kijken en er een kiezen.
Of, als de tijd niet zo belangrijk is, kunnen we bijvoorbeeld gebruikmaken van methods voor stochastische optimalisatie, bijvoorbeeld een genetisch algoritme.
Ik stel voor om de werking van zo'n benadering voor het selecteren van de systeemconfiguratie te bekijken, met behulp van een genetisch algoritme, in het volgende zogenaamde: laboratoriumwerk.
Ingangsgegevens:
- Laten we een service-systeem hebben:
oracle xe 18c - Laat het diensten voor transactieactiviteit en het doel: het verkrijgen van een zo hoog mogelijke doorvoer van de database bij transacties per seconde.
- Transacties kunnen sterk variëren, afhankelijk van hun aard in de omgang met gegevens en de context.
Laten we afspreken dat dit transacties zijn die geen grote hoeveelheid tabelgegevens verwerken.
In die zin dat ze niet meer undo-gegevens genereren dan redo-gegevens en geen grote percentage regels in grote tabellen verwerken.
Dit zijn transacties die één regel wijzigen in een meer of minder grote tabel, met een klein aantal indexen op die tabel.
In dit scenario zal de productiviteit van de database bij de verwerking van transacties, met de nodige kanttekening, bepaald worden door de kwaliteit van de verwerking van redo-gegevens.
De kanttekening — als we het specifiek hebben over database-instellingen.
Omdat er in het algemeen bijvoorbeeld transactievergrendelingen kunnen zijn tussen SQL-sessies, veroorzaakt door het ontwerp van de gebruikersinteractie met tabelgegevens en/of het tabelmodel.
Die natuurlijk een negatieve invloed zal hebben op de tps-metriek en dit een exogene factor voor de database is: het ontwerp van het tabelmodel en de manier van werken met gegevens leidt tot vergrendelingen.
Daarom, om de experimenten puur te houden, zullen we deze factor uitsluiten; ik zal hieronder verduidelijken hoe precies.
- Laten we aannemen, voor de duidelijkheid, dat 100% van de SQL-commando's die aan de database worden gegeven: DML-commando's zijn.
Laat de kenmerken van de gebruikersinteractie met de database hetzelfde zijn in de tests.
Namelijk: het aantal SQL-sessies, tabelgegevens, hoe de SQL-sessies daarmee omgaan. - De database werkt in
FORCE LOGGING,ARCHIVELOGmodi. Flashback-database modus is uitgeschakeld, op database-niveau. - Redo-logs: bevinden zich in een apart bestandssysteem, op een aparte "schijf";
De rest van de fysieke component van de database: in een ander, apart bestandssysteem, op een aparte "schijf":
Meer details over de fysieke component van de laboratoriumdatabase
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Oorspronkelijk wilde ik onder deze belastingstoestand de database gebruiken voor transacties.
Het heeft een geweldige eigenschap, ik citeer de auteur:
In het hart van SLOB ligt de "SLOB-methode." De SLOB-methode heeft als doel om platformen te testen
zonder applicatieconcurrentie. Men kan de maximale hardwareprestaties niet behalen
met applicatiecode die bijvoorbeeld gebonden is aan applicatievergrendeling of zelfs
het delen van Oracle Database-blokken. Dat klopt - er zijn overheadkosten bij het delen van gegevens
in datablocks! Maar SLOB - in de standaardimplementatie - is immuun voor dergelijke concurrentie.
Deze verklaring: is correct en zo is het.
Het is handig om de mate van parallelisme van de SLOB-sessies te reguleren, dat is de sleutel -t tot de lancering van het hulpprogramma runit.sh uit de SLOB-samenstelling
Het percentage DML-opdrachten wordt geregeld, in dat aantal SQL's dat iedere SQL-sessie naar de database stuurt, parameter UPDATE_PCT
Apart en erg handig: SLOB zelf, vóór en na de belastingssessie - bereidt statspack of AWR-snapshots voor (wat is ingesteld om te prepareren).
Echter, het bleek dat SLOB SQL-sessies met een duur van minder dan 30 seconden niet worden ondersteund.
Daarom heb ik eerst mijn eigen, huis-tuin-en-keukenvariant van een belastinggenerator geprogrammeerd, en vervolgens bleef het in gebruik.
Ik zal verduidelijken wat de belastinggenerator doet en hoe, voor de duidelijkheid.
De belastinggenerator ziet er in wezen zo uit:
Worker-code
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Workers worden op deze manier gestart:
Start van de workers
echo "start test, duur: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "wachten..." >> "$v_logfile"
wait
De tabellen voor werkers worden als volgt voorbereid:
Tabellen aanmaken
function createtable() {
source "/home/oracle/testingredotracе/config.conf"
$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
/

create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Dat wil zeggen, voor elke werker (praktisch: een aparte SQL-sessie in de database) wordt een aparte tabel aangemaakt waarmee de werker werkt.
Hierdoor zijn er geen transactieblokkades tussen de SQL-sessies van de werkers.
Elke werker doet hetzelfde met zijn eigen tabel, alle tabellen zijn gelijk.
Alle werkers voeren de taak uit gedurende hetzelfde aantal tijd.
En wel lang genoeg, zodat er bijvoorbeeld zeker een log-switching heeft plaatsgevonden, en dit niet slechts één keer.
Dit heeft uiteraard tot gevolg dat er kosten en effecten ontstaan.
In mijn geval heb ik de duur van de werkzaamheden van de werkers ingesteld op 8 minuten.
Een stuk van het statspack-rapport, met de beschrijving van de database-activiteit onder belasting.
Database    DB Id    Instance     Inst Num  Startup Time   Release     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NO

Host Name             Platform                CPUs Cores Sockets   Memory (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       Snap Id     Snap Time      Sessions Curs/Sess Comment
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Begin Snap:       1630 07-Sep-20 23:12:27       55        .7
  End Snap:       1631 07-Sep-20 23:20:29       62        .6
   Elapsed:       8.03 (mins) Av Act Sess:       8.4
   DB time:      67.31 (mins)      DB CPU:      15.01 (mins)

Cache Sizes            Begin        End
~~~~~~~~~~~       ---------- ----------
    Buffer Cache:     1,392M              Std Block Size:         8K
     Shared Pool:       288M                  Log Buffer:   103,424K

Load Profile              Per Second    Per Transaction    Per Exec    Per Call
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB time(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Redo size:        7,685,765.6              978.4
   Logical reads:           60,447.0                7.7
   Block changes:           47,167.3                6.0
  Physical reads:                8.3                0.0
 Physical writes:              253.4                0.0
      User calls:               42.6                0.0
          Parses:               23.2                0.0
     Hard parses:                1.2                0.0
W/A MB processed:                1.0                0.0
          Logons:                0.5                0.0
        Executes:           15,756.5                2.0
       Rollbacks:                0.0                0.0
    Transactions:            7,855.1
Laten we terugkeren naar de formulering van het labwerk.
We zullen, bij gelijke omstandigheden, de waarden van de volgende parameters van het labdatabasesysteem variëren:
- Grootte van de database-loggroepen. Bereik van waarden: [32, 1024] MB;
- Aantal loggroepen van de database. Bereik van waarden: [2,32];
log_archive_max_processesbereik van waarden: [1,8];commit_loggingtoegestaan twee waarden:batch|immediate;commit_waittoegestaan twee waarden:wait|nowait;log_bufferbereik van waarden: [2,128] MB.log_checkpoint_timeoutbereik van waarden: [60,1200] secondendb_writer_processesbereik van waarden: [1,4]undo_retentionbereik van waarden: [30;300] secondentransactions_per_rollback_segmentbereik van waarden: [1,8]disk_asynch_iotoegestaan twee waarden:true|false;filesystemio_optionsde volgende waarden zijn toegestaan:none|setall|directIO|asynch;db_block_checkingde volgende waarden zijn toegestaan:OFF|LOW|MEDIUM|FULL;db_block_checksumde volgende waarden zijn toegestaan:OFF|TYPICAL|FULL;
Een persoon met ervaring in het beheer van Oracle-databases kan ongetwijfeld nu al zeggen welke waarden moeten worden ingesteld voor de genoemde parameters en hun toegestane waarden, om een hogere productiviteit van het databasesysteem te verkrijgen voor de gegeven toepassing met de gegevens, zoals hierboven aangegeven door de applicatiecode.
Maar.
Het doel van het laboratoriumwerk is te laten zien dat het optimalisatie-algoritme zelf en relatief snel kan worden verduidelijkt.
Voor ons blijft het alleen nog maar om in de documentatie van het configureerbare systeem te kijken, precies zover als nodig is om te achterhalen: welke parameters en in welke bereiken moeten worden aangepast.
En ook: de code te schrijven die de interactie met het configureerbare systeem van het gekozen optimalisatie-algoritme zal realiseren.
Dus, nu over de code.
Boven heb ik het gehad over cran-r, d.w.z.: alle manipulaties met het configureerbare systeem worden gecoördineerd in de vorm van een R-script.
Eigenlijk is de opdracht, analyse, selectie op basis van de waarde van de metriek, de toestandsvectoren van het systeem: dit is het pakket GA ()
In dit geval is het pakket niet zo geschikt, omdat het verwacht dat de vectoren (chromosomen, als we het hebben over het pakket) in de vorm van gehele getallen met een fractie worden opgegeven.
En mijn vector, uit de waarden van de instelparameters: dit zijn 14 grootheden — gehele getallen en stringwaarden.
De probleem kan natuurlijk eenvoudig worden opgelost door bepaalde getallen toe te wijzen aan stringgrootheden.
Dus, uiteindelijk, ziet het belangrijkste deel van het R-script er als volgt uit:
Oproep GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitisme_waarde=1
pmutatie_coef=0.8
pcrossover_coef=0.1
iteraties=50

gam=GA::ga(type="real-valued", fitness=evalueer,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutatie = pmutatie_coef,
maxiter=iteraties,
run=4,
keepBest=T)
cat( "GA-sessie is voltooid" , file=v_logfile, sep="n", append=T)
gam@oplossing
Hier, met behulp van lower en upper attributen van de subroutine ga wordt in feite het zoekgebied gedefinieerd waarbinnen de zoekopdracht naar een vector (of vectoren) wordt uitgevoerd waarvoor de maximale waarde van de fitnessfunctie wordt verkregen.
De ga-subroutine voert de zoektocht uit om de fitnessfunctie te maximaliseren.
Dus, het blijkt dat in dit geval de fitnessfunctie, begrepen als een vector van waarden voor bepaalde parameters van de database, de metriek van de database moet verkrijgen.
D.w.z.: hoeveel transacties per seconde de database verwerkt bij deze configuratie van de database en deze belasting op de database.
Met andere woorden, om uit te breiden, moet binnen de fitnessfunctie een dergelijk meerledig proces worden uitgevoerd:
- Verwerking van de binnenkomende vector van getallen — omzetten naar waarden voor de parameters van de database.
- Poging om het opgegeven aantal redo-groepen van opgegeven grootte te creëren. En deze poging kan mislukken.
Bestaande loggroepen in de database, in een bepaalde hoeveelheid en van een bepaalde grootte, moeten voor de duidelijkheid van het experiment worden verwijderd. - Bij succes van het vorige punt: waarden voor configuratieparameter instellen (nogmaals: er kan een fout optreden).
- Bij succes van het vorige punt: de database stoppen, de database opnieuw starten zodat de opnieuw ingestelde parameterwaarden in werking treden. (nogmaals: er kan een fout optreden).
- Bij succes van het vorige punt: een belastingstest uitvoeren. Verkrijg metrische gegevens van de database.
- Breng de database terug naar de oorspronkelijke staat, d.w.z. verwijder de extra loggroepen, herstel de oorspronkelijke databaseconfiguratie.
Code van de fitnessfunctie
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," probeert vector te evalueren: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups is mislukt",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," kan de db niet opstarten met die vector van instellingen",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," kan de db niet opstarten met die vector van instellingen",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("resultaat: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Dus, al het werk: wordt uitgevoerd in de fitnessfunctie.
ga-subroutine, voert de verwerking van vectoren uit, of beter gezegd — chromosomen.
Waarbij, we het belangrijkste belang hechten aan: selectie van chromosomen met genen waarvoor de fitnessfunctie hoge waarden oplevert.
Dit is in wezen het proces van het zoeken naar de optimale set chromosomen in een N-dimensionale zoekruimte.
Zeer duidelijk, gedetailleerd , met voorbeelden van R-code, werking van het genetisch algoritme.
Ik wil twee technische punten apart benadrukken.
Hulpfuncties, vanuit de functie evaluate, bijvoorbeeld stoppen-starten, toekennen van parameterwaarde aan de DB, worden uitgevoerd op basis van cran-r functie system2
Waarmee: een bepaalde bash-script, of commando, wordt aangeroepen.
Bijvoorbeeld:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Een tweede punt — regel, evaluate functie, waarbij de specifieke waarde van de metriek en de bijbehorende instellingsvector, in het logboekbestand wordt opgeslagen:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Dit is belangrijk, omdat uit deze gegevensarray, aanvullende informatie kan worden verkregen over welke van de componenten van de instellingsvector meer of minder invloed heeft op de waarde van de metriek.
Dat wil zeggen: er kan een attribute-importance analyse worden uitgevoerd.
Dus, wat kan eruit komen.
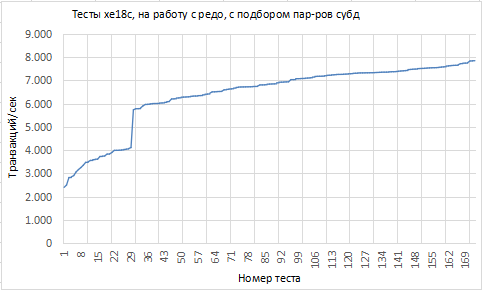
In de vorm van een grafiek, als we de tests sorteren op toenemende metriek, ziet het plaatje er als volgt uit:
Enkele gegevens, die overeenkomen met de uiterste waarden van de metriek:
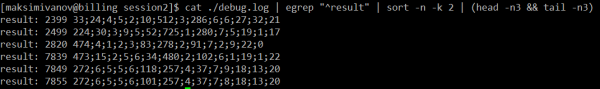
Hier, op de screenshot met resultaten, benadruk ik: de waarden van de instellingsvector — zijn gegeven in de termen van de fitnessfunctiecode, niet in termen van de lijst met parameters/bereik van parameterwaarden, die ik eerder in de tekst heb geformuleerd.
Nou. Is dit veel of weinig, ~8.000 tps: dat is een aparte kwestie.
In het kader van het laboratoriumwerk — is dit cijfer niet van belang, de dynamiek, hoe deze waarde verandert, is belangrijk.
De dynamiek hier is goed.
Het is duidelijk dat, in ieder geval één factor, die significant invloed heeft op de waarde van de metriek, het ga-algoritme, door de vector-chromosomen heen gaat: heeft gedekt.
Gelet op de vrij sterke dynamiek van de curvewaarden, is er tenminste één extra factor die, zij het in mindere mate, invloed heeft.
Hier is een attribute-importance analyse nodig om te begrijpen welke attributen (in dit geval de componenten van de parametervector) en in welke mate invloed hebben op de waarde van de metric.
Aan de hand van deze informatie: begrijpen welke factoren werden beïnvloed door veranderingen in de significante attributen.
Uitvoeren attribute-importance kan op verschillende manieren.
Voor deze doelen vind ik het algoritme randomForest uit de gelijknamige R-pakket (zoals ik begrijp hoe het in het algemeen werkt en zijn aanpak om de belangrijkheid van attributen te beoordelen, bouwt een model van de afhankelijkheid van de responsvariabele van de attributen.)
randomForestIn ons geval is de responsvariabele de metric die wordt verkregen van databasesystemen in belastingstests:
tps En de attributen zijn de componenten van de parametervector.;
beoordeelt de belangrijkheid van elk attribuut van het model met twee getallen:
Dus randomForest %IncMSE — hoe de aanwezigheid/afwezigheid van dit attribuut in het model de MSE-kwaliteit van het model verandert (Mean Squared Error); En IncNodePurity — dit is een getal dat aangeeft hoe goed, op basis van de waarden van dit attribuut, de dataset kan worden verdeeld, zodat aan de ene kant de gegevens met een specifieke waarde van de verklaarde metric komen, en aan de andere kant met een andere waarde van de metric.
Dus: in hoeverre is dit een classificerend attribuut (de meest duidelijke, Nederlandstalige uitleg over random forest die ik heb gezien
Werkende R-code voor het verwerken van de dataset met de resultaten van belastingstests: ).
x=NULL v_data_file=paste('tmp/data1.dat',sep="") x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE) colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7)) idxNotTrain=which(! 1:nrow(x) %in% idxTrain ) TrainDS=x[idxTrain,] ValidateDS=x[idxNotTrain,]library(randomForest) #mtry=as.integer( sqrt(dim(x)[2]-1) ) rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F) ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response") sum((ValidateDS$metric-ValidateDS$predicted)^2) rf$importance
Je kunt de hyperparameters van het algoritme handmatig afstemmen en, rekening houdend met de kwaliteit van het model, het model kiezen dat nauwkeuriger voorspellingen doet op de validatiedataset.Je kunt een functie schrijven voor dit werk (overigens — opnieuw, op basis van een optimalisatie-algoritme).
Je kunt gebruik maken van het R-pakket
caret , dat doet er niet toe., het maakt niet uit.
Uiteindelijk krijgt men in dit geval het volgende resultaat voor de beoordeling van de belangrijkheid van de attributen:
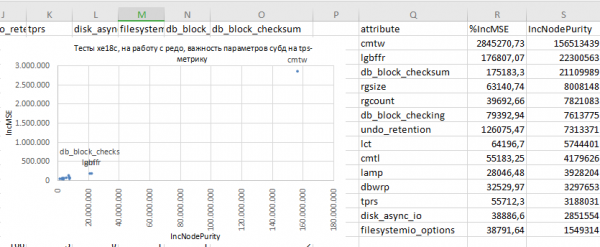
Dus, kunnen we beginnen met globale overpeinzingen:
- Het blijkt dat de meest significante parameter in deze testomstandigheden is:
commit_wait
Technisch gezien stelt deze de uitvoeringsmodus in voor io-operaties voor het schrijven van redo-gegevens vanuit de logbuffer van de database naar de huidige loggroep: synchronisch of asynchronisch.
Waardenowaitwaarbij er vrijwel een verticale vermenigvuldiging van de tps-metriekwaarde ontstaat: dit is de inschakeling van de async-modus voor io in de redo-groepen.
Een aparte vraag — moet men dit wel of niet doen in de productie-database. Hier beperkte ik me tot de constatering: dit is een significante factor. - Logisch dat de grootte van de logbuffer van de database een significante factor blijkt te zijn.
Hoe kleiner de grootte van de logbuffer, hoe minder het bufferende vermogen, hoe vaker het vol raakt en/of er geen vrije ruimte kan worden toegewezen voor een nieuwe portie redo-gegevens.
En dat betekent: vertragingen die verbonden zijn aan het toewijzen van ruimte in de logbuffer en/of het doorschrijven van redo-gegevens uit deze buffer naar de redo-groepen.
Deze vertragingen zouden, natuurlijk, invloed moeten hebben en hebben invloed op de doorvoer van de database in termen van transacties. - Parameter
db_block_checksum: nou, dat is ook wel duidelijk — het verwerken van transacties leidt tot de vorming van dirty blocks in de buffercache van de database.
Die, bij ingeschakelde controle van checksums van datablokken, door de database moeten worden verwerkt — deze checksums moeten worden berekend op basis van de inhoud van het datablok en vergeleken met wat in de header van het datablok is geschreven: komt overeen/niet overeen.
Zulke werkzaamheden kunnen de verwerking van gegevens natuurlijk niet versnellen, en dus blijken de parameter en het mechanisme dat deze parameter instelt — van belang.
Daarom biedt de vendor in de documentatie voor deze parameter verschillende mogelijke waarden aan en merkt aan dat — ja, er zal impact zijn, maar, kijk, verschillende waarden, tot 'uit' toe, hebben een verschillende impact, je kunt kiezen.
En dan de globale conclusie.
De aanpak blijkt in het algemeen: heel goed te werken.
Het stelt in staat, in de vroege fasen van belastingstests van een of ander servicesysteem, om de optimale configuratie voor de belasting te kiezen zonder al te diep in de details van het systeem aanpassing voor belasting in te gaan.
Maar het uitsluiten van begrip is niet volledig — op zijn minst moet men weten wat "afstelinstrumenten" zijn en de toegestane draaihoeken van deze instrumenten.
Daarna kan de aanpak relatief snel de optimale configuratie van het systeem vinden.
En na het testen kan men informatie verkrijgen over de aard van de relatie tussen de kwaliteitsmaatstaven van het systeem en de waarden van de instellingen van het systeem.
Dit zou natuurlijk moeten bijdragen aan het ontstaan van dit diepere begrip van het systeem en zijn werking, althans onder deze belasting.
In de praktijk betekent dit: het afwegen van de kosten van het begrijpen van het configureerbare systeem versus de kosten van de voorbereiding van dergelijke tests van het systeem.
Ik wil benadrukken: in deze aanpak is de mate van geschiktheid van de tests van het systeem in de omstandigheden waaronder het zal functioneren in de productie van cruciaal belang.
Dank u voor uw aandacht en tijd.
Bron: habr.com
