

Aan het begin van het werken met Kubernetes wordt vaak vergeten om de resources van containers in te stellen. In deze fase is het voldoende om ervoor te zorgen dat het Docker-image functioneert en uitgerold kan worden in het Kubernetes-cluster.
Later moet de applicatie worden uitgerold in een productiecluster samen met andere applicaties. Hiervoor moeten resources aan de container worden toegewezen en moet worden gecontroleerd of deze voldoende zijn voor het starten en functioneren van de applicatie, zonder dat dit problemen veroorzaakt bij andere draaiende applicaties.
Opdracht heeft het artikel over containerresources (CPU & MEM), aanvragen en resource-beperkingen vertaald. U zult leren welke voordelen deze instellingen bieden en wat er gebeurt als u ze niet instelt.
Rekenkracht
We hebben twee soorten resources met de volgende eenheden:
- Centraal processor (CPU) — cores;
- Geheugen (MEM) — bytes.
Resources worden aangegeven voor elke container. In het volgende YAML-bestand van de Pod ziet u de sectie resources, die de aangevraagde en maximale resources bevat:
- Aangevraagde resources van de Pod = som van de aangevraagde resources van alle containers;
- Maximale resources van de Pod = som van de maximale resources van alle containers.
apiVersion: v1
kind: Pod
metadata:
  name: backend-pod-name
  labels:
    application: backend
spec:
  containers:
    - name: main-container
      image: my-backend
      tag: v1
      ports:
      - containerPort: 8080
      resources:
        requests:
          cpu: 0.2 # AANGEVRAAGDE CPU: 200m cores
          memory: "1Gi" # AANGEVRAAGDE MEM: 1Gi
        limits:
          cpu: 1 # MAX CPU GEBRUIK: 1 core
          memory: "1Gi" # MAX MEM GEBRUIK:  1Gi
    - name: other-container
      image: other-app
      tag: v1
      ports:
      - containerPort: 8000
      resources:
        requests:
          cpu: "200m" # AANGEVRAAGDE CPU: 200m cores
          memory: "0.5Gi" # AANGEVRAAGDE MEM: 0.5Gi
        limits:
          cpu: 1 # MAX CPU GEBRUIK: 1 core
          memory: "1Gi" # MAX MEM GEBRUIK:  1Gi
Voorbeeld van aangevraagde en maximale resources
Veld resources.requested uit de specificatie van de Pod — een van de elementen die worden gebruikt om de juiste node te vinden. Hierop kan de uitrol van de Pod worden gepland. Hoe vindt men de geschikte node?
Kubernetes bestaat uit verschillende componenten, waaronder een hoofd node of master-node (Kubernetes Control Plane). In de master-node draaien verschillende processen: kube-apiserver, kube-controller-manager en kube-scheduler.
Het kube-scheduler proces is verantwoordelijk voor het bekijken van nieuw gemaakte modules en het zoeken naar mogelijke werk-nodes die voldoen aan alle aanvragen van de modules, inclusief het aantal aangevraagde resources. De lijst van nodes die door kube-scheduler zijn gevonden, wordt gerangschikt. De Pod wordt gepland op de node met de hoogste score.
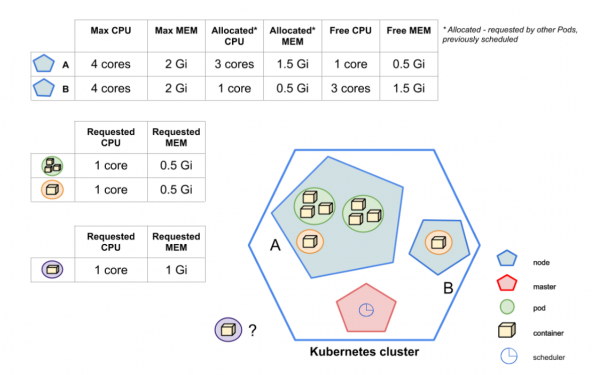 Waar wordt de paarse Pod geplaatst?
Op de afbeelding is te zien dat de kube-scheduler een nieuwe paarse Pod moet inplannen. De Kubernetes-cluster bevat twee knooppunten: A en B. Zoals te zien is, kan de kube-scheduler de Pod niet op knooppunt A inplannen - de beschikbare (niet aangevraagde) middelen komen niet overeen met de vereisten van de paarse Pod. De door de paarse Pod aangevraagde 1 GB geheugen past niet op knooppunt A, omdat er slechts 0,5 GB beschikbaar is. Maar knooppunt B heeft voldoende middelen. Uiteindelijk besluit de kube-scheduler dat de bestemming van de paarse Pod knooppunt B is.
Nu weten we hoe de aangevraagde middelen van invloed zijn op de keuze van een knooppunt voor het starten van een Pod. Maar hoe zijn de limieten van invloed?
Limieten van middelen zijn de grenzen die CPU/MEM niet mogen overschrijden. Echter, CPU-middelen zijn flexibel, dus containers die de limiet van CPU bereiken, zullen niet leiden tot het afsluiten van de Pod. In plaats daarvan vindt er CPU-throttling plaats. Als de limiet voor het gebruik van MEM wordt bereikt, wordt de container gestopt door OOM-Killer en opnieuw opgestart als dit is toegestaan door de RestartPolicy-instelling.
Aangevraagde en limietmiddelen in detail
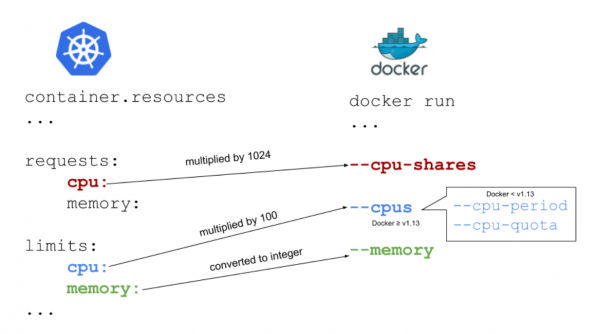 De relatie tussen middelen in Docker en Kubernetes
De beste manier om uit te leggen hoe aangevraagde en limieten middelen werken, is door de relatie tussen Kubernetes en Docker voor te stellen. In de afbeelding hierboven kun je zien hoe de velden van Kubernetes en de opstartvlaggen van Docker met elkaar verbonden zijn.
Geheugen: aanvraag en limiet
containers:
...
 resources:
   requests:
     memory: "0.5Gi"
   limits:
     memory: "1Gi"
Zoals hierboven vermeld, wordt geheugen gemeten in bytes. Gebaseerd op , kunnen we geheugen opgeven als een getal. Gewoonlijk is het een geheel getal, zoals 2678 – dat is 2678 bytes. Je kunt ook suffixen gebruiken G en Gi, belangrijk is om te onthouden dat ze niet gelijkwaardig zijn. De eerste is decimaal, de tweede is binair. Bijvoorbeeld, genoemd in de k8s-documentatie: 128974848, 129e6, 129M, 123Mi – ze zijn praktisch gelijkwaardig.
De Kubernetes-parameter limits.memory komt overeen met de vlag --memory uit Docker. In het geval van request.memory is de pijl voor Docker niet aanwezig, omdat Docker dit veld niet gebruikt. Je zou je kunnen afvragen of dit überhaupt nodig is? Ja, dat is het. Zoals ik al zei, het veld is belangrijk voor Kubernetes. Op basis van de informatie hierin beslist de kube-scheduler op welk knooppunt de Pod moet worden ingepland.
Wat gebeurt er als je niet genoeg geheugen voor de aanvraag instelt?
Als de container de grenzen van het aangevraagde geheugen bereikt, wordt de Pod in een groep Pods geplaatst die worden gestopt bij gebrek aan geheugen op het knooppunt.
Wat gebeurt er als ik een te lage geheugengrens instel?
Als de container de geheugengrens overschrijdt, wordt deze beëindigd wegens OOM-Killed. En deze zal opnieuw worden opgestart, indien mogelijk op basis van RestartPolicy, waarbij de standaardwaarde is - Altijd.
Wat gebeurt er als er geen gevraagde geheugenwaarde wordt opgegeven?
Kubernetes neemt de geheugengrens en stelt deze in als standaardwaarde.
Wat kan er gebeuren als de geheugengrens niet wordt opgegeven?
De container heeft geen beperkingen, hij kan zoveel geheugen gebruiken als hij wil. Als hij echter alle beschikbare geheugen op de node begint te gebruiken, wordt hij door OOM beëindigd. Daarna zal de container opnieuw worden opgestart, indien mogelijk op basis van de RestartPolicy.
Wat gebeurt er als er geen geheugenlimieten worden opgegeven?
Dit is het slechtste scenario: de planner weet niet hoeveel middelen de container nodig heeft, en dit kan ernstige problemen op de node veroorzaken. In dit geval is het goed om standaardlimieten in de namespace te hebben (geconfigureerd met LimitRange). Er zijn geen standaardlimieten - de Pod heeft geen beperkingen, hij kan zoveel geheugen gebruiken als hij wil.
Als het gevraagde geheugen groter is dan de node kan bieden, zal de Pod niet worden gepland. Het is belangrijk om te onthouden dat Requests.memory geen minimumwaarde is. Dit beschrijft de hoeveelheid geheugen die nodig is voor een continue werking van de container.
Over het algemeen wordt aanbevolen om dezelfde waarde in te stellen voor request.memory en limit.memory. Hierdoor zal Kubernetes de Pod niet plannen op een node die voldoende geheugen heeft om de Pod te draaien, maar niet genoeg om deze daadwerkelijk te kunnen uitvoeren. Houd in gedachten: bij het plannen van de Pod houdt Kubernetes alleen rekening met requests.memory, met behulp van 1 bit, gelijk aan 0, limits.memory wordt niet meegerekend.
CPU: verzoek en limiet
containers:
...
 resources:
   requests:
     cpu: 1
   limits:
     cpu: "1200m"
Met CPU is het iets complexer. Terugkijkend naar de afbeelding van de relatie tussen Kubernetes en Docker, kan men opmerken dat request.cpu overeenkomt met --cpu-shares, terwijl limit.cpu komt overeen met de vlag cpus in Docker.
De CPU die Kubernetes aanvraagt, wordt vermenigvuldigd met 1024 - de verhouding van CPU-cycli. Als je 1 volledige kern wilt aanvragen, moet je toevoegen cpu: 1, zoals hierboven getoond.
Een verzoek om een volledige kern (verhouding = 1024) betekent niet dat uw container deze zal krijgen. Als uw hostcomputer slechts één kern heeft en u meer dan één container gebruikt, moeten alle containers de beschikbare CPU gezamenlijk gebruiken. Hoe gebeurt dit? Laten we naar de afbeelding kijken.
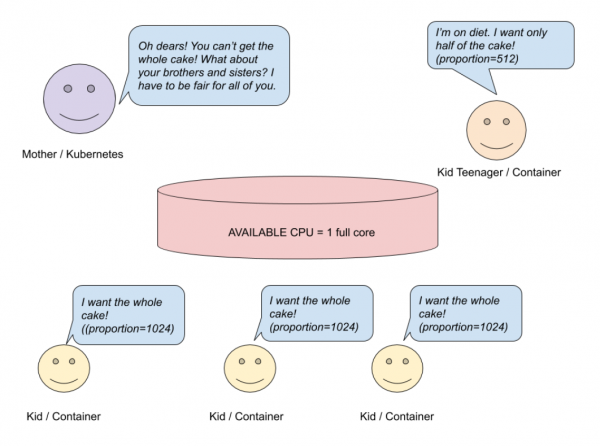
CPU-aanroep - systeem met één kern
Stel je voor dat je een host-systeem hebt met één kern waarop containers draaien. Moeder (Kubernetes) heeft een taart (CPU) gebakken en wil deze delen tussen de kinderen (containers). Drie kinderen willen elk een hele taart (verhouding = 1024), terwijl een ander kind de helft van de taart wil (512). Moeder wil eerlijk zijn en maakt een eenvoudige berekening.
# Сколько пирогов хотят дети?
# 3 ребенка хотят по целому пирогу и еще один хочет половину пирога
cakesNumberKidsWant = (3 * 1) + (1 * 0.5) = 3.5
# Выражение получается так:
3 (ребенка/контейнера) * 1 (целый пирог/полное ядро) + 1 (ребенок/контейнер) * 0.5 (половина пирога/половина ядра)
# Сколько пирогов испечено?
availableCakesNumber = 1
# Сколько пирога (максимально) дети реально могут получить?
newMaxRequest = 1 / 3.5 =~ 28%
Op basis van de berekening krijgen de drie kinderen elk 28% van de kern, en niet de hele kern. Het vierde kind krijgt 14% van de volledige kern en niet de helft. Maar het zal anders zijn als je een meerkernig systeem hebt.
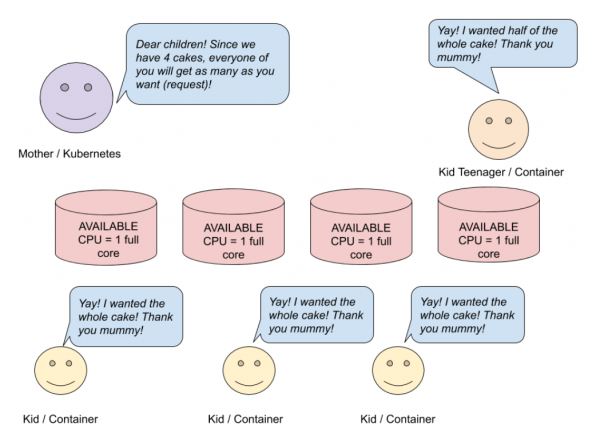
CPU-aanroep - meerkernig (4) systeem
In de afbeelding hierboven kunnen we zien dat drie kinderen een hele taart willen en één de helft. Aangezien moeder vier taarten heeft gebakken, krijgt elk van haar kinderen zoveel als ze willen. In een meerkernig systeem zijn de processorresources verdeeld over alle beschikbare kernen. Als de container is beperkt tot minder dan één volledige CPU-kern, kan deze nog steeds 100% ervan gebruiken.
De bovenstaande berekeningen zijn vereenvoudigd om te begrijpen hoe CPU wordt verdeeld tussen containers. Natuurlijk zijn er naast de containers ook andere processen die CPU-resources gebruiken. Wanneer processen in één container inactief zijn, kunnen andere zijn resources gebruiken. CPU: "200m" overeenkomt met CPU: 0,2, wat ongeveer 20% van één kern betekent.
Laten we nu praten over limit.cpu. De CPU die Kubernetes beperkt, wordt vermenigvuldigd met 100. Het resultaat is de hoeveelheid tijd die de container elke 100 µs kan gebruiken (cpu-period).
limit.cpu komt overeen met de Docker-vlag --cpus. Dit is een nieuwe combinatie van oude --cpu-period en --cpu-quota. Door deze in te stellen, geven we aan hoeveel beschikbare CPU-resources de container maximaal kan gebruiken voordat throttling begint:
- cpus — combinatie
cpu-periodencpu-quota. cpus = 1.5is gelijk aan het instellen vancpu-period = 100000encpu-quota = 150000; - cpu-period — periode , standaard 100 microseconden;
- cpu-quota — het aantal microseconden binnen
cpu-period, waarmee de container is beperkt.
Wat gebeurt er als je te weinig gevraagde CPU instelt?
Als de container meer nodig heeft dan is ingesteld, zal het CPU van andere processen afpakken.
Wat gebeurt er als je een onvoldoende CPU-limiet instelt?
Omdat CPU een regelbare hulpbron is, zal throttling in werking treden.
Wat gebeurt er als je geen CPU-aanroep opgeeft?
Net als bij geheugen geldt dat de aanvraag gelijk is aan de limiet.
Wat gebeurt er als je geen CPU-limiet opgeeft?
De container zal zoveel CPU gebruiken als het nodig heeft. Als in de naamruimte een standaard CPU-beleid (LimitRange) is gedefinieerd, wordt deze limiet ook voor de container gebruikt.
Wat gebeurt er als er noch een aanvraag, noch een limiet voor de CPU wordt opgegeven?
Net als bij geheugen is dit het slechtste scenario. De scheduler weet niet hoeveel middelen je container nodig heeft, wat ernstige problemen op de node kan veroorzaken. Om dit te voorkomen, moeten er standaardlimieten voor naamruimten (LimitRange) worden ingesteld.
Vergeet niet: als je meer CPU aanvraagt dan de nodes kunnen bieden, zal de Pod niet worden gepland. Requests.cpu — dit is geen minimumwaarde, maar een waarde die voldoende is om de Pod te starten en zonder uitval te laten functioneren. Als de applicatie geen complexe berekeningen uitvoert, is het beste om request.cpu <= 1 en zoveel replica's te draaien als nodig is.
De ideale hoeveelheid gevraagde of gelimiteerde middelen
We hebben geleerd over het beperken van rekenkundige middelen. Nu is het tijd om de vraag te beantwoorden: "Hoeveel middelen heeft mijn Pod nodig om de applicatie zonder problemen uit te voeren? Wat is de ideale hoeveelheid?".
Helaas zijn er geen eenduidige antwoorden op deze vragen. Als je niet weet hoe je applicatie werkt, hoeveel CPU of geheugen het nodig heeft, is het beste om de applicatie veel geheugen en CPU te geven en vervolgens prestatietests uit te voeren.
Naast prestatietests, let een week lang op het gedrag van de applicatie in de monitoring. Als uit de grafieken blijkt dat je applicatie minder middelen verbruikt dan je hebt aangevraagd, kun je de hoeveelheid gevraagde CPU of geheugen verlagen.
Ter illustratie, kijk naar dit . Het toont het verschil tussen de gevraagde middelen of de limiet van middelen en het huidige gebruik van middelen.
Conclusie
Resource requests and limits help maintain the functioning of a Kubernetes cluster. Properly configuring limits minimizes costs and keeps applications running consistently.
In short, keep several points in mind:
- Requested resources are the configuration considered during startup (when Kubernetes plans the placement of the application). In contrast, resource limits are crucial during operation—when the application is already running on a node.
- Compared to memory, CPU is a manageable resource. In case of CPU shortage, your Pod will not terminate; throttling will kick in.
- Requested resources and resource limits are not minimum and maximum values! By defining requested resources, you ensure that the application will run smoothly.
- A good practice is to set the memory request equal to the memory limit.
- It's good to set the requested
CPU <=1, if the application does not perform complex calculations. - If you request more resources than are available on the node, the Pod will never be scheduled on that node.
- To determine the correct amount of requested resources/limits, use load testing and monitoring.
I hope this article helps you understand the core concept of resource limits. And you can apply this knowledge in your work.
Veel succes!
Wat verder te lezen:
- .
- .
- .
Bron: habr.com
