

U kunt de opslag van applicatiedata die draait in de Kubernetes-cluster op verschillende manieren configureren. Sommige daarvan zijn verouderd, terwijl andere pas recent zijn geïntroduceerd. In dit artikel bekijken we het concept van drie opties voor het verbinden van opslagsystemen, waaronder de nieuwste optie - verbinding via de Container Storage Interface.
Methode 1. Het opgeven van PV in de podmanifest
Een typisch manifest dat een pod in de Kubernetes-cluster beschrijft:
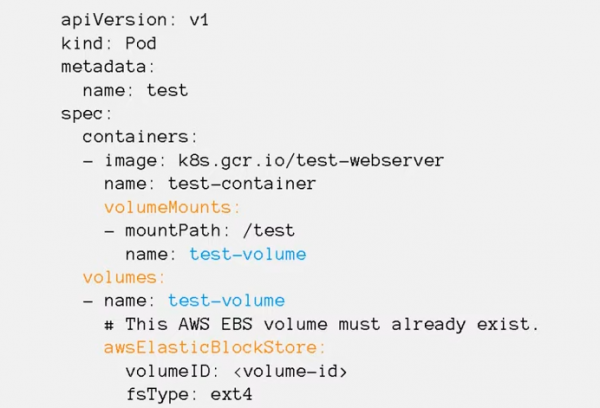
Met kleur zijn de delen van het manifest gemarkeerd waar is beschreven welke schijf wordt aangesloten en waar.
In de sectie volumeMounts geeft de mountpunten (mountPath) aan - in welke map binnen de container de persistente schijf wordt gemonteerd, evenals de naam van de schijf.
In de sectie x vermeldt alle schijven die in de pod worden gebruikt. Ze geven de naam van elke schijf, evenals het type (in ons geval: awsElasticBlockStore) en verbindingsparameters aan. Welke parameters in het manifest worden vermeld, hangt af van het type schijf.
Dezelfde schijf kan tegelijkertijd in meerdere containers van de pod worden gemonteerd. Hierdoor hebben verschillende processen van de applicatie toegang tot dezelfde gegevens.
Deze verbindingsmethode werd bedacht in de beginperiode van Kubernetes, toen het net was opgekomen, en is inmiddels verouderd.
Bij het gebruik ervan ontstaan er verschillende problemen:
- alle schijven moeten handmatig worden aangemaakt, Kubernetes kan niets voor ons aanmaken;
- de toegangparameters voor elke schijf zijn uniek en moeten in de manifesten van alle pods die de schijf gebruiken worden opgegeven;
- om het opslagsysteem te wijzigen (bijvoorbeeld van AWS naar Google Cloud) moeten de instellingen en het type van de aangesloten schijven in alle manifesten worden gewijzigd.
Dit alles is erg ongemakkelijk, daarom wordt deze methode in de praktijk alleen gebruikt voor het aansluiten van enkele speciale soorten schijven: configMap, secret, emptyDir, hostPath:
configMap en secret - speciale schijven die het mogelijk maken om in de container een schijf te maken met bestanden uit de Kubernetes-manifesten.
emptyDir - tijdelijke schijf, wordt alleen aangemaakt voor de levensduur van de pod. Handig voor testing of het opslaan van tijdelijke gegevens. Wanneer de pod wordt verwijderd, wordt ook de emptyDir-schijf verwijderd en gaan alle gegevens verloren.
hostPath — stelt in staat om elke map van de lokale schijf van de server waarin de applicatie draait, inclusief /etc/kubernetes, in de container met de applicatie te monteren. Dit is een onveilige mogelijkheid, daarom verbieden beveiligingsbeleid meestal het gebruik van dit type volumes. Anders kan een aanvaller zijn eigen container met de map van HTC Kubernetes monteren en alle certificaten van de cluster stelen. Over het algemeen is het gebruik van hostPath-volumes alleen toegestaan voor systeemtoepassingen die draaien in de kube-system namespace.
worden in de documentatie weergegeven.
Methode 2. Verbinding met pods SC/PVC/PV
Een alternatieve verbindingsmethode is het concept van Storage class, PersistentVolumeClaim, PersistentVolume.
Storage class bevat de verbindingsparameters naar het opslagsysteem.
PersistentVolumeClaim beschrijft de vereisten voor het volume dat de applicatie nodig heeft.
PersistentVolume bevat de toegang parameters en status van het volume.
De kern van het idee: in de manifest van de pod wordt een volume van het type PersistentVolumeClaim aangegeven en wordt de naam van deze entiteit in de parameter claimName opgegeven.
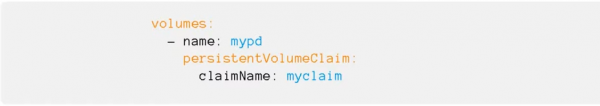
In de manifest van PersistentVolumeClaim worden de vereisten voor de gegevensvolume die de applicatie nodig heeft beschreven. Inclusief:
- de schijfgrootte;
- toegangsmodus: ReadWriteOnce of ReadWriteMany;
- verwijzing naar de Storage class — in welk opslagsysteem we het volume willen aanmaken.
In de manifest van Storage class worden het type en de verbindingsparameters naar het opslagsysteem opgeslagen. Deze zijn nodig voor de kubelet om het volume aan zijn knoop te monteren.
In de manifests van PersistentVolume wordt de Storage class en de toegang parameters voor een specifiek volume (volume-ID, pad, enz.) opgegeven.
Bij het aanmaken van PVC kijkt Kubernetes naar welk volume van welke grootte en uit welke Storage class vereist is, en selecteert het een beschikbare PersistentVolume.
Als er geen PV's beschikbaar zijn, kan Kubernetes een speciaal programma starten — Provisioner (de naam wordt in de Storage class opgegeven). Dit programma maakt verbinding met de opslagoplossing, creëert een volume van de vereiste grootte, verkrijgt een identificator en maakt in de Kubernetes-cluster een manifest PersistentVolume aan dat verband houdt met de PersistentVolumeClaim.
Al deze abstracties maken het mogelijk om de informatie over met welk opslagsysteem de applicatie werkt, van het niveau van de applicatiemanifesten naar het administratieniveau te verplaatsen.
Alle verbindingsparameters voor het opslagnetwerk bevinden zich in de Storage class, waarvoor de clusterbeheerders verantwoordelijk zijn. Het enige wat je hoeft te doen bij de overgang van AWS naar Google Cloud, is de naam van de Storage class in de PVC-manifesten te wijzigen. Persistente Volume voor gegevensopslag worden automatisch in de cluster aangemaakt met behulp van de Provisioner-software.
Methode 3. Container Storage Interface
Alle code die interactie heeft met verschillende opslagsystemen, maakt deel uit van de Kubernetes-kern. De uitgave van bugfixes of nieuwe functionaliteit is gekoppeld aan nieuwe versies, wat betekent dat de code aangepast moet worden voor alle ondersteunde versies van Kubernetes. Dit is moeilijk te onderhouden en om nieuwe functionaliteit toe te voegen.
Om het probleem op te lossen, hebben ontwikkelaars van Cloud Foundry, Kubernetes, Mesos en Docker de Container Storage Interface (CSI) gecreëerd — een eenvoudige, gestandaardiseerde interface die de interactie beschrijft tussen het containerbeheersysteem en een specifieke driver (CSI Driver) die werkt met een specifiek opslagsysteem. Alle code die interactie heeft met het opslagsysteem is uit de Kubernetes-kern gehaald en in een apart systeem geplaatst.
.
Over het algemeen bestaat de CSI Driver uit twee componenten: Node Plugin en Controller Plugin.
De Node Plugin draait op elke node en is verantwoordelijk voor het koppelen van volumes en het uitvoeren van bewerkingen daarop. De Controller Plugin communiceert met het opslagsysteem: creëert of verwijdert volumes, wijst toegangsrechten toe, enzovoort.
Hoewel de oude drivers in de Kubernetes-kern blijven, wordt het gebruik ervan niet langer aanbevolen en wordt iedereen aangeraden om de CSI Driver specifiek voor het systeem te installeren waarmee ze willen werken.
Deze innovatie kan mensen die gewend zijn om opslag via de Storage class in te stellen, angst aanjagen, maar in werkelijkheid is er niets ernstigs gebeurd. Voor programmeurs verandert er niet veel — ze blijven gewoon werken met de naam Storage class. Voor beheerders is er de installatie van de helm chart bijgevoerd en de structuur van de instellingen is veranderd. Als eerder de instellingen rechtstreeks in de Storage class werden ingevoerd, moeten ze nu eerst in de helm chart worden vastgesteld en daarna pas in de Storage class. Als je het goed bekijkt, is er niets ernstigs gebeurd.
Laten we als voorbeeld bekijken welke voordelen je kunt behalen door over te schakelen naar de aansluiting van het Ceph-opslagsysteem met behulp van de CSI-driver.
Bij het werken met Ceph biedt de CSI-plugin meer mogelijkheden voor interactie met het opslagsysteem dan de ingebouwde drivers.
- Dynamische schijfcreatie. Meestal worden RBD-schijven alleen in RWO-modus gebruikt, terwijl CSI voor Ceph het mogelijk maakt om ze in RWX-modus te gebruiken. Meerdere pods op verschillende knooppunten kunnen dezelfde RBD-schijf aan hun knooppunten koppelen en er parallel mee werken. Ter rechtvaardiging, het is niet allemaal zo rooskleurig — deze schijf kan alleen als blokapparaat worden aangesloten, wat betekent dat de applicatie aangepast moet worden om ermee te werken in een modus voor meervoudige toegang.
- Snapshots aanmaken. In een Kubernetes-cluster kan een manifest worden aangemaakt met de eis om een snapshot te maken. De CSI-plug-in zal dit opmerken en een snapshot van de schijf maken. Op basis hiervan kan een back-up of een kopie van de PersistentVolume gemaakt worden.
- Schijfgrootte vergroten op de SAN en PersistentVolume in het Kubernetes-cluster.
- Quota. Ingebouwde CephFS-drivers in Kubernetes ondersteunen geen quota, terwijl de nieuwste CSI-plug-ins met de recente Ceph Nautilus versie quota op CephFS-partities kunnen inschakelen.
- Metrics. De CSI-plug-in kan in Prometheus tal van metrics geven over welke volumes zijn aangesloten, welke interacties er plaatsvinden, enzovoort.
- Topologie bewust. Stelt je in staat om in manifesten aan te geven hoe geografisch verdeeld het cluster is, en voorkomt dat verbindingen worden gemaakt met pods die draaien in Londen met een gegevensopslagsysteem dat zich in Amsterdam bevindt.
Hoe Ceph via CSI aan een Kubernetes-cluster te koppelen, zie . Je kunt je ook inschrijven voor , die op 15 oktober van start gaat.
Auteur van het artikel: Sergey Bondarev, ervaren architect bij Southbridge, Certified Kubernetes Administrator, een van de ontwikkelaars van kubespray.
Een beetje Post Scriptum ter nuttigheid, niet ter reclame...
P.S. Sergey Bondarev verzorgt twee intensieve cursussen: de vernieuwde van 28-30 september en de geavanceerde van 14–16 oktober.
Bron: habr.com
