

Hallo!
Mijn naam is Michail, ik ben de IT-directeur bij het bedrijf “Sportmaster”. Ik wil een verhaal delen over hoe we de uitdagingen tijdens de pandemie hebben overwonnen.
In de eerste dagen van de nieuwe realiteit kwam het gebruikelijke offline winkelmodel van “Sportmaster” stil te liggen, terwijl de druk op ons online kanaal, met name wat betreft leveringen aan klanten, tien keer toenam. In enkele weken hebben we een enorme offline business omgevormd naar online en onze service aangepast aan de behoeften van onze klanten.
Kortom, wat ooit onze secundaire operatie was, werd de belangrijkste business. Het belang van elke online bestelling nam extreem toe. We moesten elke euro behouden die een klant in het bedrijf bracht.
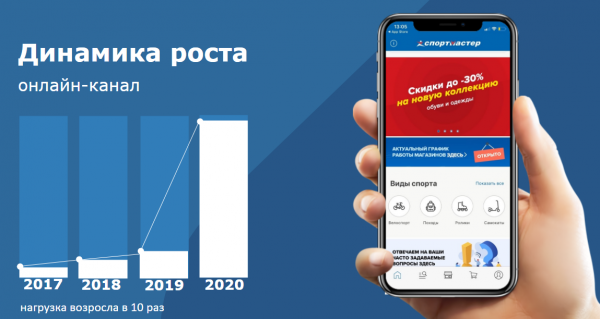
Om snel te reageren op klantverzoeken, hebben we een extra contactcentrum geopend in het hoofdkantoor van het bedrijf, en we kunnen nu ongeveer 285.000 telefoongesprekken per week aannemen. Tegelijkertijd hebben we 270 winkels omgevormd naar een nieuw formaat voor contactloze en veilige werking, wat klanten in staat stelde om hun bestellingen te ontvangen en medewerkers hun banen te behouden.
Tijdens het transformatieproces stuitten we op twee hoofdproblemen. Ten eerste steeg de druk op onze online middelen aanzienlijk (hoe we dit hebben aangepakt, zal Sergey uitleggen). Ten tweede nam de stroom van zeldzame (voor COVID) transacties exponentieel toe, wat op zijn beurt een grote hoeveelheid snelle automatisering vereiste. Om dit probleem op te lossen, moesten we snel middelen overhevelen van gebieden die eerder hoofdzakelijk waren. Hoe we dit hebben opgelost, zal Elena vertellen.
Exploitation van online diensten
Koliesnikov Sergey, verantwoordelijk voor de exploitatie van de webshop en microservices
Vanaf het moment dat onze fysieke winkels werden gesloten voor bezoekers, begonnen we een stijging te registreren in metriek zoals het aantal gebruikers, het aantal bestellingen dat via onze applicatie werd geplaatst, en het aantal verzoeken naar de applicaties.
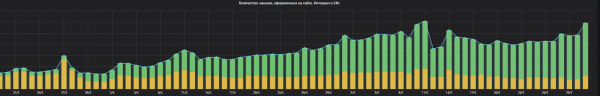 Aantal bestellingen van 18 tot 31 maart
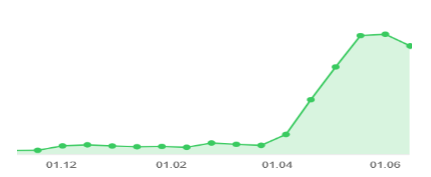 Aantal verzoeken naar de microservices voor online betalingen
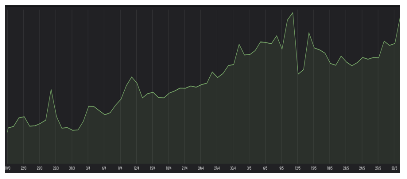 Aantal bestellingen geplaatst op de website
In de eerste grafiek zien we dat de groei ongeveer 14 keer was, en in de tweede 4 keer. We beschouwen de metriek van de responstijd van onze applicaties als de meest sprekende.
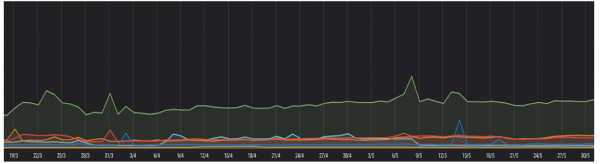
In dit diagram zien we de respons van front- en applicaties, en voor ons hebben we vastgesteld dat we geen significante groei hebben opgemerkt.
Dit komt voornamelijk doordat we eind 2019 zijn begonnen met voorbereidingen. Onze diensten zijn nu gereserveerd, waarbij redundantie is gegarandeerd op het niveau van fysieke servers, virtualisatiesystemen, Docker en de diensten daarin. Daarnaast maken de capaciteit van onze serverbronnen het mogelijk om meerdere belastingen te verwerken.
Het belangrijkste hulpmiddel dat ons heeft geholpen in dit proces, is ons monitorsysteem. Eerlijk gezegd hadden we niet zo lang geleden geen uniform systeem dat het mogelijk maakte om metrics op alle lagen te verzamelen, van de fysieke apparatuur en hardware tot bedrijfsmetrics.
Formeel hadden we monitoring in het bedrijf, maar meestal was dit verspreid en viel het onder de verantwoordelijkheid van specifieke afdelingen. In feite hadden we bijna nooit een gezamenlijk begrip van wat er precies was gebeurd wanneer er een incident plaatsvond, er was geen informatievoorziening, en vaak leidde dit tot een constante zoektocht naar het lokaliseren en oplossen van problemen.
Op een gegeven moment hebben we nagedacht en besloten dat we dit niet langer konden tolereren — we hadden een uniform systeem nodig om het volledige plaatje te zien. De belangrijkste technologieën die in onze stack zitten, zijn Zabbix als het centrum voor waarschuwingen en metric-opslag, Prometheus voor het verzamelen en opslaan van applicatie-metrics, Stack ELK voor logging en gegevensopslag van het volledige monitorsysteem, evenals Grafana voor visualisatie, Swagger, Docker en andere handige en vertrouwde hulpmiddelen.
Daarnaast gebruiken we niet alleen de beschikbare technologieën op de markt, maar ontwikkelen we ook enkele dingen zelf. Bijvoorbeeld, we maken diensten voor de integratie van systemen met elkaar, dat wil zeggen een soort API voor het verzamelen van metrics. Bovendien werken we aan onze eigen monitorsystemen — op het niveau van bedrijfsmetrics gebruiken we UI-tests. We hebben ook een bot in Telegram voor het informeren van teams.
En we proberen ook het monitorsysteem toegankelijk te maken voor teams, zodat ze zelf hun metrics kunnen opslaan en ermee kunnen werken, inclusief het instellen van waarschuwingen voor bepaalde specifieke metrics die niet van brede toepassing zijn.
Binnen het hele systeem streven we naar proactiviteit en de snelste mogelijke lokale incidentoplossing. Bovendien is het aantal van onze microservices en systemen de laatste tijd aanzienlijk toegenomen, wat ook het aantal integraties doet stijgen. In het kader van het optimaliseren van het diagnoseproces op het gebied van integratie ontwikkelen we een systeem dat cross-systemcontrole mogelijk maakt en een resultaat presenteert, waardoor we de belangrijkste problemen met imports en de interactie tussen systemen kunnen identificeren.
Natuurlijk hebben we nog ruimte om te groeien en ons te ontwikkelen op het gebied van systeemoperaties, en we werken daar actief aan. Meer informatie over ons monitoringsysteem is te lezen. .
Technische testen
Sergio Orlov, leidt het competentiecentrum voor web- en mobiele ontwikkeling.
Sinds de sluiting van fysieke winkels zijn we met verschillende uitdagingen geconfronteerd vanuit het perspectief van ontwikkeling. Ten eerste, de sprong in de belasting zelf. Het is duidelijk dat, als er geen passende maatregelen worden genomen, een systeem onder hoge belasting met een trieste klap kan veranderen in een pompoen, of volledig kan degraderen in prestaties, of zelfs zijn functionaliteit kan verliezen.
Het tweede aspect, dat iets minder voor de hand liggend is, is dat het systeem onder hoge belasting zeer snel moest worden aangepast aan de wijzigingen in bedrijfsprocessen. Soms meerdere keren per dag. Veel bedrijven hanteren de regel dat er tijdens grote marketingactiviteiten geen wijzigingen in het systeem mogen worden aangebracht. Helemaal geen, laat het maar werken zoals het werkt.
En wij hadden eigenlijk een eindeloze zwarte vrijdag, waarbij we het systeem moesten aanpassen. En elke fout, probleem of storing in het systeem zou de onderneming enorm veel kosten.
Om vooruit te lopen, kan ik zeggen dat we deze uitdagingen hebben weten te overwinnen; alle systemen hebben de belasting doorstaan, zijn eenvoudig geschaald en we hebben geen grote technische storingen gehad.
Er zijn vier pijlers waarop het vermogen van het systeem om hoge piekbelastingen te weerstaan berust. De eerste hiervan is monitoring, waarover je hierboven al hebt gelezen. Zonder een goed opgezet monitoringsysteem is het vrijwel onmogelijk om knelpunten in het systeem te vinden. Een goed monitoringsysteem is als een huisoutfit; het moet comfortabel en op jou afgestemd zijn.
Het tweede aspect is testen. We nemen dit aspect heel serieus: we schrijven zowel klassieke unit tests, integratietests, belastingstests als vele andere voor elk systeem. Daarnaast schrijven we een teststrategie en proberen we het testniveau zo hoog te krijgen dat handmatige controles niet langer nodig zijn.
De derde pijler is de CI/CD-pijplijn. De processen van builden, testen en implementeren van de applicatie moeten zo veel mogelijk geautomatiseerd zijn; er mogen geen handmatige ingrepen zijn. Het onderwerp CI/CD-pijplijn is behoorlijk diepgaand, en ik zal het slechts kort aanstippen. Het is alleen vermeldenswaard dat we een checklist voor de CI/CD-pijplijn hebben, waaraan elke productteam via competentiecentra werkt.
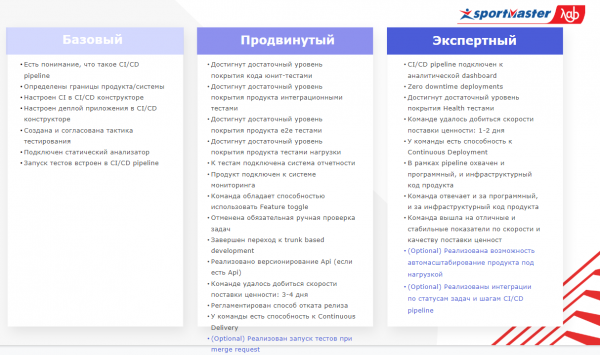 En hier is de checklist
Op deze manier worden veel doelen bereikt. Dit omvat versiebeheer van de API, feature toggles om een kettingreactie van releases te voorkomen, en het bereiken van een testdekking zo hoog dat testen volledig geautomatiseerd is, implementaties naadloos zijn, en meer.
De vierde pijler zijn de architecturale principes en technische oplossingen. Er valt veel te zeggen over architectuur, maar ik wil een paar principes benadrukken waarop ik de nadruk wil leggen.
Ten eerste moet je gespecialiseerde tools kiezen voor specifieke taken. Ja, het klinkt vanzelfsprekend, en het is duidelijk dat je spijkers met een hamer moet slaan en dat je een speciale schroevendraaier voor het demonteren van horloges nodig hebt. Maar in onze tijd proberen veel tools te generaliseren om zoveel mogelijk gebruikerssegmenten te bereiken: databases, caches, frameworks en meer. Neem bijvoorbeeld de database MongoDB, die werkt met multi-documenttransacties, terwijl de Oracle-database met JSON werkt. En het lijkt misschien dat alles voor alles gebruikt kan worden. Maar als we pleiten voor prestaties, moeten we de sterke en zwakke punten van elke tool duidelijk begrijpen en de juiste tools voor onze specifieke taak gebruiken.
Ten tweede moet iedere verhoging van de complexiteit bij het ontwerpen van systemen gerechtvaardigd zijn. We moeten dit constant in gedachten houden, het principe van low coupling is algemeen bekend. Ik geloof dat het op zowel het niveau van specifieke diensten, als op het niveau van het gehele systeem en het architectonische landschap moet worden toegepast. Ook is de mogelijkheid van horizontale schaalbaarheid van elk systeemcomponent onder belasting belangrijk. Als je over deze mogelijkheid beschikt, zal schaalvergroting geen probleem zijn.
Als we het hebben over technische oplossingen, hebben we de productteams gevraagd om een frisse set aanbevelingen, ideeën en oplossingen voor te bereiden die zij hebben geïmplementeerd in de aanloop naar de volgende golf van belasting.
Caches
Het is belangrijk om bewust om te gaan met de keuze tussen lokale en gedistribueerde caches. Soms is het zinvol om beide types binnen één systeem te gebruiken. Bijvoorbeeld, we hebben systemen waarin een deel van de data in wezen een vitrinedatabase is, wat betekent dat de bron van updates zich buiten het systeem bevindt en dat het systeem deze data niet wijzigt. Voor deze aanpak gebruiken we de lokale Caffeine Cache.
Er zijn ook data die het systeem actief wijzigt tijdens de werking, en in dit geval gebruiken we een gedistribueerde cache met Hazelcast. Deze aanpak stelt ons in staat de voordelen van een gedistribueerde cache te benutten waar dat echt nodig is, en de operationele kosten voor het circuleren van data in de Hazelcast-cluster te minimaliseren waar dat mogelijk is. We hebben veel over caches geschreven. en .
Bovendien heeft de overgang naar de Kryo-serialisator in Hazelcast ons een behoorlijke winst opgeleverd. De overstap van ReplicatedMap naar IMap + Near Cache in Hazelcast heeft ons geholpen om de databeweging binnen het cluster te minimaliseren.
Een kleine tip: bij massale invalidatie van de cache kan het soms handig zijn om een tweede cache voor te verwarmen, waarna je vervolgens naar die cache overschakelt. Het lijkt misschien dat we met deze aanpak dubbele geheugengebruik zouden krijgen, maar in de praktijk, in systemen waar dit is toegepast, nam het geheugengebruik af.
Reactieve stack
We gebruiken de reactieve stack al in een behoorlijk aantal systemen. In ons geval is dat Webflux of Kotlin met coroutines. De reactieve stack werkt bijzonder goed in situaties waar we trage input-output operaties verwachten. Bijvoorbeeld, bij het aanroepen van trage services, het werken met het bestandssysteem of opslagsystemen.
Het belangrijkste principe is om blokkering oproepen te vermijden. Onder de motorkap draaien er een klein aantal actieve service-threads in reactieve frameworks. Als we onoplettend een directe blokkering oproep doen, zoals een aanroep naar een JDBC-driver, dan zal het systeem gewoon stoppen.
Probeer fouten om te zetten in eigen runtime exceptions. De echte uitvoeringsstroom van het programma schakelt over naar reactieve frameworks, waardoor de uitvoering van de code niet-lineair wordt. Dit maakt het moeilijk om problemen te diagnosticeren op basis van stack traces. Een oplossing is hier het creëren van begrijpelijke, objectieve runtime exceptions voor elke fout.
Elasticsearch
Bij het gebruik van Elasticsearch is het belangrijk om ongebruikte data niet te selecteren. Dit is in principe ook een heel eenvoudige tip, maar vaak wordt dit vergeten. Als je meer dan 10.000 records in één keer moet selecteren, gebruik dan Scroll. Vergelijk het met een cursor in een relationele database.
Gebruik geen postfilter tenzij het nodig is. Bij grote datasets in de primaire selectie belast deze operatie de database enorm.
Gebruik bulk-operaties waar mogelijk.
API
Bij het ontwerpen van API's moet je vereisten opnemen voor het minimaliseren van de over te dragen data. Dit is vooral relevant in combinatie met de front-end: precies op dat raakvlak gaan we buiten de kanalen van onze datacenters en werken we al op de lijn die ons met de klant verbindt. Als er op die lijn de kleinste problemen zijn, veroorzaakt te veel verkeer een negatieve gebruikerservaring.
En tot slot, dump niet alle gegevens; benader het contract tussen consumenten en leveranciers doelgericht.
Organisatorische transformatie
Yelena Eroshkina, plaatsvervangend directeur IT
Op het moment dat de lockdown begon en het noodzakelijk werd om de groei van online diensten en de implementatie van omnichannel-services snel te versnellen, waren we al bezig met een organisatorische transformatie.
Een deel van onze structuur is overgestapt op werken volgens de principes en praktijken van een productgerichte aanpak. Teams zijn gevormd die nu verantwoordelijk zijn voor de werking en ontwikkeling van elk product. Werknemers in dergelijke teams zijn voor 100% betrokken en organiseren hun werk volgens scrum of kanban, afhankelijk van wat voor hen het meest geschikt is, en optimaliseren de implementatieprocessen, voeren technische praktijken en kwaliteitsborging in en nog veel meer.
Gelukkig bevond het grootste deel van dergelijke productteams zich bij ons al op het gebied van online en omnichannel-services. Dit stelde ons in staat om binnen zeer korte tijd (echt, letterlijk binnen twee dagen) over te stappen op thuiswerken zonder verlies van efficiëntie. Het ingerichte proces stelde ons in staat om snel aan te passen aan de nieuwe werkomstandigheden en een behoorlijk hoge snelheid van levering van nieuwe functionaliteit vast te houden.
Bovendien ontstond de noodzaak om de teams te versterken die zich aan de frontlinie van de online business bevinden. In dat moment werd duidelijk dat we dit alleen konden doen met interne middelen. Ongeveer 50 mensen veranderden binnen twee weken van werkgebied en sloten zich aan bij de ontwikkeling van een nieuw product voor hen.
Hiervoor waren geen bijzondere managementinspanningen nodig, omdat we parallel met de organisatie van onze eigen processen, de technische verfijning van het product en de kwaliteitsborging, onze teams leren zelforganiserend te zijn — hun eigen productieproces te beheren zonder administratieve hulp.
We were able to focus our management resources precisely where it was necessary at that moment—on coordinating with the business: What is currently important for our client, what functionality should be implemented first, and what needs to be done to increase our delivery and order processing capacity. All of this, along with a clear role model, allowed us to load our value creation processes with what is truly important and needed during this period.
Clearly, with remote work and the rapid pace of change, when the participation of each individual affects business metrics, one cannot rely solely on internal feelings like "Is everything going well? It seems fine." Objective metrics of the production process are necessary. We have these metrics; they are available to anyone interested in the metrics of product teams. Primarily for the team itself, the business, stakeholders, and management.
Every two weeks, a status meeting with each team is held, where for 10 minutes, metrics are analyzed, bottlenecks in the production process are identified, and a joint solution is developed: what can be done to eliminate these bottlenecks. Here, team members can also immediately ask for help from management if any identified issue lies outside the team's influence or from colleagues who may have faced similar problems.
Nevertheless, we understand that to accelerate multiple times (which is precisely our goal), we still have much to learn and implement in our daily work. Right now, we are continuing to scale the product approach to other teams and new products. For this, we had to master a new format of online methodological school.
Methodologists, the people who help teams build processes, establish communications, and improve work efficiency, essentially act as change agents. Right now, graduates from our first cohort are working with teams and helping them become successful.
Ik denk dat de huidige situatie ons mogelijkheden en perspectieven biedt waarvan we ons misschien nog niet volledig bewust zijn. Maar de ervaringen en de praktijk die we op dit moment opdoen, bevestigen dat we de juiste richting voor ontwikkeling hebben gekozen, en dat we deze nieuwe kansen in de toekomst niet zullen missen en ook effectief kunnen reageren op de uitdagingen die voor 'Sportmaster' liggen.
Conclusies
Gedurende deze uitdagende tijd hebben we de belangrijkste principes geformuleerd die de ontwikkeling van software ondersteunen, die, denk ik, relevant zullen zijn voor elk bedrijf dat hieraan werkt.
Mensen. Dit is waar alles op steunt. Medewerkers moeten plezier hebben in hun werk, de doelen van het bedrijf en de producten waar ze mee bezig zijn begrijpen. En natuurlijk moeten ze zich professioneel kunnen ontwikkelen.
Technologie. Het is noodzakelijk dat het bedrijf op een volwassen manier omgaat met zijn technologische stack en competenties opbouwt waar dat echt nodig is. Het klinkt erg simpel en voor de hand liggend. En wordt vaak genegeerd.
Processen. Het is belangrijk om de samenwerking binnen productteams en competentiecentra goed te organiseren en interactie met het bedrijfsleven op te zetten, zodat we als partners kunnen samenwerken.
Over het algemeen hebben we zo overleefd. De belangrijkste stelling van de moderniteit bevestigde zich weer eens, met een duidelijke klap op het voorhoofd.
Zelfs als je een enorm offline bedrijf bent met veel winkels en in tal van steden aanwezig bent, ontwikkel je je online. Dit is niet zomaar een extra verkoopkanaal of een mooie applicatie waar je ook iets kunt kopen (en ook omdat de concurrentie ook mooie applicaties heeft). Dit is geen reserveband voor als het nodig is, die je helpt om de storm door te komen.
Dit is een absolute noodzaak. Waarvoor niet alleen je technische mogelijkheden en infrastructuur, maar ook mensen en processen voorbereid moeten zijn. Want het is mogelijk om snel extra geheugen, ruimte, nieuwe instanties en dergelijke aan te schaffen in een paar uur. Maar mensen en processen moeten hiervoor van tevoren worden voorbereid.
Bron: habr.com
