

Hallo allemaal. Dit artikel is geschreven voor degenen die nog steeds twijfelen tussen verschillende virtualisatieplatforms, vooral na het lezen van een artikel in de serie ‘We hebben Proxmox geïnstalleerd en het werkt geweldig, 6 jaar uptime zonder enige onderbreking’. Maar na het installeren van welke kant-en-klare oplossing dan ook, komt de vraag: hoe pas ik dit en dat aan, zodat de monitoring begrijpelijker is, en hieromtrent wil ik de backups beter kunnen beheren... En dan komt er een moment waarop je beseft dat je iets functioneelers wilt, of dat je wilt dat alles binnen jouw systeem duidelijk is, en niet dat zwarte doos-gevoel. Of je wilt iets gebruiken dat meer is dan alleen een hypervisor met veel virtuele machines. In dit artikel zal ik wat overpeinzingen en praktische voorbeelden delen op basis van het OpenNebula-platform – gekozen omdat het niet veel middelen vereist en de architectuur niet zo ingewikkeld is.
Dus, zoals we zien, werken veel cloudproviders met KVM en creëren ze externe toepassingen voor het beheren van machines. Het is duidelijk dat grote hosters hun eigen applicaties voor cloudinfrastructuren schrijven, zoals YANDEX bijvoorbeeld. Sommigen gebruiken OpenStack en bouwen hun toepassingen daaromheen – SELECTEL, MAIL.RU. Maar als je eigen hardware hebt en een klein team van specialisten, kies je meestal iets uit de beschikbare opties – VMWARE, HYPER-V, er zijn gratis en betaalde licenties, maar daar gaat dit nu niet over. Laten we het hebben over enthousiastelingen – degenen die niet bang zijn om nieuwe dingen voor te stellen en te proberen, ongeacht de impliciete signalen van het bedrijf als 'Wie gaat dit later onderhouden' of 'Zullen we dit wel in productie brengen? Dat is eng.' Maar je kunt deze oplossingen eerst in een testomgeving gebruiken, en als iedereen tevreden is, kun je de kwestie van verdere ontwikkeling en gebruik in serieuzere omgevingen ter sprake brengen.
Hier is ook een link naar de presentatie van een actieve deelnemer in de ontwikkeling van dit platform.
Misschien bevat dit artikel iets dat overbodig is en al begrijpelijk is voor een ervaren specialist, en in sommige gevallen zal ik niet alles beschrijven, omdat dergelijke commando's en beschrijvingen online beschikbaar zijn. Hier deel ik alleen mijn ervaringen met dit platform. Ik hoop dat actieve deelnemers in de comments zullen aanvullen wat beter kan en welke fouten ik heb gemaakt. Alle acties vonden plaats in een thuistestomgeving bestaande uit 3 PCs met verschillende specificaties. Ook heb ik er bewust voor gekozen om niet uit te leggen hoe deze software werkt en hoe je deze installeert. Nee, alleen ervaringen met het beheer en de problemen waarmee ik ben geconfronteerd. Hopelijk is dit nuttig voor iemand bij het maken van keuze.
Laten we beginnen. Voor mij als systeembeheerder zijn de volgende punten belangrijk, zonder welke ik deze oplossing waarschijnlijk niet zal gebruiken.
1. Herhaalbaarheid van installatie
Er zijn veel instructies voor de installatie van opennebula, hier zouden geen problemen moeten optreden. Van versie tot versie verschijnen er nieuwe functies die niet altijd werken bij een upgrade.
2. Monitoring
We zullen de node zelf, kvm en opennebula monitoren. Gelukkig is er al iets klaar. Voor het monitoren van Linux-hosts zijn er talloze opties, zoals Zabbix of een node exporter — wat je maar het leukste vindt — momenteel definieer ik het zo dat system metrics (temperatuur waar gemeten kan worden, consistentie van de schijfarray) via Zabbix gaan, en wat betreft applicaties via een exporter naar Prometheus. Voor het monitoren van kvm kun je bijvoorbeeld het project gebruiken en het opstarten via systemd instellen, wat goed werkt en kvm-metrics toont. Er is ook een kant-en-klare dashboard beschikbaar. .
Bijvoorbeeld, hier is mijn bestand:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
En dus hebben we 1 exporter, we hebben er een tweede nodig voor het monitoren van opennebula, ik heb deze gebruikt:
Je kunt toevoegen aan een standaard voor het monitoren van het systeem het volgende.
In het node_exporter bestand wijzigen we de startopdracht als volgt:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorMaak de directory aan mkdir -p /var/lib/opennebula_exporter
De bash-script hierboven controleren we eerst op de console; als het laat zien wat nodig is (als er een foutmelding is, installeren we xmlstarlet), kopiëren we het naar /usr/local/bin/opennebula_exporter.sh
Voeg een cron-taak toe die elke minuut draait:
*\/1 * * * * (\/usr\/local\/bin\/opennebula_exporter.sh > \/var\/lib\/opennebula_exporter\/textfile_collector\/opennebula.prom)Metrics are starting to appear, you can collect them with Prometheus, build graphs, and set alerts. In Grafana, you can create a simple dashboard like this.
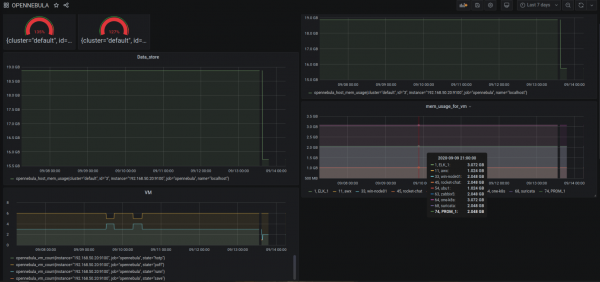
(it's clear that I've done an overcommit for CPU and RAM here)
For those who like and use Zabbix, there's
That's all about monitoring; the main thing is it's available. Of course, you can additionally use built-in monitoring tools for virtual machines and export data to billing, but everyone has their own vision, and I haven’t delved into that yet.
As for logging, I haven’t started much yet. The simplest option is to add td-agent for parsing the directory \/var\/lib\/one with regular expressions. For example, the file sunstone.log fits the regexp for nginx and other files that show the history of platform interactions — what's the advantage of this? Well, for instance, we can clearly track the number of 'Error' messages and more quickly identify where and at what level there are issues.
3. Backups
There are also paid enhanced projects — for example, sep :OpenNebula_Backup. Here, we need to understand that simply backing up a machine image isn’t enough, as our virtual machines must work with full integration (the same context file that describes network settings, VM name, and custom settings for your applications). Therefore, we determine what and how we will back up. In some cases, it’s better to make copies of what is inside the VM. And possibly, we only need to back up one disk from this machine.
For example, we decided that all machines start with persistent images, hence reading
means we can first export the image from our VM:
onevm disk-saveas 74 3 prom.qcow2
Image ID: 77

Let's see under what name it was saved:

oneimage show 77
\/var\/lib\/one\/datastores\/100\/f9503161fe180658125a9b32433bf6e8

And then we copy it to where we need it. Of course, it's not the best method. I just wanted to show that using OpenNebula tools, similar solutions can be built.
I've also found and there's also , but this one is only for qcow2 storage.
Maar zoals we allemaal weten, komt er vroeg of laat een moment waarop je wilt investeren in incrementele back-ups. Dit is ingewikkelder en misschien zal het management geld uittrekken voor een betaalde oplossing, of je kiest ervoor om het anders aan te pakken, met de wetenschap dat we hier alleen resources aan het verspillen zijn. Het reserveren zou op applicatieniveau moeten plaatsvinden en het aantal nieuwe nodes en virtuele machines moet worden vergroot. Ik bedoel hier dat het gebruik van de cloud uitsluitend voor het opstarten van applicatieclustering moet zijn, terwijl databases op een ander platform draaien of je gebruik kunt maken van een oplossing van een leverancier, als dat mogelijk is.
4. Gebruiksgemak
In dit gedeelte beschrijf ik de problemen waarmee ik te maken heb gehad. Bijvoorbeeld, zoals we weten, zijn er persistent images — wanneer deze afbeelding aan een virtuele machine wordt gekoppeld, worden alle gegevens in deze afbeelding opgeslagen. Bij non-persistent kopieert het de afbeelding naar de opslag en worden de gegevens geschreven aan wat is gekopieerd van de oorspronkelijke afbeelding — dit zijn hoe sjablonen werken. Ik heb mezelf herhaaldelijk problemen bezorgd door vergeten persistent aan te geven, waardoor een afbeelding van 200 GB werd gekopieerd. Het probleem is dat je deze procedure meestal niet kunt annuleren; je moet naar de node gaan en het huidige proces ‘cp’ beëindigen.
Een van de belangrijkste nadelen is dat je acties niet eenvoudig kunt annuleren met de GUI. Je annuleert ze en ziet dat er niets gebeurt, dus start je het opnieuw, annuleer je het en feitelijk zijn er nu al 2 kopieerprocessen gaande die de afbeelding kopiëren.
En hier komt het inzicht waarom OpenNebula elke nieuwe instantie een nieuwe ID geeft. Bijvoorbeeld, als je in Proxmox een VM met ID 101 maakt, deze verwijdert en vervolgens opnieuw maakt, krijg je weer ID 101. Dat zal in OpenNebula niet gebeuren; elke nieuwe instantie zal worden aangemaakt met een nieuwe ID en dat heeft zijn logica — bijvoorbeeld, het opruimen van oude gegevens of onsuccesvolle installaties.
Hetzelfde geldt voor de opslag; dit platform is voornamelijk gericht op gecentraliseerde opslag. Er zijn add-ons voor lokaal gebruik, maar dat is hier niet het onderwerp. Ik denk dat iemand in de toekomst een artikel zal schrijven over hoe het mogelijk was om lokale opslag op nodes te gebruiken en het succesvol in productie te gebruiken.
5. Maximale eenvoud
Natuurlijk, hoe verder je gaat, hoe minder mensen je zullen begrijpen.
In mijn omgeving — 3 nodes met NFS-opslag — werkt alles prima. Maar als je experimenten uitvoert met stroomuitval, bijvoorbeeld tijdens het starten van een snapshot en het uitschakelen van de node, blijven de instellingen in de database bewaard, wat aangeeft dat er een snapshot is, terwijl het feitelijk niet bestaat (we begrijpen allemaal dat dit oorspronkelijk in de SQL-database is vastgelegd over deze actie, maar de operatie zelf is niet succesvol afgerond). Het voordeel is dat bij het aanmaken van een snapshot er een apart bestand wordt gegenereerd en er een 'ouder' is, waardoor we bij problemen, zelfs als het via de GUI niet werkt, het QCOW2-bestand kunnen ophalen en apart kunnen herstellen.
Wat netwerken betreft, helaas is het niet zo eenvoudig. Althans, eenvoudiger dan in OpenStack; ik heb alleen VLAN (802.1Q) gebruikt — dat werkt prima, maar als je wijzigingen aanbrengt in de instellingen van de sjabloonnetwerk, worden die instellingen niet toegepast op al werkende machines. Dat wil zeggen, je moet de netwerkinterface verwijderen en opnieuw toevoegen, zodat de nieuwe instellingen worden toegepast.
Als je nog wilt vergelijken met OpenStack, kun je zeggen dat in OpenNebula er geen duidelijke definitie is van welke technologieën gebruikt moeten worden voor gegevensopslag, netwerkbeheer en -resources — elke administrator beslist zelf hoe het hem het beste uitkomt.
6. Aanvullende plugins en installaties
Want zoals we begrijpen, kan het cloudplatform niet alleen KVM beheren, maar ook VMware ESXi. Helaas had ik geen pool met vCenter, als iemand dit heeft geprobeerd, laat het me weten.
Er is ondersteuning verklaard voor andere cloudproviders.
AWS, AZURE.
Ik heb ook geprobeerd VMware Cloud van Selectel te integreren, maar het is niet gelukt — in het algemeen ben ik gestopt, omdat er veel factoren zijn en het heeft geen zin om contact op te nemen met de technische ondersteuning van de hostingprovider.
Bovendien is er in de nieuwe versie nu Firecracker — dit is de lancering van microVM's, een soort KVM-wrapper bovenop Docker, die nog meer veelzijdigheid, veiligheid en prestatiewinst biedt, omdat het geen middelen vereist voor hardware-emulatie. Ik zie alleen de voordelen ten opzichte van Docker in die zin dat het geen extra processen verbruikt en er geen sockets worden bezet bij het gebruik van deze emulatie — dat wil zeggen, het kan heel goed worden gebruikt als load balancer (maar daarover zou misschien een apart artikel moeten worden geschreven, aangezien ik nog niet alle tests volledig heb uitgevoerd).
7. Positieve ervaringen met gebruik en het debuggen van fouten
Ik wilde mijn observaties delen over het functioneren, een deel heb ik hierboven beschreven, en ik wil er meer over schrijven. Het is inderdaad waarschijnlijk niet alleen ik die in eerste instantie denkt dat dit geen goed systeem is en dat alles hier eigenlijk een beetje improvisatie is — hoe werkt dit eigenlijk? Maar dan komt het begrip dat alles vrij logisch is. Natuurlijk is het moeilijk om iedereen tevreden te stellen en sommige punten vereisen verbetering.
Bijvoorbeeld, een eenvoudige operatie om een schijfkopie van de ene datastore naar de andere te kopiëren. In mijn geval zijn er 2 knooppunten met nfs, ik stuur de afbeelding — de kopieeractie verloopt via de frontend van OpenNebula, terwijl we allemaal gewend zijn dat gegevens rechtstreeks tussen hosts moeten worden gekopieerd — in VMware en Hyper-V zijn we daar gewend aan, maar hier is het anders. Hier is een andere aanpak en een andere ideologie, en in versie 5.12 is de knop 'migreer naar datastore' verwijderd — alleen de machine wordt verplaatst, maar niet de opslag, omdat er een gecentraliseerde opslag wordt verondersteld.
Vervolgens een veelvoorkomende fout met verschillende oorzaken 'Error deploying virtual machine: Could not create domain from /var/lib/one//datastores/103/10/deployment.5' Hieronder komt een lijst van wat je moet kijken.
- Rechten op de afbeelding voor de gebruiker oneadmin;
- Rechten voor de gebruiker oneadmin om libvirtd te starten;
- Is de datastore goed gemonteerd? Ga en controleer het pad op het knooppunt zelf, misschien is er iets afgehaakt;
- Onjuist geconfigureerd netwerk, beter gezegd, op de frontend staat in de netwerkinstellingen dat br0 het belangrijkste interface voor vlan is, terwijl op het knooppunt is aangegeven — bridge0 — het moet consistent zijn.
system datastore slaat metadata voor uw vm op, als u een vm met een persistente afbeelding start, moet de vm toegang hebben tot de oorspronkelijk gemaakte configuratie op de opslag waar u de vm hebt gemaakt — dit is heel belangrijk. Daarom moet alles opnieuw worden gecontroleerd bij het verplaatsen van de vm naar een andere datastore.
8. Documentatie, gemeenschap. Verdere ontwikkeling
En verder, goede documentatie, gemeenschap en vooral dat het project in de toekomst blijft leven.
Hier is alles in het algemeen redelijk goed gedocumenteerd en zelfs via de officiële bron zou het geen probleem zijn om te installeren en antwoorden op vragen te vinden.
Gemeenschap, actief. Publiceert veel kant-en-klare oplossingen die u kunt gebruiken in uw installaties.
Op dit moment zijn er met 5.12 enkele beleidswijzigingen binnen het bedrijf. Het is interessant om te zien hoe het project zich zal ontwikkelen. In het begin heb ik doelbewust enkele leveranciers genoemd die hun eigen oplossingen gebruiken en wat de industrie te bieden heeft. Er is natuurlijk geen eenduidig antwoord op wat u moet gebruiken. Maar voor kleine organisaties kan het ondersteunen van een klein privé-cloudsysteem minder duur zijn dan het lijkt. Het belangrijkste is om precies te weten dat dit is wat u nodig heeft.
Samengevat, ongeacht welk cloud-systeem u kiest, moet u niet bij één product blijven. Als u tijd heeft, is het de moeite waard om te kijken naar andere, meer open oplossingen.
Er is een goede chatgroep helpen actief en zeggen niet dat u de oplossing voor uw probleem op Google moet zoeken. Sluit je aan.
Bron: habr.com
