

Beste lezers, goedemiddag!
De uitdaging van het opbouwen van IT-platforms voor dataopslag en -analyse komt vroeg of laat bij elk bedrijf dat een op intellectueel zware dienstverlening of de creatie van technisch complexe producten gebaseerd is. Het bouwen van analytische platforms is een complexe en tijdrovende taak. Maar elke uitdaging kan vereenvoudigd worden. In dit artikel wil ik mijn ervaringen delen met het gebruik van low-code-tools die helpen bij het creëren van analytische oplossingen. Deze ervaring is opgedaan tijdens de uitvoering van verschillende projecten binnen de Big Data Solutions afdeling van NeoFlex. Sinds 2005 houdt NeoFlex zich bezig met het bouwen van datastorage en data lakes, optimaliseerproblemen van inform processing en werkt aan methodologieën voor gegevenskwaliteitbeheer.
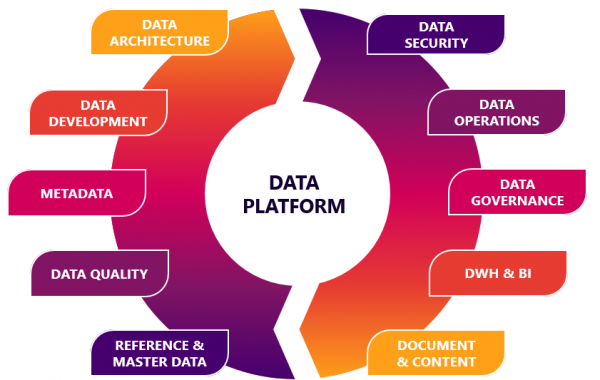
Het is voor niemand mogelijk om het opzettelijk accumuleren van zwak en/of sterk gestructureerde gegevens te vermijden. Zelfs niet voor kleine bedrijven. Want bij de groei van het bedrijf zal een vooruitziende ondernemer geconfronteerd worden met vragen over loyaliteitsprogramma's, wil hij de effectiviteit van verkooppunten analyseren, denken over gerichte reclame, en zich zorgen maken over de vraag naar ondersteunende producten. In eerste instantie kan de uitdaging op een ad-hoc manier worden opgelost. Maar met de groei van het bedrijf is de overgang naar een analytisch platform onvermijdelijk.
Maar wanneer kunnen data-analysetaken in opdrachten van het type 'Rocket Science' veranderen? Waarschijnlijk op het moment dat het echt om grote gegevens gaat.
Om de 'Rocket Science'-uitdaging te vereenvoudigen, kun je de olifant in stukjes eten.
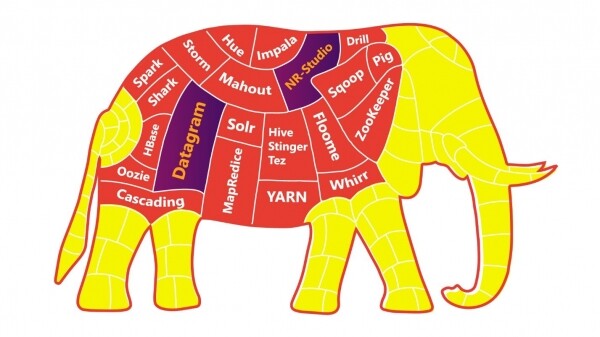
Hoe groter de discretie en autonomie van je applicaties/diensten/microservices, des te eenvoudiger het wordt voor jou, je collega's en het hele bedrijf om de olifant te verteren.
Bij deze conclusie zijn vrijwel al onze klanten gekomen, waarbij zij het landschap hebben omgevormd op basis van de engineeringpraktijken van DevOps-teams.
Maar zelfs met een 'gescheiden, olifanten'-dieet hebben we nog steeds een redelijke kans op 'oververzadiging' van het IT-landschap. Op dat moment is het goed om even stil te staan, diep adem te halen en in de richting van low-code engineering platform.
Veel ontwikkelaars zijn bang voor de mogelijkheid van een carrière-stagnatie bij het afstappen van het rechtstreeks schrijven van code naar het 'slijden' van pijlen in de UI-interfaces van low-code systemen. Maar de komst van machines heeft niet geleid tot de verdwijning van ingenieurs; in plaats daarvan heeft het hun werk naar een nieuw niveau getild!
Laten we uitzoeken waarom.
Data-analyse in de logistiek, de telecomsector, het medialandschap en de financiële sector gaat altijd gepaard met de volgende vragen:
- De snelheid van geautomatiseerde analyse;
- De mogelijkheid om experimenten uit te voeren zonder invloed op de hoofdproductiestroom van gegevens;
- De betrouwbaarheid van voorbereide gegevens;
- Het volgen van wijzigingen en versiebeheer;
- Data provenance, Data lineage, CDC;
- De snelheid van levering van nieuwe functies naar de productieomgeving;
- En de beruchte: kosten van ontwikkeling en ondersteuning.
Dit betekent dat ingenieurs een enorm aantal hoogwaardige taken hebben die efficiënt kunnen worden uitgevoerd door hun geest vrij te maken van lage-niveau ontwikkeltaken.
De aanleiding voor het overstappen van ontwikkelaars naar een nieuw niveau zijn de evolutie en digitalisering van het bedrijfsleven. De waarde van de ontwikkelaar verandert ook: er is een significante schaarste aan ontwikkelaars die in staat zijn om de kern van de concepten van geautomatiseerd bedrijfsleven te doorgronden.
Laten we een vergelijking maken met lage- en hoge-niveau programmeertalen. De overstap van lage-niveau talen naar hoge-niveau talen is een overgang van het schrijven van 'directe instructies in de taal van de hardware' naar 'instructies in de taal van mensen'. Dit betekent het toevoegen van een bepaalde laag van abstractie. In dit geval is de overstap naar low-code platforms vanuit hoge-niveau programmeertalen een overgang van 'instructies in de taal van mensen' naar 'instructies in de taal van het bedrijfsleven'. Als er ontwikkelaars zijn die dit feit verdrietig maken, dan zijn zij mogelijk al verdrietig sinds het moment dat JavaScript zijn intrede deed, waarin functie voor array-sortering worden gebruikt. En deze functies hebben natuurlijk software-implementaties onder de motorkap met behulp van andere middelen van dezelfde hoge-niveau programmering.
Conclusie: low-code is slechts het ontstaan van een nieuw niveau van abstractie.
Toegepaste ervaring met het gebruik van low-code
Het onderwerp low-code is breed, maar nu wil ik het hebben over de praktische toepassing van 'low-codeconcepten' aan de hand van een van onze projecten.
De afdeling Big Data Solutions van het bedrijf ‘Neoflex’ richt zich voornamelijk op de financiële sector, door dataopslag- en datameren te bouwen en verschillende rapportages te automatiseren. In deze niche is het gebruik van low-code al lang een standaard. Onder andere low-code-tools zijn te noemen voor het organiseren van ETL-processen: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Of Oracle Apex, dat fungeert als een platform voor het snel ontwikkelen van toegang- en data-editie interfaces. Echter, het gebruik van low-code ontwikkelingsmiddelen betekent niet altijd dat er alleen op maat gemaakte applicaties worden gebouwd met een commercieel technologie-stack dat sterk afhankelijk is van een leverancier.
Met low-code-platformen kunnen ook datastromen worden georkestreerd, data-science-omgevingen worden gecreëerd of bijvoorbeeld modules voor datakwaliteitscontrole worden ontwikkeld.
Een van de praktische voorbeelden van de ervaring met low-code ontwikkelingsmiddelen is de samenwerking van 'Neoflex' met Mediascope, een van de leiders op de Russische markt voor medi onderzoek. Een van de zakelijke doelstellingen van dit bedrijf is het produceren van data, waarop adverteerders, internetplatformen, televisiekanalen, radiostations, reclamebureau’s en merken hun beslissingen over het kopen van advertenties baseren en hun marketingcommunicatie plannen.
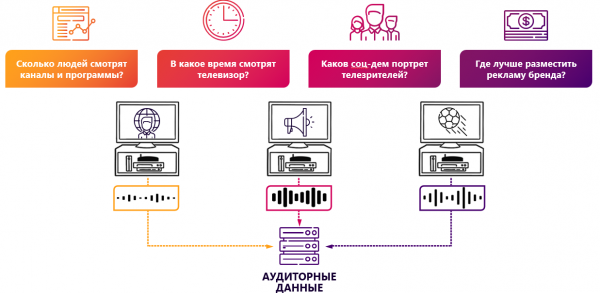
Mediaonderzoek is een technologisch intensieve sector. Het herkennen van video-inhoud, het verzamelen van gegevens van apparaten die het bekijken analyseren, en het meten van activiteit op webresources – dit alles vereist dat een bedrijf een groot IT-team heeft en een enorme ervaring in het opbouwen van analytische oplossingen. Maar de exponentiële groei van de hoeveelheid informatie, evenals het aantal en de diversiteit van de bronnen, dwingt de IT-datindustrie voortdurend te innoveren. De gemakkelijkste manier om een al functionerend analytisch platform zoals Mediascope op te schalen, zou kunnen zijn door het IT-team uit te breiden. Maar een veel effectievere oplossing is om het ontwikkelingsproces te versnellen. Een van de stappen die in deze richting kunnen leiden, is het gebruik van low-code-platformen.
Bij de start van het project had het bedrijf al een functionele productoplossing. Echter, de implementatie van de oplossing op MSSQL kon niet volledig voldoen aan de verwachtingen voor schaalbaarheid van de functionaliteit, terwijl de kosten voor aanpassingen acceptabel bleven.
De taak die voor ons lag, was werkelijk ambitieus – Neoflex en Mediascope moesten een industrieel niveau oplossing creëren in minder dan een jaar, met de voorwaarde dat de MVP al in het eerste kwartaal na de startdatum zou worden gelanceerd.
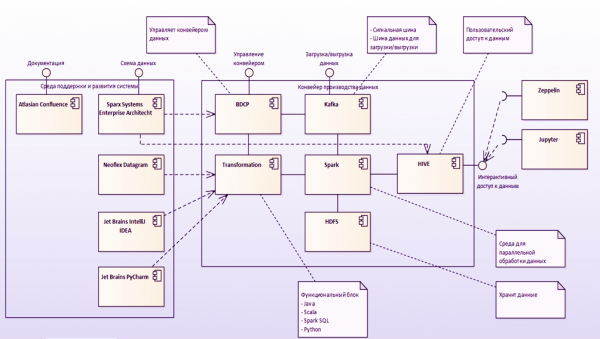
Als fundament voor het opbouwen van het nieuwe data platform, gebaseerd op low-code berekeningen, werd de technologie stack Hadoop gekozen. De standaard voor dataopslag werd HDFS met gebruik van parquet-bestandsformaten. Voor toegang tot de gegevens op het platform werd Hive gebruikt, waarin alle beschikbare virtuele tabellen zijn weergegeven als externe tabellen. De gegevensinvoer in de opslag werd uitgevoerd met behulp van Kafka en Apache NiFi.
De low-code tool in dit concept werd toegepast om de meest arbeidsintensieve taak in het bouwen van het analytische platform – de gegevensverwerkingsopdracht – te optimaliseren.
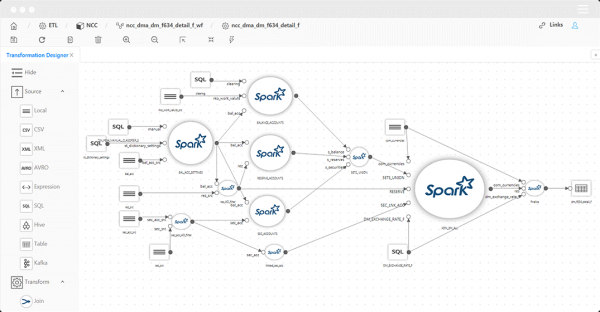
Het belangrijkste mechanisme voor het mappen van gegevens was de low-code tool Datagram. Neoflex Datagram is een hulpmiddel voor het ontwikkelen van transformaties en datastromen.
Met deze tool is het mogelijk om zonder handmatige Scala-code te schrijven. Scala-code wordt automatisch gegenereerd met behulp van het Model Driven Architecture-approach.
Een duidelijk voordeel van deze aanpak is de versnelling van het ontwikkelingsproces. Maar naast snelheid zijn er nog meer voordelen:
- Inhoud en structuur van bronnen/ontvangers bekijken;
- De herkomst van objecten in de datastroom tot aan individuele velden traceren (lineage);
- Gedeeltelijke uitvoering van transformaties met een weergave van tussenresultaten;
- Bekijk de originele code en pas deze aan voor uitvoering;
- Automatische validatie van transformaties;
- Automatische gegevensinvoer 1 op 1.
De instapdrempel voor low-code oplossingen voor het genereren van transformaties is relatief laag: een ontwikkelaar moet SQL begrijpen en ervaring hebben met ETL-tools. Het is echter belangrijk op te merken dat code-driven transformatiegeneratoren niet hetzelfde zijn als ETL-tools in de brede zin van het woord. Low-code-tools hebben mogelijk geen eigen omgeving om code uit te voeren. Dit betekent dat de gegenereerde code wordt uitgevoerd in de omgeving die op het cluster bestond vóór de installatie van de low-code oplossing. Dit is wellicht weer een pluspunt voor low-code. Parallel aan het low-code team kan een 'klassiek' team werken dat functionaliteit implementeert, bijvoorbeeld met pure Scala-code. Het aanbrengen van aanpassingen door beide teams in productie zal eenvoudig en 'naadloos' verlopen.
Het is misschien ook belangrijk op te merken dat er naast low-code ook no-code oplossingen zijn. En in wezen zijn dit verschillende zaken. Low-code stelt de ontwikkelaar in grote mate in staat om in de gegenereerde code in te grijpen. In het geval van Datagram is het mogelijk om de gegenereerde Scala-code te bekijken en te bewerken, terwijl no-code mogelijk die mogelijkheid niet biedt. Dit verschil is aanzienlijk, niet alleen wat betreft de flexibiliteit van de oplossing, maar ook in termen van comfort en motivatie voor data-engineers.
Architectuur van de oplossing
Laten we proberen te begrijpen hoe een low-code tool helpt bij het optimaliseren van de snelheid van de ontwikkeling van functionaliteit voor gegevensberekeningen. Laten we beginnen met het analyseren van de functionele architectuur van het systeem. In dit geval is het voorbeeld een datamodel voor mediaonderzoek.
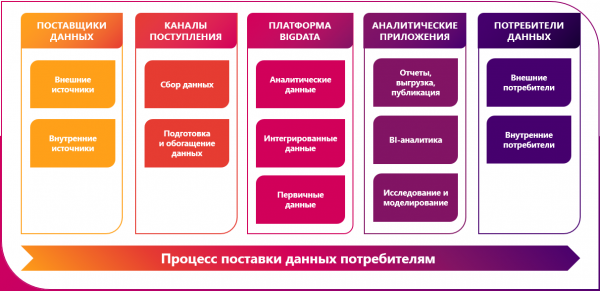
De gegevensbronnen in ons geval zijn zeer divers en rijk aan variëteiten:
- People meters (TV meters) zijn software-hardware apparaten die het gebruikersgedrag van respondenten op een televisiepanel registreren – wie, wanneer en welke zender werd bekeken in een huishouden dat deelneemt aan het onderzoek. De geleverde informatie is een stroom van kijkintervalgegevens gekoppeld aan het mediapakket en het mediaproduct. Gegevens kunnen tijdens de upload naar de Data Lake worden verrijkt met demografische attributen, koppelingen aan geostrategieën, tijdzones en andere informatie die nodig is voor de analyse van het kijkgedrag van een bepaald mediaproduct. De verzamelde metingen kunnen worden gebruikt voor de analyse of planning van reclamecampagnes, het evalueren van de activiteit en voorkeuren van het publiek en voor het opstellen van een uitzendschema;
- Gegevens kunnen afkomstig zijn van systemen voor het monitoren van streamingtelevisie en het meten van kijkgedrag op online videoplatforms;
- Meetinstrumenten in de webomgeving, bestaande uit zowel site-centrische als user-centrische tellers. Een browserextensie zoals de research bar en een mobiele applicatie met ingebouwde functies kunnen dienen als dataleverancier voor de Data Lake; VPN.
- Gegevens kunnen ook afkomstig zijn van platforms die de resultaten consolideren van online enquêtes en de uitkomsten van telefonische interviews in de marktonderzoeken van het bedrijf;
- Extra verrijking van de gegevenslake kan plaatsvinden door gegevens uit logboeken van partnerbedrijven te uploaden.
De implementatie van de as-is upload vanuit de bronsystemen naar de primaire staging van ruwe gegevens kan op verschillende manieren worden georganiseerd. Bij gebruik van low-code zijn automatische uploadscripten mogelijk op basis van metadata. Het is dan niet nodig om naar het niveau van development van source to target mapping te dalen. Voor de automatische upload moeten we verbinding maken met de bron en vervolgens in de uploadinterface een lijst van entiteiten bepalen die moeten worden geüpload. De structuren voor mappen in HDFS worden automatisch aangemaakt en sluiten aan bij de datastructuur van het bronsysteem.
Echter, in de context van dit project hebben we besloten deze mogelijkheid van de low-code platformen niet te gebruiken, omdat het bedrijf Mediascope al zelf is begonnen met het ontwikkelen van een soortgelijke dienst met een combinatie van Nifi + Kafka.
Het is belangrijk om te benadrukken dat deze tools elkaar niet vervangen, maar eerder elkaar aanvullen. Nifi en Kafka kunnen zowel in een directe (Nifi -> Kafka) als in een omgekeerde (Kafka -> Nifi) koppeling werken. Voor het mediatonenplatform werd de eerste variant van de koppeling gebruikt.
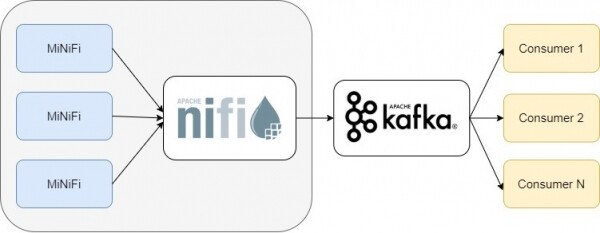
In ons geval moest Nifi verschillende soorten gegevens uit systemen van bronnen verwerken en naar de Kafka-broker sturen. Het verzenden van berichten naar een specifieke Kafka-topic gebeurde met behulp van Nifi-processors PublishKafka. De orkestratie en het onderhoud van deze pipelines vinden plaats in een visuele interface. De tool Nifi en het gebruik van de combinatie Nifi + Kafka kunnen ook worden beschouwd als een low-code benadering van ontwikkeling, met een lage instapdrempel voor Big Data-technologieën en een versnelde applicatie-ontwikkelingsproces.
De volgende stap in de uitvoering van het project was het omzetten naar een uniform semantisch laagformaat voor gedetailleerde gegevens. In het geval van historische attributen van een entiteit vindt de berekening plaats in de context van de betreffende partitie. Als de entiteit niet historisch is, is het optioneel mogelijk om ofwel de hele inhoud van het object opnieuw te berekenen, of om helemaal geen herberekening van dit object uit te voeren (wegens afwezigheid van wijzigingen). In deze fase worden sleutels gegenereerd voor alle entiteiten. De sleutels worden opgeslagen in de bijbehorende masterobjectenreferentiebestanden in Hbase, die de overeenkomst tussen sleutels in het analytische platform en sleutels uit de systemen van bronnen bevatten. De consolidatie van atomische entiteiten gaat gepaard met verrijking met resultaten van voorlopige berekening van analytische gegevens. Het framework voor het berekenen van de gegevens was Spark. De beschreven functionaliteit voor het omzetten van gegevens naar een uniforme semantiek werd ook gerealiseerd op basis van de mappings van het low-code-instrument Datagram.
In de doelarchitectuur was het nodig om SQL-toegang tot gegevens voor zakelijke gebruikers te waarborgen. Voor deze optie werd Hive gebruikt. De registratie van objecten in Hive gebeurt automatisch wanneer de optie 'Register Hive Table' in het low-code-instrument wordt ingeschakeld.
Beheer van de stroom van berekeningen
Datagram heeft een interface voor het ontwerpen van workflow-stromen. Het uitvoeren van mapping kan worden gedaan met behulp van de Oozie-scheduler. In de ontwikkelaarsinterface voor stromen is het mogelijk om schema's te maken van parallelle, sequentiële of voorwaarden-gedreven datatransformaties. Er is ondersteuning voor shell scripts en Java-programma's. Ook is het mogelijk om gebruik te maken van de server Apache Livy. Apache Livy wordt gebruikt om applicaties direct vanuit de ontwikkelomgeving te starten.
Indien het bedrijf al een eigen procesorchestrator heeft, is het mogelijk om de REST API te gebruiken om mappings in de bestaande stroom te integreren. Bijvoorbeeld, we hebben vrij succesvolle ervaring opgedaan met het integreren van mappings op Scala in orchestrators geschreven in PLSQL en Kotlin. De REST API van de low-code tool omvat operaties zoals het genereren van uitvoerbare taken op basis van het mappingontwerp, het aanroepen van mappings, het aanroepen van een reeks mappings en natuurlijk het doorgeven van parameters in de URL voor het starten van de mappings.
Naast Oozie kan de rekenstroom ook worden georganiseerd met Airflow. Ik zal niet te lang stilstaan bij de vergelijking tussen Oozie en Airflow, maar gewoon zeggen dat, in de context van het mediaproject, de keuze is gevallen op Airflow. De belangrijkste argumenten deze keer waren een actiever gemeenschap die het product ontwikkelt, en een verder ontwikkeld interface + API.
Airflow is ook goed omdat het veelgeprezen Python gebruikt voor het beschrijven van rekenprocessen. Over het algemeen zijn er niet zoveel open-source workflow management platforms. Het starten en monitoren van processen (inclusief met een Gantt-diagram) draagt gewoon bij aan de goede reputatie van Airflow.
Het configuratiebestandsformaat voor het starten van mappings van de low-code oplossing is spark-submit geworden. Dit is om twee redenen gebeurd. Ten eerste laat spark-submit toe om een jar-bestand rechtstreeks vanuit de console te starten. Ten tweede kan het alle nodige informatie bevatten voor het configureren van de workflow (wat het schrijven van scripts die de Dag vormen vergemakkelijkt).
Het meest voorkomende element in de Airflow-workflow in ons geval is de SparkSubmitOperator geworden.
SparkSubmitOperator stelt je in staat om jar-bestanden - verpakte mappings van Datagram met vooraf geconfigureerde invoerparameters - uit te voeren.
Het moet worden opgemerkt dat elke taak van Airflow in een aparte thread wordt uitgevoerd en niets weet van de andere taken. Hierdoor vindt de interactie tussen taken plaats via controleoperators, zoals DummyOperator of BranchPythonOperator.
De combinatie van het gebruik van de low-code oplossing Datagram met de universalizatie van configuratiebestanden (die de Dag vormen) heeft geleid tot aanzienlijke versnelling en vereenvoudiging van het ontwikkelingsproces van dataloading streams.
Berekening van datavitrines
Misschien is de meest intellectueel belastende fase in de productie van analytische gegevens de stap van het bouwen van vitrines. In de context van een van de datacalculatiestromen van een onderzoeksbedrijf vindt op dit moment de aanpassing aan de referentietransmissie plaats rekening houdend met tijdzonecorrectie gekoppeld aan de uitzendgrid. Mogelijk is er ook een correctie voor de lokale uitzendgrid (lokale nieuws en reclame). Onder andere wordt in deze stap de afbraak van de continu kijkintervallen van mediaproducten uitgevoerd op basis van kijkintervalanalyses. Hier wordt ook de 'weging' van kijkwaarden uitgevoerd op basis van informatie over hun betekenis (berekening van de corrigerende coëfficiënt).
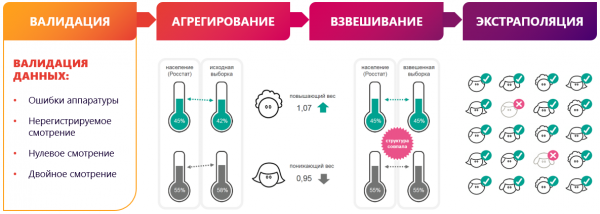
Een aparte stap in de voorbereiding van vitrines is de validatie van gegevens. Het validatie-algoritme is verbonden met het toepassen van een aantal wiskundige science-modellen. Het gebruik van een low-code platform maakt het echter mogelijk om het complexe algoritme op te splitsen in een reeks afzonderlijke visueel leesbare mappings. Elke mapping voert een specifieke taak uit. Hierdoor is midden in het proces debugging, logging en visualisatie van de gegevensvoorbereidingsstappen mogelijk.
Het validatie-algoritme is besloten te discretiseren in de volgende sub-stappen:
- Het bouwen van regressies van het kijkgedrag van de televisienetwerken in de regio, met het kijken naar alle netwerken in de regio over een periode van 60 dagen.
- Berekening van de student-gecorrigeerde residuen (de afwijkingen van de werkelijke waarden ten opzichte van de voorspelde waarden door het regressiemodel) voor alle regressiepunten en voor de berekende dag.
- Selectie van abnormale paren regio-televisienetwerk, waar het student-gecorrigeerde residu van de berekende dag de norm (vastgesteld door de instelling van de operatie) overschrijdt.
- Hertelling van de aangepaste gestandardiseerde restwaarde voor abnormale paar regio-televisienetwerken voor elke respondent die het netwerk in de regio bekeek, met de bepaling van de bijdrage van deze respondent (de omvang van de wijziging van de gestandardiseerde restwaarde) bij uitsluiting van het bekijken door deze respondent uit de steekproef.
- Zoeken naar kandidaten wiens uitsluiting de gestandardiseerde restwaarde van de berekeningsdag in de norm brengt.
Het bovenstaande voorbeeld bevestigt de hypothese dat een data-engineer al te veel in zijn hoofd moet hebben... En als hij daadwerkelijk een 'ingenieur' is en geen 'codeur', dan zou de angst voor professionele achteruitgang door het gebruik van low-code-tools hem definitief moeten vergaan.
Wat kan low-code nog meer?
Het toepassingsgebied van low-code-tools voor batch- en streaminggegevensverwerking zonder handmatig Scala-code te schrijven eindigt niet.
Het gebruik van low-code in de ontwikkeling van datalakes is voor ons al een soort standaard geworden. Je zou kunnen zeggen dat oplossingen op de Hadoop-stack de ontwikkeling van klassieke DWH's, gebaseerd op relationele databases, nabootsen. Low-code-tools op de Hadoop-stack kunnen zowel data-verwerkingsoplossingen als de bouw van uiteindelijke BI-interfaces aanpakken. Daarbij moet worden opgemerkt dat BI niet alleen de representatie van gegevens kan zijn, maar ook hun bewerking door zakelijke gebruikers. Deze functionaliteit wordt door ons vaak gebruikt bij de opbouw van analytische platforms voor de financiële sector.
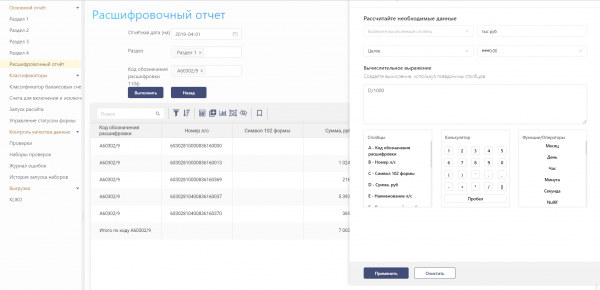
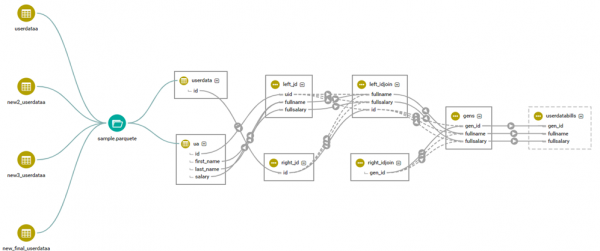
Onder andere kan met low-code en in het bijzonder Datagram de uitdaging van het volgen van de herkomst van gegevensstroomobjecten tot op het niveau van afzonderlijke velden (lineage) worden opgelost. Hiervoor is in de low-code-tool een koppeling met Apache Atlas en Cloudera Navigator geïmplementeerd. In wezen moet de ontwikkelaar een set objecten registreren in de Atlas-dictionaries en naar de geregistreerde objecten verwijzen bij het opstellen van mappings. Het mechanisme voor het volgen van de herkomst van gegevens of het analyseren van afhankelijkheden van objecten bespaart veel tijd bij het aanbrengen van wijzigingen in de berekeningsalgoritmen. Bijvoorbeeld bij het opstellen van financiële rapportages maakt deze functionaliteit het makkelijker om de periode van wijzigingen in wetgeving door te komen. Hoe beter we de intersectorale afhankelijkheid in detailobjecten begrijpen, hoe minder we te maken krijgen met "onverwachte" defecten en hoe we het aantal revisies kunnen verminderen.
Gegevenskwaliteit & Low-code
Een andere uitdaging die is gerealiseerd met de low-code-tool in het project van Mediascope, was de uitdaging van de klasse Gegevenskwaliteit. De bijzonderheid van de implementatie van de datavalidatiepijplijn voor het project van het onderzoeksbedrijf was dat er geen invloed was op de functionaliteit en snelheid van de primaire gegevensverwerkingsstroom. Voor het orkestreren van onafhankelijke datavalidatiestromen werd al bekende Apache Airflow gebruikt. Naarmate elke stap van de gegevensproductie gereed was, vond parallel de start van een afzonderlijk deel van de DQ-pijplijn plaats.
Een goede praktijk is het monitoren van de gegevenskwaliteit vanaf het moment van hun ontstaan in het analytische platform. Met metadata-informatie kunnen we al vanaf het moment dat informatie in de primaire laag binnenkomt controleren of aan basisvoorwaarden is voldaan — not null, constraints, foreign keys. Deze functionaliteit is gebaseerd op automatisch gegenereerde mappings van de data quality-familie in Datagram. De codegeneratie is in dit geval ook gebaseerd op de metadata van het model. In het project van Mediascope vond de koppeling plaats met de metadata van het product Enterprise Architect.
Dankzij de koppeling tussen de low-code-tool en Enterprise Architect werden automatisch de volgende controles gegenereerd:
- Controle op de aanwezigheid van "null"-waarden in velden met de modifier "not null";
- Controle op de aanwezigheid van dubbele primaire sleutels;
- Controle van de externe sleutel van de entiteit;
- Controle van de uniciteit van de rij op basis van een set velden.
Voor meer geavanceerde controles van de beschikbaarheid en validiteit van gegevens is er een mapping gemaakt met Scala Expression, die een externe Spark SQL-code voor controle accepteert, voorbereid door analisten in Zeppelin.
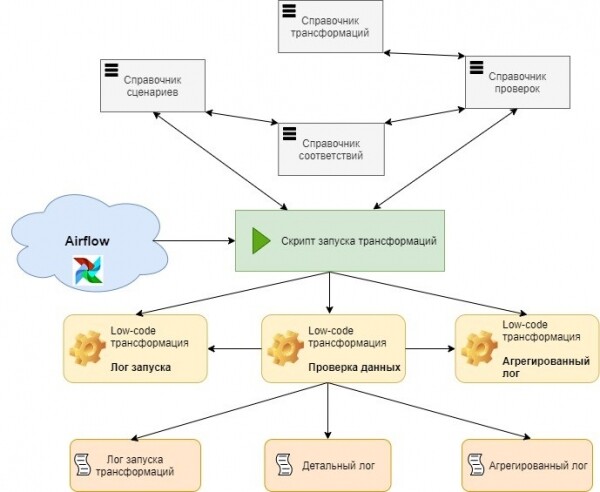
Natuurlijk moet de autogeneratie van controles geleidelijk worden geïmplementeerd. In het kader van dit project gingen de volgende stappen hieraan vooraf:
- DQ, geïmplementeerd in Zeppelin-notebooks;
- DQ, ingebed in de mapping;
- DQ in de vorm van afzonderlijke massieve mappings, die een hele reeks controles voor een afzonderlijke entiteit bevatten;
- Universiële parametergebaseerde DQ-mappings, die informatie over metadata en zakelijke controles accepteren.
Misschien is het belangrijkste voordeel van het creëren van een service voor parameter-gebaseerde controles de verkorting van de levertijd van functionaliteit naar de productieomgeving. Nieuwe kwaliteitscontroles kunnen het klassieke leveringspatroon omzeilen, dat gewoonlijk via ontwikkelings- en testomgevingen verloopt:
- Alle metadata-controles worden automatisch gegenereerd bij wijzigingen in het model in EA;
- Controles voor gegevensbeschikbaarheid (bepaling van de aanwezigheid van gegevens op een bepaald moment) kunnen worden gegenereerd op basis van een register dat de verwachte timing van het verschijnen van de volgende gegevensset per object opslaat;
- Zakelijke controles van gegevensvaliditeit worden door analisten in Zeppelin-notebooks gemaakt. Deze worden rechtstreeks naar de configuratietabellen van de DQ-module in de productieomgeving gestuurd.
De risico's van directe levering van scripts naar productie zijn er niet. Zelfs bij een syntaxisfout is het ergste dat ons kan overkomen, dat één controle niet wordt uitgevoerd, aangezien de gegevensverwerkingsstroom en de stroom voor het starten van kwaliteitscontroles van elkaar zijn gescheiden.
In wezen is de DQ-service permanent actief in de productieomgeving en klaar om zijn werk te beginnen bij het verschijnen van de volgende gegevensset.
Ter afsluiting
Het voordeel van het gebruik van low-code is duidelijk. Ontwikkelaars hoeven de applicatie niet "vanaf nul" te ontwikkelen. Een ontlastte programmeur levert sneller resultaat. Hierdoor komt er meer tijd vrij om optimalisatievraagstukken aan te pakken. Daarom kan in dit geval rekening gehouden worden met de aanwezigheid van een betere en snellere oplossing.
Natuurlijk is low-code geen wondermiddel, en de magie gebeurt niet zomaar:
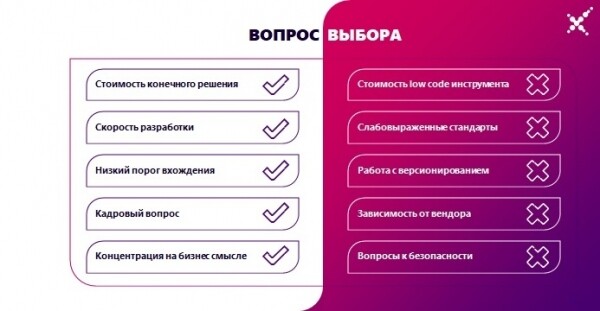
- De low-code industrie verkeert in een fase van "versterking", en er zijn momenteel geen uniforme industriestandaarden;
- Veel low-code oplossingen zijn niet gratis, en de aanschaf ervan moet een weloverwogen stap zijn, die men moet zetten met volledige zekerheid van de financiële voordelen van het gebruik;
- Veel low-code oplossingen werken niet altijd goed samen met GIT / SVN. Of ze zijn onhandig in gebruik wanneer de gegenereerde code verborgen is;
- Bij het uitbreiden van de architectuur kan het nodig zijn om de low-code oplossing aan te passen – wat op zijn beurt het effect van "afhankelijkheid en binding" aan de leverancier van de low-code oplossing bevordert.
- Een passend niveau van beveiliging is mogelijk, maar zeer arbeidsintensief en complex in de implementatie van low-code systemen. Low-code platforms moeten niet alleen worden gekozen op basis van het zoekvak van voordelen van hun gebruik. Bij de keuze moet men zich afvragen of er functies zijn voor toegangsbeheer en delegatie/escalatie van identificatiegegevens op het niveau van het gehele IT-landschap van de organisatie.
Maar als u zich alle nadelen van het gekozen systeem bewust bent, en de voordelen van het gebruik ervan desondanks in de overgrote meerderheid aanwezig zijn, ga dan zonder angst over naar low-code. Zeker omdat de overgang ernaartoe onontkoombaar is – net als elke evolutie.
Als één ontwikkelaar op een low-code-platform zijn werk sneller kan uitvoeren dan twee ontwikkelaars zonder low-code, geeft dat het bedrijf op alle fronten een voordeel. De instapdrempel voor low-code-oplossingen is lager dan voor ‘traditionele’ technologieën, wat een positieve invloed heeft op het vraagstuk van het tekort aan personeel. Het gebruik van low-code-tools kan de samenwerking tussen functionele teams versnellen en snellere besluitvorming over de juistheid van de gekozen richting in data-science-onderzoeken mogelijk maken. Low-code-platforms kunnen de digitale transformatie van een organisatie stimuleren, omdat de opgeleverde oplossingen begrijpelijk zijn voor niet-technische specialisten (en met name voor zakelijke gebruikers).
Als u krappe deadlines heeft, complexe zakelijke logica, een tekort aan technologische expertise en uw time to market wilt versnellen, dan is low-code een van de manieren om aan uw behoeften te voldoen.
Het is niet te ontkennen dat traditionele ontwikkelingshulpmiddelen belangrijk zijn, maar in veel gevallen is het toepassen van low-code-oplossingen de beste manier om de efficiëntie van de taken te verhogen.
Bron: habr.com
