

Steeds vaker ontvangen we verzoeken van klanten zoals: "We willen iets als Amazon RDS, maar goedkoper"; "We willen iets als RDS, maar overal, in elke infrastructuur". Om een soortgelijk managed-oplossing op Kubernetes te realiseren, hebben we gekeken naar de huidige staat van de meest populaire operators voor PostgreSQL (Stolon, operators van Crunchy Data en Zalando) en hebben we onze keuze gemaakt.
Dit artikel bevat onze ervaringen, zowel vanuit theoretisch perspectief (een overzicht van oplossingen) als vanuit praktisch perspectief (wat is gekozen en wat is daarvan het resultaat). Maar laten we eerst bepalen welke eisen er überhaupt worden gesteld aan een mogelijke vervanging van RDS…
Wat is RDS?
Wanneer mensen het over RDS hebben, bedoelen ze uit onze ervaring meestal een managed database service die:
- gemakkelijk te configureren is;
- de mogelijkheid heeft om met snapshots te werken en hieruit te herstellen (bij voorkeur met ondersteuning voor );
- de mogelijkheid biedt om master-slave topologieën te creëren;
- een rijke lijst van extensies biedt;
- audit en gebruikers-/toegangsbewaking verzorgt.
In het algemeen kunnen de benaderingen voor de uit te voeren taak behoorlijk verschillend zijn, maar de weg met een soortgelijke Ansible spreekt ons niet aan. (Collega's van 2GIS kwamen ook tot een vergelijkbare conclusie tijdens om "een hulpmiddel voor het snel implementeren van een failover-cluster op basis van Postgres" te creëren.)
Operators zijn de algemeen aanvaarde benadering voor het oplossen van dergelijke taken in het Kubernetes-ecosysteem. Meer over hen in relatie tot databases die binnen Kubernetes draaien, heeft technische directeur "Flanta" al verteld, , in .
NB: Voor het snel creëren van eenvoudige operators raden we aan om aandacht te besteden aan onze Open Source-tool . Hiermee kun je dit doen zonder kennis van Go, op manieren die meer vertrouwd zijn voor sysadmins: in Bash, Python, enz.
Voor PostgreSQL zijn er verschillende populaire K8s-operators:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Laten we ze eens nader bekijken.
De keuze van de operator
Naast de belangrijke mogelijkheden die hierboven zijn genoemd, hebben we - als infrastructuur engineers in Kubernetes - ook de volgende verwachtingen van operators gehad:
- deployment vanuit Git en met ;
- ondersteuning voor pod anti-affinity;
- installatie van node affinity of node selector;
- installatie van tolerations;
- aanwezigheid van tuningmogelijkheden;
- begrijpelijke technologieën en zelfs commando's.
Zonder in detail op elk van de punten in te gaan (vraag in de opmerkingen als er na het lezen van het artikel nog vragen zijn), wil ik in het algemeen opmerken dat deze parameters nodig zijn voor een fijnere beschrijving van de specialisatie van de clusterknopen, zodat we ze kunnen aanvragen voor specifieke applicaties. Zo kunnen we een optimale balans bereiken tussen prestaties en kosten.
Nu, naar de PostgreSQL-operators zelf.
1. Stolon
van het Italiaanse bedrijf Sorint.lab in werd beschouwd als een soort standaard onder operators voor databases. Dit is een vrij oud project: de eerste publieke release vond plaats in november 2015(!), en de GitHub-repo kan bogen op bijna 3000 sterren en 40+ bijdragers.
En inderdaad, Stolon is een uitstekend voorbeeld van doordachte architectuur:
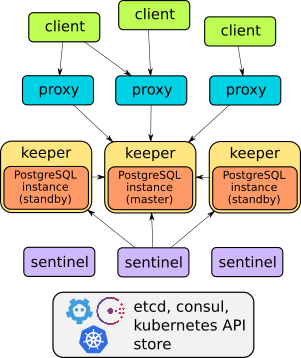
De details van deze operator zijn te vinden in het rapport of . In het algemeen is het voldoende om te zeggen dat hij alles kan wat beschreven is: failover, proxy voor transparante toegang voor klanten, back-ups... Bovendien bieden de proxies toegang via één service-eindpunt - in tegenstelling tot de twee andere oplossingen die verder worden besproken (die hebben twee services voor toegang tot de database).
Echter, Stolon , waardoor het niet mogelijk is om het zo te implementeren dat je eenvoudig en snel - "zoals warme broodjes" - database-exemplaren in Kubernetes kunt aanmaken. Beheer gebeurt via de tool stolonctl, implementatie - via een Helm-chart, en gebruikersdefinities worden vastgelegd in ConfigMap.
Aan de ene kant lijkt de operator niet echt een operator te zijn (want hij gebruikt geen CRD). Maar aan de andere kant is het een flexibel systeem dat je in staat stelt om bronnen in K8s zo in te stellen zoals jij dat wilt.
Samenvattend leek het voor ons niet optimaal om voor elke database een aparte chart aan te maken. Daarom gingen we op zoek naar alternatieven.
2. Crunchy Data PostgreSQL Operator
, een jonge Amerikaanse start-up, leek een logische alternatieve keuze. Zijn publieke geschiedenis begint met de eerste release in maart 2017, sindsdien heeft de GitHub-repo iets minder dan 1300 sterren en 50+ bijdragers gekregen. De laatste release van september is getest voor gebruik met Kubernetes 1.15—1.18, OpenShift 3.11+ en 4.4+, GKE en VMware Enterprise PKS 1.3+.
De architectuur van Crunchy Data PostgreSQL Operator voldoet ook aan de opgegeven eisen:
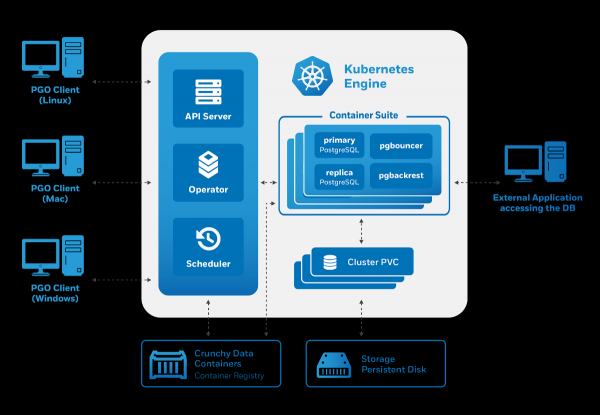
Beheer gebeurt via de tool pgo, maar het genereert op zijn beurt Custom Resources voor Kubernetes. Daarom was er goed nieuws voor ons als potentiële gebruikers van de operator:
- er is beheer via CRD;
- gemakkelijk gebruikersbeheer (ook via CRD);
- integratie met andere componenten — een gespecialiseerde verzameling containerafbeeldingen voor PostgreSQL en tools voor het werken ermee (inclusief pgBackRest, pgAudit, extensies uit contrib, enz.).
Echter, de pogingen om de operator van Crunchy Data te gebruiken hebben enkele problemen aan het licht gebracht:
- Er was geen mogelijkheid voor tolerances — alleen nodeSelector was beschikbaar.
- De gemaakte pod's waren deel van een Deployment, hoewel we een stateful-toepassing deponeerden. In tegenstelling tot StatefulSets kunnen Deployments geen schijven aanmaken.
Dit laatste gebrek leidt tot amusante momenten: op de testomgeving lukte het om 3 replica's met één schijf te draaien lokale opslag, waardoor de operator meldde dat 3 replica's actief waren (terwijl dat niet het geval was).
Een andere eigenschap van deze operator is de kant-en-klare integratie met verschillende ondersteunende systemen. Het is bijvoorbeeld eenvoudig om pgAdmin en pgBounce te installeren, en in overweegde voorgeconfigureerde Grafana en Prometheus. In de recente wordt de verbeterde integratie met het project , waardoor de operator een visuele weergave van de PgSQL-metrics 'out of the box' biedt.
Desondanks heeft de vreemde keuze van gegenereerde Kubernetes-resources ons gedwongen een andere oplossing te zoeken.
3. Zalando Postgres Operator
We zijn al lang bekend met de producten van Zalando: we hebben ervaring met Zalenium en natuurlijk hebben we geprobeerd — hun populaire HA-oplossing voor PostgreSQL. Over de aanpak van het bedrijf bij het creëren van vertelde een van de auteurs — Alexey Klyukin — tijdens de uitzending van , en we waren er meteen enthousiast over.
Dit is de meest recente oplossing in het artikel: de eerste release vond plaats in augustus 2018. Ondanks het geringe aantal formele releases is het project steeds verder gevorderd, en het heeft inmiddels het Crunchy Data-oplossing overtroffen met meer dan 1300 sterren op GitHub en het hoogste aantal bijdragers (meer dan 70).
‘Onder de motorkap’ van deze operator worden bewezen oplossingen gebruikt:
- Patroni en voor beheer,
- — voor back-ups,
- — als verbindingenpool.
Zo is de architectuur van de operator van Zalando gepresenteerd:
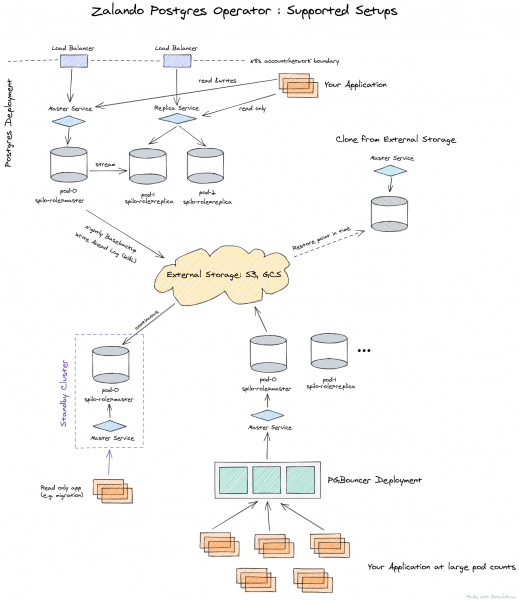
De operator wordt volledig beheerd via Custom Resources, maakt automatisch een StatefulSet van containers die vervolgens kunnen worden aangepast door verschillende sidecars aan de pod toe te voegen. Dit is een aanzienlijke plus ten opzichte van de operator van Crunchy Data.
Aangezien we de oplossing van Zalando hebben gekozen uit de 3 overwogen opties, volgt hieronder een beschrijving van de mogelijkheden, samen met de praktische toepassing.
Praktijk met Postgres Operator van Zalando
De deployment van de operator gebeurt heel eenvoudig: het enige wat je hoeft te doen is de actuele release van GitHub te downloaden en de YAML-bestanden uit de directory toe te passen. . Als alternatief kun je ook gebruikmaken van .
Na de installatie is het belangrijk om de . Dit gebeurt via ConfigMap postgres-operator in de namespace waar je de operator hebt geïnstalleerd. Zodra de opslag is ingesteld, kun je de eerste PostgreSQL-cluster implementeren.
Bijvoorbeeld, de standaard deployment ziet eruit als volgt:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Dit manifest implementeert een cluster van 3 exemplaren met een sidecar in de vorm van , waarvan we de statistieken van de applicatie ophalen. Zoals je ziet, is het heel eenvoudig, en als je wilt, kun je letterlijk een onbeperkt aantal clusters maken.
Het is ook de moeite waard om te wijzen op de webinterface voor administratie — . Deze wordt meegeleverd met de operator en stelt je in staat om clusters te creëren en te verwijderen, evenals te werken met de back-ups die de operator maakt.
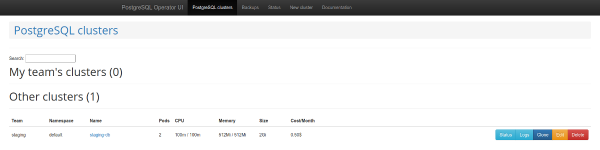
Lijst van PostgreSQL-clusters
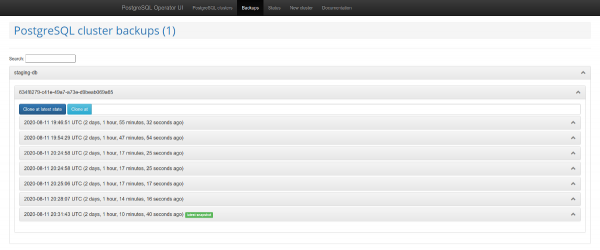
Beheer van back-ups
Een andere interessante functie is de ondersteuning van . Dit mechanisme creëert automatisch rollen in PostgreSQL, op basis van de ontvangen lijst van gebruikersnamen. Vervolgens kan de API een lijst van gebruikers teruggeven waarvoor automatisch rollen worden aangemaakt.
Problemen en oplossingen
Echter, het gebruik van de operator heeft al snel enkele significante nadelen aan het licht gebracht:
- gebrek aan ondersteuning voor nodeSelector;
- ongemak om back-ups uit te schakelen;
- bij het gebruik van de functie voor het aanmaken van databases verschijnen er geen standaardrechten;
- af en toe ontbreekt documentatie of is deze verouderd.
Gelukkig kunnen veel van deze problemen worden opgelost. Laten we beginnen met het einde — problemen met de documentatie.
Waarschijnlijk krijg je te maken met het feit dat het niet altijd duidelijk is hoe je een back-up opzet en hoe je de back-up bucket aan de Operator UI koppelt. Dit wordt slechts terloops in de documentatie genoemd, maar een echte beschrijving is te vinden in :
- het moet een geheim worden gemaakt;
- het aan de operator doorgeven als parameter
pod_environment_secret_namein de CRD met de instellingen van de operator of in de ConfigMap (afhankelijk van hoe je hebt besloten de operator te installeren).
Echter, zoals het blijkt, is het op dit moment onmogelijk. Daarom hebben we met enkele extra externe toevoegingen. Meer hierover — zie hieronder.
Als je parameters voor de back-up aan de operator doorgeeft, zoals wal_s3_bucket en toegangssleutels voor AWS S3, dan zal het alles back-uppen: niet alleen databases in productie, maar ook staging. Dit was niet acceptabel voor ons.
In de beschrijving van de parameters voor Spilo, dat de basis Docker-wrapping voor PgSQL is bij gebruik van de operator, bleek dat je de parameter WAL_S3_BUCKET leeg kunt doorgeven, waarmee de back-ups zijn uitgeschakeld. Bovendien, tot grote vreugde, is er ook , die we onmiddellijk hebben geaccepteerd in onze fork. Nu is het voldoende om eenvoudig enableWALArchiving: false toe te voegen aan de resource van de PostgreSQL-cluster.
Ja, het was mogelijk om het anders te doen door 2 operators te draaien: één voor staging (zonder back-ups), en de tweede voor productie. Maar zo konden we met één operator toe.
Oké, we hebben geleerd toegang tot databases voor S3 door te geven en de back-ups begonnen in de opslag terecht te komen. Hoe laten we de back-up pagina's in de Operator UI werken?
In de Operator UI moeten 3 variabelen worden toegevoegd:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Na dit alles zal het beheer van back-ups beschikbaar zijn, wat in ons geval het werken met staging vereenvoudigt, waardoor we snapshots van productie zonder extra scripts kunnen leveren.
Als nog een pluspunt werd het werken met de Teams API en de uitgebreide mogelijkheden voor het aanmaken van databases en rollen met behulp van de operator genoemd. Echter, de gemaakte rollen hadden geen standaardrechten. Dienovereenkomstig kon een gebruiker met leesrechten nieuwe tabellen niet lezen.
Waarom is dat zo? Ondanks het feit dat in de code de nodige GRANT, ze worden lang niet altijd toegepast. Er zijn 2 methoden: syncPreparedDatabases en syncDatabaseswordt een tabel met wijzigingen en instructies voor de overgang naar de nieuwe configuratie gegeven. Voor meer informatie, zie syncPreparedDatabases — ondanks dat in de sectie preparedDatabases er een voorwaarde is defaultRoles en defaultUsers voor het aanmaken van rollen, — de standaardrechten worden niet toegepast. We zijn bezig met het voorbereiden van een patch zodat deze rechten automatisch worden toegepast.
En het laatste punt in de relevante verbeteringen voor ons is — , die Node Affinity toevoegt aan de aangemaakte StatefulSet. Onze klanten geven er vaak de voorkeur aan om kosten te verlagen door spot-instanties te gebruiken, en het is duidelijk niet verstandig om databaseservices daarop te plaatsen. Dit probleem zou ook met tolerations opgelost kunnen worden, maar het hebben van Node Affinity biedt veel meer zekerheid.
Wat is het resultaat?
Als resultaat van de oplossing van de genoemde problemen hebben we de Postgres Operator van Zalando geforkt naar , waar hij wordt opgebouwd met deze nuttige patches. En voor extra gemak hebben we ook een .
Lijst van PR's die in de fork zijn geaccepteerd:
- ;
- ;
- ;
- .
Het zou geweldig zijn als de community deze PR's steunt, zodat ze in de upstream komen met de volgende versie van de operator (1.6).
Bonus! Succesverhaal over de migratie van productie
Als je Patroni gebruikt, kun je live productie met minimale downtime naar de operator migreren.
Spilo maakt het mogelijk om standby-clusters via S3-opslag te creëren met , wanneer de binaire log van PgSQL eerst in S3 wordt opgeslagen en vervolgens door een replica wordt opgehaald. Maar wat te doen als je niet Wal-E in de oude infrastructuur gebruikt? De oplossing voor dit probleem is al op Habré.
Logische replicatie PostgreSQL komt te hulp. Laten we echter niet ingaan op de details van hoe publicaties en abonnementen te maken, omdat… ons plan is mislukt.
Het probleem is dat er in de database verschillende zwaar belaste tabellen waren met miljoenen rijen, die bovendien voortdurend werden toegevoegd en verwijderd. met copy_data, wanneer een nieuwe replica alles kopieert van de master, kon simpelweg niet bijhouden met de master. Het kopiëren van de inhoud werkte een week, maar heeft de master nooit ingehaald. Uiteindelijk hielp een oplossing voor het probleem van collega's van Avito: je kunt de gegevens verplaatsen met pg_dump. Ik zal onze (licht aangepaste) versie van dit algoritme beschrijven.
Het idee is dat je een inactieve abonnement kunt maken, gekoppeld aan een specifieke replicatieslot, en vervolgens het transactienummer kunt aanpassen. Er waren replicas beschikbaar voor de productieomgeving. Dit is belangrijk omdat de replica zal helpen een consistente dump te creëren en doorgaan met het ontvangen van wijzigingen van de master.
In de volgende opdrachten, die het migratieproces beschrijven, zullen de volgende aanduidingen voor hosts worden gebruikt:
- master — de oorspronkelijke server;
- replica1 — streaming replica op de oude productie;
- replica2 — nieuwe logische replica.
Migratieplan
1. We zullen een abonnement maken op de master voor alle tabellen in het schema public van de database dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. We creëren een replicatieslot op de master:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. We stoppen de replicatie op de oude replica:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. We krijgen het transactienummer van de master:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. We maken een dump van de oude replica. We zullen dit in meerdere streams doen, wat het proces zal versnellen:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. We laden de dump op de nieuwe server:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Na het laden van de dump kan de replicatie op de streaming replica worden gestart:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. We creëren een abonnement op de nieuwe logische replica:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. We krijgen oid van het abonnement:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Stel dat we hebben gekregen oid=1000. We passen het transactienummer toe op het abonnement:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. We starten de replicatie:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. We controleren de status van het abonnement, de replicatie zou moeten werken:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Nadat de replicatie is gestart en de databases zijn gesynchroniseerd, kan de overstap worden gemaakt.
13. Na het uitschakelen van de replicatie moeten de sequences worden aangepast. Dit is goed beschreven .
Dankzij dit plan is de overstap met minimale vertragingen verlopen.
Conclusie
Kubernetes-operators maken verschillende acties eenvoudiger door ze te reduceren tot het creëren van K8s-resources. Echter, nadat mooie automatisering is bereikt, is het belangrijk te onthouden dat dit ook onverwachte nuances met zich mee kan brengen, dus kies wijs bij de selectie van operators.
Na het bekijken van de drie meest populaire Kubernetes-operators voor PostgreSQL, hebben we gekozen voor het project van Zalando. We zijn op bepaalde moeilijkheden gestuit, maar het resultaat was echt bevredigend, dus we zijn van plan deze ervaring ook op andere PgSQL-installaties uit te breiden. Als je ervaring hebt met vergelijkbare oplossingen, zouden we het leuk vinden om de details in de reacties te zien!
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
