

Drie jaar geleden presenteerden Viktor Tarnavski en Alexey Milovidov van Yandex op het podium HighLoad++ , hoe goed ClickHouse is en hoe soepel het werkt. Op het naastgelegen podium was Alexander Zaitsev met aan het praten over de overstap naar ClickHouse een andere analytische database en concludeerde dat ClickHouse, het is absoluut goed, maar niet heel gebruiksvriendelijk. Toen in 2016 het bedrijf LifeStreet, waar Alexander toen werkte, een multi-petabyte analytisch systeem migreerde naar ClickHouse, was het een boeiende 'zuidweg van de gele bakstenen', vol onbekende gevaren - ClickHouse toen deed het denken aan een mijnenveld.
Drie jaar later ClickHouse is het veel beter geworden - in die tijd richtte Alexander het bedrijf Altinity op, dat niet alleen helpt bij de overstap naar ClickHouse tientallen projecten, maar ook het product zelf verbetert samen met collega’s van Yandex. Nu ClickHouse is het nog steeds geen zorgeloze wandeling, maar ook geen mijnenveld meer.
Alexander houdt zich sinds 2003 bezig met gedistribueerde systemen en heeft grote projecten ontwikkeld met MySQL, Oracle en Vertica. Tijdens de afgelopen HighLoad++ 2019 deelde Alexander, een van de pioniers in het gebruik van ClickHouse, zijn inzichten over wat deze database tegenwoordig inhoudt. We leren over de belangrijkste kenmerken ClickHouse: wat maakt het anders dan andere systemen en in welke gevallen is het effectiever te gebruiken. Aan de hand van voorbeelden bekijken we recente en bewezen best practices voor het opbouwen van systemen gebaseerd op ClickHouse.
Terugblik: wat er drie jaar geleden was
Drie jaar geleden migreerden we het bedrijf LifeStreet en een werkende opdracht krijgen. ClickHouse van een andere analytische database, en de migratie van de analytics van het advertentienetwerk zag er als volgt uit:
- Juni 2016. In OpenSource De release van de definitieve versie van Microsoft Edge wordt dit jaar verwacht. Op dit moment gaat het om versies voor Windows 10 en macOS, maar in de toekomst wordt ook de komst van builds voor Windows 7/8/8.1 beloofd. Een build voor Linux is momenteel nog niet aangekondigd, maar die kan ook verwacht worden. ClickHouse begon ons project;
- Augustus. Proof Of Concept: een groot advertentienetwerk, infrastructuur en 200-300 terabyte gegevens;
- Oktober. Eerste productiegegevens;
- December. Volledige productbelasting - 10-50 miljard evenementen per dag.
- Juni 2017. Succesvolle migratie van gebruikers naar ClickHouse, 2,5 petabyte gegevens op een cluster van 60 servers.
Tijdens het migratieproces groeide het begrip dat ClickHouse een goed systeem is waarmee je fijn kunt werken, maar het is een intern project van Yandex. Daarom zijn er nuances: Yandex zal eerst zijn interne klanten bedienen en pas daarna de externe gemeenschap en de behoeften van externe gebruikers, terwijl ClickHouse op dat moment niet voldeed aan de enterprise-normen in veel functionele gebieden. Daarom richtten we in maart 2017 het bedrijf Altinity op om te doen ClickHouse nog sneller en handiger, niet alleen voor Yandex, maar ook voor andere gebruikers. En nu zijn we:
- Opleiden en helpen bij het bouwen van oplossingen op ClickHouse zodat klanten geen fouten maken en de oplossing uiteindelijk werkt;
- Bieden 24/7 ondersteuning ClickHouse-instellingen;
- Ontwikkelen onze eigen ecosysteemprojecten;
- Actief bij het verbeteren van de software ClickHouse, in antwoord op de verzoeken van gebruikers die bepaalde functies willen zien.
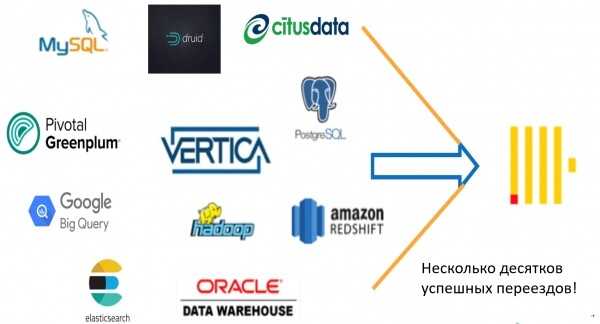
En natuurlijk helpen we bij de migratie naar ClickHouse met MySQL, Vertica, Oracle, Greenplum, Redshift en andere systemen. We hebben deelgenomen aan verschillende migraties, en ze waren allemaal succesvol.
Waarom eigenlijk migreren naar ClickHouse
Het vertraagt niet! Dat is de belangrijkste reden. ClickHouse — een zeer snelle database voor verschillende scenario's:
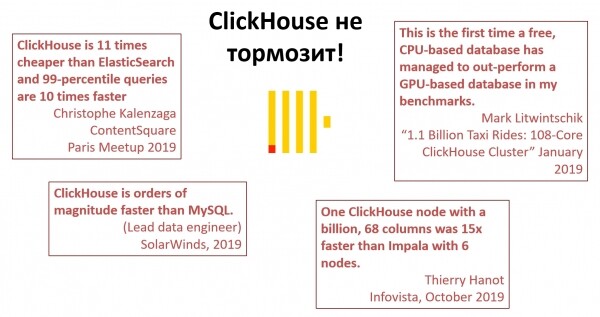
Willekeurige citaten van mensen die lang met ClickHouse.
Schaalbaarheid. Met een andere DB kun je behoorlijke prestaties behalen op één machine, maar ClickHouse kun je zowel verticaal als horizontaal schalen door simpelweg servers toe te voegen. Het werkt niet altijd zo soepel als gewenst, maar het werkt. Je kunt het systeem laten groeien met de groei van het bedrijf. Het is belangrijk dat we nu niet beperkt zijn door de oplossing en altijd potentieel voor ontwikkeling hebben.
Draagbaarheid. Er is geen vastlegging aan iets specifieks. Bijvoorbeeld, met Amazon Redshift is het moeilijk om ergens heen te verhuizen. Maar ClickHouse kan je op je laptop, server installeren, in de cloud implementeren, of migreer naar Kubernetes — er zijn geen beperkingen op het gebruik van infrastructuur. Dit is handig voor iedereen en het is een groot voordeel dat veel andere vergelijkbare databases niet kunnen bieden.
Flexibiliteit. ClickHouse staat niet stil bij één ding, zoals Yandex.Metrica, maar ontwikkelt zich en wordt in steeds meer verschillende projecten en industrieën gebruikt. Het kan worden uitgebreid door nieuwe mogelijkheden toe te voegen voor nieuwe taken. Bijvoorbeeld, het wordt als een slechte gewoonte beschouwd om logs in een database te bewaren, daarom werden er voor dit doel Elasticsearchbedacht. Maar dankzij de flexibiliteit van ClickHousekun je ook logs daarin opslaan, en vaak is het zelfs beter dan in Elasticsearch — tot ClickHouse hiervoor is 10 keer minder hardware nodig.
Gratis Open Source. Je hoeft nergens voor te betalen. Je hoeft geen toestemming te vragen om het systeem op je laptop of server te installeren. Er zijn geen verborgen kosten. En geen enkele andere open source database technologie kan concurreren met de snelheid van ClickHouse. MySQL, MariaDB, Greenplum — zij zijn allemaal veel langzamer.
Gemeenschap, energie en fun. Het ClickHouse heeft een geweldige gemeenschap: meetups, chats en Alexey Milovidov, die ons allemaal opvijzelt met zijn energie en optimisme.
Overstappen naar ClickHouse
Om over te stappen naar ClickHouse iets anders heb je slechts drie dingen nodig:
- Begrijp de beperkingen ClickHouse en waarvoor het niet geschikt is.
- Maak gebruik van de voordelen van de technologie en haar sterkste punten.
- Experimenteer. Zelfs als je begrijpt hoe het werkt, ClickHouseis het niet altijd mogelijk te voorspellen wanneer het sneller, langzamer, beter of slechter is. Dus probeer het uit.
Het probleem van de overstap
Er is maar één 'maar': als je overstapt van ClickHouse iets anders gaat meestal iets mis. We zijn gewend aan bepaalde praktijken en dingen die werken in onze favoriete DB. Bijvoorbeeld, iedereen die met SQL-databases werkt, beschouwt een set functies als essentieel:
- transacties;
- restricties;
- consistentie;
- indexen;
- UPDATE/DELETE;;
- NULLs;;
- milliseconden;
- automatische type-conversies;
- meervoudige joins;
- arbitraire partitionering;
- clustermanagementtools.
Die set is verplicht, maar drie jaar geleden had ClickHouse geen van deze functies! Nu is minder dan de helft van de ongeëiste functies over: transacties, restricties, consistentie, milliseconden en type-conversies.
En het belangrijkste is dat sommige standaardpraktijken en benaderingen niet werken of anders werken dan we gewend zijn. Alles wat in ClickHouse verschijnt, volgt de 'ClickHouse manier', ClickHousewat betekent dat functies anders zijn dan in andere databases. Bijvoorbeeld:Indexen worden niet geselecteerd, maar overgeslagen.zijn niet synchroon, maar asynchroon.
- Meervoudige joins zijn aanwezig, maar er is geen query planner. Hoe deze dan worden uitgevoerd, is voor mensen uit de database-wereld niet helemaal duidelijk.
- UPDATE/DELETE; ClickHouse scenario's
- In 1960 schreef de Amerikaanse wiskundige van Hongaarse afkomst
Wigner E. P.
een artikel getiteld 'De onredelijke effectiviteit van wiskunde in de natuurwetenschappen' over het feit dat de omgeving om ons heen om een of andere reden goed wordt beschreven door wiskundige wetten. Wiskunde is een abstracte wetenschap, en de fysieke wetten uitgedrukt in wiskundige vorm zijn niet triviaal, en benoemde het feit dat dit heel vreemd is. Vanuit mijn perspectief iszo'n vreemdheid. Herformulerend wat Wigner zei, kun je zeggen: de onwaarschijnlijke effectiviteit isin de meest diverse analytische toepassingen! benoemde het feit dat dit heel vreemd is. Neem bijvoorbeeld
Real-Time Data Warehouse, ClickHouse waar gegevens vrijwel continu worden geladen. We willen queries met een vertraging van een seconde ontvangen. Alsjeblieft - we gebruiken ClickHouse in de meest diverse analytische toepassingen!
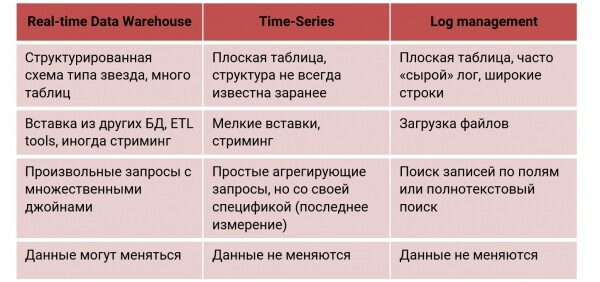
Neem bijvoorbeeld Real-Time Data Warehouse, waarin gegevens vrijwel continu worden geladen. We willen verzoeken met een vertraging van een seconde ontvangen. Alstublieft — laten we gebruiken ClickHouse, omdat dit scenario hiervoor is ontwikkeld. ClickHouse dit wordt niet alleen in webtoepassingen gebruikt, maar ook in marketing en financiële analyse, AdTech, evenals in Fraud detection. In Real-time Data Warehouse wordt een complexe gestructureerde indeling van het type ‘ster’ of ‘sneeuwvlok’ gebruikt, met veel tabellen en JOIN (soms meerdere), en gegevens worden meestal opgeslagen en gewijzigd in bepaalde systemen.
Laten we een ander scenario nemen — Time Series: apparaatmonitoring, netwerken, gebruiksstatistieken, internet der dingen. Hier komen we eenvoudige, in de tijd geordende gebeurtenissen tegen. ClickHouse dit was niet oorspronkelijk ontwikkeld, maar functioneert goed, daarom gebruiken grote bedrijven ClickHouse het als opslag voor monitoringinformatie. Om te onderzoeken of ClickHouse geschikt is voor time-series, hebben we een benchmark uitgevoerd op basis van de aanpak en de resultaten InfluxDB en TimescaleDB — gespecialiseerde time-series databases. , dat ClickHouse, zelfs zonder optimalisatie voor dergelijke taken, presteert goed op het eigen terrein:
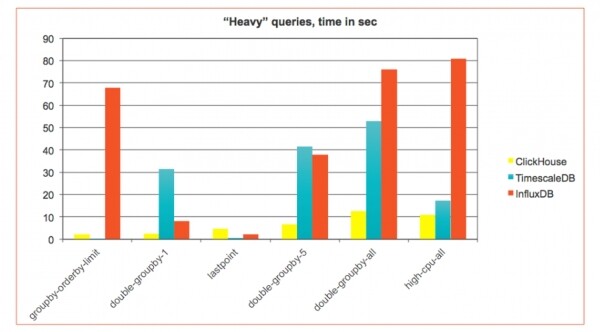
In time-series normaal gesproken wordt een smalle tabel gebruikt — enkele kleine kolommen. Van monitoring kunnen zeer grote hoeveelheden gegevens komen — miljoenen records per seconde — en deze komen meestal in kleine inserts (real-time streaming). Daarom is een ander insert-scenario nodig, en de query's hebben hun eigen specificiteit.
Log Management. Het verzamelen van logs in een database is meestal niet ideaal, maar in ClickHouse is dit mogelijk met enkele kanttekeningen, zoals hierboven beschreven. Veel bedrijven gebruiken ClickHouse precies hiervoor. In dit geval wordt een platte, brede tabel gebruikt, waarin we de logs in hun geheel opslaan (bijvoorbeeld in de vorm van of een ander formaat.), of we snijden in stukken. Gegevens worden meestal in grote batches (bestanden) geladen, en we zoeken op een bepaald veld.
Voor elke van deze functies worden meestal gespecialiseerde databases gebruikt. ClickHouse één kan dit alles doen en dat zo goed dat hij ze overtreft in prestaties. Laten we nu gedetailleerd kijken naar time-series het scenario, en hoe we het goed ‘voorbereiden’ ClickHouse voor dit scenario.
Time-Series
Op dit moment is dit het belangrijkste scenario waarvoor ClickHouse wordt beschouwd als de standaardoplossing. Time-series is een reeks in de tijd geordende gebeurtenissen die de veranderingen in een proces over de tijd weergeven. Dit kan bijvoorbeeld de hartslag gedurende een dag zijn of het aantal processen in een systeem. Alles wat tijdstempels geeft met enige metingen – dit is time-series:
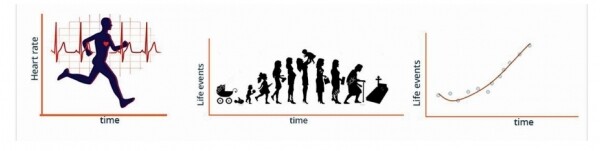
De meeste van dit soort gebeurtenissen komen uit monitoring. Dit kan niet alleen webmonitoring zijn, maar ook echte apparaten: auto's, industriële systemen, IoT, productie of onbemande taxi's, waarvan Yandex nu al ClickHouse-servers in de kofferbak plaatst.
Bijvoorbeeld, er zijn bedrijven die gegevens verzamelen van schepen. Elke paar seconden sturen sensoren van een containerschip honderden verschillende metingen. Ingenieurs bestuderen deze, bouwen modellen en proberen te begrijpen hoe efficiënt het schip wordt gebruikt, omdat een containerschip geen seconde stil moet liggen. Elke stilstand is een verlies van geld, daarom is het belangrijk om de route zo te voorspellen dat de tussenstops minimaal zijn.
Er is momenteel een groei te zien in gespecialiseerde databases die meten time-series. Op de website DB-Engines op een bepaalde manier verschillende databases rangschikken, en deze kunnen worden bekeken op types:
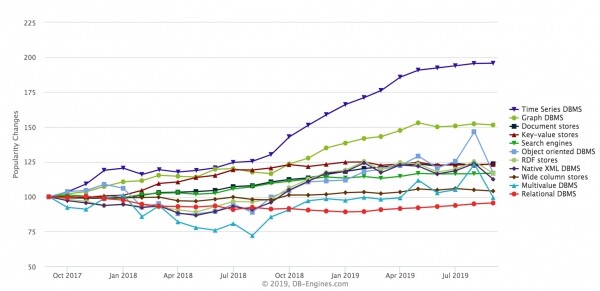
Het snelst groeiende type is time-seriesdatabases. Grafische databases groeien ook, maar time-seriesgroeien sneller in de afgelopen jaren. Typische vertegenwoordigers van dit databasefamilie zijn InfluxDB, Prometheus, KDB, TimescaleDB (gebouwd op PostgreSQL), oplossingen van Amazon. ClickHouse hier kan ook worden gebruikt, en dat wordt aangeboord. Ik geef enkele publieke voorbeelden.
Een van de pioniers is het bedrijf CloudFlare (CDN-provider). Ze monitoren hun CDN door ClickHouse (DNS-verzoeken, HTTP-verzoeken) met een enorme belasting — 6 miljoen gebeurtenissen per seconde. Alles gaat via Kafka, wordt verzonden naar ClickHouse, dat de mogelijkheid biedt om in real-time dashboards van gebeurtenissen in het systeem te zien.
Comcast is een van de leiders in de telecommunicatie in de VS: internet, digitale televisie, telefonie. Ze hebben een soortgelijk managementsysteem gecreëerd CDN binnen Open Source van het project Apache Traffic Control voor het werken met hun enorme gegevens. ClickHouse wordt gebruikt als backend voor analytics.
Percona hebben ze ingebouwd ClickHouse in hun PMM, om monitoring van verschillende MySQL.
Specifieke vereisten
Time-series databases hebben hun specifieke vereisten.
- Snelle invoer van meerdere agenten.We moeten gegevens zeer snel invoeren vanuit meerdere stromen. ClickHouse dit doet het goed, omdat het geen blokkerende invoer heeft. Elke insert is een nieuw bestand op de schijf, en kleine invoeren kunnen op de een of andere manier worden gebufferd. In ClickHouse het is beter om gegevens in grote pakketten in te voeren, en niet regel voor regel.
- Flexibel schemawordt een tabel met wijzigingen en instructies voor de overgang naar de nieuwe configuratie gegeven. Voor meer informatie, zie time-series We usually do not know the data structure completely. A monitoring system can be built for a specific application, but it becomes difficult to use for another application. A more flexible scheme is needed for this. ClickHouse, this allows for that to happen, even though it is a strictly typed database.
- Efficient storage and 'forgetting' of data. Usually in time-series the massive amount of data, so they need to be stored as efficiently as possible. For example, a InfluxDB good compression is its main feature. But besides storage, it is also necessary to be able to 'forget' old data and do some kind of downsampling — automatic aggregation counting.
- Fast queries for aggregated data. Sometimes it is interesting to look at the last 5 minutes with millisecond precision, but with monthly data, minute or second granularity may not be needed — general statistics are sufficient. Support for this kind of functionality is essential; otherwise, a query over 3 months will take a very long time, even in ClickHouse.
- Queries like 'last point, as of». These are typical time-series queries: we are looking at the last measurement or the state of the system at a certain point in time t. For databases, these are not very pleasant queries, but they also need to be executable.
- 'Merging' time series. Time-series — this is a time series. If there are two time series, they often need to be combined and correlated. Not all databases make this convenient, especially with unaligned time series: here — one time stamp, there — another. Averages can be calculated, but there might still be gaps, thus it's unclear.
Let's examine how these requirements are met in ClickHouse.
Schema
In ClickHouse the scheme for time-series can be done in various ways, depending on the degree of regularity of the data. A system can be built on regular data when we know all the metrics in advance. For instance, this is how CloudFlare with monitoring CDN — this is a well-optimized system. A more general system can be built that monitors the entire infrastructure, various services. In the case of irregular data, we do not know in advance what we are monitoring — and probably this is the most general case.
Regular data. Columns. The scheme is simple - columns with the required types:
CREËER TABEL cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* join to dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Dit is een gewone tabel die enige activiteit met betrekking tot de systeembelasting monitort (gebruiker, system, idle, nice). Eenvoudig en handig, maar niet flexibel. Als we een flexibelere schema willen, kunnen we arrays gebruiken.
Onregelmatige gegevens. Arrays:
CREËER TABEL cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Structuur Genest — dit zijn twee arrays: metrics.name en metrics.value. Hier kunnen zulk willekeurig monitoringsgegevens worden opgeslagen, zoals een array van namen en een array van waarden bij elk evenement. Voor verdere optimalisatie kan in plaats van één dergelijke structuur meerdere worden gemaakt. Bijvoorbeeld één voor float-waarde, de andere voor int-waarde, omdat int we het efficiënter willen opslaan.
Maar het is moeilijker om met een dergelijke structuur om te gaan. We moeten een speciale constructie gebruiken, en met speciale functies de waarden eerst uit de index en daarna uit de array halen:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...Maar het werkt nog steeds vrij snel. Een andere manier om onregelmatige gegevens op te slaan – via rijen.
Onregelmatige gegevens. Rijen. In deze traditionele methode zonder arrays worden onmiddellijk namen en waarden opgeslagen. Als er in één keer 5.000 metingen van één apparaat komen – worden er 5.000 rijen in de database gegenereerd:
CREËER TABEL cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FROM cpu_r
WHERE metric_name IN ('usage_user', ...)
ClickHouse dit kan ermee omgaan – het heeft speciale extensies ClickHouse SQL. Bijvoorbeeld, maxIf – is een speciale functie die de maximumwaarde per metriek berekent onder een bepaalde voorwaarde. Je kunt in één query meerdere van zulke uitdrukkingen schrijven en meteen de waarde voor meerdere metriken berekenen.
Laten we drie benaderingen vergelijken:
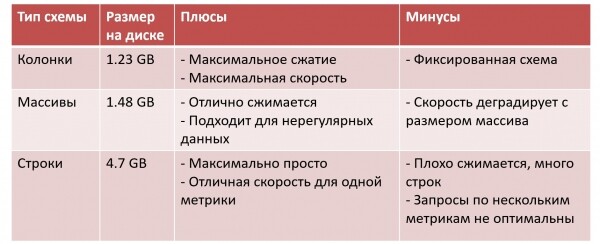
Hier heb ik de 'Grootte van gegevens op schijf' toegevoegd voor een bepaalde dataset. Bij kolommen hebben we de kleinste datagrootte: maximale compressie, maximale query-snelheid, maar dat betekent dat we meteen alles moeten fixeren.
Bij arrays is het iets minder gunstig. Gegevens kunnen nog steeds goed worden gecomprimeerd en we kunnen een onregelmatig schema opslaan. Maar ClickHouse — een kolomgeoriënteerde database, en wanneer we alles in een array gaan opslaan, wordt het een rijgeoriënteerde database, en betalen we voor flexibiliteit met efficiëntie. Voor elke bewerking moet de hele array in het geheugen worden geladen, waarna we het juiste element moeten zoeken – en als de array groeit, degradeert de snelheid.
In een van de bedrijven dat deze aanpak gebruikt (bijvoorbeeld, ), worden arrays in stukjes van 128 elementen gesneden. Gegevens van enkele duizenden metrics, met 200 TB gegevens per dag, worden niet in één array opgeslagen, maar in 10 of 30 arrays met speciale logica voor opslag.
De meest eenvoudige aanpak is met rijen. Maar gegevens worden slecht gecomprimeerd, de tabelgrootte wordt groot, en wanneer queries over meerdere metrics gaan, werkt ClickHouse suboptimaal.
Hybride schema
Laten we aannemen dat we een schema met een array hebben gekozen. Maar als we weten dat de meeste van onze dashboards alleen metrics voor user en system laten zien, kunnen we deze metrics op tabelniveau uit de array materialiseren in kolommen, op de volgende manier:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Bij het invoegen ClickHouse wordt het automatisch berekend. Zo kunnen we het aangename met het nuttige combineren: het schema is flexibel en algemeen, maar de meest gebruikte kolommen hebben we eruit gehaald. Ik wil opmerken dat dit geen wijzigingen in de invoeging vereiste, en ETL, dat doorgaat met het invoegen van arrays in de tabel. We hebben gewoon ALTER TABLE, een paar kolommen toegevoegd en zo ontstond er een hybride en snellere schema die meteen kan worden gebruikt.
Codecs en compressie
Voor time-series het is belangrijk hoe goed je de gegevens verpakt, omdat de array met informatie erg groot kan zijn. In ClickHouse er is een set instrumenten voor het bereiken van een compressieverhouding van 1:10, 1:20, en soms zelfs meer. Dit betekent dat niet-gecomprimeerde gegevens van 1 TB op schijf 50-100 GB innemen. Een kleinere grootte is goed, de gegevens kunnen sneller worden gelezen en verwerkt.
Om een hoog niveau van compressie te bereiken, ClickHouse ondersteunt de volgende codecs:
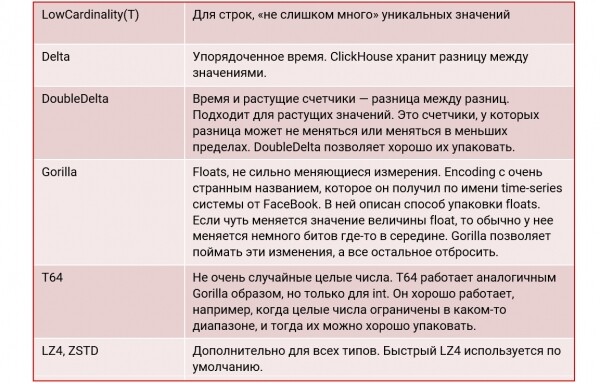
Voorbeeld van een tabel:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Hier definiëren we de codec DoubleDelta in één geval, en in de andere — Gorilla, en we voegen zeker nog LZ4 compressie toe. Als resultaat wordt de omvang van de gegevens op schijf aanzienlijk verminderd:
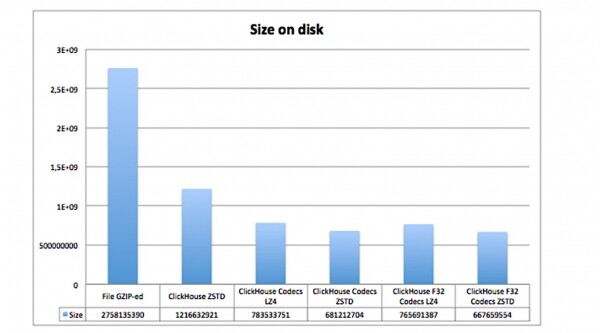
Hier wordt weergegeven hoeveel ruimte dezelfde gegevens in beslag nemen, maar met verschillende codecs en compressies:
- in een GZIP-bestand op schijf;
- in ClickHouse zonder codecs, maar met ZSTD-compressie;
- in ClickHouse met codecs en compressie LZ4 en ZSTD.
Het is duidelijk dat tabellen met codecs veel minder ruimte innemen.
Grootte doet er toe
Even belangrijk is het juiste datatypes:
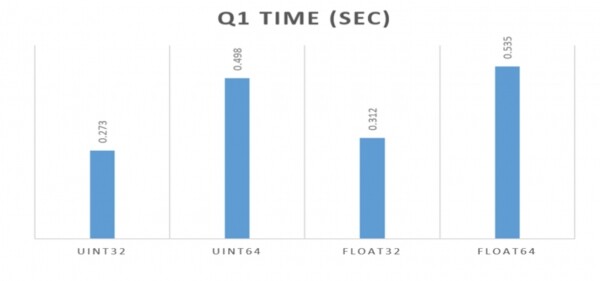
In alle bovenstaande voorbeelden heb ik gebruikt Float64. Maar als we zouden kiezen voor Float32, dan zou dat zelfs nog beter zijn. Dit werd goed geïllustreerd door de jongens van Percona in het artikel in de bovenstaande link. Het is belangrijk om het meest compacte type te gebruiken dat geschikt is voor de taak: zelfs in mindere mate voor de grootte op schijf dan voor de snelheid van aanvragen. ClickHouse is hier zeer gevoelig voor.
Als je int32 in plaats van int64, verwacht dan een bijna verdubbeling van de prestaties. Gegevens nemen minder geheugen in beslag en alle 'rekenkunde' werkt veel sneller. ClickHouse binnen in een zeer streng getypeerd systeem, benut het maximaal alle mogelijkheden die moderne systemen bieden.
Aggregatie en Materialized Views
Aggregatie en materialized views maken het mogelijk om aggregaten te maken voor verschillende situaties:
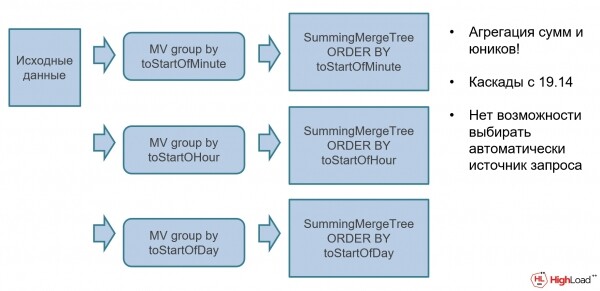
Bijvoorbeeld, je kunt ongewijzigde oorspronkelijke gegevens hebben, en daarop kunnen verschillende materialized views worden gelegd met automatische summatie via een speciale engine SummingMergeTree (SMT). SMT — dit is een speciale aggregatiestructuur die automatisch aggregaten berekent. Rauwe gegevens worden in de database ingevoerd, ze worden automatisch geaggregeerd, en dashboards kunnen onmiddellijk worden gebruikt.
TTL — we 'vergeten' oude gegevens
Hoe 'vergeten' we gegevens die niet meer nodig zijn? ClickHouse kan dit. Bij het maken van tabellen kan je aangeven TTL uitdrukkingen: bijvoorbeeld dat we minutengegevens één dag opslaan, dagelijkse gegevens 30 dagen, terwijl wekelijkse of maandelijkse gegevens nooit worden aangeraakt:
CREATE TABLE aggr_by_minute
…
TTL tijd + interval 1 dag

CREATE TABLE aggr_by_day
…
TTL tijd + interval 30 dagen

CREATE TABLE aggr_by_week
…
/* geen TTL */
Multi-tier — we splitsen gegevens over schijven
Door dit idee verder te ontwikkelen, kunnen gegevens worden opgeslagen in ClickHouse verschillende locaties. Stel dat we de hete gegevens van de afgelopen week op een zeer snelle lokale SSD, maar meer historische gegevens gaan we op een andere plek opslaan. In ClickHouse is dit nu mogelijk:
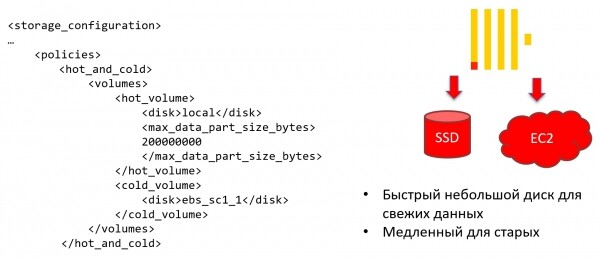
Het is mogelijk om een opslagbeleid (storage policy) te configureren zodat ClickHouse gegevens automatisch worden verplaatst zodra aan bepaalde voorwaarden is voldaan.
Maar dat is nog niet alles. Op het niveau van een specifieke tabel kunnen regels worden gedefinieerd wanneer gegevens precies naar koude opslag gaan. Bijvoorbeeld, 7 dagen blijven gegevens op een zeer snelle schijf, en alles wat ouder is, wordt naar een langzamere schijf verplaatst. Dit is goed omdat het het systeem maximale prestaties laat behouden, terwijl ook de kosten worden gecontroleerd en geen middelen aan koude gegevens worden uitgegeven:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Unieke mogelijkheden ClickHouse
Bijna alles in ClickHouse heeft dergelijke 'speciale kenmerken', maar deze worden gecompenseerd door de exclusiviteit — datgene wat niet in andere databases aanwezig is. Bijvoorbeeld, hier zijn enkele unieke functies ClickHouse:
- Arrayswordt een tabel met wijzigingen en instructies voor de overgang naar de nieuwe configuratie gegeven. Voor meer informatie, zie ClickHouse zeer goede ondersteuning voor arrays, evenals de mogelijkheid om complexe berekeningen op hen uit te voeren.
- Aggregatiestructuren. Dit is een van de 'killer features' ClickHouse. Ondanks dat de jongens van Yandex zeggen dat we geen gegevens willen aggregeren, aggregeren toch iedereen in ClickHouse, omdat het snel en comfortabel is.
- Gegevensmateriaaliseerde weergaven. Samen met aggregatiestructuren maken gegevensmateriaaliseerde weergaven een gemakkelijke real-time aggregatie mogelijk.
- ClickHouse SQL. Dit is een uitbreiding van de taal SQL met enkele extra en exclusieve functies die alleen aanwezig zijn in ClickHouseVroeger was het zowel een uitbreiding als een nadeel. Tegenwoordig hebben we bijna alle nadelen vergeleken met SQL 92 we verwijderd, nu is het alleen maar een uitbreiding.
- Lambda-uitdrukkingen. Zijn ze er ook in andere databases?
- ML-ondersteuning. Dit is beschikbaar in verschillende databases, bij sommige beter dan bij andere.
- Open code. We kunnen uitbreiden ClickHouse samen. Momenteel zijn er ClickHouse ongeveer 500 bijdragers, en dat aantal groeit voortdurend.
Slimme query's
In ClickHouse er zijn veel verschillende manieren om hetzelfde te doen. Bijvoorbeeld, je kunt op drie verschillende manieren de laatste waarde uit een tabel halen voor CPU (er is een vierde manier, maar die is zelfs nog excentrieker).
De eerste toont hoe handig het is om in ClickHouse query's te werken, wanneer je wilt controleren wat tuple aanwezig is in een subquery. Dit is iets dat ik persoonlijk in andere databases miste. Als ik iets wil vergelijken met een subquery, kan ik in andere databases alleen met een scalar vergelijken, en voor meerdere kolommen moet ik schrijven JOINwordt een tabel met wijzigingen en instructies voor de overgang naar de nieuwe configuratie gegeven. Voor meer informatie, zie ClickHouse je kunt tuple gebruiken:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
De tweede manier doet hetzelfde, maar gebruikt de aggregatiefunctie argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
In ClickHouse er zijn enkele tientallen aggregatiefuncties, en als je combinatoren gebruikt, dan zijn er volgens de combinatoriek zo'n duizend. ArgMax - een van de functies die de maximale waarde berekent: de query retourneert de waarde van usage_user, waarop de maximale waarde wordt bereikt. created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
ASOF JOIN - het 'samenvoegen' van rijen met verschillende tijdstippen. Dit is een unieke functie voor databases, die alleen ook in kdb+beschikbaar is. Als er twee tijdreeksen zijn met verschillende tijdstippen, ASOF JOIN maakt het mogelijk deze te verschuiven en in één query samen te voegen. Voor elke waarde in de ene tijdreeks wordt de dichtstbijzijnde waarde in de andere gezocht, en ze worden op één regel geretourneerd:
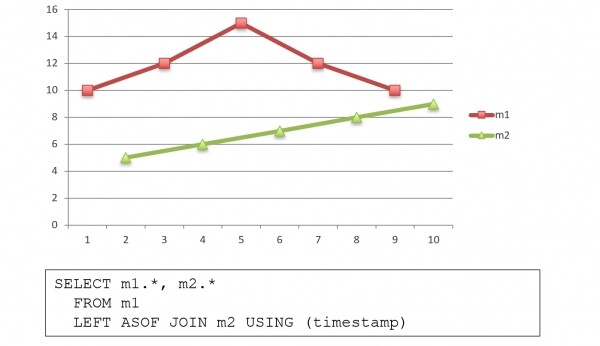
Analytische functies
In de standaard SQL-2003 kun je zo schrijven:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
In ClickHouse maar dat kan niet — het ondersteunt de standaard niet SQL-2003 en zal dat waarschijnlijk ook nooit doen. In plaats daarvan in ClickHouse het is gebruikelijk om het zo te schrijven:
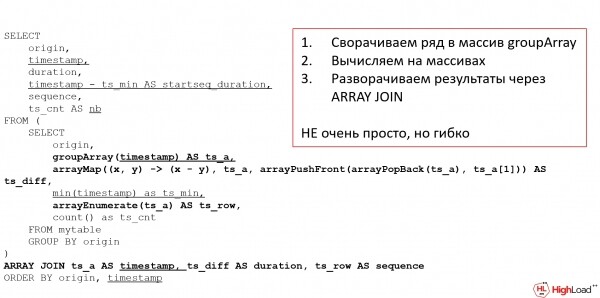
Ik beloofde lambda's - hier zijn ze!
Dit is analoog aan de analytische query in de standaard SQL-2003: het berekent het verschil tussen twee timestamp, duur, volgnummer - alles wat we normaal beschouwen als analytische functies. In ClickHouse beschouwen we ze via arrays: eerst aggregaten we de gegevens in een array, daarna doen we alles wat we willen met de array, en daarna transformerend we terug. Dit is niet erg handig, vereist liefde voor functionele programmering op zijn minst, maar het is heel flexibel.
Speciale functies
Bovendien zijn er in ClickHouse veel gespecialiseerde functies. Bijvoorbeeld, hoe bepaal je hoeveel sessies tegelijkertijd plaatsvinden? Een typische monitoringtaak is het bepalen van de maximale belasting met één query. In ClickHouse is er een speciale functie voor dit doel:
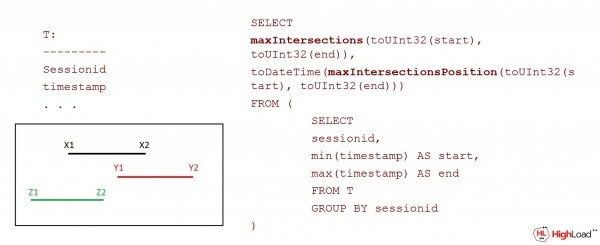
In feite zijn er voor veel doeleinden in ClickHouse speciale functies:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Dit is geen volledige lijst van functies, er zijn er in totaal 500-600. Hint: alle functies in ClickHouse zijn te vinden in de systeemtabel (niet allemaal gedocumenteerd, maar allemaal interessant):
select * from system.functions order by nameClickHouse zelf bevat veel informatie over zichzelf, inclusief log tabellen, query_log, trace log, log van datablokoperaties (part_log), log van metriek, en het systeem log, dat meestal op schijf wordt geschreven. Het metriek log is time-series in ClickHouse in feite ClickHouse: de database kan zelf als time-series databases fungeren, en ‘‘op deze manier zichzelf opslokken’’.
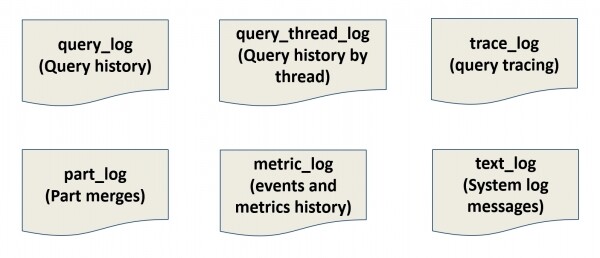
Dit is ook een unieke zaak - als we goed werk verrichten voor time-series, waarom kunnen we niet alles wat nodig is zelf opslaan? We hebben geen Prometheus, we slaan alles in onszelf op. We hebben Grafana aangesloten en monitoren onszelf. Echter, als ClickHouse valt, dan zien we niet waarom - daarom wordt het meestal niet zo gedaan.
Een grote cluster of veel kleine ClickHouse
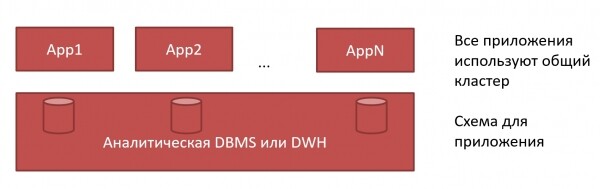
Wat is beter - één grote cluster of veel kleine ClickHouse? De traditionele benadering voor DWH is een grote cluster, waarin schema's voor elke applicatie worden toegewezen. We kwamen naar de databasebeheerder - geef ons een schema, en het werd ons gegeven:
In ClickHouse dit kan anders. We kunnen voor elke applicatie een eigen ClickHouse:
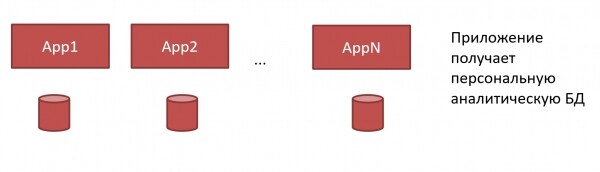
We hebben geen grote monsterachtige DWH en stugge beheerders meer nodig. We kunnen elke applicatie zijn eigen ClickHousegeven, en de ontwikkelaar kan dit zelf doen, omdat ClickHouse heel eenvoudig te installeren en vereist geen ingewikkeld beheer:
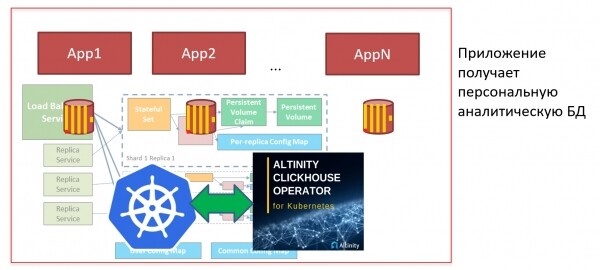
Maar als we veel hebben ClickHouse, en het vaak moet installeren, wil ik dit proces automatiseren. Bijvoorbeeld, we gebruiken Kubernetes en clickhouse-operator. In Kubernetes ClickHouse kun je het "met één klik" installeren: ik kan op een knop drukken, een manifest starten en de database is klaar. Ik kan meteen een schema aanmaken, beginnen met het laden van metrics, en binnen 5 minuten heb ik al een dashboard klaar Grafana. Zo eenvoudig is alles!
Wat is het resultaat?
So, ClickHouse is:
- Snel. Dit is algemeen bekend.
- Gewoon. Een beetje discutabel, maar ik geloof dat moeilijk leren, gemakkelijk vechten betekent. Als je begrijpt hoe ClickHouse het werkt, dan is alles verder heel eenvoudig.
- Universeel. Het is geschikt voor verschillende scenario's: DWH, Tijdreeksen, Logopslag. Maar het is geen OLTP database, dus probeer geen korte invoeringen en lezingen te doen.
- Interessant. Waarschijnlijk heeft degene die werkt met ClickHouse, veel interessante momenten meegemaakt, zowel goed als slecht. Bijvoorbeeld, er kwam een nieuwe release uit, alles stopte met werken. Of als je twee dagen aan een taak werkte, maar na een vraag in een Telegram-chat was de taak binnen twee minuten opgelost. Of zoals op de conferentie tijdens de presentatie van Alexey Milovidov een screenshot uit ClickHouse de uitzending verstoorde HighLoad++. Dit soort dingen gebeurt voortdurend en maakt ons leven met ClickHouse helder en interessant!
De presentatie is beschikbaar om te bekijken .
De langverwachte ontmoeting van ontwikkelaars van hoogbelaste systemen op zal plaatsvinden op 9 en 10 november in Skolkovo. Eindelijk zal het een offline-conferentie zijn (hoewel met inachtneming van alle veiligheidsmaatregelen), want de energie van HighLoad++ kan niet online worden verpakt.
Voor de conferentie vinden we en tonen we u cases over de maximale mogelijkheden van technologieën: HighLoad++ was, is en zal de enige plek zijn waar je in twee dagen kunt leren hoe Facebook, Yandex, VKontakte, Google en Amazon zijn georganiseerd.
Met onze vergaderingen zonder onderbrekingen sinds 2007, ontmoeten we elkaar dit jaar voor de 14e keer. In die tijd is de conferentie 10 keer gegroeid, vorig jaar verzamelde het belangrijkste evenement van de sector 3339 deelnemers, 165 sprekers van lezingen en meetups, en er waren tegelijkertijd 16 tracks.
Vorig jaar hadden we 20 bussen, 5280 liter thee en koffie, 1650 liter sap en 10200 flesjes water voor u. En ook 2640 kilogram voedsel, 16000 borden en 25000 bekers. Trouwens, met het geld dat we hebben verdiend met gerecycled papier, hebben we 100 eikenboompjes geplant 🙂Kaarten kunnen worden gekocht , blijf op de hoogte van het nieuws over de conferentie — , en praat — op alle sociale netwerken: , , en .
Bron: habr.com
