

— een zeer krachtige en handige mechanisme, als er dezelfde acties 'diep' worden uitgevoerd op gerelateerde gegevens. Maar ongecontroleerde recursie is slecht, wat kan leiden tot oneindige uitvoering van het proces, of (wat vaker gebeurt) tot het 'opeten' van al het beschikbare geheugen.
Databases werken in dit opzicht volgens dezelfde principes — "ze zeiden te graven, en ik graaf". Jouw query kan niet alleen de naastgelegen processen vertragen, door voortdurend CPU-resources te gebruiken, maar ook de gehele database 'neerhalen', door al het beschikbare geheugen te 'consumeren'. Daarom is bescherming tegen onbegrensde recursie de verantwoordelijkheid van de ontwikkelaar zelf.
In PostgreSQL is de mogelijkheid om recursieve queries te gebruiken via al sinds de verre versie 8.4 aanwezig, maar het is nog steeds mogelijk om regelmatig potentiële kwetsbare 'onbeschermde' queries tegen te komen. Hoe kun je jezelf beschermen tegen dergelijke problemen?
Geen recursieve queries schrijven
Maar niet-recursieve queries schrijven. Met vriendelijke groet, Uw K.O.
In werkelijkheid biedt PostgreSQL een aanzienlijk aantal functies die je kunt gebruiken om niet recursie toe te passen.
Een fundamenteel andere benadering van het probleem toepassen
Soms kun je het probleem gewoon 'van de andere kant' bekijken. Een voorbeeld van een dergelijke situatie heb ik gegeven in het artikel — het vermenigvuldigen van een set getallen zonder gebruik te maken van gebruikersgedefineerde aggregatiefuncties:
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- selecteer het eindresultaat
  i DESC
LIMIT 1;
Zo'n query kan worden vervangen door een variant van liefhebbers van wiskunde:
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Gebruik generate_series in plaats van loops
Stel dat we de taak hebben om alle mogelijke prefixen voor een string te genereren 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
Is recursie hier echt nodig?.. Als je gebruik maakt van LATERAL en generate_series, dan zijn zelfs CTE's niet nodig:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
De structuur van de database wijzigen
Bijvoorbeeld, je hebt een forum berichten tabel met de relaties wie op wie heeft gereageerd of een draad in :
CREATE TABLE message(
  message_id
    uuid
      PRIMARY KEY
, reply_to
    uuid
      REFERENCES message
, body
    text
);
CREATE INDEX ON message(reply_to); 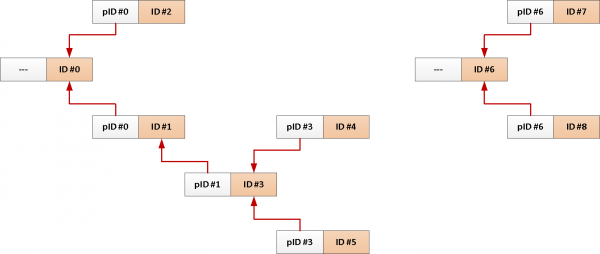
En een typische query om alle berichten over een bepaald onderwerp te laden, ziet er ongeveer zo uit:
WITH RECURSIVE T AS (
  SELECT
    *
  FROM
    message
  WHERE
    message_id = $1
UNION ALL
  SELECT
    m.*
  FROM
    T
  JOIN
    message m
      ON m.reply_to = T.message_id
)
TABLE T;
Maar aangezien we altijd het hele onderwerp vanaf het eerste bericht nodig hebben, waarom zouden we dan niet de identificatie ervan aan elke record automatisch toevoegen? automatisch?
-- voeg een veld met de gezamenlijke identificatie van het onderwerp en een index erop toe
ALTER TABLE message
  ADD COLUMN theme_id uuid;
CREATE INDEX ON message(theme_id);

-- initialiseer de identificatie van het onderwerp in de trigger bij invoeging
CREATE OR REPLACE FUNCTION ins() RETURNS TRIGGER AS $$
BEGIN
  NEW.theme_id = CASE
    WHEN NEW.reply_to IS NULL THEN NEW.message_id -- neem het van het initiële evenement
    ELSE ( -- of van het bericht waarop we antwoorden
      SELECT
        theme_id
      FROM
        message
      WHERE
        message_id = NEW.reply_to
    )
  END;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER ins BEFORE INSERT
  ON message
    FOR EACH ROW
EXECUTE PROCEDURE ins(); 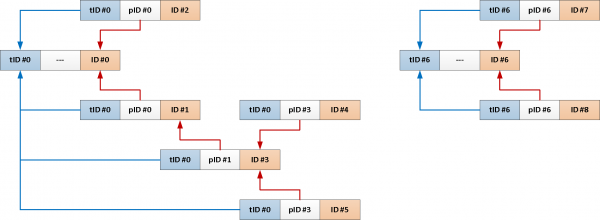
Nu kan onze complete recursieve query eenvoudig worden teruggebracht tot het volgende:
SELECT
  *
FROM
  message
WHERE
  theme_id = $1;
Gebruik applicatie "beperkingen"
Als we om welke reden dan ook de database-structuur niet kunnen veranderen, laten we dan eens kijken op welke we kunnen steunen, zodat zelfs de aanwezigheid van een fout in de gegevens niet leidt tot een oneindige uitvoering van de recursie.
Recursiediepte teller
Verhoog eenvoudig de teller met één bij elke stap van de recursie tot we de limiet bereiken die we als duidelijk onredelijk beschouwen:
WITH RECURSIVE T AS (
  SELECT
    0 i
  ...
UNION ALL
  SELECT
    i + 1
  ...
  WHERE
    T.i < 64 -- limiet
)
Pro: Bij een poging tot oneindige lus zullen we niet meer dan het opgegeven limiet van iteraties "diep" uitvoeren.
Contra: Er is geen garantie dat we niet opnieuw dezelfde record verwerken — bijvoorbeeld op diepte 15 en 25, en verder elke +10. En over "breedte" is ook niets beloofd.
Formeel gezien zal deze recursie niet oneindig zijn, maar als het aantal records bij elke stap exponentieel toeneemt, weten we allemaal hoe dat eindigt...
Bewaker van het "pad"
We voegen stap voor stap alle objectidentificaties die we tegenkomen langs het pad van de recursie toe aan een array, die het unieke "pad" naar hen vertegenwoordigt:
MET RECURSIEVE T AS (
  SELECT
    ARRAY[id] pad
  ...
UNION ALL
  SELECT
    pad || id
  ...
  WHERE
    id  ALL(T.pad) -- komt niet overeen met een van de
)
Pro: Als er een cyclus in de gegevens is, zullen we absoluut niet dezelfde registratie opnieuw verwerken binnen hetzelfde pad.
Contra: Maar we kunnen letterlijk alle registraties doorlopen zonder ons te herhalen.
Beperkingen voor de lengte van het pad
Om de situatie van " dwaalrecursie" op een onbekende diepte te voorkomen, kunnen we de twee voorgaande methoden combineren. Of, als we geen extra velden willen ondersteunen, de voorwaarde voor voortzetting van de recursie aanvullen met de schatting van de lengte van het pad:
MET RECURSIEVE T AS (
  SELECT
    ARRAY[id] pad
  ...
UNION ALL
  SELECT
    pad || id
  ...
  WHERE
    id  ALL(T.pad) AND
    array_length(T.pad, 1) < 10
)
Kies de methode naar jouw smaak!
Bron: habr.com
