

Welke versie van de firmware is de 'juiste' en 'werkende'? Garandeert de opslagomgeving een uitvalresistentie van 99,9999%, betekent dit dan dat deze ook zonder software-updates voortdurend functioneert? Of is het juist zo dat voor maximale uitvalresistentie altijd de nieuwste firmware geïnstalleerd moet worden? We proberen deze vragen te beantwoorden op basis van onze ervaring.
Korte inleiding
Iedereen begrijpt dat er in elke versie van software, of het nu een besturingssysteem of een stuurprogramma voor een apparaat is, vaak tekortkomingen/bugs en andere 'kenmerken' zitten, die kunnen, net zoals ze niet 'aan het licht komen' tot het einde van de levensduur van de apparatuur, alleen onder bepaalde omstandigheden 'naar voren komen'. Het aantal en de betekenis van dergelijke nuances hangen af van de complexiteit (functionaliteit) van de software en van de kwaliteit van de tests bij de ontwikkeling.
Vaak blijven gebruikers op de 'fabrieksfirmware' (de beroemde - 'het werkt, dus laat het maar') of installeren ze altijd de nieuwste versie (in hun begrip betekent laatste, dat deze het beste werkt). Wij hanteren echter een andere aanpak - we bekijken de release-opmerkingen voor alle gebruikte apparatuur en kiezen zorgvuldig de geschikte firmware voor elk stuk apparatuur.
Tot deze conclusie zijn we gekomen door ervaring. We zullen aan de hand van ons eigen gebruik toelichten waarom de beloofde 99,9999% betrouwbaarheid van de opslagomgeving niets betekent als je niet tijdig let op updates en beschrijvingen van de software. Onze casus is geschikt voor gebruikers van opslagomgevingen van elke leverancier, aangezien een dergelijke situatie zich met hardware van elke fabrikant kan voordoen.
Kiezen van een nieuw datasysteem
Aan het eind van vorig jaar is er een interessante datasysteem aan onze infrastructuur toegevoegd: het instapmodel van de IBM FlashSystem 5000 reeks, dat ten tijde van aankoop de naam Storwize V5010e droeg. Tegenwoordig wordt het verkocht onder de naam FlashSystem 5010, maar feitelijk is het dezelfde hardwarebasis met dezelfde Spectrum Virtualize erbinnen.
De aanwezigheid van een uniforme beheersysteem is, overigens, het belangrijkste kenmerk van IBM FlashSystem. Bij de modellen uit de instapserie verschilt het nauwelijks van de modellen met hogere prestaties. Het kiezen van een bepaald model biedt alleen de bijbehorende hardwarebasis, waarvan de specificaties de mogelijkheid bieden om bepaalde functionaliteit te gebruiken of een hoger niveau van schaalbaarheid te waarborgen. De software identificeert de hardware en biedt de benodigde en voldoende functionaliteit voor dit platform.
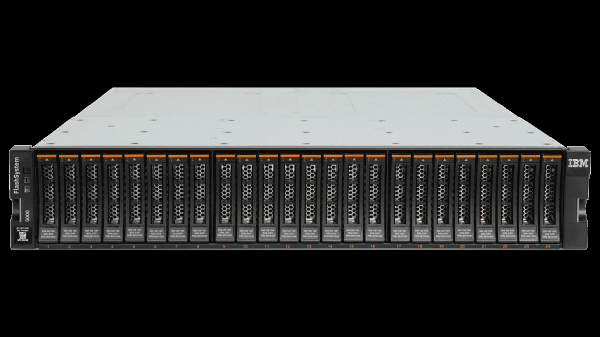 IBM FlashSystem 5010
Kort over ons model 5010. Dit is een tweedelige controller block storage systeem voor de instapklasse. Het kan NLSAS-, SAS-, en SSD-schijven huisvesten. Het plaatsen van NVMe is niet beschikbaar omdat dit model van de SAN is gepositioneerd voor taken die geen NVMe-prestaties vereisen.
De SAN is aangeschaft voor het opslaan van archiefinformatie of gegevens die niet vaak worden geraadpleegd. Daarom was een standaard set van functionaliteit voldoende voor ons: tiering (Easy Tier), Thin Provision. Ook de prestaties op NLSAS-schijven van 1000-2000 IOPS waren voor ons volledig acceptabel.
Onze ervaring — hoe we de firmware niet op tijd hebben bijgewerkt
Laten we nu echt praten over de software-update. Op het moment van aankoop had het systeem al een iets verouderde versie van de Spectrum Virtualize-software, namelijk, 8.2.1.3.
We hebben de firmwarebeschrijvingen bestudeerd en de update naar 8.2.1.9. Als we iets sneller waren geweest, zou dit artikel niet zijn geschreven — met een recentere firmware zou de bug zich niet hebben voorgedaan. Echter, om bepaalde redenen werd de update van dit systeem uitgesteld.
Als resultaat leidde een kleine vertraging in de update tot een zeer onaangenaam beeld, zoals beschreven in de link: .
Ja, in de firmware van die versie was er inderdaad het zogenaamde APAR (Authorized Program Analysis Report) HU02104. Dit manifesteert zich als volgt: onder belasting begint de cache onder bepaalde omstandigheden vol te lopen, waarna het systeem in een beschermingsmodus gaat, waarin invoer-uitvoer voor de pool (Pool) wordt uitgeschakeld. In ons geval leek dit op het uitschakelen van 3 schijven voor de RAID-groep in RAID 6-modus. De uitschakeling duurt 6 minuten. Daarna wordt de toegang tot de volumes in de pool hersteld.
Als iemand niet bekend is met de structuur en naamgeving van logische entiteiten in de context van IBM Spectrum Virtualize, zal ik dit nu kort uitleggen.
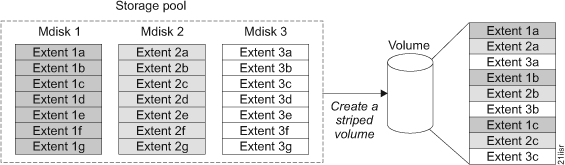 Structuur van logische elementen van opslag systemen
Schijven worden in groepen samengebracht, die MDisk (Managed Disk) worden genoemd. MDisk kan een klassieke RAID (0,1,10,5,6) of een gevirtualiseerde versie zijn - DRAID (Distributed RAID). Het gebruik van DRAID verhoogt de prestaties van de array, omdat alle schijven in de groep worden gebruikt, en vermindert de hersteltijd, omdat alleen specifieke blokken hoeven te worden hersteld in plaats van alle gegevens van de defecte schijf.
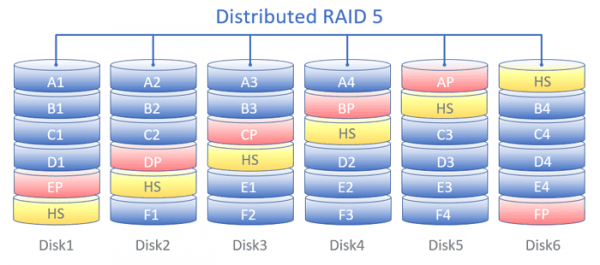 Verspreiding van datablocks over schijven bij het gebruik van Distributed RAID (DRAID) in RAID-5 modus.
Dit schema toont de logica van het DRAID-herstel in het geval van een defecte schijf:
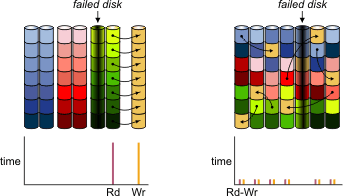 Logica van het DRAID-herstel bij het falen van een enkele schijf
Vervolgens vormen een of meer MDisk wat we een Pool noemen. Binnen een enkele pool is het niet aanbevolen om MDisk met verschillende RAID/DRAID-niveaus op schijven van hetzelfde type te gebruiken. We zullen hier niet te diep op ingaan, aangezien we van plan zijn dit in een van de volgende artikelen verder uit te leggen. En de Pool wordt verdeeld in Volumes, die worden gepresenteerd via een bepaald bloktoegangsprotocol naar de hosts.
Dus, in ons geval, als gevolg van de situatie beschreven in APAR HU02104, stopte een MDisk, als gevolg van de logische storing van drie schijven, met functioneren, wat op zijn beurt leidde tot het falen van de Pool en de bijbehorende Volumes.
Aangezien deze systemen behoorlijk 'slim' zijn, kunnen ze worden aangesloten op de cloudgebaseerde monitoringsystemen van IBM Storage Insights, die automatisch, bij het optreden van een defect, een verzoek voor service naar de IBM-ondersteuningsdienst verzendt. Er wordt een ticket aangemaakt en IBM-specialisten voeren op afstand diagnostiek uit en nemen contact op met de gebruiker van het systeem.
Hierdoor werd het probleem vrij snel opgelost en ontving de ondersteuningsdienst een snelle aanbeveling om ons systeem bij te werken naar de eerder door ons gekozen firmware 8.2.1.9, waarin dit probleem al was opgelost. Dit bevestigt .
Conclusies en onze aanbevelingen
Zoals het gezegde luidt: "goed is wat goed eindigt". Een bug in de firmware heeft niet geleid tot ernstige problemen — de werking van de servers is in korte tijd en zonder gegevensverlies hersteld. Bij sommige klanten was het nodig om virtuele machines opnieuw op te starten, maar over het algemeen waren we voorbereid op meer negatieve gevolgen, aangezien we dagelijks back-ups maken van alle elementen van de infrastructuur en klantmachines.
We hebben bevestiging gekregen dat zelfs betrouwbare systemen met 99,9999% beloofde beschikbaarheid aandacht en tijdig onderhoud vereisen. Op basis van de situatie hebben we een aantal conclusies getrokken en delen we onze aanbevelingen:
Het is absoluut noodzakelijk om updates in de gaten te houden, de Release Notes te bestuderen op zoek naar het verhelpen van potentieel kritieke punten en tijdig geplande updates uit te voeren.
Dit is een organisatorisch en zelfs vrij voor de hand liggend punt, dat ogenschijnlijk niet de nadruk waard is. Echter, op deze "vanzelfsprekende plek" kan men vrij gemakkelijk struikelen. Dit punt is in feite de oorzaak geweest van de eerder beschreven ongemakken. Neem de opstelling van het update-reglement zeer serieus en houd ook toezicht op de naleving ervan. Dit punt heeft meer te maken met het concept van "discipline".
Het is altijd beter om het systeem te houden met de meest actuele versie van de software. En met actueel bedoelen we niet de versie met het hoogste nummer, maar die met de meest recente uitgavedatum.
Bijvoorbeeld, IBM houdt voor zijn opslag systemen minimaal twee softwareversies up-to-date. Op het moment van schrijven van dit artikel zijn dat 8.2 en 8.3. Updates voor 8.2 worden eerder uitgebracht. Vervolgens komt meestal met een kleine vertraging een soortgelijke update voor 8.3.
Release 8.3 heeft een aantal functionele voordelen, zoals de mogelijkheid om MDisk (in DRAID-modus) uit te breiden met het toevoegen van een of meer nieuwe schijven (deze mogelijkheid is beschikbaar sinds versie 8.3.1). Dit is vrij basale functionaliteit, maar in 8.2 is deze mogelijkheid helaas niet aanwezig.
Als het om welke reden dan ook niet mogelijk is om te upgraden, dan raadt de technische ondersteuning van IBM voor versies van de Spectrum Virtualize-software voorafgaand aan versies 8.2.1.9 en 8.3.1.0 (waar de hierboven beschreven bug van toepassing is) aan om de prestaties van het systeem op het niveau van de pool te beperken, zoals weergegeven in de onderstaande afbeelding (de screenshot is gemaakt in de Nederlandstalige versie van de GUI). De waarde 10000 IOPS is ter illustratie en wordt afgestemd op de specificaties van uw systeem.
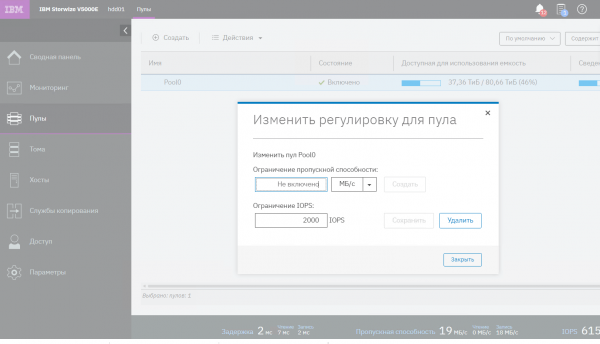 Prestatiebeperkingen van de IBM Systeemopslag
Het is noodzakelijk om de belasting op opslag systemen goed te berekenen en te voorkomen dat deze overbelast raken. Dit kan worden gedaan met de IBM-sizer (indien toegankelijk), met hulp van partners, of met externe bronnen. Het is hierbij essentieel om het type belasting op het opslag systeem te begrijpen, omdat de prestaties in MB/s en IOPS aanzienlijk verschillen afhankelijk van ten minste de volgende parameters:
type operatie: lezen of schrijven,
blokgrootte van de operatie,
de procentuele verhouding van lees- en schrijfoperaties in de totale invoer-uitvoer-stroom.
Ook de snelheid van de uitvoering van operaties wordt beïnvloed door hoe de datablokken worden gelezen: sequentieel of willekeurig. Bij het uitvoeren van meerdere datatoegang operaties aan de applicatiezijde is er sprake van afhankelijke operaties. Dit is ook goed om in overweging te nemen. Dit alles kan helpen om een overzicht van de gegevens van de prestatiestatistieken van het besturingssysteem, de opslag systemen, servers/hypervisors te krijgen, evenals een begrip van de werking van applicaties, databases en andere "gebruikers" van schijfruimte.
En tenslotte, zorg ervoor dat u actuele en werkende reservekopieën heeft. De planning voor back-ups moet worden ingesteld op basis van zakelijke aanvaardbare waarden voor RPO en de integriteit van back-ups moet periodiek worden gecontroleerd (veel softwareleveranciers voor back-up hebben geautomatiseerde verificatie in hun producten geïmplementeerd) om een acceptabele waarde voor RTO te waarborgen.
Bedankt dat u tot het einde heeft gelezen.
Wij staan klaar om uw vragen en opmerkingen in de reacties te beantwoorden. Ook, waarin we regelmatig acties organiseren (kortingen op IaaS en verlotingen van promotiecodes tot 100% op VPS), interessante nieuwsberichten schrijven en nieuwe artikelen aankondigen op het blog van Habr.
Bron: habr.com
