

In dit artikel wordt de problematiek van het verwijderen van beelden besproken die zich ophopen in containerregisters (Docker Registry en zijn analogen) in de context van moderne CI/CD-pijplijnen voor cloud-native applicaties die worden geleverd in Kubernetes. De belangrijkste criteria voor de relevantie van beelden worden gepresenteerd, evenals de bijbehorende moeilijkheden bij het automatiseren van het verwijderen, het besparen van ruimte en het voldoen aan de behoeften van teams. Tot slot zullen we aan de hand van een specifiek open source-project uitleggen hoe deze moeilijkheden kunnen worden overwonnen.
Inleiding
Het aantal beelden in het containerregister kan snel toenemen, waardoor er meer opslagruimte wordt ingenomen en, dienovereenkomstig, de kosten aanzienlijk worden verhoogd. Om de groei van de ruimte die in de registry wordt ingenomen te controleren, te beperken of op een aanvaardbaar niveau te houden, wordt het volgende gedaan:
- een vast aantal tags voor beelden gebruiken;
- op de een of andere manier beelden verwijderen.
De eerste beperking is soms acceptabel voor kleine teams. Als ontwikkelaars voldoende hebben aan vaste tags (latest, main, test, boris enzovoort), zal het register niet in omvang toenemen en kan men lange tijd helemaal niet aan verwijdering denken. Want alle irrelevante beelden worden overschreven, en er blijft gewoon geen werk meer over voor verwijdering (alles wordt gedaan door de ingebouwde garbage collector).
Desondanks beperkt deze aanpak de ontwikkeling sterk en is deze zelden toepasbaar op moderne CI/CD-projecten. Automatisering is een integraal onderdeel van de ontwikkeling geworden, die het mogelijk maakt om veel sneller nieuwe functionaliteit te testen, in te zetten en aan gebruikers te leveren. Bijvoorbeeld, in al onze projecten wordt bij elke commit automatisch een CI-pijplijn aangemaakt. Hierin wordt een beeld opgebouwd, getest, uitgerold in verschillende Kubernetes-omgevingen voor debugging en resterende controles, en als alles goed is — komen de wijzigingen bij de eindgebruiker aan. En dit is al lang geen rocket science meer, maar dagelijkse kost voor velen — waarschijnlijk ook voor u, aangezien u dit artikel leest.Aangezien het oplossen van bugs en het ontwikkelen van nieuwe functionaliteit parallel plaatsvindt, en releases meerdere keren per dag kunnen worden uitgevoerd, is het duidelijk dat het ontwikkelingsproces wordt gekenmerkt door een aanzienlijk aantal commits, wat betekent —
een groot aantal beelden in de registry. een groot aantal afbeeldingen in de register. Als gevolg hiervan komt de kwestie van het organiseren van effectieve registratie schoonmaak, d.w.z. het verwijderen van niet-relevante beelden, sterk op de voorgrond.
Maar hoe bepaal je überhaupt of een beeld relevant is?
Criteria voor relevantie van het beeld
In de overgrote meerderheid van de gevallen zijn de belangrijkste criteria als volgt:
1. Het eerste (het meest voor de hand liggende en het meest kritische van allemaal) — zijn de beelden die op dit moment in Kubernetes worden gebruikt. Het verwijderen van deze beelden kan leiden tot ernstige kosten vanwege productie-uitval (bijvoorbeeld, beelden kunnen nodig zijn bij replicatie) of de inspanningen van het team die bezig is met debugging op een van de contouren tenietdoen. (Om deze reden hebben we zelfs een speciale , die het ontbreken van dergelijke beelden in elke Kubernetes-cluster bijhoudt.)
2. Het tweede (minder voor de hand liggend, maar ook zeer belangrijk en weer betrekking hebbend op exploitatie) — zijn beelden die vereist zijn voor terugdraaien in geval van ernstige problemen met de huidige versie. Bijvoorbeeld, in het geval van Helm zijn dit de beelden die worden gebruikt in bewaarde versies van de release. (Trouwens, standaard heeft Helm een limiet van 256 revisies, maar weinig mensen zullen echt behoefte hebben aan het bewaren van zoveel versies?..) We bewaren versies namelijk zodat we ze later kunnen gebruiken, d.w.z. ‘terugdraaien’ naar hen indien nodig.
3. De derde — de behoeften van ontwikkelaars: alle beelden die verband houden met hun huidige werkzaamheden. Bijvoorbeeld, als we een PR overwegen, heeft het zin om het beeld te behouden dat overeenkomt met de laatste commit en, zeg, de voorgaande commit: zo kan de ontwikkelaar snel terugkeren naar elke taak en werken met de laatste wijzigingen.
4. De vierde — beelden die overeenkomen met de versies van onze applicatie, d.w.z. het eindproduct zijn: v1.0.0, 20.04.01, sierra, enz.
NB: De criteria die hier zijn vastgesteld, zijn geformuleerd op basis van ervaringen met tientallen ontwikkelteams van verschillende bedrijven. Echter, afhankelijk van de kenmerken van de ontwikkelingsprocessen en de gebruikte infrastructuur (bijvoorbeeld, als Kubernetes niet wordt gebruikt), kunnen deze criteria verschillen.
Overeenstemming met de criteria en bestaande oplossingen
Populaire container registry-services bieden doorgaans hun eigen beleid voor het opschonen van afbeeldingen aan: hierin kunt u voorwaarden definiëren waaronder een tag uit de registry wordt verwijderd. De mogelijkheden van deze voorwaarden zijn echter beperkt tot parameters zoals namen, aanmaakdatum en aantal tags*.
* Hangt af van de specifieke implementaties van container registries. We hebben de mogelijkheden van de volgende oplossingen bekeken: Azure CR, Docker Hub, ECR, GCR, GitHub Packages, GitLab Container Registry, Harbor Registry, JFrog Artifactory, Quay.io — op basis van september 2020.
Deze set parameters is voldoende om aan de vierde criteria te voldoen — namelijk het selecteren van afbeeldingen die overeenkomen met versies. Voor alle andere criteria moet echter een compromisoplossing worden gekozen (een strikter of juist een soepeler beleid) — afhankelijk van de verwachtingen en financiële mogelijkheden.
Bijvoorbeeld, de derde criteria — gerelateerd aan de behoeften van ontwikkelaars — kan worden aangepakt door processen binnen teams te organiseren: specifieke naamgeving van afbeeldingen, het bijhouden van speciale toelatingslijsten en interne afspraken. Maar uiteindelijk moet het toch worden geautomatiseerd. En als de mogelijkheden van de bestaande oplossingen niet genoeg zijn, moet je zelf iets doen.
De situatie met de eerste twee criteria is vergelijkbaar: deze kunnen niet worden vervuld zonder gegevens van een extern systeem — het systeem waar de applicaties worden uitgerold (in ons geval is dat Kubernetes).
Illustratie van workflow in Git
Stel dat je ongeveer volgens dit schema in Git werkt:
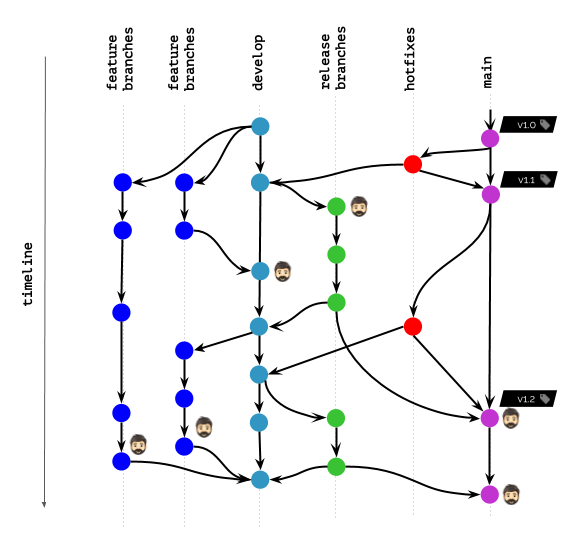
In de afbeelding zijn de containerafbeeldingen gemarkeerd met een hoofd op het schema, die momenteel zijn uitgerold in Kubernetes voor bepaalde gebruikers (eindgebruikers, testers, managers, enz.) of door ontwikkelaars worden gebruikt voor debugging en soortgelijke doeleinden.
Wat gebeurt er als het opschoonbeleid toestaat om afbeeldingen alleen te laten staan (niet te verwijderen) op specifieke tag-namen?
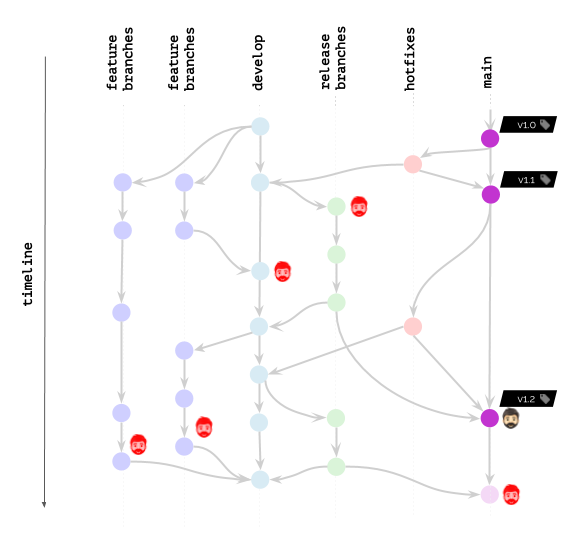
Dit scenario zal duidelijk niemand blij maken.
Wat verandert er als het beleid toestaat om afbeeldingen niet te verwijderen over een bepaalde tijdsperiode / aantal laatste commits?
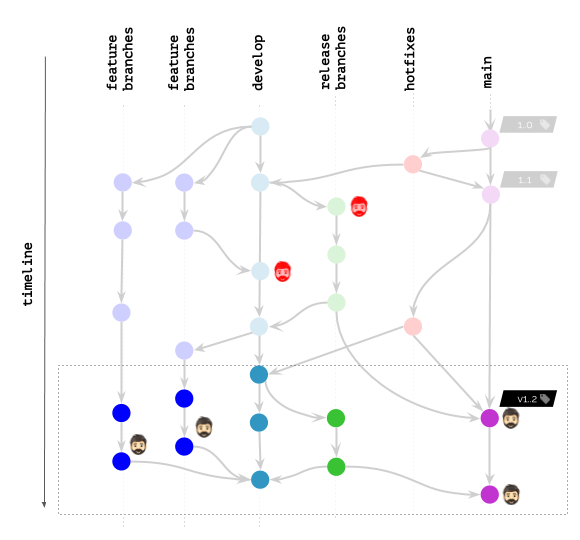
Het resultaat is aanzienlijk verbeterd, maar nog steeds ver verwijderd van ideaal. Want er zijn nog steeds ontwikkelaars die afbeeldingen in de registry (of zelfs uitgerold in K8s) nodig hebben voor het debuggen van bugs...
Samenvattend de huidige situatie op de markt: de beschikbare functies in containerregistries bieden niet de nodige flexibiliteit bij het opschonen, en de belangrijkste reden daarvoor is het gebrek aan interactie met de buitenwereld. Dit betekent dat teams die deze flexibiliteit nodig hebben, gedwongen zijn om zelf de verwijdering van images "van buiten" te realiseren, met behulp van de Docker Registry API (of de native API van de betreffende implementatie).
Echter, we zochten naar een universele oplossing die het opschonen van images zou automatiseren voor verschillende teams die verschillende registries gebruiken…
Onze weg naar universeel opschonen van images
Waarom is deze behoefte ontstaan? Het komt omdat we niet een losstaande groep ontwikkelaars zijn, maar een team dat meerdere teams ondersteunt, en helpt om CI/CD-vragen op een geïntegreerde manier aan te pakken. Het belangrijkste technische hulpmiddel hiervoor is een open-source utility . Het kenmerk daarvan is dat het niet slechts één functie vervult, maar de processen van continue levering op alle niveaus begeleidt: van bouwen tot implementatie.
Publicatie in de images registry* (direct na hun opbouw) is een voor de hand liggende functie van zo'n utility. En aangezien images daar op worden opgeslagen, moet er, als je opslag niet eindeloos is, ook verantwoordelijk voor hun latere opschoning worden gezorgd. Hoe we hierin succesvol zijn geweest, met inachtneming van alle gestelde criteria, zal hierna worden besproken.
* Hoewel de registries zelf verschillend kunnen zijn (Docker Registry, GitLab Container Registry, Harbor, enz.), worden hun gebruikers geconfronteerd met dezelfde problemen. De universele oplossing in ons geval hangt niet af van de implementatie van de registry, omdat deze buiten de registries zelf wordt uitgevoerd en hetzelfde gedrag voor allemaal biedt.
Hoewel we werf als voorbeeld van implementatie gebruiken, hopen we dat de gebruikte benaderingen ook nuttig zullen zijn voor andere teams die met dezelfde uitdagingen worden geconfronteerd.
Dus zijn we begonnen met externe implementatie van een mechanisme voor het opschonen van images— in plaats van de mogelijkheden die al zijn ingebouwd in de registries voor containers. De eerste stap was het gebruik van de Docker Registry API om opnieuw de primitieve beleidsregels voor het aantal tags en de tijd van aanmaak (boven genoemd) op te stellen. Hieraan werd toegevoegd een allow list op basis van de images die in de uitgerolde infrastructuur worden gebruikt, dat wil zeggen Kubernetes. Voor de laatste was het voldoende om via de Kubernetes API alle gedeployde resources te doorlopen en een lijst met waarden te verkrijgen. afbeelding.
Deze triviale oplossing heeft het kritischste probleem opgelost (criteria nr. 1), maar was slechts het begin van onze weg om het opruimmechanisme te verbeteren. De volgende - en veel interessantere - stap was de oplossing om de gepubliceerde afbeeldingen aan de Git-geschiedenis te koppelen..
Tagging-schema's
We kozen in eerste instantie voor een aanpak waarbij de uiteindelijke afbeelding de nodige informatie voor opruiming moest bevatten, en we hebben het proces gebouwd op tagging-schema's. Bij het publiceren van de afbeelding koos de gebruiker een bepaalde tagging-optie (git-tak, git-commit of git-tag) en gebruikte de bijbehorende waarde. In CI-systemen gebeurde het instellen van deze waarden automatisch op basis van omgevingsvariabelen. In feite werd de uiteindelijke afbeelding gekoppeld aan een bepaald Git-primitief, waarbij de noodzakelijke gegevens voor opruiming in labels werden opgeslagen.
Met deze aanpak is een set beleidsregels ontstaan die het mogelijk maakte om Git als de enige bron van waarheid te gebruiken:
- Bij het verwijderen van een tak/tag in Git werden ook de gekoppelde afbeeldingen in de registry automatisch verwijderd.
- Het aantal afbeeldingen dat aan Git-tags en commits was gekoppeld, kon worden gereguleerd door het aantal tags dat in het gekozen schema was gebruikt en het tijdstip waarop de gekoppelde commit was gemaakt.
Over het algemeen voldeed de uiteindelijke implementatie aan onze behoeften, maar we stonden al snel voor een nieuwe uitdaging. Gedurende de tijd dat we tagging-schema's op Git-primitieven gebruikten, stuitten we op een aantal nadelen. (Omdat de beschrijving hiervan buiten het bestek van dit artikel valt, kan iedereen die geïnteresseerd is de details bekijken. .) Daarom, na de beslissing om over te schakelen op een effectieve aanpak voor tagging (content-based tagging), moesten we ook de implementatie van beeldopruiming heroverwegen.
Nieuwe algoritme
Waarom? Bij tagging binnen content-based kan elke tag aan meerdere commits in Git voldoen. Bij het opruimen van afbeeldingen kan je niet langer alleen uitgaan van de commit waarop de nieuwe tag aan de registry werd toegevoegd.
Voor het nieuwe opruimalgoritme werd besloten om af te stappen van tagging-schema's en te bouwen de proces op meta-afbeeldingen, elk van deze bevat de koppeling van:
- commits waarop de publicatie plaatsvond (ongeacht of de afbeelding is toegevoegd, gewijzigd of hetzelfde gebleven is in de container registry);
- en onze interne identifier die overeenkomt met de samengestelde afbeelding.
Met andere woorden, werd ervoor gezorgd dat de gepubliceerde tags werden gekoppeld aan commits in Git.
De uiteindelijke configuratie en het algemene algoritme
Gebruikers hebben toegang gekregen tot het beleid voor het configureren van opruiming, waarmee de actuele afbeeldingen worden geselecteerd. Elk dergelijk beleid wordt gedefinieerd door:
- een aantal referenties, d.w.z. Git-tags of Git-branches die worden gebruikt bij het scannen;
- en een limiet van de te zoeken afbeeldingen voor elke referentie uit de verzameling.
Ter illustratie — zo is de standaard configuratie van de beleidsregels eruit komen te zien:
cleanup:
  keepPolicies:
  - references:
      tag: \/.*\/
      limit:
        last: 10
  - references:
      branch: \/.*\/
      limit:
        last: 10
        in: 168h
        operator: And
    imagesPerReference:
      last: 2
      in: 168h
      operator: And
  - references:
      branch: \/^(main|staging|production)$\/
    imagesPerReference:
      last: 10
Zo'n configuratie bevat drie beleidsregels die voldoen aan de volgende voorwaarden:
- Bewaar de afbeelding voor de 10 nieuwste Git-tags (op basis van de datum waarop de tag is aangemaakt).
- Bewaar maximaal 2 afbeeldingen die in de afgelopen week zijn gepubliceerd, voor maximaal 10 branches met activiteit van de afgelopen week.
- Bewaar 10 afbeeldingen voor branches
main,stagingenproduction.
Het uiteindelijke algoritme bestaat uit de volgende stappen:
- Het verkrijgen van manifests uit de container registry.
- Uitsluiten van afbeeldingen die in Kubernetes worden gebruikt, omdat deze al vooraf zijn geselecteerd via de K8s API.
- Scannen van de Git-historie en uitsluiten van afbeeldingen op basis van gedefinieerde beleidsregels.
- Verwijderen van de resterende afbeeldingen.
Terugkomend op onze illustratie, dit is wat er gebeurt met werf:
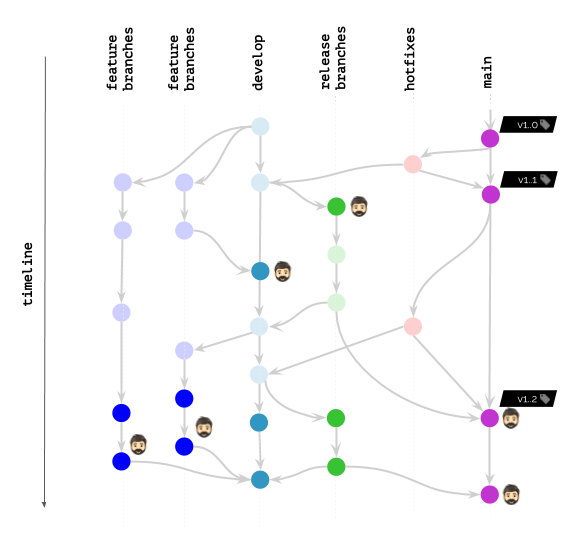
Echter, zelfs als u geen werf gebruikt, kan een dergelijke benadering voor geavanceerde opruiming van afbeeldingen — in een of andere implementatie (volgens de voorkeur voor het taggen van afbeeldingen) — ook in andere systemen/utilities worden toegepast. Het enige wat u hoeft te doen, is de problemen te herinneren die zich voordoen en de mogelijkheden in uw stack te vinden die het mogelijk maken om hun oplossing het soepelst in te bouwen. We hopen dat de weg die we hebben afgelegd u helpt om ook naar uw specifieke geval met nieuwe inzichten en gedachten te kijken.
Conclusie
- Vroeg of laat komt de meeste teams het probleem van overbelasting van de registry tegen.
- Bij het zoeken naar oplossingen is het belangrijk om eerst de relevantiecriteria van de afbeelding te bepalen.
- De tools die door populaire container registry services worden aangeboden, maken een zeer eenvoudige opruiming mogelijk, waarbij geen rekening wordt gehouden met de "externe wereld": de afbeeldingen die in Kubernetes worden gebruikt en de kenmerken van de werkprocessen in het team.
- Een flexibel en efficiënt algoritme moet bewust zijn van CI/CD-processen en niet alleen de gegevens van Docker-afbeeldingen verwerken.
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
