

De presentatie is gewijd aan praktische vraagstukken van de ontwikkeling van een operator in Kubernetes, het ontwerp van zijn architectuur en de belangrijkste principes van werking.
In het eerste deel van de presentatie zullen we behandelen:
- wat een operator in Kubernetes is en waarom het nodig is;
- hoe een operator het beheer van complexe systemen vereenvoudigt;
- wat de operator wel en niet kan.
Vervolgens gaan we over op de bespreking van de interne structuur van de operator. We bekijken de architectuur en werking van de operator stap voor stap. We zullen gedetailleerd bespreken:
- de interactie tussen de operator en Kubernetes;
- welke functies de operator op zich neemt en wat hij delegeert naar Kubernetes.
We bekijken het beheer van shards en replica's van de database in Kubernetes.
Daarna bespreken we de kwesties rond gegevensopslag:
- hoe om te gaan met Persistent Storage vanuit het perspectief van de operator;
- de valkuilen van het gebruik van Local Storage.
In het slotgedeelte van de presentatie bekijken we praktische voorbeelden van toepassing van met Amazon of Google Cloud Service. De presentatie is opgebouwd rond de ontwikkeling en ervaring met de operator voor ClickHouse.
Video:
Mijn naam is Vladislav Klimenko. Vandaag wilde ik ons ervaring met de ontwikkeling en exploitatie van de operator delen, en dit is een gespecialiseerde operator voor het beheren van clusters van databases. Aan de hand van om het cluster ClickHouse te beheren.
Waarom hebben wij de mogelijkheid om te vertellen over de operator en ClickHouse?
- Wij ondersteunen en ontwikkelen ClickHouse.
- Momenteel proberen we op een rustige manier een bijdrage te leveren aan de ontwikkeling van ClickHouse. En we zijn de tweede na Yandex qua hoeveelheid aangebrachte wijzigingen in ClickHouse.
- We proberen extra projecten voor het ClickHouse-ecosysteem te realiseren.
Over een van deze projecten wil ik vertellen. Dit gaat over ClickHouse-operator voor Kubernetes.
In mijn presentatie wil ik twee onderwerpen aansnijden:
- Het eerste onderwerp is hoe onze operator werkt voor het beheren van ClickHouse-databases in Kubernetes.
- Het tweede onderwerp is hoe elke operator werkt, d.w.z. hoe hij interacteert met Kubernetes.
Deze twee vragen zullen gedurende mijn hele presentatie met elkaar overlappen.
Voor wie zou het interessant zijn om te luisteren naar wat ik probeer te vertellen?
- Het zal vooral interessant zijn voor degenen die operators exploiteren.
- Of voor degenen die hun eigen willen maken om te begrijpen hoe het van binnenuit werkt, hoe de operator met Kubernetes interageert en welke valkuilen zich kunnen voordoen.
Om beter te begrijpen wat we vandaag gaan bespreken, is het nuttig om te weten hoe Kubernetes werkt en een basiskennis van cloudtechnologieën te hebben.
Wat is ClickHouse? Het is een kolomgeoriënteerde database die specifiek is voor het online verwerken van analytische queries. En het is volledig open source.
Er zijn twee belangrijke zaken die we moeten weten. We moeten begrijpen dat dit een database is, dus wat ik ga vertellen is praktisch toepasbaar op elke database. En dat ClickHouse als database zeer goed schaalbaar is, bijna lineaire schaalbaarheid biedt. Daarom is de toestand van een cluster een natuurlijke toestand voor ClickHouse. We willen vooral bespreken hoe we een ClickHouse-cluster in Kubernetes kunnen onderhouden.
Waarom is het daar nodig? Waarom kunnen we het niet zelfstandig blijven gebruiken? De antwoorden zijn deels technisch en deels organisatorisch van aard.
- In de praktijk zien we steeds vaker dat in grote bedrijven bijna alle componenten al in Kubernetes zijn. Dat er databases buiten blijven.
- En steeds vaker wordt de vraag gesteld: "Kunnen we dit intern onderbrengen?" Daarom proberen grote bedrijven maximale uniformiteit in het beheer te creëren, zodat ze snel hun dataopslag kunnen beheren.
- Dit helpt vooral als er de benodigde mogelijkheid is om hetzelfde snel naar een nieuwe locatie te repliceren, met andere woorden, maximale overdraagbaarheid.
Hoe eenvoudig of ingewikkeld is dit? Dit kan natuurlijk handmatig worden gedaan. Maar het is niet zo simpel, omdat we te maken krijgen met de complexiteit van het beheer van Kubernetes, en daarnaast de specifieke eisen van ClickHouse. Dit leidt tot een aggregatie.
En alles samen creëert een behoorlijk groot aantal technologieën, die steeds moeilijker te beheren zijn, omdat Kubernetes zijn dagelijkse operationele vragen met zich meebrengt en ClickHouse zijn eigen operationele vragen. Vooral als we meerdere ClickHouse-instanties hebben en we voortdurend iets met hen moeten doen.
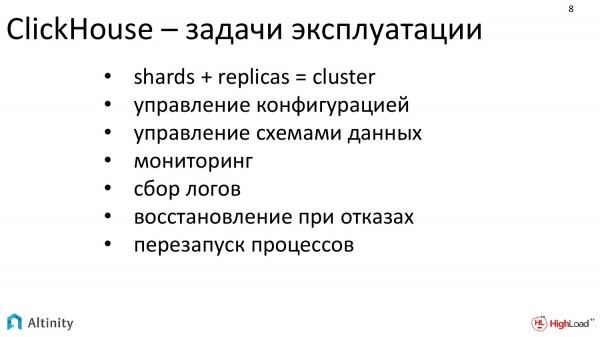
ClickHouse heeft bij dynamische configuratie een aantal vragen die een constante belasting voor DevOps creëren:
- Wanneer we iets in ClickHouse willen wijzigen, zoals het toevoegen van een replica of sharding, moeten we het configuratiemanagement uitvoeren.
- Daarna de datastructuur wijzigen, omdat ClickHouse een specifieke manier van sharding heeft. Je moet de datastructuur en configuraties uitpakken.
- Er moet monitoring worden ingesteld.
- Logverzameling voor nieuwe shards en nieuwe replicas.
- Zorg voor herstel.
- En herstarten.
Dit zijn routinetaken die we graag zouden willen vergemakkelijken in het beheer.
Kubernetes helpt goed in het beheer, maar vooral bij de basis systeemzaken.
Kubernetes vergemakkelijkt en automatiseert zaken zoals:
- Herstel.
- Herstart.
- Beheer van opslag systemen.
Dat is goed, het is de juiste richting, maar hij heeft volledig geen idee hoe je een databasecluster moet beheren.
We willen meer, we willen dat onze gehele database in Kubernetes draait.
Ik wil iets als een grote magische rode knop, waarop je kunt drukken en waarmee je een cluster ontplooit en onderhoudt gedurende zijn hele levenscyclus, met dagelijkse taken die moeten worden opgelost. Een ClickHouse-cluster in Kubernetes.
En we hebben geprobeerd een oplossing te creëren die het werk vergemakkelijkt. Dit is de ClickHouse-operator voor Kubernetes van Altinity.
Een operator is een programma dat als belangrijkste taak heeft om andere programma's te beheren, d.w.z. het is een manager.
En het bevat gedragssjablonen. Je zou dit gecodificeerde kennis van een vakgebied kunnen noemen.
En de belangrijkste taak is om het leven van DevOps te vergemakkelijken en micromanagement te verminderen, zodat hij (DevOps) al denkt in termen van hoge niveaus, d.w.z. dat hij (DevOps) zich niet bezig houdt met micromanagement, zodat hij niet alle details handmatig hoeft in te stellen.
En juist de operator is een robotassistent die de microtaken aanpakt en DevOps helpt.
Waarom is een operator nodig? Hij scoort vooral goed op twee punten:
- Wanneer een specialist die met ClickHouse werkt, niet genoeg ervaring heeft, maar ClickHouse al moet beheren, vergemakkelijkt de operator het beheer en stelt je in staat om een ClickHouse-cluster met een vrij complexe configuratie te beheren, zonder echt in te gaan op de details van hoe alles intern werkt. Je geeft hem gewoon hoge niveau taken, en het werkt.
- En de tweede taak waarin hij zich het beste manifesteert, is wanneer er een groot aantal standaardtaken geautomatiseerd moet worden. Hij neemt microtaken van systeembeheerders over.
Dit is vooral nodig voor degenen die net beginnen, of voor degenen die veel met automatisering bezig moeten zijn.
Wat is dan het verschil tussen de operator-gebaseerde benadering en andere systemen? Er is toch Helm. Het helpt ook om ClickHouse te installeren, je kunt helm charts tekenen die zelfs een hele ClickHouse-cluster zullen opzetten. Wat is dan het verschil tussen de operator en bijvoorbeeld Helm?
Het belangrijkste fundamentele verschil is dat Helm een pakketbeheerder is, terwijl de operator verder gaat. Dit betreft het beheer van de volledige levenscyclus. Het is niet alleen installatie, het omvat dagelijkse taken zoals schaling, sharding, dat wil zeggen, alles wat moet worden uitgevoerd in het proces van de levenscyclus (indien nodig ook verwijdering) - dat lost de operator op. Hij probeert de volledige levenscyclus van de software te automatiseren en te onderhouden. Dit is zijn fundamentele verschil van andere beschikbare oplossingen.
Dit was het inleidende deel, laten we verder gaan.
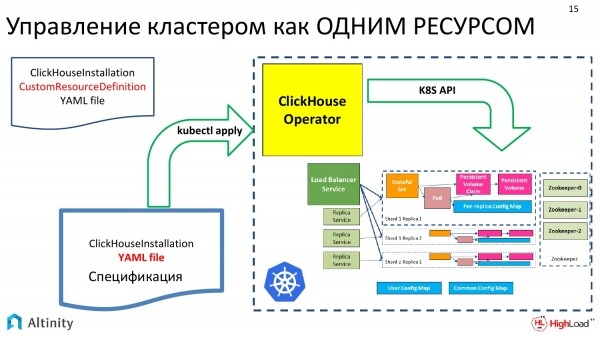
Hoe bouwen we onze operator? We proberen de aanpak te hanteren om de cluster ClickHouse als één bron te beheren.
Aan de linkerkant van het beeld hebben we de invoergegevens. Dit is YAML met de specificatie van de cluster, die op de klassieke manier via kubectl aan Kubernetes wordt doorgegeven. Daar pakt onze operator het op en doet zijn magie. En aan de uitvoer krijgen we zo'n schema. Dit is de implementatie van ClickHouse in Kubernetes.
En verder gaan we rustig kijken naar hoe de operator precies werkt en welke standaardtaken we kunnen oplossen. We zullen ons alleen richten op standaardtaken omdat we beperkte tijd hebben. En we zullen niet alles behandelen wat de operator kan oplossen.
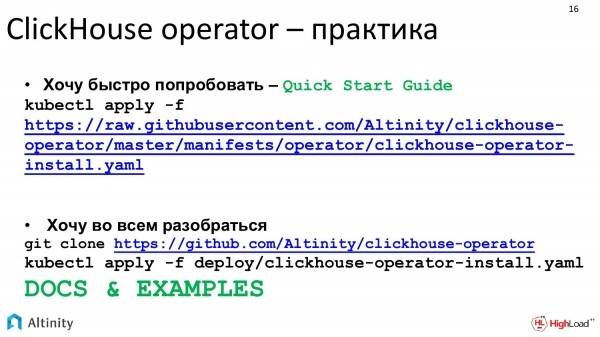
Laten we praktisch te werk gaan. Ons project is volledig open source, dus je kunt op GitHub kijken hoe het werkt. En je kunt aannemen dat als je gewoon wilt starten, je met de Quick Start Guide kunt beginnen.
Als je gedetailleerd wilt begrijpen, dan proberen we de documentatie in een redelijk goede staat te houden.
Laten we beginnen met een praktische taak. De eerste taak, waarmee we allemaal willen beginnen, is om het eerste voorbeeld op de een of andere manier te starten. Hoe kunnen we de ClickHouse-operator starten, zelfs als we niet goed weten hoe hij werkt? We schrijven een manifest, want alle communicatie met k8s gaat via manifesten.
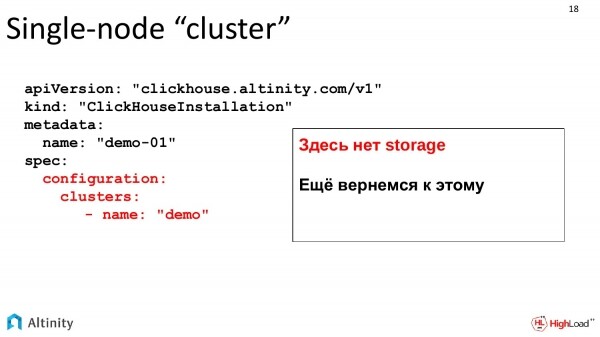
Dit is een vrij gecompliceerd manifest. Wat we in het rood hebben gemarkeerd, is waar we de nadruk op moeten leggen. We vragen de operator om een cluster met de naam demo te creëren.
Tot nu toe zijn dit basale voorbeelden. De opslag is nog niet beschreven, maar we komen daar later op terug. Voorlopig observeren we de ontwikkeling van het cluster in realtime.
We hebben dit manifest gemaakt. We voeren het in bij onze operator. Hij heeft gewerkt, heeft zijn magie gedaan.
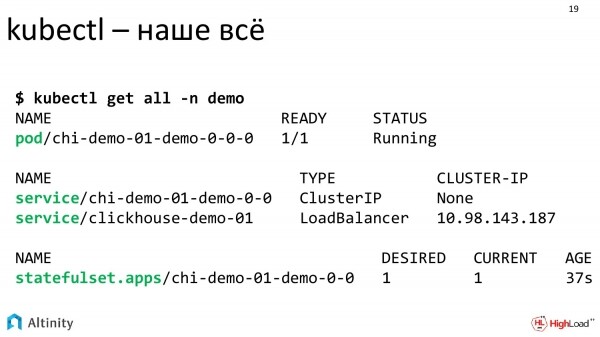
We kijken in de console. Drie componenten zijn interessant – dit is Pod, twee Services, StatefulSet.
De operator heeft zijn werk gedaan, en we kunnen zien wat hij heeft gecreëerd.
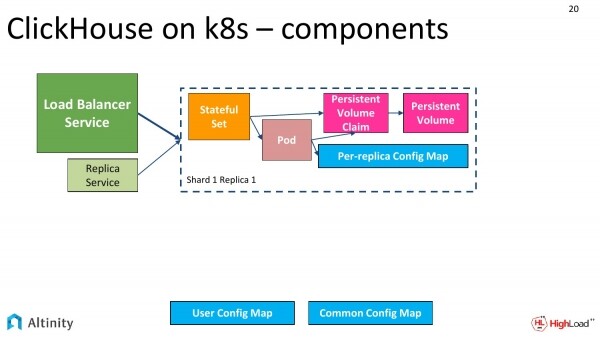
Hij maakt ongeveer zo'n schema. We hebben StatefulSet, Pod, een ConfigMap voor elke replica, en een ConfigMap voor het hele cluster. Services zijn essentieel als toegangspunten naar het cluster.
De services zijn de centrale Load Balancer Service en eventueel ook voor elke replica en elke shard.
Zo ziet ons basiscluster eruit. Het bestaat uit één enkele node.
Laten we verder gaan, we gaan het ingewikkelder maken. We moeten het cluster sharden.
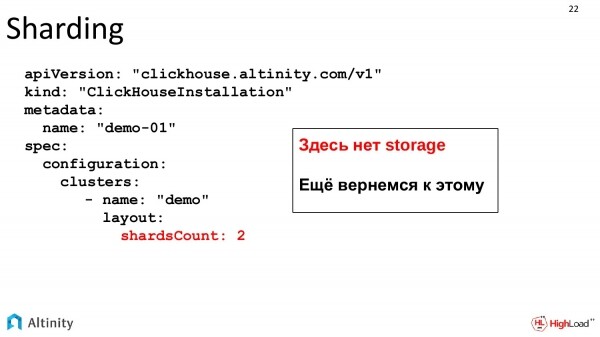
Onze taken groeien, er ontstaat dynamiek. We willen een shard toevoegen. We volgen de ontwikkeling. We wijzigen onze specificatie. We geven aan dat we twee shards willen.
Dit is hetzelfde bestand dat dynamisch evolueert met de groei van het systeem. Er is geen opslag, dat wordt later besproken, dit is een apart onderwerp.
We voeren de YAML-operator in en kijken wat er uitkomt.
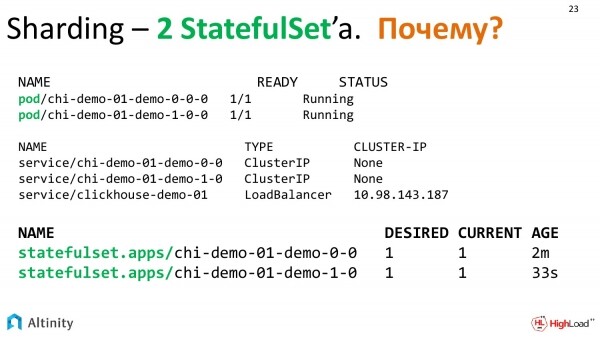
De operator heeft nagedacht en de volgende entiteiten gemaakt. We hebben al twee Pods, drie Services en, verrassend genoeg, 2 StatefulSets. Waarom 2 StatefulSets?
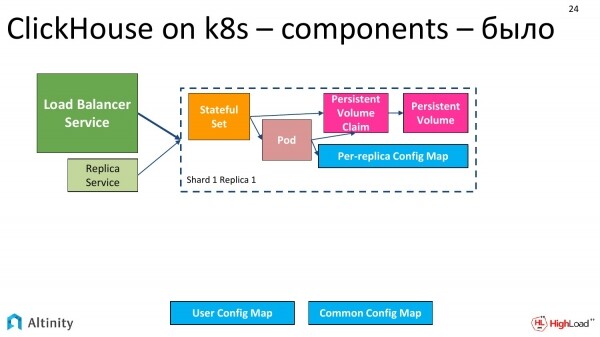
Op het schema was het zo – dit is onze initiële toestand, toen we één pod hadden.
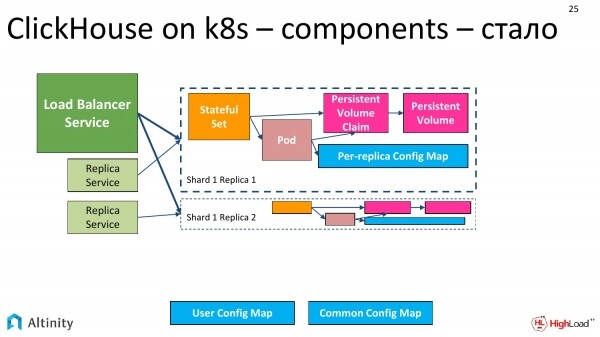
Het is nu zo geworden. Voorlopig is het simpel, het is gedupliceerd.
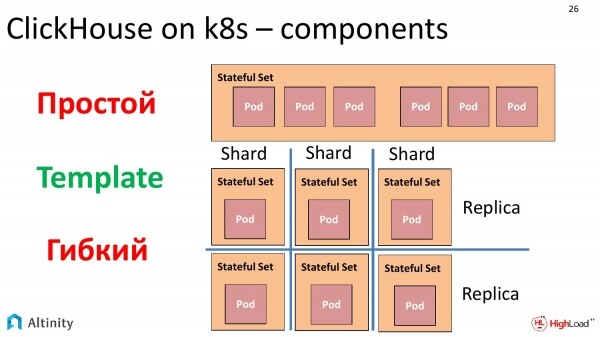
En waarom zijn er nu twee StatefulSets? We moeten even afdwalen en bespreken hoe Kubernetes Pod’s beheert.
Er is een object genaamd StatefulSet, dat het mogelijk maakt om een set Pod’s uit een sjabloon te maken. De sleutel is de Template. En binnen één StatefulSet kunnen veel Pod’s op basis van één sjabloon worden gestart. De sleutelzin hier is 'veel Pod’s op basis van één sjabloon'.
Er was een grote verleiding om de hele cluster in één StatefulSet te verpakken. Dit zou werken, daar zijn geen twijfels over. Maar er is één nuance. Als we een heterogene cluster willen opbouwen, dat wil zeggen met meerdere versies van ClickHouse, dan beginnen we vragen te krijgen. Ja, StatefulSet kan een rolling update doen, ja, je kunt een nieuwe versie aanbrengen, en aangeven dat je niet meer dan zoveel knooppunten tegelijk moet proberen.
Maar als we de taak extrapoleren en zeggen dat we een volledig heterogene cluster willen maken, en we willen niet van de oude versie naar de nieuwe overstappen met een rolling update, maar we willen gewoon een heterogene cluster creëren, zowel qua verschillende versies van ClickHouse als qua verschillende opslag. We willen bijvoorbeeld sommige replica's op afzonderlijke schijven maken, op langzame, in het algemeen een volledig heterogene cluster opbouwen. En omdat StatefulSet een gestandaardiseerde oplossing vanuit één sjabloon creëert, is het niet mogelijk om dat te doen.
Na enige overdenking werd besloten om het op deze manier te doen. Elke replica zit in zijn eigen StatefulSet. Er zijn enkele nadelen aan deze oplossing, maar in de praktijk omvat het volledig de operator. En er zijn veel voordelen. We kunnen een volledig cluster bouwen zoals we willen, bijvoorbeeld absoluut heterogeen. Daarom, in de cluster waar we twee shards met elk één replica hebben, zullen we 2 StatefulSets en 2 Pods hebben, juist omdat we voor deze aanpak hebben gekozen om hierboven genoemde redenen om een heterogene cluster te kunnen bouwen.
Laten we terugkomen op de praktische taken. In onze cluster moeten we gebruikers instellen, dat wil zeggen dat we enige configuratie van ClickHouse in Kubernetes moeten uitvoeren. De operator biedt hiervoor alle mogelijkheden.
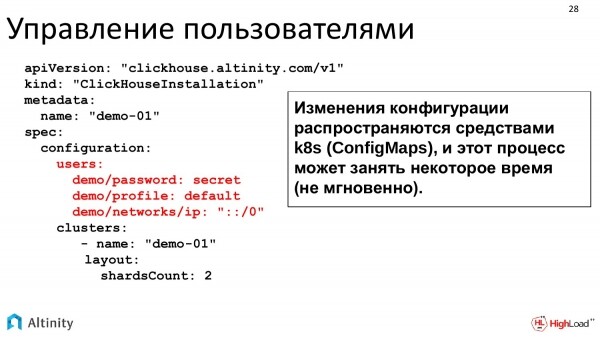
Je kunt rechtstreeks in de YAML schrijven wat we willen. Alle configuratie-opties worden rechtstreeks gemapt vanuit deze YAML naar de ClickHouse-configuraties, die vervolgens over de hele cluster worden verspreid.
Je kunt het ook zo schrijven. Dit is ter illustratie. Een wachtwoord kan encrypted zijn. Alle configuratie-opties van ClickHouse worden volledig ondersteund. Dit is slechts een voorbeeld.
De configuratie van de cluster wordt verspreid als ConfigMap. In de praktijk gebeurt de update van de ConfigMap niet onmiddellijk, dus als het een grote cluster is, kan het enige tijd duren voordat de configuratie is doorgevoerd. Maar dit is allemaal uiterst handig in gebruik.
We complicate the task. The cluster is evolving. We want to replicate data. That is, we already have two shards, with one replica each, and users configured. We are growing and want to engage in replication.
What do we need for replication?
We need ZooKeeper. Replication in ClickHouse is built using ZooKeeper. ZooKeeper is needed so that various ClickHouse replicas have a consensus regarding which data blocks exist on which ClickHouse.
Any ZooKeeper can be used. If the enterprise has an external ZooKeeper, it can be utilized. If not, we can install it from our repository. There is an installer that makes this process easier.
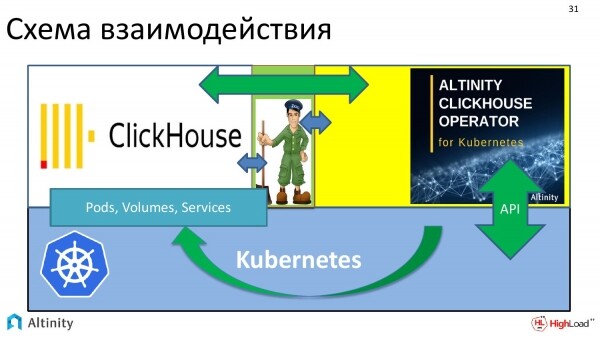
And the interaction scheme of the entire system looks like this. We have Kubernetes as the platform. The ClickHouse operator runs on it. I've depicted ZooKeeper here. The operator interacts with both ClickHouse and ZooKeeper. That is, interaction is established.
And all this is necessary for ClickHouse to successfully replicate data in k8s.
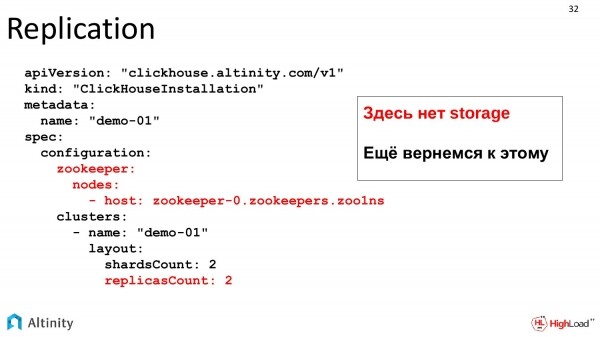
Now let's look at the task itself, at how the manifest for replication will look.
We add two sections to our manifest. The first is where to source ZooKeeper, which can be either within Kubernetes or external. This is just a description. And we request replicas. That is, we want two replicas. Therefore, in total we should have 4 pods. We remember about storage; it will come back a bit later. Storage is a separate matter.
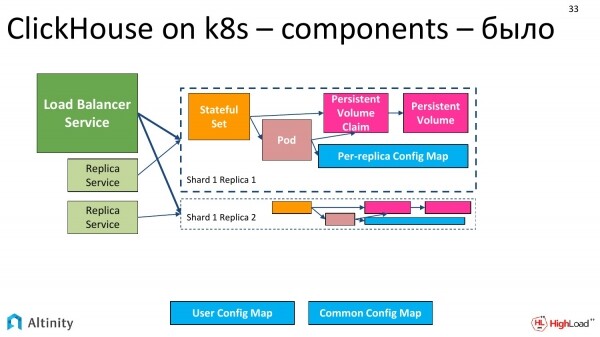
It used to be like this.
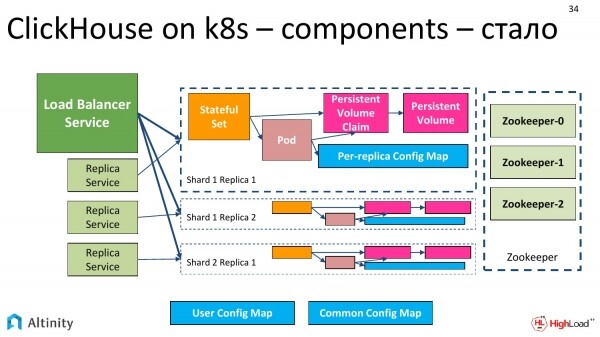
Now it looks like this. Replicas are added. The 4th one didn't fit; we believe there can be many. And ZooKeeper is added on the side. The schemes are becoming more complex.
And it's time to add the next task. We will add Persistent Storage.
 We have various options for Persistent Storage.
In case we are executing in a cloud provider, for example, using Amazon, Google, there is a strong temptation to use cloud storage. It's very convenient; it’s good.
And there is a second option. This is for local storage when we have local disks on each node. This option is much more complicated to implement but is more efficient.
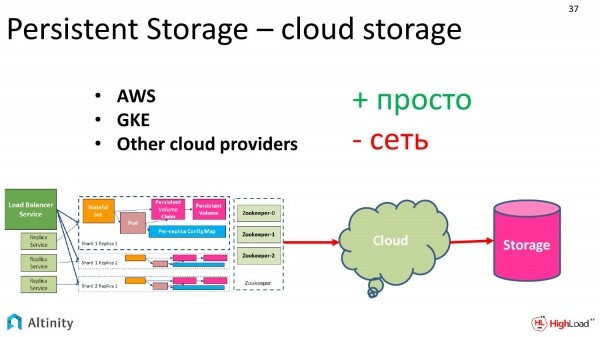
Let's look at what we have regarding cloud storage.
There are advantages. It's very easy to configure. We just order from the cloud provider to please provide us with storage of such capacity and class. The classes are detailed by the providers themselves.
En er is een nadeel. Voor sommige mensen is dit geen kritiekpunt. Natuurlijk zullen er enige prestatieproblemen optreden. Het is zeer handig in gebruik, betrouwbaar, maar er zijn enkele potentiële prestatieverlies.
En omdat ClickHouse zich juist richt op prestatie, kunnen we zelfs zeggen dat het alles eruit haalt wat mogelijk is, daarom proberen veel klanten de maximale prestatie te behalen.
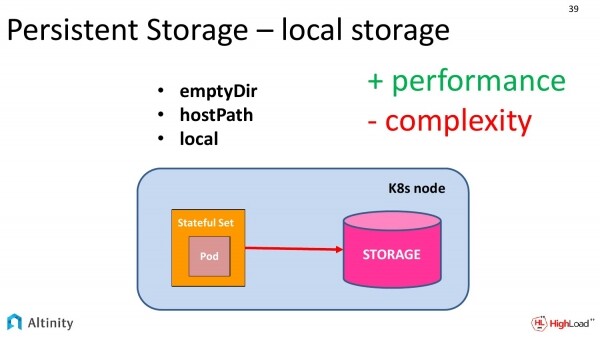
Om het maximale eruit te halen, hebben we lokale opslag nodig.
Kubernetes biedt drie abstracties voor het gebruik van lokale opslag in Kubernetes. Dit zijn:
- EmptyDir
- HostPath.
- Local
Laten we eens kijken naar de verschillen en overeenkomsten.
Ten eerste hebben we in alle drie de benaderingen opslag – dit zijn lokale schijven die zich op dezelfde fysieke k8s-node bevinden. Maar er zijn enkele verschillen.
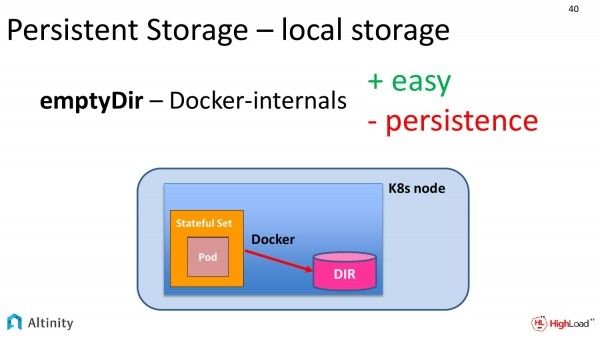
Laten we beginnen met het eenvoudigste, namelijk emptyDir. Wat is dat in de praktijk? Dit is waar we de containerisatie-systeem (meestal Docker) vragen om toegang te geven tot een map op de lokale schijf.
In de praktijk creëert Docker ergens in zijn eigen paden een tijdelijke map, noemt het een lange hash en biedt toegang tot die map.
Hoe zal dit presteren? Het zal functioneren met de snelheid van de lokale schijf, d.w.z. het is volledige toegang tot je HDD.
Maar dit heeft zijn eigen nadeel. Persistentie is hierbij nogal twijfelachtig. Bij de eerste beweging van Docker met containers gaat de persistentie verloren. Als Kubernetes om een of andere reden deze Pod naar een andere schijf wil verplaatsen, gaan de gegevens verloren.
Deze benadering is goed voor tests, omdat de snelheid al acceptabel is, maar dit alternatief is niet geschikt voor iets ernstigs.
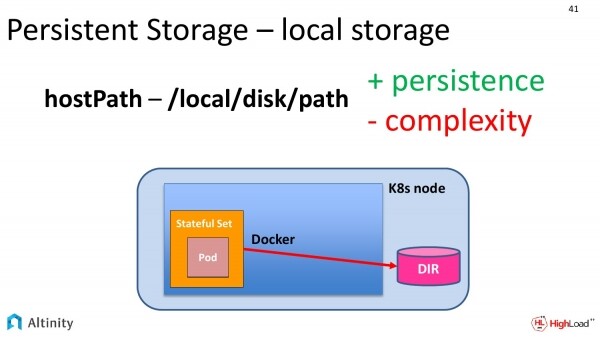
Daarom is er een tweede benadering. Dit is hostPath. Als we naar de vorige dia en deze kijken, zien we slechts één verschil. Onze map is van Docker naar de Kubernetes-node verplaatst. Dit is iets eenvoudiger. We schrijven gewoon het pad in het lokale bestandssysteem op waar we onze gegevens willen opslaan.
Dit heeft voordelen. Het is al echte persistentie, en dan ook klassiek. Onze gegevens worden op de schijf opgeslagen op een bepaalde locatie.
Er zijn ook nadelen. Dit is het beheer. Onze Kubernetes kan besluiten een Pod naar een andere fysieke node te verplaatsen. En hier komt DevOps om de hoek kijken. Hij moet de hele systeem uitleggen dat deze pod's alleen naar nodes kunnen worden verplaatst waar je via deze paden iets gemonteerd hebt, en niet meer dan één node tegelijk. Dit is behoorlijk complex.
Speciaal voor deze doelen hebben we bij onze operator sjablonen gemaakt om al deze complexiteit te verbergen. En je zou gewoon kunnen zeggen: 'Ik wil dat ik één instance ClickHouse heb op elke fysieke node en op zo'n pad.'
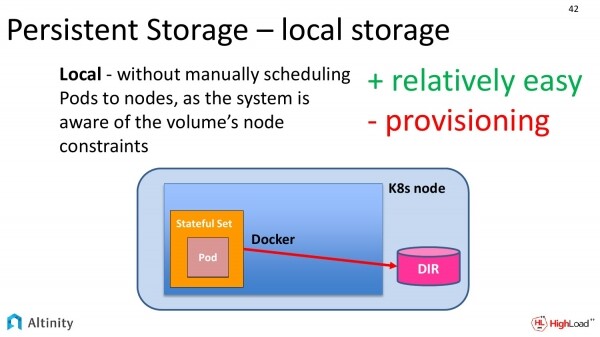
Maar deze noodzaak is niet alleen voor ons, daarom begrijpen de heren van Kubernetes ook dat mensen toegang willen hebben tot fysieke schijven, daarom bieden ze een derde niveau aan.
Dit wordt local genoemd. Het verschil met de vorige slide is vrijwel nul. Eerder moest je handmatig doorgeven dat we deze pod's niet van node naar node konden verplaatsen omdat ze op een bepaald pad aan de lokale fysieke schijf moesten zijn gekoppeld, maar nu worden al deze kennis ingebed in Kubernetes zelf. Het wordt veel eenvoudiger om te configureren.
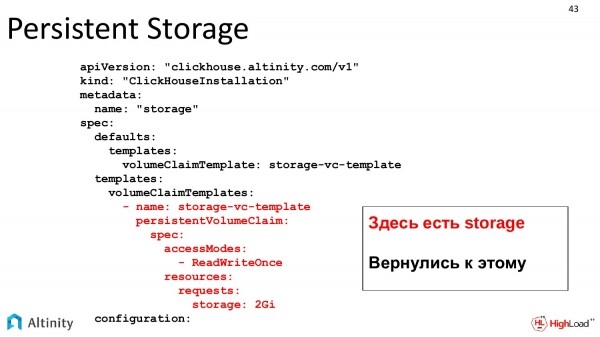
Laten we terugkeren naar onze praktische taak. Laten we terugkeren naar de YAML-sjabloon. Hier hebben we een echte opslag gekregen. We zijn hierop teruggekomen. We stellen de klassieke VolumeClaim-sjabloon in zoals in k8s. En beschrijven welke opslag we willen.
Daarna zal k8s de opslag aanvragen. Het zal ons deze toewijzen in StatefulSet. En uiteindelijk komt dit beschikbaar voor ClickHouse.
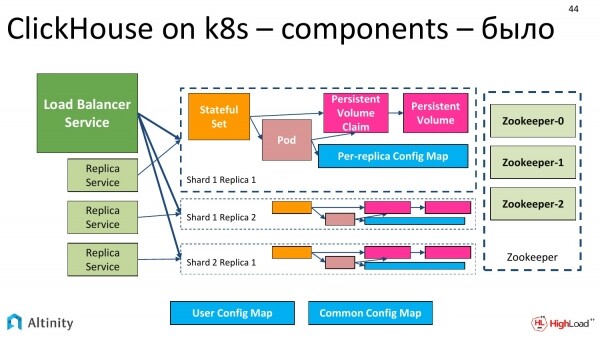
We hadden zo'n schema. Onze Persistent Storage was rood, wat als een hint kwam dat het nodig was om dit te maken.
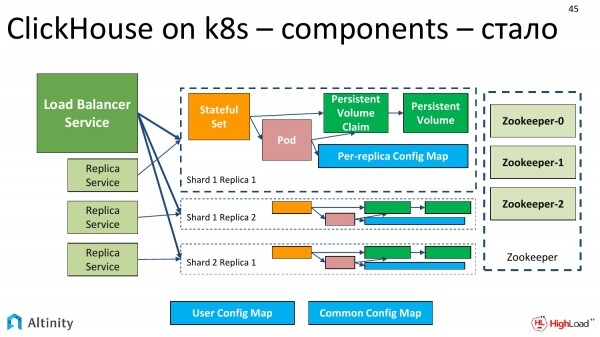
En het wordt groen. Nu is het schema van de ClickHouse-cluster op k8s volledig afgerond. We hebben shards, replica's, ZooKeeper, er is een echte Persistent die op de een of andere manier is gerealiseerd. Het schema is al volledig operationeel.
We gaan verder met ons leven. Onze cluster ontwikkelt zich. En Alexey doet zijn best en brengt een nieuwe versie van ClickHouse uit.
Er ontstaat een praktische taak – de nieuwe versie van ClickHouse op onze cluster te testen. En natuurlijk willen we deze niet allemaal in één keer inzetten, we willen misschien in een ver hoek een nieuwe versie op één replica plaatsen, of misschien niet één nieuwe versie, maar meteen twee, omdat ze regelmatig uitkomen.
Wat kunnen we hierover zeggen?
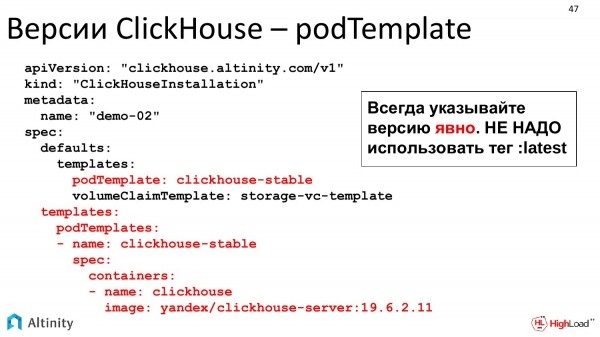
Hier hebben we precies zo'n mogelijkheid. Dit zijn de pod-sjablonen. We kunnen het opstellen, onze operator staat volledig toe om een heterogene cluster op te bouwen. Dat wil zeggen, configureren, beginnend met alle replica's in een hoop, tot elke persoonlijke replica waarbij we willen welke versie van ClickHouse we willen, welke versie van de opslag we willen. We kunnen het cluster volledig configureren volgens onze behoeften.
We gaan nu iets dieper in de materie. Eerder spraken we over hoe de ClickHouse-operator werkt, specifiek voor ClickHouse.
Nu wil ik een paar woorden zeggen over hoe elke operator in het algemeen werkt, en hoe deze samenwerkt met K8s.
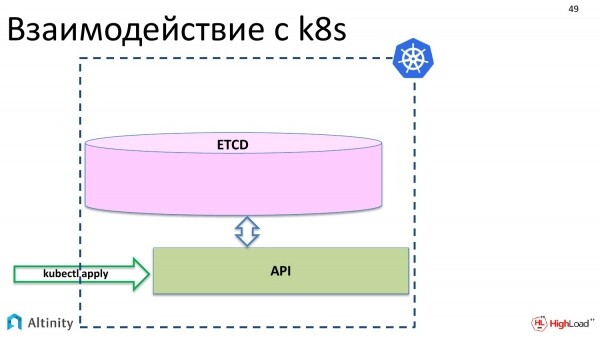
Laten we beginnen met de interactie met K8s. Wat gebeurt er wanneer we kubectl apply uitvoeren? Onze objecten verschijnen via de API in etcd.
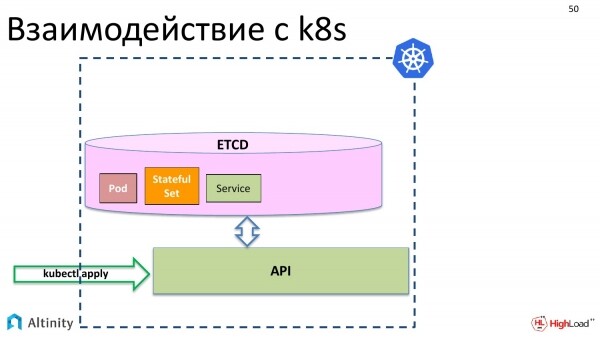
Bijvoorbeeld de basisobjecten van Kubernetes: pod, StatefulSet, service, enzovoort.
Op dat moment gebeurt er nog niets fysiek. Deze objecten moeten in de cluster worden gematerialiseerd.
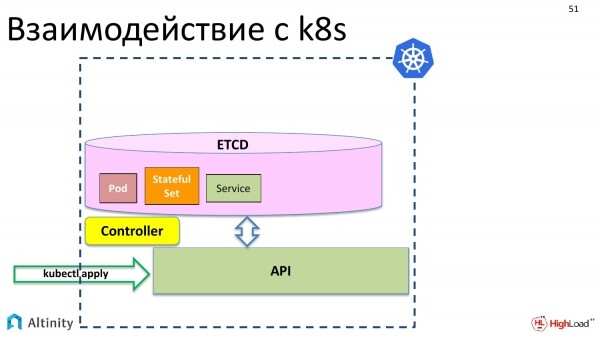
Daarvoor verschijnt de controller. De controller is een speciale component van K8s die in staat is om deze beschrijvingen te materialiseren. Hij weet hoe en wat er fysiek moet gebeuren. Hij weet hoe hij containers moet opstarten en wat er moet worden ingesteld om de server te laten werken.
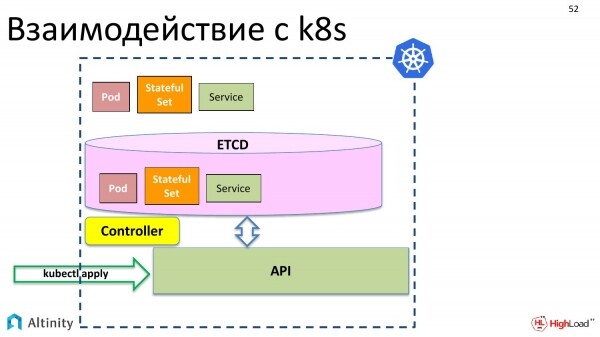
En hij materialiseert onze objecten in K8s.
Maar we willen niet alleen met pod's en StatefulSet's werken, we willen een ClickHouseInstallation creëren, dat wil zeggen, een object van het type ClickHouse, zodat we het als een geheel kunnen beheren. Tot nu toe is zo'n mogelijkheid er niet.
Maar K8s heeft nog een prettig kenmerk. We willen dat er ergens zo'n complexe entiteit ontstaat, die ons cluster verzamelt vanuit pod's en StatefulSet's.
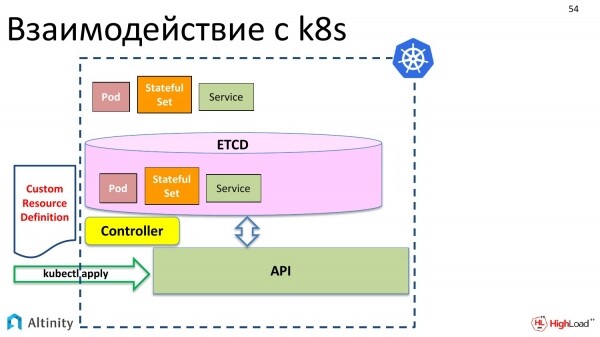
En wat moet daarvoor gedaan worden? Ten eerste komt de Custom Resource Definition in beeld. Wat is dat? Dit is een beschrijving voor K8s dat er een extra datatypes zal zijn, dat we een aangepaste bron willen toevoegen aan de pod, StatefulSet, die complex binnenin zal zijn. Dit is de beschrijving van de datastructuur.
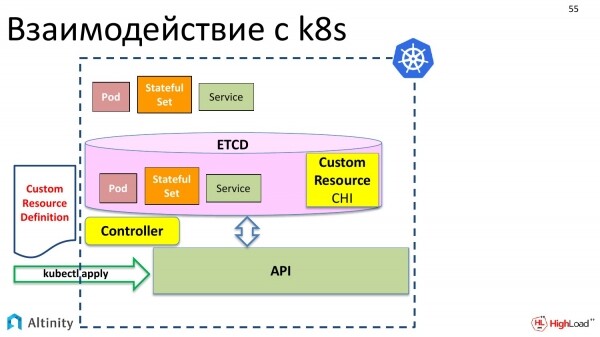
We sturen het ook via kubectl apply daarheen. Kubernetes heeft het met plezier opgepakt.
En nu hebben we in de opslag, bij het object in etcd, de mogelijkheid om een aangepaste bron genaamd ClickHouseInstallation op te slaan.
Maar voorlopig zal er niets verder gebeuren. Met andere woorden, als we nu het YAML-bestand aanmaken dat we hebben besproken met de beschrijving van shards, replicas en we zeggen 'kubectl apply', dan zal Kubernetes het accepteren, het opslaan in etcd en zeggen: 'Prima, maar ik weet niet wat ik ermee moet doen. Hoe een ClickHouseInstallation te onderhouden weet ik niet.'
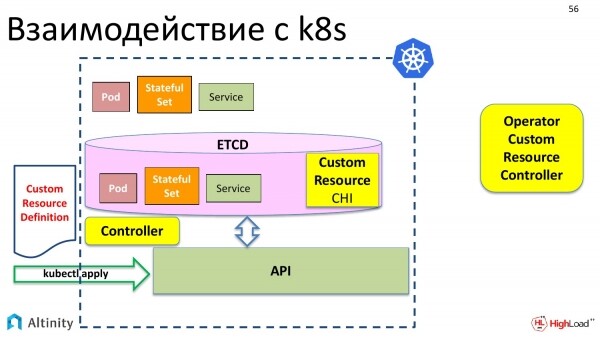
Daarom hebben we iemand nodig die Kubernetes kan helpen bij het onderhouden van een nieuw datatype. Links hebben we de standaard Kubernetes-controller, die werkt met standaard datatypen. En rechts moet er een aangepaste controller verschijnen die kan werken met aangepaste datatypen.
En anders wordt het een operator genoemd. Ik heb hem hier specifiek buiten Kubernetes geplaatst, omdat hij ook buiten K8s kan draaien. Meestal draaien alle operators natuurlijk in Kubernetes, maar er is niets dat hem tegenhoudt om buiten te staan, dus daarom is hij hier speciaal naar buiten geplaatst.
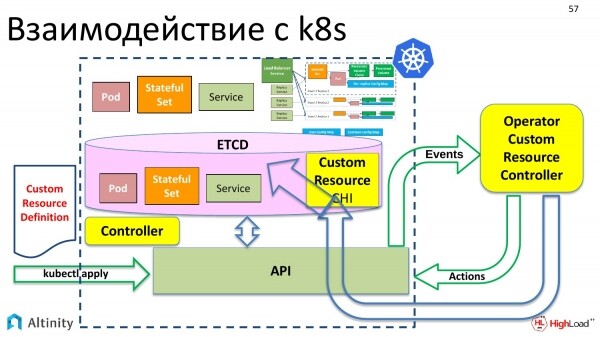
En de aangepaste controller, oftewel de operator, interacteert met Kubernetes via de API. Hij kan al communiceren met de API. En hij weet al hoe hij uit het aangepaste resource een complexe schema kan materialiseren die we willen maken. Dat is precies wat de operator doet.
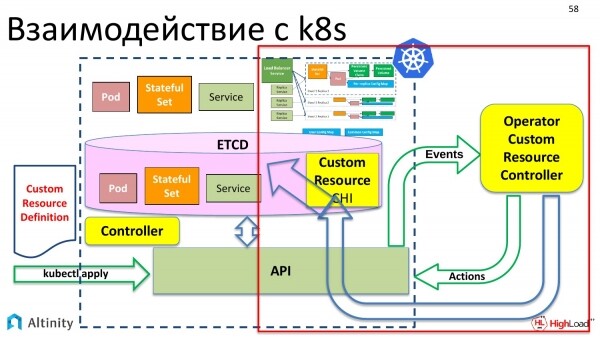
Hoe werkt de operator? Laten we naar de rechterkant kijken om te ontdekken hoe hij dit doet. We zullen leren hoe de operator alles materialiseert en hoe de interactie met K8s verder verloopt.
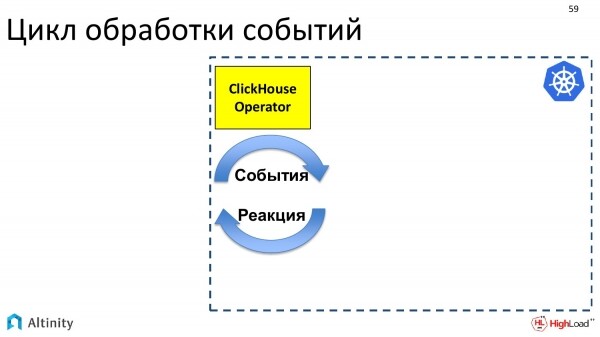
De operator is een programma. Het is gebeurtenisgestuurd. De operator abonneert zich via de Kubernetes API op gebeurtenissen. In de Kubernetes API zijn er toegangspunten waar je je op gebeurtenissen kunt abonneren. En als er iets verandert in K8s, dan stuurt Kubernetes gebeurtenissen naar iedereen die geïnteresseerd is, dat wil zeggen, wie zich op dit API-punt heeft geabonneerd, die zal meldingen ontvangen.
De operator abonneert zich op gebeurtenissen en moet een bepaalde reactie geven. Zijn taak is om te reageren op de opkomende gebeurtenissen.
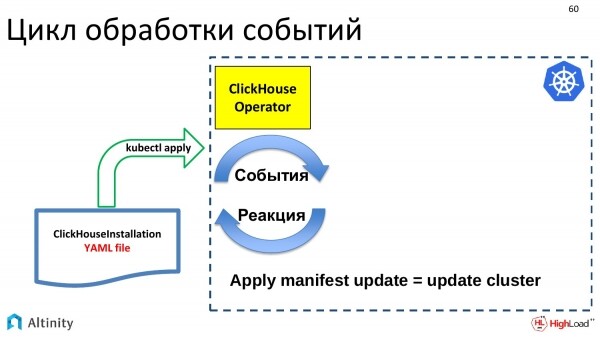
Gebeurtenissen worden gegenereerd door bepaalde updates. Ons YAML-bestand met de beschrijving van ClickHouseInstallation komt binnen. Het is via kubectl apply in etcd gegaan. Daar vond een gebeurtenis plaats, uiteindelijk kwam deze gebeurtenis bij de ClickHouse-operator aan. De operator ontving deze beschrijving. En hij moet iets doen. Als er een update op het ClickHouseInstallation-object is binnengekomen, dan moet het cluster worden geüpdatet. En de taak van de operator is om het cluster te updaten.
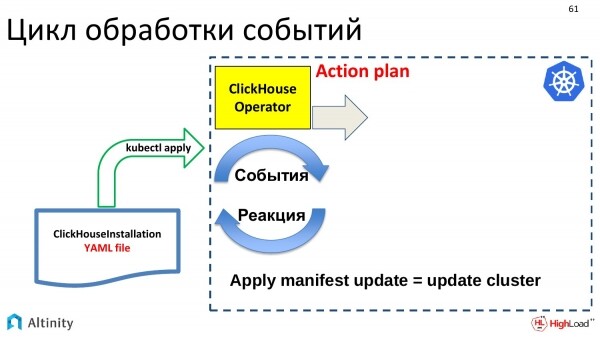
Wat doet hij? Ten eerste moet er een actieplan worden opgesteld over wat we met deze update gaan doen. Updates kunnen heel klein zijn, zoals kleine YAML-uitvoeringen, maar kunnen zeer grote veranderingen in het cluster met zich meebrengen. Daarom stelt de operator een plan op en houdt zich daar vervolgens aan.
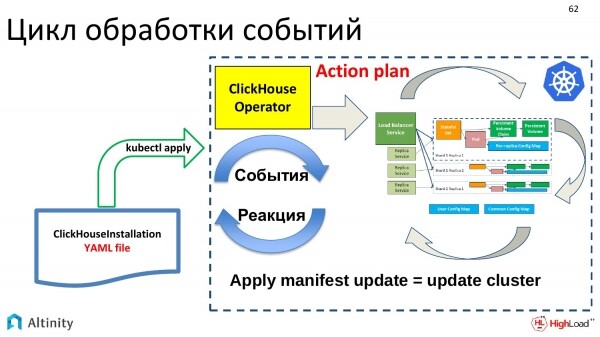
Hij begint volgens dit plan deze structuur binnenin te bouwen om pods en services te materialiseren, dat wil zeggen, om te doen wat zijn belangrijkste taak is. Dit is vergelijkbaar met het bouwen van een ClickHouse-cluster in Kubernetes.
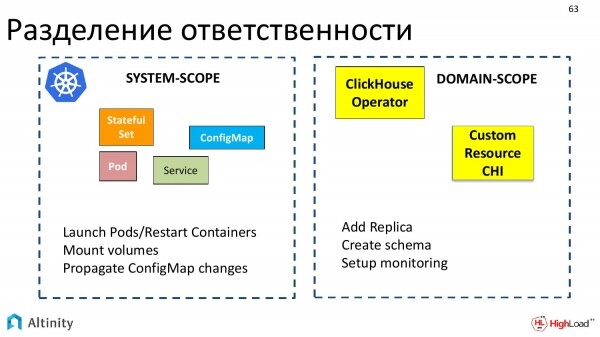
Laten we nu een interessant onderwerp aansnijden. Het gaat om de verdeling van verantwoordelijkheden tussen Kubernetes en de operator, dat wil zeggen, wat Kubernetes doet, wat de operator doet en hoe zij met elkaar omgaan.
Kubernetes is verantwoordelijk voor systeemzaken, dat wil zeggen, voor de basisset objecten die geïnterpreteerd kunnen worden als system-scope. Kubernetes weet hoe hij pods moet starten, hoe hij containers moet herstarten, hoe hij volumes moet aanmaken, hoe hij met ConfigMaps moet werken, dat wil zeggen, alles wat je een systeem kunt noemen.
Operators opereren in specifieke domeinen. Iedere operator is ontworpen voor zijn eigen domein. Wij hebben die voor ClickHouse gemaakt.
En de operator werkt precies in termen van zijn domein, zoals een replica toevoegen, een schema maken, monitoring instellen. Dit resulteert in een dergelijke verdeling.
Laten we kijken naar een praktisch voorbeeld van hoe deze verdeling van verantwoordelijkheden plaatsvindt wanneer we de actie 'voeg een replica toe' uitvoeren.
De operator ontvangt de taak - voeg een replica toe. Wat doet de operator? De operator berekent dat er een nieuwe StatefulSet moet worden gemaakt, waarin bepaalde sjablonen en volumeclaims moeten worden beschreven.
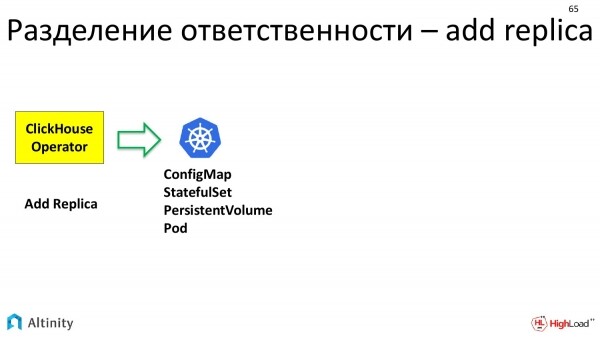
Hij heeft dit alles voorbereid en geeft het door aan K8s. Hij zegt dat hij een ConfigMap, StatefulSet en Volume nodig heeft. Kubernetes gaat aan de slag. Het materialiseert de basis eenheden waarmee hij werkt.
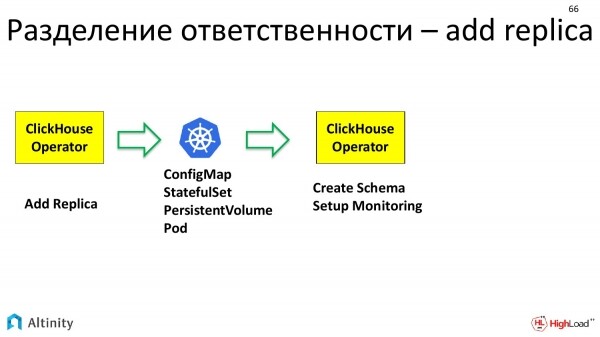
En dan komt de ClickHouse-operator weer in beeld. Hij heeft al een fysieke pod waar iets mee gedaan kan worden. En de ClickHouse-operator werkt opnieuw in termen van het domein. Dat wil zeggen, om een replica in het cluster in te schakelen, moet je ten eerste het gegevensschema dat in dit cluster aanwezig is, instellen. Ten tweede moet deze replica in de monitoring worden opgenomen, zodat deze goed te volgen is. De operator stelt dit in.
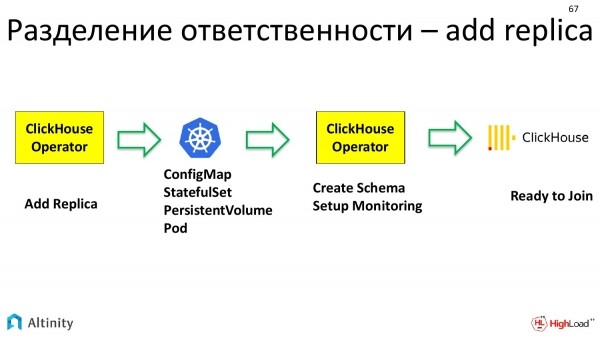
En pas daarna komt ClickHouse zelf in beeld, dat is een hogere laag. Dit is al een database. Het heeft zijn eigen instantie, een opnieuw geconfigureerde replica die klaar is om in de cluster te stappen.
Het blijkt dat de keten van uitvoering en het verdelen van verantwoordelijkheden bij het toevoegen van een replica behoorlijk lang is.
Laten we doorgaan met onze praktische taken. Als de cluster al bestaat, kunnen we de configuratie migreren.
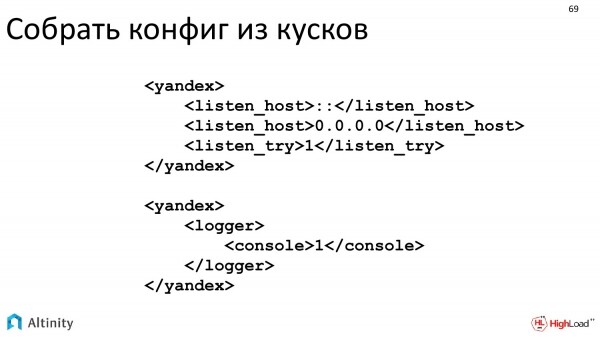
We hebben het zo gedaan dat we in de bestaande XML, die ClickHouse begrijpt, doorheen kunnen sturen.
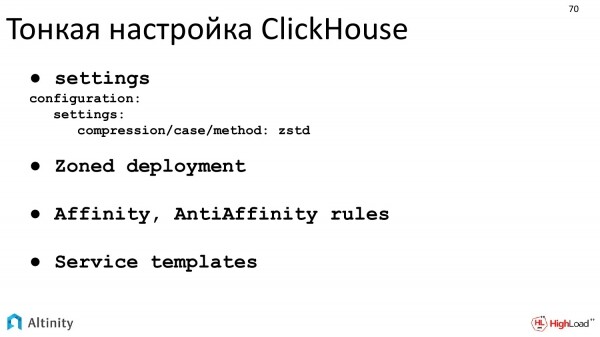
Je kunt ClickHouse fijn afstemmen. Precies de zonale implementatie – dat is wat ik uitlegde bij het toelichten van hostPath, lokale opslag. Dit is hoe je een zonale implementatie goed moet aanpakken.
De volgende praktische taak is monitoring.
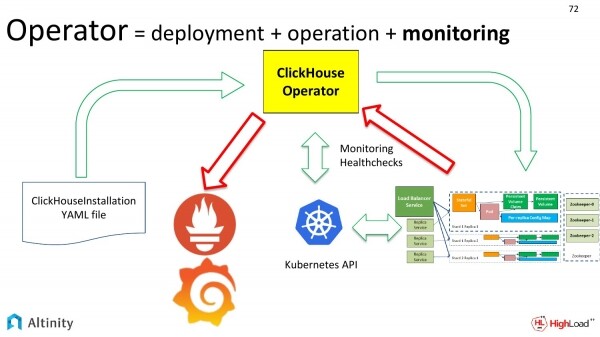
Als onze cluster verandert, moet de monitoring periodiek worden ingesteld.
Laten we het schema bekijken. We hebben de groene pijlen hier al besproken. Laten we nu de rode pijlen bekijken. Dit is hoe we onze cluster willen monitoren. Hoe metrics van de ClickHouse-cluster in Prometheus terechtkomen en daarna in Grafana.
Wat is het probleem met monitoring? Waarom wordt dit als een prestatie beschouwd? De moeilijkheid ligt precies in de dynamiek. Wanneer we één cluster hebben en het statisch is, kan de monitoring één keer worden ingesteld en verder niet meer worden behandeld.
Maar als we veel clusters hebben, of als er voortdurend iets verandert, dan is het een dynamisch proces. En continu het opnieuw instellen van de monitoring is een verspilling van middelen en tijd, oftewel, zelfs gewoon luiheid. Dit moet geautomatiseerd worden. De moeilijkheid ligt juist in de dynamiek van het proces. En de operator automatiseert dit heel goed.
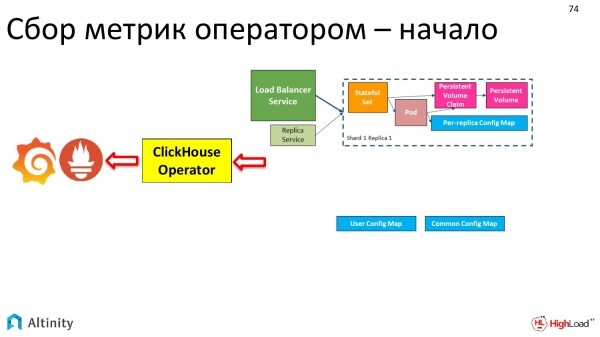
Hoe is onze cluster geëvolueerd? In het begin was hij zo.
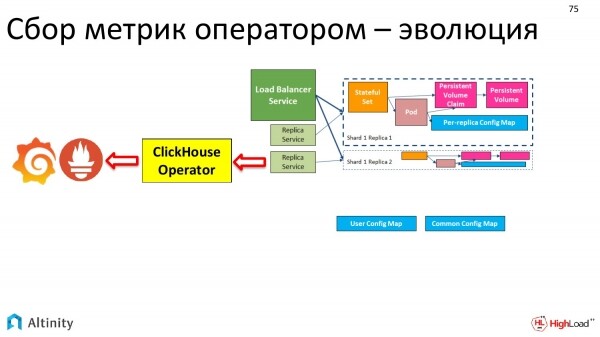
Toen was hij zo.
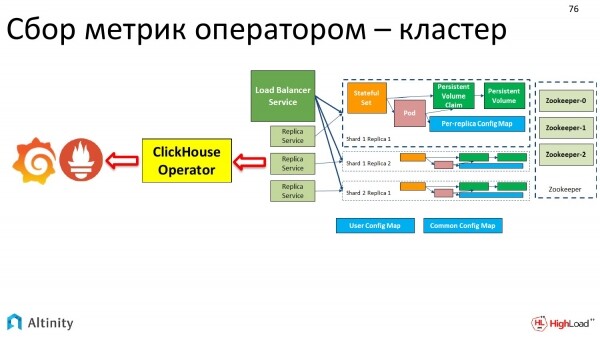
Uiteindelijk is hij zo geworden.
De monitoring wordt automatisch gedaan door de operator. Één toegangspunt.
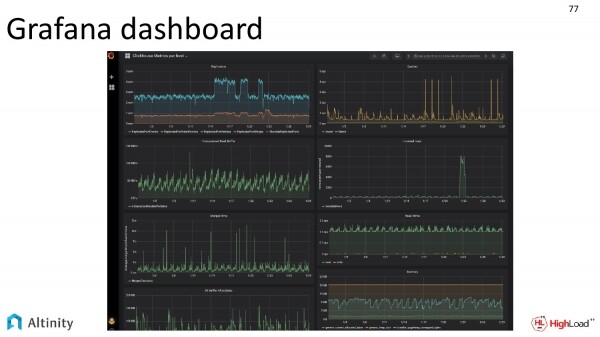
En we kijken slechts op de output in het Grafana-dashboard, hoe het leven binnen onze cluster zich ontwikkelt.
Overigens wordt het Grafana-dashboard ook verspreid met onze operator, rechtstreeks in de bronbestanden. Je kunt het aansluiten en gebruiken. Deze schermafbeelding is me gegeven door onze DevOps.
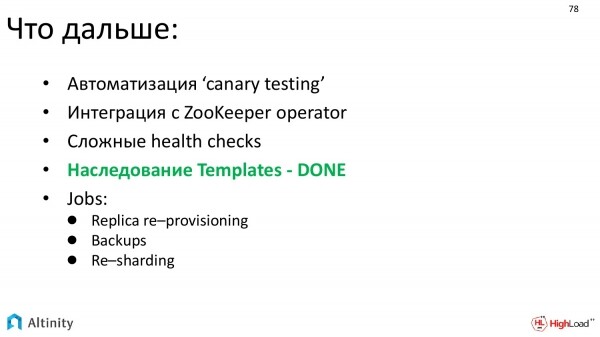
Waar zouden we verder naartoe willen? Dit is:
- Automatisering van testen verder ontwikkelen. Het belangrijkste doel is geautomatiseerd testen van nieuwe versies.
- Wij willen ook graag de integratie met ZooKeeper automatiseren. En we zijn van plan om te integreren met de ZooKeeper-operator. Dat wil zeggen, er is een operator voor ZooKeeper geschreven en het is logisch dat de twee operators beginnen te integreren voor een meer gebruiksvriendelijke oplossing.
- We willen complexere levensbig checks maken.
- Ik heb in het groen gemarkeerd wat binnenkort aan de beurt is, de erfenis van Templates - KLAAR, d.w.z. met de volgende release van de operator hebben we al de erfenis van templates. Dit is een krachtig hulpmiddel dat het mogelijk maakt om complexe configuraties samen te stellen uit stukjes.
- En we willen de automatisering van complexe taken. De belangrijkste hiervan is Re-sharding.
Laten we een tussenresultaat bespreken.
Wat krijgen we aan het einde? En is het de moeite waard om hieraan te werken of niet? Moeten we überhaupt proberen om de database naar Kubernetes te brengen en de operator in zijn geheel toe te passen, en specifiek de Alitnity-operator?
Aan het einde krijgen we:
- Een aanzienlijke vereenvoudiging en automatisering van configuratie, implementatie en onderhoud.
- Directe ingebouwde monitoring.
- En kant-en-klare gecodificeerde templates voor complexe situaties. Handmatige acties zoals het toevoegen van replicas zijn niet meer nodig. Dat doet de operator.
Er is nog maar één laatste vraag. We hebben al een database in Kubernetes, virtualisatie. Hoe zit het met de prestaties van zo'n oplossing, vooral gezien het feit dat ClickHouse geoptimaliseerd is voor prestaties?
Antwoord - alles is in orde! Ik zal niet in detail treden, dit is een onderwerp voor een aparte presentatie.
Maar er is zo'n project als TSBS. Wat is de belangrijkste taak hiervan? Dit is een test van databases op prestaties. Proberen om warme dingen met warme dingen, zachte dingen met zachte dingen te vergelijken.
Hoe werkt het? Er wordt één dataset gegenereerd. Vervolgens wordt deze dataset op dezelfde set tests op verschillende databases uitgevoerd. En elke database lost één taak op zoals zij dat kan. En daarna kunnen de resultaten worden vergeleken.
Het ondersteunt al een grote hoeveelheid databases. Ik heb drie hoofdgroepen выделен. Dit zijn:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
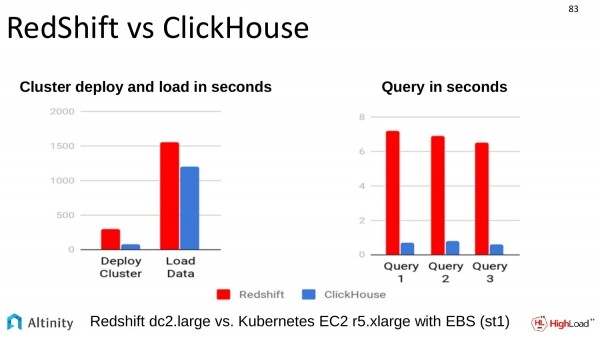
Er is ook een vergelijking gedaan met een andere vergelijkbare oplossing. Een vergelijking met RedShift. De vergelijking is uitgevoerd op Amazon. ClickHouse overtreft ook iedereen goed op dit gebied.
Wat kunnen we concluderen uit wat ik heb verteld?
- DB in Kubernetes is mogelijk. Waarschijnlijk zijn alle databases mogelijk, maar over het algemeen lijkt het erop dat het kan. ClickHouse in Kubernetes kan zeker worden uitgevoerd met behulp van onze operator.
- De operator helpt processen te automatiseren en vereenvoudigt echt het leven.
- De prestaties zijn normaal.
- En wij denken dat dit kan en moet worden gebruikt.
Open source – sluit je aan!
Zoals ik al zei, is de operator een volledig open source product, dus het zou geweldig zijn als zoveel mogelijk mensen het gebruiken. Sluit je aan! We wachten op jullie allemaal!
Bedankt iedereen!
Vragen
Dank u voor de presentatie! Mijn naam is Anton. Ik kom van SEMrush. Ik ben benieuwd naar logging. Over monitoring hebben we gehoord, maar over logging niets, als we het hele cluster bekijken. Bij ons hebben we bijvoorbeeld een cluster draaien op hardware. En we gebruiken gecentraliseerde logging, we verzamelen standaard middelen in één grote hoop. En daaruit halen we vervolgens de interessante gegevens.
Goede vraag, d.w.z. logging staat op de todo-lijst. Onze operator automatiseert dit voorlopig nog niet. Het ontwikkelt zich nog, het project is nog vrij jong. We begrijpen de noodzaak van logging. Dit is ook een zeer belangrijk onderwerp. En het is waarschijnlijk niet minder belangrijk dan monitoring. Maar monitoring had de hoogste prioriteit voor implementatie. Logging komt er aan. We doen ons best om alle aspecten van het cluster te automatiseren. Dus het antwoord is – op dit moment kan de operator dit helaas nog niet, maar het staat op de planning, we zullen het doen. Als je wilt bijdragen, stuur dan alsjeblieft een pull request.
Hallo! Bedankt voor de presentatie! Ik heb een standaard vraag over Persistent Volumes. Wanneer we met deze operator een configuratie aanmaken, hoe bepaalt de operator op welke node een schijf of map is gemount? Moeten we hem van tevoren uitleggen dat hij onze ClickHouse op deze nodes moet plaatsen waar de schijf is?
Voor zover ik begrijp, is deze vraag een vervolg op local storage, vooral het gedeelte over hostPath. Het is als het uitleggen aan het systeem dat een pod op precies die node moet worden gestart, waar we een fysiek aangesloten schijf hebben die op een bepaald pad is gemount. Dit is een heel stuk waar ik heel oppervlakkig op in ben gegaan, omdat het antwoord behoorlijk groot is.
Kortom, dit is hoe het eruit ziet. We moeten natuurlijk de provisioning van deze volumes uitvoeren. Op dit moment is er geen dynamische provisioning in lokale opslag, dus de DevOps-teams moeten zelf de schijven aanmaken, deze volumes. En ze moeten Kubernetes uitleggen dat we Persistent Volumes van een bepaald type hebben, die zich op bepaalde nodes bevinden. Daarna moet uitgelegd worden aan Kubernetes dat pods die een bepaalde soort lokale opslag vereisen, alleen op die specifieke nodes moeten worden gepland, op basis van labels. Voor dit doel kan de operator een label toegewezen aan een instance per host. Dit zorgt ervoor dat de pods door Kubernetes worden gerouteerd naar nodes die voldoen aan de voorwaarden van de labels, om het eenvoudig te zeggen. Beheerders stellen labels in en voeren handmatig de provisioning van de schijven uit. En dan is het schaalbaar.
En precies de derde optie maakt lokale opslag iets eenvoudiger. Zoals ik al benadrukte, is het een nauwgezette instelling dat uiteindelijk helpt om maximale prestaties te behalen.
Ik heb een tweede vraag met betrekking tot dit onderwerp. Kubernetes is ontworpen met het idee dat het ons niet uitmaakt of we een node verliezen of niet. Wat moeten we in dit geval doen als we de node verliezen waar een shard op draait?
Ja, Kubernetes is oorspronkelijk gepositioneerd met de gedachte dat onze relatie met onze pods is als met vee, en nu wordt elke schijf iets als een huisdier. Er is een probleem dat we ze niet gewoon kunnen weggooien. En de ontwikkeling van Kubernetes gaat in de richting dat we niet volledig en filosofisch kunnen omgaan met deze middelen als iets dat helemaal weg te gooien is.
Nu een praktische vraag. Wat te doen als je een node verliest waarop een schijf was? Dit probleem wordt op een hoger niveau opgelost. In het geval van ClickHouse hebben we replicas die op een hoger niveau werken, dat wil zeggen, op het niveau van ClickHouse.
Wat is de uiteindelijke situatie? De verantwoordelijkheden voor het behoud van de gegevens liggen bij DevOps. Zij moeten de replicatie goed instellen en zorgen dat de replicatie wordt uitgevoerd. In de replica op het level van ClickHouse moeten de gegevens zijn gedupliceerd. Dit is niet de taak van de operator. En dit is ook niet de taak van Kubernetes zelf. Dit moet op het niveau van ClickHouse gebeuren.
Wat te doen als je een fysieke node is uitgevallen? Het blijkt dat we een tweede moeten zetten, de schijf correct provisioneren, labels aanbrengen. En daarna voldoet deze aan de eisen zodat Kubernetes er een instance pod kan starten. Kubernetes zal het opstarten. Je hebt immers niet genoeg pods om aan de vereisten te voldoen. Het zal door de cyclus gaan die ik heb getoond. En op het hoogste niveau zal ClickHouse begrijpen dat er een replica is binnengekomen, die nog leeg is en waarop we moeten beginnen met het overzetten van gegevens. Dit proces is echter nog slecht geautomatiseerd.
Dank voor de presentatie! Wanneer er allerlei vervelende dingen gebeuren, valt de operator uit en reboot, en op dat moment komen er gebeurtenissen binnen, hoe verwerk je dit?
Wat gebeurt er als de operator uitvalt en herstart, toch?
Ja. En op dat moment kwamen er gebeurtenissen binnen.
De taak van wat te doen in dit geval wordt gedeeltelijk gedeeld tussen de operator en Kubernetes. Kubernetes heeft de mogelijkheid om de gebeurtenissen opnieuw af te spelen. Het speelt het opnieuw af. En de taak van de operator is ervoor te zorgen dat, wanneer er een replay van de log van gebeurtenissen op hem wordt uitgevoerd, deze gebeurtenissen idempotent zijn. En dat het opnieuw binnenkomen van dezelfde gebeurtenis onze systeem niet breekt. En onze operator slaagt in deze taak.
Hallo! Dank voor de presentatie! Dmitry Zavyalov, bedrijf Smedova. Is het mogelijk om in de operator de mogelijkheid te integreren om met haproxy te configureren? Ik ben geïnteresseerd in een andere balancer dan de standaard, zodat deze slim is en begrijpt dat er daadwerkelijk ClickHouse is.
Heb je het over Ingress?
Ja, vervang Ingress door haproxy. In haproxy kun je de topologie van de cluster opgeven, waar zijn replicas zich bevinden.
Tot nu toe hebben we daar nog niet over nagedacht. Als je het nodig hebt en kunt uitleggen waarom, dan kan het gerealiseerd worden, vooral als je wilt deelnemen. We bekijken het graag. Korte antwoord – nee, we hebben momenteel geen dergelijke functionaliteit. Dank voor de suggestie, we zullen dit bekijken. En als je ook de use case uitlegt en waarom het praktisch nodig is, bijvoorbeeld door issues op GitHub aan te maken, zou dat geweldig zijn.
Het is er al.
Goed. We staan open voor alle suggesties. En haproxy komt op de to-do lijst. De to-do lijst groeit, en vermindert voorlopig niet. Maar dat is goed, dat betekent dat het product in trek is.
Bron: habr.com
