

In mijn werk kom ik vaak nieuwe technische oplossingen/softwareproducten tegen waarover er weinig informatie beschikbaar is in het Nederlandstalige internet. Met dit artikel hoop ik een dergelijk gat te vullen met een voorbeeld uit mijn recente praktijk, toen het nodig was om de verzending van CDC-gebeurtenissen van twee populaire DBMS (PostgreSQL en MongoDB) naar een Kafka-cluster in te stellen met behulp van Debezium. Ik hoop dat dit overzichtelijke artikel, dat is ontstaan uit het verrichte werk, ook voor anderen nuttig zal zijn.
Wat is Debezium en wat is CDC eigenlijk?
is een vertegenwoordiger van de categorie software voor CDC (), en als we het preciezer zeggen — het is een set van connectors voor verschillende DBMS die compatibel zijn met het Apache Kafka Connect-framework.
Dit is dat de Apache License v2.0 gebruikt en wordt gesponsord door Red Hat. De ontwikkeling gaat sinds 2016 door en momenteel ondersteunt het officieel de volgende DBMS: MySQL, PostgreSQL, MongoDB, SQL Server. Er zijn ook connectors voor Cassandra en Oracle, maar die zijn momenteel in de status van 'vroege toegang' en nieuwe releases garanderen geen achterwaartse compatibiliteit.
Als we CDC vergelijken met de traditionele aanpak (waarbij een applicatie gegevens rechtstreeks uit een DBMS leest), dan zijn de belangrijkste voordelen de implementatie van datastreaming op rijniveau met lage latentie, hoge betrouwbaarheid en beschikbaarheid. De laatste twee punten worden bereikt door gebruik te maken van een Kafka-cluster als opslag voor CDC-gebeurtenissen.
Andere voordelen zijn het feit dat er een eenduidig model voor het opslaan van gebeurtenissen wordt gebruikt, waardoor de eindapplicatie zich geen zorgen hoeft te maken over de nuances van het werken met verschillende DBMS.
Ten slotte opent het gebruik van een berichtenbroker de mogelijkheid voor horizontale schaalvergroting van applicaties die veranderingen in gegevens volgen. Daarbij is de impact op de gegevensbron minimaal, aangezien de gegevens niet rechtstreeks uit de DBMS worden verkregen, maar uit het Kafka-cluster.
Over de architectuur van Debezium
Het gebruik van Debezium komt neer op een heel eenvoudig schema:
DBMS (als gegevensbron) → connector in Kafka Connect → Apache Kafka → consument
Ter illustratie geef ik een schema van de projectwebsite:
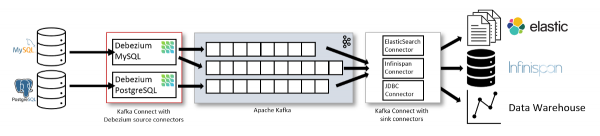
Echter, ik hou niet zo van dit schema, omdat het de indruk wekt dat alleen het gebruik van sink-connector mogelijk is.
In werkelijkheid is de situatie anders: de inhoud van uw Data Lake (de laatste schakel in het bovenstaande schema) — is niet de enige manier om Debezium toe te passen. Gebeurtenissen die naar Apache Kafka worden verzonden, kunnen door uw applicaties worden gebruikt om verschillende situaties op te lossen. Bijvoorbeeld:
- het verwijderen van verouderde gegevens uit de cache;
- verzending van meldingen;
- updates van zoekindexen;
- een soort auditlogboeken;
- …
Als u een applicatie in Java heeft en het niet nodig of mogelijk is om een Kafka-cluster te gebruiken, is er ook de mogelijkheid om te werken via . Een voor de hand liggend voordeel is dat u extra infrastructuur (in de vorm van de connector en Kafka) kunt vermijden. Deze oplossing is echter als verouderd (deprecated) gemarkeerd sinds versie 1.1 en wordt niet langer aanbevolen (de ondersteuning kan in toekomstige releases worden verwijderd).
In dit artikel wordt de door de ontwikkelaars aanbevolen architectuur behandeld, die redundantie en schaalbaarheid waarborgt.
Configuratie van de connector
Om te beginnen met het volgen van veranderingen in de belangrijkste waarde — gegevens — hebben we nodig:
- een gegevensbron, die MySQL kunnen zijn, beginnend vanaf versie 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- een Apache Kafka-cluster;
- een Kafka Connect-instantie (versies 1.x, 2.x);
- een geconfigureerde Debezium-connector.
De werkzaamheden aan de eerste twee punten, namelijk het installatieproces van de DBMS en Apache Kafka, vallen buiten de reikwijdte van dit artikel. Voor degenen die alles in een sandbox willen implementeren, is er in de officiële repository met voorbeelden een kant-en-klare .
We zullen ons echter meer richten op de laatste twee punten.
0. Kafka Connect
Hier en verder in het artikel worden alle configuratievoorbeelden behandeld in de context van het Docker-image dat door de ontwikkelaars van Debezium wordt verspreid. Het bevat alle benodigde pluginbestanden (connectors) en stelt de configuratie van Kafka Connect mogelijk via omgevingsvariabelen.
Als verwacht wordt dat Kafka Connect van Confluent wordt gebruikt, moet u zelf de plugins voor de benodigde connectors aan de directory toevoegen die in plugin.path of ingesteld via de omgevingsvariabele CLASSPATH. De instellingen van de Kafka Connect-worker en connectors worden gedefinieerd via configuratiebestanden die als argumenten aan de opstartopdracht van de worker worden doorgegeven. Zie voor meer informatie. .
Het hele proces van het configureren van Debezium met de connector verloopt in twee stappen. Laten we elke stap bekijken:
1. Configuratie van het Kafka Connect framework
Voor het streamen van gegevens naar een Apache Kafka-cluster worden specifieke parameters gedefinieerd in het Kafka Connect framework, zoals:
- verbindingseisen voor het cluster,
- de namen van topics waarin de configuratie van de connector zelf zal worden opgeslagen,
- de groepsnaam waaronder de connector is uitgevoerd (bij gebruik van de distributed-modus).
Het officiële Docker-image van het project ondersteunt configuratie via omgevingsvariabelen - laten we hiervan gebruikmaken. Dus, we downloaden het image:
docker pull debezium/connectDe minimale set omgevingsvariabelen die nodig zijn voor het starten van de connector ziet er als volgt uit:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— de initiële lijst van Kafka-cluster servers om de volledige lijst van clusterleden te verkrijgen; -
OFFSET_STORAGE_TOPIC=connector-offsets— het topic voor het opslaan van de posities waar de connector zich momenteel bevindt; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— het topic voor het opslaan van de status van de connector en zijn taken; -
CONFIG_STORAGE_TOPIC=connector-config— het topic voor het opslaan van de configuratiegegevens van de connector en zijn taken; -
GROUP_ID=1— de groepsidentificatie voor de workers waarop de connector-taak kan worden uitgevoerd; vereist bij gebruik van de gedistribueerde (distributed) modus.
We starten de container met deze variabelen:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Opmerking over Avro
Standaard schrijft Debezium gegevens in JSON-formaat, wat acceptabel is voor sandboxes en kleine hoeveelheden gegevens, maar problematisch kan worden in zwaar belaste databases. Een alternatief voor de JSON-converter is het serialiseren van berichten in binaire vorm, wat de belasting op de I/O-subsystemen in Apache Kafka kan verlagen.
Voor het gebruik van Avro is het nodig om een aparte (voor het opslaan van schema's). De variabelen voor de converter zien er als volgt uit:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Details over het gebruik van Avro en het configureren van de registry vallen buiten de reikwijdte van dit artikel - hierna zullen we voor de duidelijkheid JSON gebruiken.
2. Configuratie van de connector
Nu kunnen we verder gaan met de configuratie van de connector zelf, die gegevens uit de bron zal lezen.
Laten we de voorbeelden van connectors voor twee databasesystemen bekijken: PostgreSQL en MongoDB, waar ik ervaring mee heb en waar verschillen bestaan (hoe klein ook, in sommige gevallen zijn ze aanzienlijk!).
De configuratie wordt beschreven in JSON-notatie en wordt in Kafka Connect geladen via een POST-verzoek.
2.1. PostgreSQL
Voorbeeldconfiguratie van de connector voor PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Het principe van werking van de connector na deze configuratie is vrij eenvoudig:
- Bij de eerste uitvoering maakt deze verbinding met de database die in de configuratie is opgegeven en start deze in de modus initial snapshot, en verstuurt een beginset van gegevens naar Kafka, verkregen via de voorwaardelijke
SELECT * FROM table_name. - Nadat de initialisatie is voltooid, schakelt de connector over naar de modus voor het lezen van wijzigingen uit de WAL-bestanden van PostgreSQL.
Over de gebruikte opties:
-
naam— de naam van de connector waarvoor de hieronder beschreven configuratie wordt gebruikt; deze naam wordt verder gebruikt voor het werken met de connector (d.w.z. om de status te bekijken / herstarten / configuratie bij te werken) via de REST API van Kafka Connect; -
connector.class— de klasse van de databaseconnector die zal worden gebruikt door de geconfigureerde connector; -
plugin.name— de naam van de plugin voor het logisch decoderen van gegevens uit de WAL-bestanden. Beschikbaar zijnwal2json,decoderbuffsenpgoutput. De eerste twee vereisen de installatie van de overeenkomstige extensies in de database, terwijlpgoutputvoor PostgreSQL versie 10 en hoger geen aanvullende handelingen vereist zijn; -
database.*— opties voor verbinding met de database, waarbijdatabase.server.name— de naam van de PostgreSQL-instantie, gebruikt voor het vormen van de topicnaam in de Kafka-cluster; -
table.include.list— de lijst van tabellen waar we wijzigingen in willen volgen; opgegeven in het formaatschema.table_name; niet te gebruiken samen mettable.exclude.list; -
heartbeat.interval.ms— het interval (in milliseconden) waarmee de connector heartbeat-berichten naar een speciaal topic verstuurt; -
heartbeat.action.query— de query die zal worden uitgevoerd bij het versturen van elk heartbeat-bericht (deze optie is beschikbaar sinds versie 1.1); -
slot.name— de naam van de replicatieslot die door de connector zal worden gebruikt; publication.name— naam in PostgreSQL, die door de connector wordt gebruikt. Als deze niet bestaat, zal Debezium proberen deze te creëren. Als de gebruiker waarmee wordt verbonden niet genoeg rechten heeft om deze actie uit te voeren, zal de connector stoppen met een foutmelding;-
transformsbepaalt hoe de naam van het doel-topic precies moet worden gewijzigd:-
transforms.AddPrefix.typegeeft aan dat we reguliere expressies gaan gebruiken; -
transforms.AddPrefix.regex— een masker dat bepaalt hoe de naam van het doel-topic wordt overschreven; -
transforms.AddPrefix.replacement— datgene waarop we het overschrijven.
-
Meer over heartbeat en transforms
Standaard verzendt de connector gegevens naar Kafka bij elke gecommitteerde transactie en schrijft zijn LSN (Log Sequence Number) naar een service-topic offset. Maar wat gebeurt er als de connector is ingesteld om niet de volledige database te lezen, maar alleen een deel van de tabellen (waarbij gegevens niet vaak worden geüpdatet)?
- De connector zal WAL-bestanden lezen en zal daarin geen committeringen van transacties in de tabellen die hij volgt, detecteren.
- Daarom zal hij zijn huidige positie in geen van beide, het topic of het replicatieslot, bijwerken.
- Dit zal leiden tot het 'vasthouden' van WAL-bestanden op de schijf en mogelijk volledige uitputting van de schijfruimte.
En hier komen de opties van pas heartbeat.interval.ms en heartbeat.action.query. Het gebruik van deze opties samen maakt het mogelijk om elke keer dat een heartbeat-bericht wordt verzonden, een gegevenswijzigingsquery in een aparte tabel uit te voeren. Op deze manier wordt de LSN die de connector op dit moment heeft (in het replicatieslot) voortdurend geactualiseerd. Dit stelt de DBMS in staat om WAL-bestanden te verwijderen die niet meer nodig zijn. Meer over het functioneren van opties is te leren in .
Een andere optie die meer aandacht verdient, is transforms. Hoewel het meer gaat om gebruiksgemak en schoonheid...
Standaard maakt Debezium topics aan volgens het volgende naamgevingsbeleid: serverName.schemaName.tableName. Dit is niet altijd handig. Opties transforms je kunt met behulp van reguliere expressies de lijst met tabellen bepalen waarvan de evenementen naar een topic met een specifieke naam moeten worden gerouteerd.
In onze configuratie dankzij Aan het einde van de beschrijving van de configuratie van de connector voor PostgreSQL is het belangrijk om over de volgende kenmerken/beperkingen van de werking ervan te vertellen: We controleren of de upload succesvol is verlopen en of de connector is gestart: $ curl -i http://localhost:8083/connectors/pg-connector/status HTTP/1.1 200 OK Date: Thu, 17 Sep 2020 20:19:40 GMT Content-Type: application/json Content-Length: 175 Server: Jetty(9.4.20.v20190813){"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"} $ kafka/bin/kafka-console-consumer.sh --bootstrap-server kafka:9092 --from-beginning --property print.key=true --topic data.cdc.dbname Een zeer lange JSON met onze wijzigingen Een zeer lange JSON met onze wijzigingen In beide gevallen bestaan de records uit de sleutel (PK) van het gewijzigde record en de essentie van de wijzigingen: hoe het record eruitzag voor en hoe het erna uitzag. Deze connector maakt gebruik van de standaard replicatiemechanisme van MongoDB, waarbij informatie uit de oplog van de primaire node van de database wordt gelezen. Evenals de eerder beschreven connector voor PgSQL, wordt hier ook bij de eerste start een primaire snapshot van de gegevens gemaakt, waarna de connector overschakelt naar leesmodus van de oplog. Voorbeeldconfiguratie: Zoals je kunt zien, zijn er geen nieuwe opties vergeleken met het vorige voorbeeld, maar het aantal opties dat verantwoordelijk is voor de databaseverbinding en hun prefixen is verminderd. Instellingen Het probleem van failover en hoge beschikbaarheid is tegenwoordig urgenter dan ooit — vooral als we het hebben over gegevens en transacties, en het volgen van gegevenswijzigingen is ook hierin belangrijk. Laten we bekijken wat er in principe mis kan gaan en wat er met Debezium in elk geval zal gebeuren. Er zijn drie soorten uitval: Echter, er zijn uitzonderingen. Als de connector gedurende langere tijd in een uitgeschakelde staat vertoefde (of niet kon communiceren met het MongoDB-exemplaar), en de oplog in die tijd is geroteerd, zal de connector bij het herstel van de verbinding onverstoorbaar doorgaan met het lezen van gegevens vanaf de eerste beschikbare positie, waardoor een deel van de gegevens in Kafka niet zal terechtkomen. Debezium is mijn eerste ervaring met CDC-systemen en over het algemeen zeer positief. Het project wint punten door ondersteuning voor de belangrijkste DBMS, eenvoudig te configureren, ondersteuning voor clustering en een actief gemeenschap. Voor degenen die geïnteresseerd zijn in de praktijk raad ik aan om de handleidingen voor en . Te vergelijken met de JDBC-connector voor Kafka Connect is het belangrijkste voordeel van Debezium dat wijzigingen worden gelezen uit de logboeken van de DBMS, wat het mogelijk maakt om gegevens met minimale vertraging te verkrijgen. De JDBC-connector (uit de levering van Kafka Connect) doet verzoeken aan de bijgehouden tabel met een vast interval en (om deze reden) genereert geen berichten bij het verwijderen van gegevens (hoe kun je gegevens opvragen die er niet zijn?). Voor het oplossen van vergelijkbare problemen kan men aandacht besteden aan de volgende oplossingen (naast Debezium): Lees ook op onze blog: Bron: habr.comtransforms gebeurt het volgende: alle CDC-gebeurtenissen uit de gemonitorde database komen in het topic met de naam data.cdc.dbname. In andere gevallen (zonder deze instellingen) zou Debezium standaard voor elke tabel een topic aanmaken met de vorm: pg-dev.public..
Beperkingen van de connector
Toepassing van de configuratie
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.jsonGeweldig: hij is ingesteld en klaar voor gebruik. Laten we ons nu laten doorgaan als consument en verbinding maken met Kafka, waarna we een record in de tabel toevoegen en wijzigen:postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1
In ons topic zal dit als volgt worden weergegeven:{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: waarde voor (voor) is gelijk aan null, en daarna is de string die is ingevoegd. UPDATE: in payload.before toont de vorige staat van de string, en in payload.after is de nieuwe met de essentie van de wijzigingen.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms deze keer doen ze het volgende: ze transformeren de naam van het doeltopic uit het schema .. in data.cdc.mongo_.Resilience
Conclusie
P.S.
