

Gegevensgestuurde algoritmen, zoals neurale netwerken, hebben de wereld stormenderhand veroverd. Hun ontwikkeling is te danken aan verschillende factoren, waaronder goedkope en krachtige hardware en enorme hoeveelheden data. Neurale netwerken staan momenteel vooraan in alles wat met 'cognitieve' taken te maken heeft, zoals beeldherkenning, natuurlijke taalbegrip, enzovoorts. Maar ze zouden niet beperkt moeten blijven tot deze taken. Dit artikel beschrijft een methode voor het comprimeren van afbeeldingen met behulp van neurale netwerken door middel van residual learning. De in het artikel voorgestelde aanpak werkt sneller en beter dan standaard codec's. Schema's, vergelijkingen en natuurlijk een tabel met tests zijn onder de kat.
Dit artikel is gebaseerd op werk. Er wordt aangenomen dat je bekend bent met neurale netwerken en hun concepten convolutie en verliesfunctie.
Wat is afbeeldingscompressie en welke soorten zijn er?
Afbeeldingscompressie is het proces van het omzetten van een afbeelding op een manier zodat deze minder ruimte in beslag neemt. Eenvoudige opslag van afbeeldingen zou te veel ruimte innemen, daarom zijn er codec's zoals JPEG en PNG die gericht zijn op het verkleinen van de bestandsgrootte van de originele afbeelding.
Zoals bekend zijn er twee soorten afbeeldingscompressie: zonder verlies en met verlies. Zoals de namen al aangeven, kan bij compressie zonder verlies de data van de originele afbeelding worden herwonnen, terwijl bij compressie met verlies enkele gegevens tijdens de compressie verloren gaan. Bijvoorbeeld, JPG is een compressie-algoritme met verlies [zie opmerking van de vertaler — laten we vooral ook de JPEG zonder verlies niet vergeten], terwijl PNG een compressie-algoritme zonder verlies is.
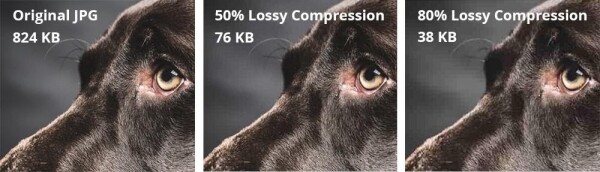
Vergelijking van compressie zonder verlies en met verlies
Let op dat er rechts op de afbeelding veel blokartefacten zijn. Dit is verloren informatie. Nabijgelegen pixels met vergelijkbare kleuren worden samengevoegd tot één gebied om ruimte te besparen, maar daarbij gaat informatie over de daadwerkelijke pixels verloren. Natuurlijk zijn de algoritmes die worden toegepast in codecs zoals JPEG, PNG, enzovoort veel complexer, maar dit is een goed intuïtief voorbeeld van compressie met verlies. Verliesvrije compressie is goed, maar verliesvrije bestanden nemen veel schijfruimte in beslag. Er zijn efficiëntere methoden om afbeeldingen te comprimeren zonder veel informatie te verliezen, maar deze zijn vrij traag en veel gebruiken iteratieve benaderingen. Dit betekent dat ze niet parallel kunnen worden uitgevoerd op meerdere kernen van een centrale of grafische processor. Deze beperking maakt ze volkomen onpraktisch voor dagelijks gebruik.
Invoer van een convolutionele neurale netwerk
Als er iets moet worden berekend en de berekeningen benaderend kunnen zijn, voeg dan . De auteurs hebben een vrij standaard convolutioneel neuraal netwerk gebruikt om de beeldcompressie te verbeteren. De voorgestelde methode werkt niet alleen gelijk op met de beste oplossingen (indien niet beter), maar kan ook gebruik maken van parallelle berekeningen, wat leidt tot een aanzienlijke versnelling. De reden is dat convolutionele neurale netwerken (CNN's) erg goed zijn in het extraheren van ruimtelijke informatie uit afbeeldingen, die vervolgens in compactere vorm worden weergegeven (bijvoorbeeld slechts de 'belangrijke' bits van de afbeelding worden opgeslagen). De auteurs wilden deze mogelijkheid van CNN's gebruiken om afbeeldingen beter voor te stellen.
Architectuur
De auteurs stelden een dubbele netwerkstructuur voor. Het eerste netwerk ontvangt een afbeelding als invoer en genereert een compacte representatie (ComCNN). De output van dit netwerk wordt vervolgens verwerkt door een standaard codec (bijvoorbeeld JPEG). Na verwerking door de codec wordt de afbeelding doorgegeven aan het tweede netwerk, dat de afbeelding uit de codec 'corrigeert' in een poging het oorspronkelijke beeld terug te brengen. De auteurs noemden dit netwerk de reconstructieve CNN (RecCNN). Net als bij GAN worden beide netwerken iteratief getraind.
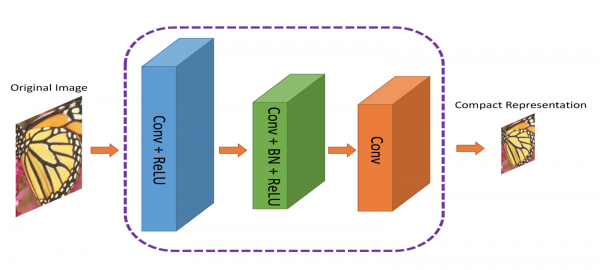
ComCNN De compacte representatie wordt doorgegeven aan de standaard codec
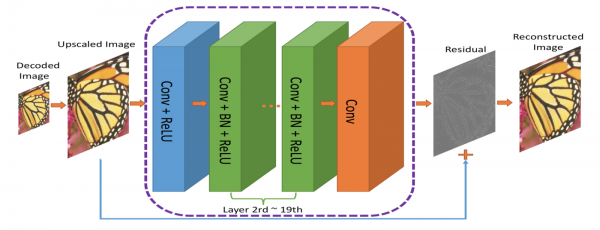
RecCNN. De output van ComCNN wordt vergroot en doorgegeven aan RecCNN, dat zal proberen de rest te leren.
De uitvoer van de codec schaalt met de toename en wordt vervolgens doorgegeven aan RecCNN. RecCNN zal proberen een afbeelding te genereren die zo veel mogelijk op het origineel lijkt.
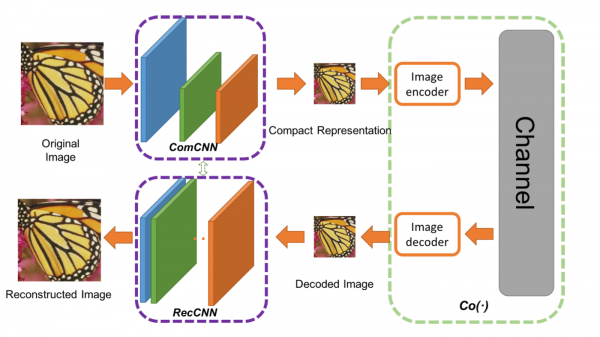
End-to-end framework voor afbeeldingscompressie. Co(.) is een algoritme voor afbeeldingscompressie. De auteurs hebben JPEG, JPEG2000 en BPG toegepast.
Wat is het residu?
Het residu kan worden gezien als een stap in de nabewerking om het door de codec gedecodeerde beeld te 'verbeteren'. De neurale netwerk met veel 'informatie' over de wereld kan cognitieve beslissingen nemen over wat te corrigeren. Dit idee is gebaseerd op , waarvan je de details kunt lezen .
Verliesfuncties
Twee verliesfuncties worden gebruikt omdat we twee neurale netwerken hebben. De eerste, ComCNN, wordt aangeduid als L1 en wordt als volgt gedefinieerd:
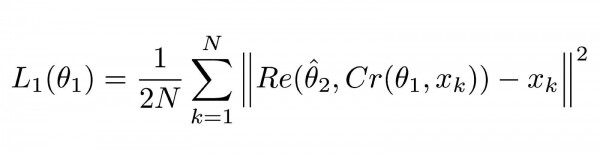
Verliesfunctie voor ComCNN
Uitleg
Deze vergelijking kan ingewikkeld lijken, maar in werkelijkheid is het een standaard (mean squared error) MSE. ||² betekent de norm van de vector die zij omvatten.
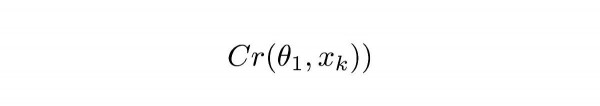
Vergelijking 1.1
Cr betekent de uitvoer van ComCNN. θ duidt de leerbare parameters van ComCNN aan, XK is het invoerbeeld.
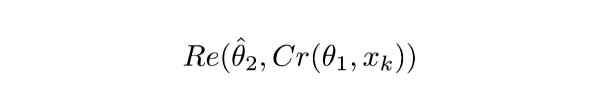
Vergelijking 1.2
Re() betekent RecCNN. Deze vergelijking geeft eenvoudig de waarde over van vergelijking 1.1 naar RecCNN. θ duidt de leerbare parameters van RecCNN aan (de hoed bovenaan betekent dat de parameters vast zijn).
Intuïtieve definitie
Vergelijking 1.0 dwingt ComCNN om zijn gewichten zo te veranderen dat de uiteindelijke afbeelding, na reconstructie met RecCNN, zo dicht mogelijk bij het invoerbeeld lijkt. De tweede verliesfunctie RecCNN wordt als volgt gedefinieerd:
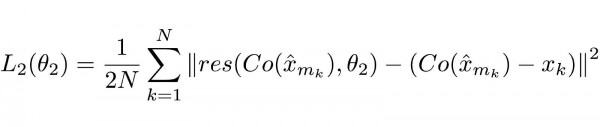
Vergelijking 2.0
Uitleg
Opnieuw kan de functie ingewikkeld lijken, maar het is voor het grootste deel een standaard verliesfunctie voor neurale netwerken (MSE).
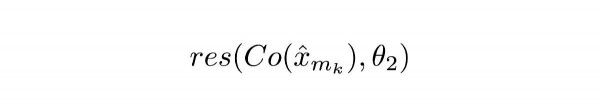
Vergelijking 2.1
Co() betekent de uitvoer van de codec, x met een hoed bovenaan betekent de uitvoer van ComCNN. θ2 zijn de leerbare parameters van RecCNN. res() is simpelweg de residuele uitvoer van RecCNN. Het is vermeldenswaard dat RecCNN wordt getraind op het verschil tussen Co() en het invoerbeeld, maar niet op het invoerbeeld zelf.
Intuïtieve definitie
Vergelijking 2.0 dwingt RecCNN om zijn gewichten zo te wijzigen dat de uitvoer zo veel mogelijk op het invoerbeeld lijkt.
Leerplan
Modellen worden iteratief getraind, vergelijkbaar met De gewichten van het eerste model worden vastgelegd terwijl de gewichten van het tweede model worden bijgewerkt, daarna worden de gewichten van het tweede model vastgelegd terwijl het eerste model leert.
Tests
De auteurs vergeleken hun methode met bestaande methoden, waaronder eenvoudige codecs. Hun methode presteert beter dan andere, terwijl het een hoge snelheid behoudt op geschikte hardware. Daarnaast probeerden de auteurs alleen één van de twee netwerken te gebruiken en merkten een daling in de prestaties op.
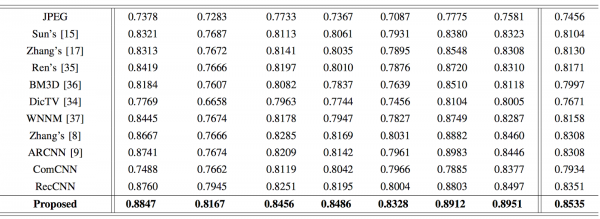
Vergelijking van de Structural Similarity Index (SSIM). Hoge waarden duiden op een betere gelijkenis met het origineel. De resultaten van de auteurs zijn vetgedrukt.
Conclusie
We hebben een nieuwe manier onderzocht om deep learning toe te passen voor beeldcompressie, en besproken hoe neurale netwerken kunnen worden gebruikt voor andere taken dan 'algemene' zoals beeldclassificatie en taalverwerking. Deze methode voldoet niet alleen aan de moderne eisen, maar stelt ons ook in staat om afbeeldingen veel sneller te verwerken.
Het is eenvoudiger geworden om neurale netwerken te bestuderen, want speciaal voor de Habr-lezers hebben we een promotiecode gemaakt HABR, die een extra korting van 10% biedt op de korting die op de banner wordt aangegeven.
Meer cursussen
Aanbevolen artikelen
Bron: habr.com
