

Hoe begrijpt een backend-ontwikkelaar dat een SQL-query goed zal functioneren in de productieomgeving? In grote of snelgroeiende bedrijven heeft niet iedereen toegang tot de productie. En zelfs met toegang kunnen niet alle queries zonder problemen worden getest, en het maken van een kopie van de database kan vaak uren duren. Om deze problemen op te lossen, hebben we een kunstmatige DBA gecreëerd - Joe. Hij is al met succes geïmplementeerd in verschillende bedrijven en helpt tientallen ontwikkelaars.
Video:
Hallo iedereen! Mijn naam is Anatoliy Stansler. Ik werk bij het bedrijf . We zijn bezig met het versnellen van het ontwikkelingsproces door de vertragingen die ontwikkelaars, DBA's en QA's ondervinden bij het werken met Postgres te verhelpen.
We hebben geweldige klanten en vandaag zal een deel van mijn presentatie gewijd zijn aan de cases die we zijn tegengekomen in de samenwerking met hen. Ik zal vertellen hoe we hen hebben geholpen om vrij ernstige problemen op te lossen.
Wanneer we ontwikkelen en complexe, belastende migraties uitvoeren, stellen we ons de vraag: 'Zal deze migratie slagen?'. We maken gebruik van reviews, en we putten uit de kennis van meer ervaren collega's, DBA-experts. En zij kunnen zeggen - het zal slagen of het zal niet slagen.
Maar misschien zou het beter zijn als we dit zelf konden testen op volledige kopieën. Vandaag gaan we het precies hebben over de huidige benaderingen van testen en hoe we dit het beste kunnen doen en met welke tools. We zullen ook bespreken welke voor- en nadelen deze benaderingen hebben en wat we hier kunnen verbeteren.
Wie heeft ooit direct in de productie indices gemaakt of wijzigingen aangebracht? Best een hoop. En bij wie leidde dit tot dataverlies of downtime? Dan kent u deze pijn maar al te goed. Gelukkig zijn er back-ups.
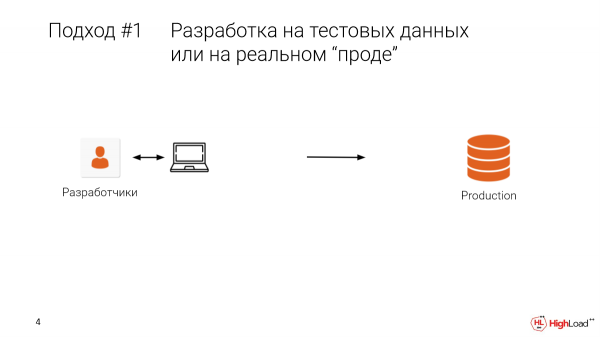
De eerste benadering is testen in de productie. Of wanneer een ontwikkelaar op zijn lokale machine zit, met testdata, er is een beperkte steekproef. En we implementeren dat in de productie, en we krijgen zo'n situatie.
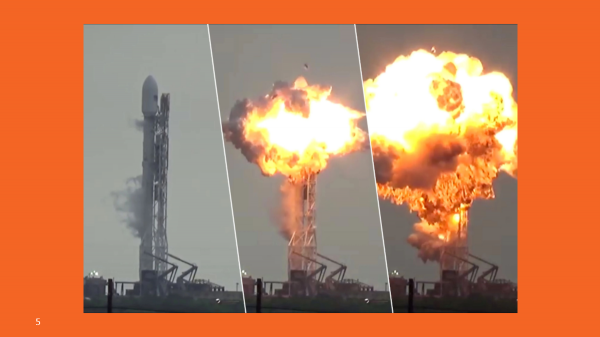
Het is pijnlijk, het is duur. Waarschijnlijk moet je het zo niet doen.
Hoe kunnen we het beter doen?
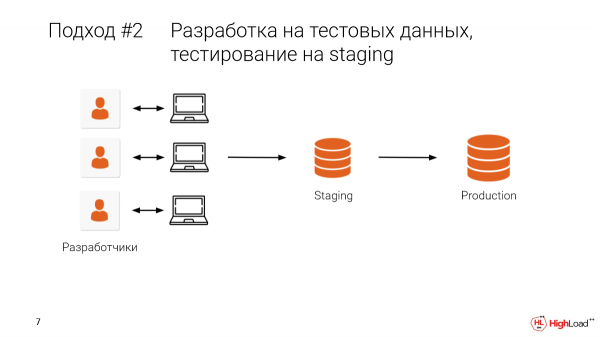
Laten we staging opnemen en daar een deel van de productie aan toewijzen. Of in het beste geval nemen we de echte productie, alle gegevens. En nadat we lokaal hebben ontwikkeld, zullen we ook extra controleren op de staging.
Dit stelt ons in staat om een deel van de fouten te elimineren, dat wil zeggen, te voorkomen in de productie.
Wat zijn de problemen?
- Het probleem is dat we deze staging met collega's delen. En het gebeurt vaak dat je een wijziging aanbrengt, bam – en er zijn geen gegevens meer, al ons werk is voor niets geweest. De staging was meerdere terabytes groot. En het duurt lang voordat het weer opstart. We besluiten dit morgen verder uit te werken. Onze ontwikkeling is stilgevallen.
- En natuurlijk werken er veel collega's, veel teams. En het moet handmatig worden goedgekeurd. Dat is onhandig.
En het moet gezegd worden dat we maar één poging hebben, één schot, als we enige wijzigingen in de database willen aanbrengen, gegevens willen aanpassen, de structuur willen wijzigen. En als er iets misgaat, als er een fout was in de migratie, kunnen we niet snel terugschakelen.
Dit is beter dan de vorige aanpak, maar er is nog steeds een grote kans dat er een fout op productie komt.
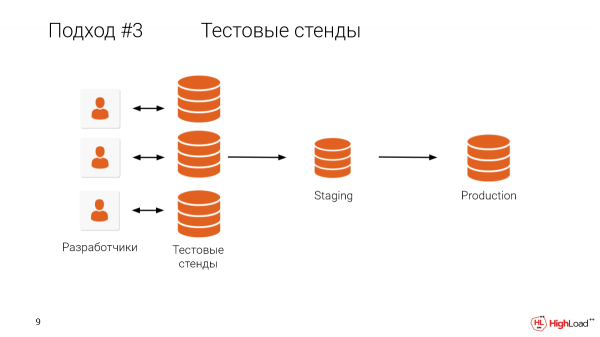
Wat weerhoudt ons ervan om elke ontwikkelaar een testomgeving, een volledige kopie, te geven? Ik denk dat het duidelijk is wat ons tegenhoudt.
Wie heeft een database groter dan een terabyte? Meer dan de helft van de zaal.
En het is duidelijk dat het onderhoud van machines voor elke ontwikkelaar, bij zo'n grote productie, erg duur is en ook nog eens lang duurt.
We hebben klanten die begrijpen dat het erg belangrijk is om alle wijzigingen op volledige kopieën te testen, maar hun databases zijn kleiner dan een terabyte en er zijn niet genoeg middelen om voor elke ontwikkelaar een testomgeving te onderhouden. Daarom moeten ze dumps lokaal op hun machine downloaden en op die manier testen. Dat kost veel tijd.
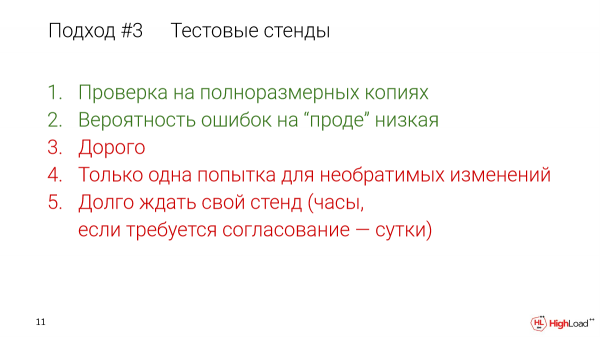
Zelfs als je dit binnen de infrastructuur doet, is het al heel goed om één terabyte gegevens in een uur te downloaden. Maar ze gebruiken logische dumps, die ze lokaal vanuit de cloud downloaden. Voor hen ligt de snelheid rond de 200 gigabyte per uur. En het kost ook tijd om uit een logische dump te herstellen, indexen aan te brengen, enzovoort.
Maar ze gebruiken deze aanpak omdat het ervoor zorgt dat prod betrouwbaar blijft.
Wat kunnen we hier doen? Laten we ervoor zorgen dat testomgevingen goedkoop zijn en elke ontwikkelaar zijn eigen testomgeving krijgt.
En dat is mogelijk.
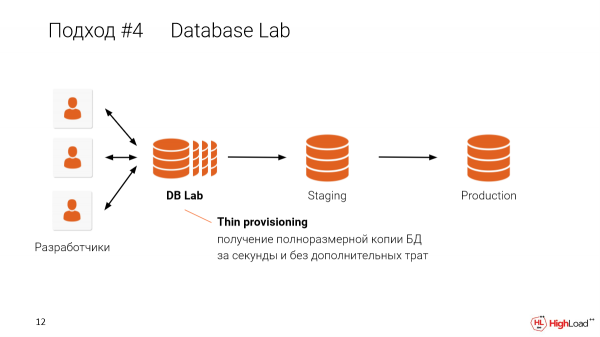
En met deze aanpak, waarbij we dunne klonen voor elke ontwikkelaar maken, kunnen we dit op één machine delen. Bijvoorbeeld, als je een database van vier terabyte hebt en je wilt deze aan 10 ontwikkelaars geven, hoef je niet 10 keer vier terabyte aan databases te hebben. Eén machine is voldoende om dunne, geïsoleerde kopieën voor elke ontwikkelaar te maken, met gebruik van één machine. Hoe dit werkt zal ik later uitleggen.
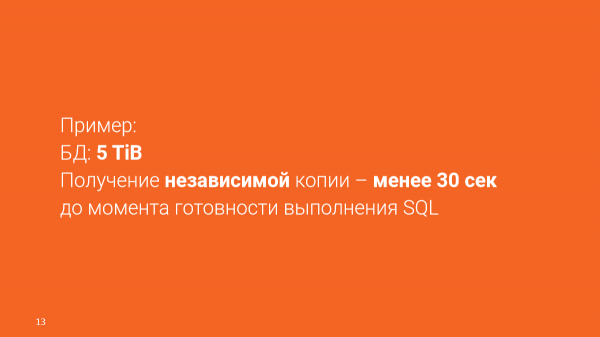
Een echt voorbeeld:
DB – 4,5 terabyte.
We kunnen onafhankelijke kopieën binnen 30 seconden verkrijgen.
Je hoeft niet te wachten op een testomgeving en afhankelijk te zijn van de grootte ervan. Je kunt het binnen enkele seconden krijgen. Dit zullen volledig geïsoleerde omgevingen zijn, maar die gegevens delen met elkaar.
Dat is geweldig. Hier praten we over magie en een parallel universum.
In ons geval werkt dit met het systeem OpenZFS.
OpenZFS is een copy-on-write bestandssysteem dat standaard snapshots en klonen ondersteunt. Het is betrouwbaar en schaalbaar. Het is heel eenvoudig te beheren. Je kunt het letterlijk met twee commando's implementeren.
Er zijn andere opties:
LVM,
Storage arrays (bijvoorbeeld, Pure Storage).
Database Lab, waar ik over praat, is modulair. Dit kan worden geïmplementeerd met deze opties. Maar voorlopig hebben we ons gefocust op OpenZFS, omdat er specifieke problemen waren met LVM.
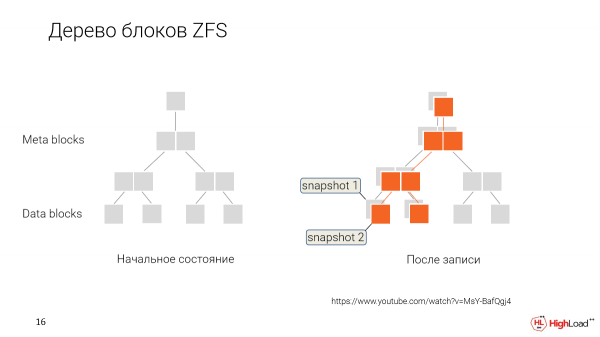
Hoe werkt dit? In plaats van gegevens elke keer opnieuw te schrijven wanneer we deze wijzigen, slaan we ze op door gewoon aan te geven dat deze nieuwe gegevens betrekking hebben op een nieuw tijdstip, naar een nieuw snapshot.
En vervolgens, wanneer we willen terugdraaien of we willen een nieuwe kloon maken van een oudere versie, zeggen we gewoon: "Oké, geef ons deze datablokken die zo zijn gemarkeerd."
En deze gebruiker zal met deze set gegevens werken. Hij zal deze geleidelijk veranderen en zijn eigen snapshots maken.
En we zullen vertakkingen hebben. Elke ontwikkelaar in ons geval heeft de mogelijkheid om zijn eigen kloon te hebben die hij bewerkt, en die gegevens die gemeenschappelijk zijn, worden gedeeld tussen iedereen.
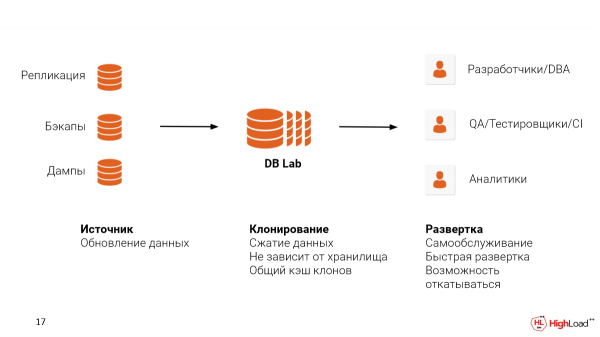
Om zo'n systeem te implementeren, moet je twee problemen oplossen:
De eerste is de gegevensbron waaruit je deze zult halen. Je kunt replicatie instellen met productie. Je kunt ook al je back-ups gebruiken die je hebt ingesteld, hoop ik. WAL-E, WAL-G of Barman. En zelfs als je een of ander cloudoplossing gebruikt, zoals RDS of Cloud SQL, kun je logische dumps gebruiken. Maar we raden je toch aan om back-ups te gebruiken, omdat je met deze aanpak ook de fysieke bestandstructuur behoudt, wat je helpt om dichter bij de statistieken te komen die je op productie zou zien, zodat je de problemen die er zijn kunt opvangen.
De tweede is de plek waar je de Database Lab wilt hosten. Dit kan Cloud zijn, dit kan On-premise zijn. Het is belangrijk om te zeggen dat ZFS gegevenscompressie ondersteunt. En dat doet het behoorlijk goed.
Stel je voor dat elke kloon afhankelijk van de bewerkingen die we met de database doen, een bepaalde dev zal toenemen. Hiervoor zal ook ruimte voor die dev nodig zijn. Maar omdat we de database van 4,5 terabyte hebben genomen, zal ZFS deze comprimeren tot 3,5 terabyte. Afhankelijk van de instellingen kan dit variëren. En we hebben nog ruimte voor dev over.
Zo'n systeem kan voor verschillende gevallen worden gebruikt.
Dit zijn ontwikkelaars, DBA's die queries controleren, voor optimalisatie.
Dit kan worden gebruikt in QA-testen om een specifieke migratie te controleren voordat we dit in prod uitrollen. En we kunnen ook speciale omgevingen voor QA opzetten met echte gegevens, waar ze nieuwe functionaliteit kunnen testen. Dit zou seconden in beslag nemen in plaats van uren, of misschien wel dagen in sommige andere gevallen waar dunne kopieën niet worden gebruikt.
En nog een apart geval. Als er binnen het bedrijf geen analysesysteem is ingesteld, kunnen we een dunne kloon van de productiedatabase aanmaken en deze toewijzen voor langdurige queries of voor speciale indices die in de analyse kunnen worden gebruikt.
Met deze aanpak:
Er is een lage kans op fouten in de productie, omdat we alle wijzigingen op volledige gegevens hebben getest.
We creëren een testcultuur, omdat je nu niet uren hoeft te wachten op je eigen testomgeving.
En er is geen hindernis, geen wachttijd tussen het testen. Je kunt echt gaan en controleren. En dat zal beter zijn, omdat we de ontwikkeling zullen versnellen.
Er zal minder refactoring zijn. Minder bugs komen in prod terecht. We zullen ze later minder refactoren.
We kunnen onomkeerbare wijzigingen maken. Dit is niet mogelijk in standaardbenaderingen.
- Het is voordelig, omdat we de middelen van testomgevingen delen.
Dat is al goed, wat kan er nog sneller?
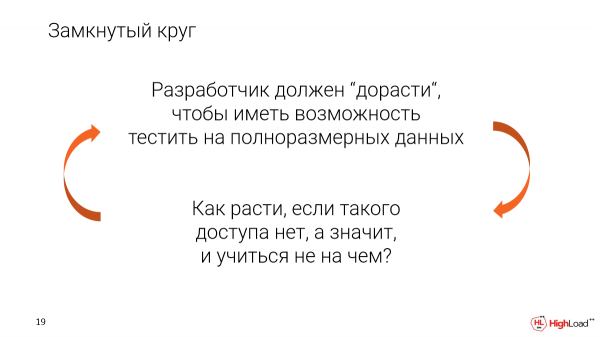
Dankzij dit systeem kunnen we de instapdrempel voor deze vorm van testen aanzienlijk verlagen.
Er is nu een vicieuze cirkel waarin een ontwikkelaar expert moet worden om toegang te krijgen tot echte volledige gegevens. Hij moet dat vertrouwen krijgen.
Maar hoe kun je groeien als dat er niet is? En wat als je alleen toegang hebt tot een heel kleine set testgegevens? Dan is er geen echte ervaring te behalen.
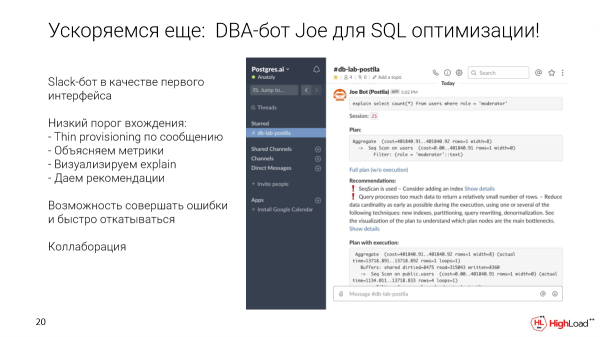
Hoe kom je uit deze cirkel? Als eerste interface, gebruiksvriendelijk voor ontwikkelaars van elk niveau, kozen we voor een Slack-bot. Maar het kan elke andere interface zijn.
Wat kan hij doen? Je kunt een specifieke query nemen en deze naar een speciaal kanaal voor de database sturen. We zullen automatisch in enkele seconden een dunne kloon uitrollen. We voeren deze query uit, verzamelen statistieken en aanbevelingen. We tonen een visualisatie. En vervolgens blijft deze kloon bestaan, zodat die query geoptimaliseerd kan worden, indices toegevoegd kunnen worden, enzovoort.
En bovendien geeft Slack ons mogelijkheden voor samenwerking uit de doos. Omdat het gewoon een kanaal is, kun je daar in een thread over die specifieke query beginnen te discussiëren, je collega's en DBA's binnen het bedrijf taggen.
Maar er zijn natuurlijk ook problemen. Aangezien dit de echte wereld is, en we een server gebruiken waarop we verschillende klonen hosten, moeten we de hoeveelheid geheugen en CPU-kracht die aan de klonen beschikbaar is, beperken.
Maar om deze tests geloofwaardig te maken, moet dit probleem op de een of andere manier worden opgelost.
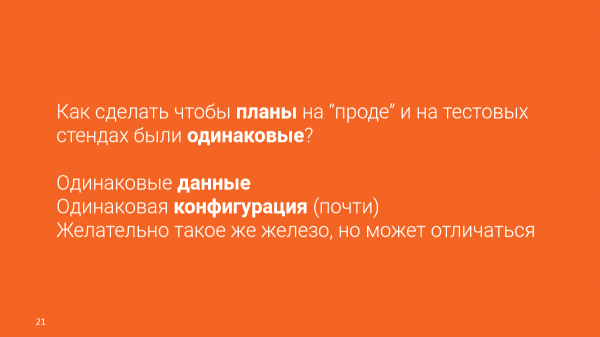
Het is duidelijk dat gelijke gegevens een belangrijk punt zijn. Maar dat hebben we al. We willen een gelijke configuratie bereiken. En we kunnen die vrijwel identieke configuratie bieden.
Het zou geweldig zijn om dezelfde hardware als in productie te hebben, maar het kan verschillen.
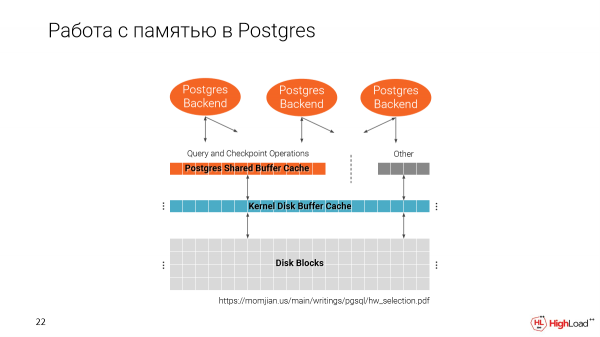
Laten we herinneren hoe Postgres met geheugen omgaat. We hebben twee caches. Eén van het bestandssysteem en één van Postgres zelf, namelijk de Shared Buffer Cache.
Het is belangrijk op te merken dat de Shared Buffer Cache wordt gealloceerd bij de opstart van Postgres, afhankelijk van de grootte die je in de configuratie instelt.
De tweede cache gebruikt alle beschikbare ruimte.
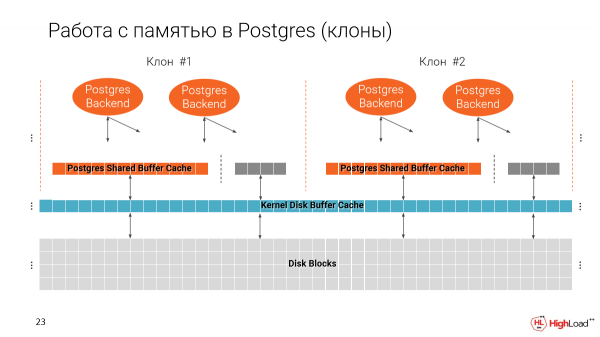
En wanneer we meerdere klonen op één machine maken, vullen we geleidelijk het geheugen. Idealiter is de Shared Buffer Cache 25% van het totale geheugen dat op de machine beschikbaar is.
Als we dit parameter niet aanpassen, kunnen we op één machine slechts 4 instanties draaien, dus 4 van zulke dunne klonen. Dat is natuurlijk slecht, omdat we er veel meer willen hebben.
Aan de andere kant wordt de Buffer Cache gebruikt voor het uitvoeren van queries en indexen, wat betekent dat het plan afhangt van de grootte van onze caches. Als we dit parameter zomaar verlagen, kunnen onze plannen drastisch veranderen.
Bijvoorbeeld, als we een grote cache op prod hebben, zal Postgres de voorkeur geven aan het gebruik van een index. Als dat niet het geval is, zal het SeqScan gebruiken. En wat zou het nut zijn als onze plannen niet met elkaar overeenkwamen?
Hier komen we tot de conclusie dat het plan in Postgres niet afhankelijk is van de specifieke in Shared Buffer ingestelde grootte, maar van de effective_cache_size.
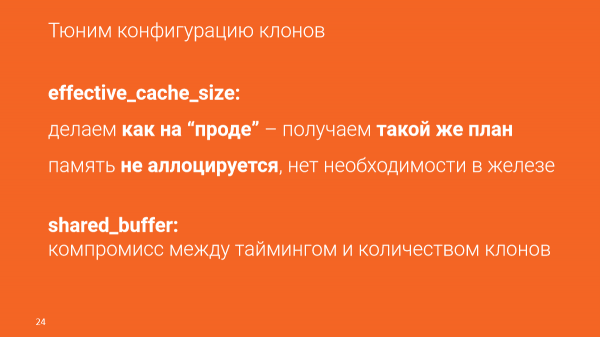
Effective_cache_size is de veronderstelde grootte van de cache die we hebben, dat wil zeggen, de totale Buffer Cache en de cache van het bestandssysteem. Dit wordt ingesteld via de configuratie. En dit geheugen wordt niet gealloceerd.
Met dit parameter kunnen we Postgres eigenlijk voor de gek houden door te zeggen dat er veel gegevens beschikbaar zijn, zelfs als we die gegevens niet hebben. Hierdoor zullen de plannen volledig overeenkomen met de productie.
Maar dit kan invloed hebben op de timing. We optimaliseren queries op basis van timing, maar het is belangrijk dat timing van veel factoren afhankelijk is:
Het hangt af van de huidige belasting op prod.
Het hangt af van de kenmerken van de machine zelf.
Dit is een indirecte parameter, maar eigenlijk kunnen we optimaliseren op basis van de hoeveelheid gegevens die deze query moet lezen om een resultaat te verkrijgen.
En als we willen dat de timing dicht in de buurt komt van wat we in prod zullen zien, moeten we de meest vergelijkbare hardware nemen en misschien zelfs meer, zodat alle kloons passen. Maar dit is een compromis, dat wil zeggen, u zult dezelfde plannen krijgen, u zult zien hoeveel gegevens een specifieke query leest en kunt concluderen - is deze query goed (of migratie) of slecht, moet deze nog worden geoptimaliseerd.
Laten we bekijken hoe de optimalisatie met Joe precies verloopt.
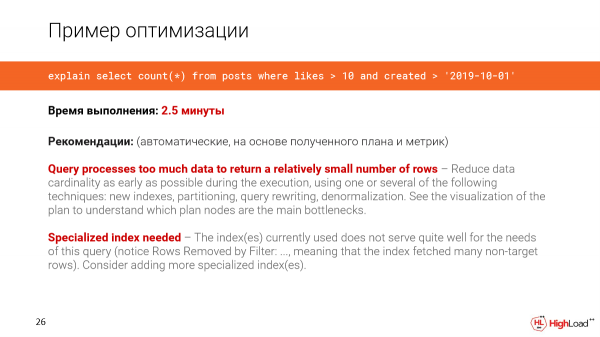
Laten we een query uit een echt systeem nemen. In dit geval is de database 1 terabyte. En we willen het aantal recente berichten tellen die meer dan 10 likes hebben.
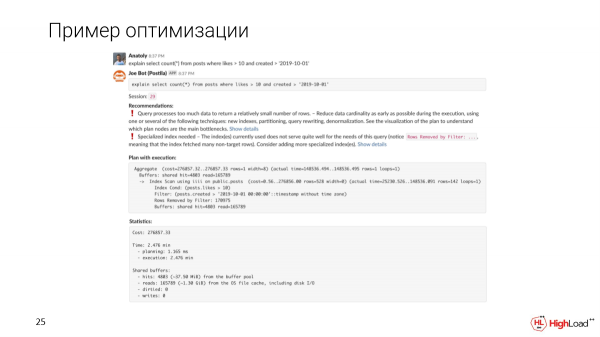
We sturen een bericht naar het kanaal, er is een kloon voor ons opgezet. En we zullen zien dat zo'n query 2,5 minuten nodig heeft om uit te voeren. Dat is het eerste wat we opmerken.
Joe laat automatische aanbevelingen zien, gebaseerd op het plan en de metrics.
We zullen zien dat de query te veel gegevens verwerkt om relatief weinig rijen te verkrijgen. En we hebben een gespecialiseerde index nodig, aangezien we hebben opgemerkt dat er te veel gefilterde rijen in de query zitten.
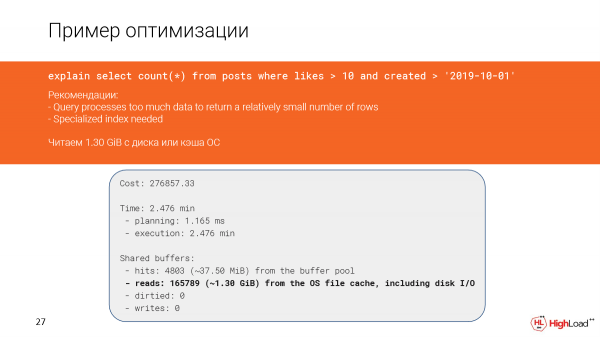
Laten we eens in detail bekijken wat er is gebeurd. We zien inderdaad dat we bijna anderhalve gigabyte aan gegevens hebben gelezen vanaf de bestandscache of zelfs van de schijf. En dat is niet goed, aangezien we slechts 142 rijen hebben opgehaald.
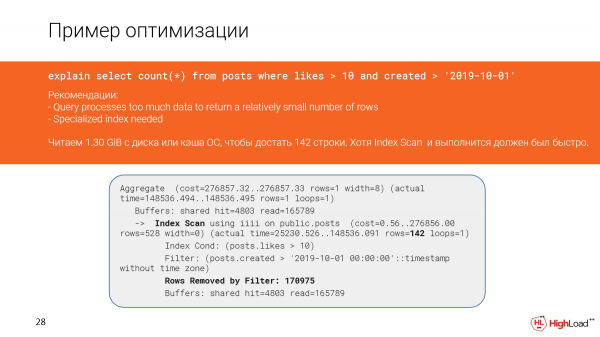
En, schijnbaar, hebben we hier een index scan en het zou snel moeten zijn, maar omdat we te veel rijen hebben gefilterd (we moesten ze tellen), heeft de query langzaam gewerkt.
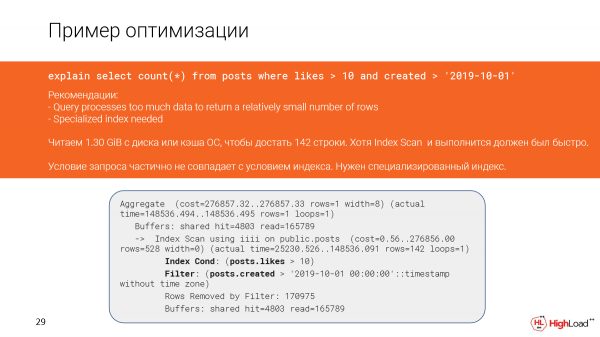
En dit gebeurde in het plan omdat de voorwaarden in de query en de voorwaarden in de index gedeeltelijk niet overeenkwamen.
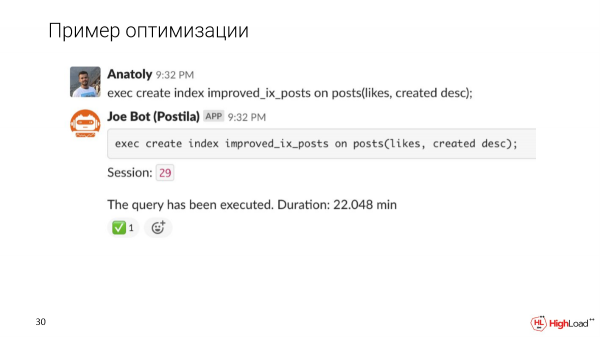
Laten we proberen de index nauwkeuriger te maken en kijken hoe de uitvoering van de query daarna verandert.
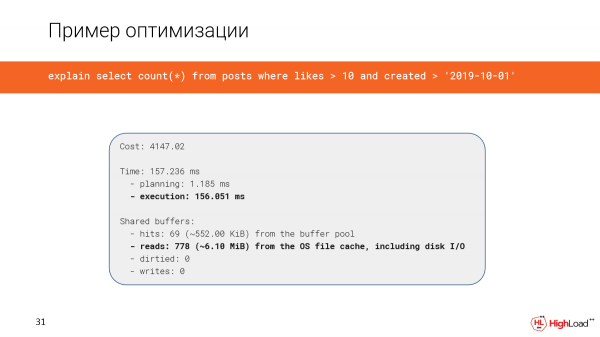
Het aanmaken van de index kostte behoorlijk wat tijd, maar nu controleren we de query en zien we dat de tijd in plaats van 2,5 minuten slechts 156 milliseconden is geworden, wat vrij goed is. En we lezen in totaal slechts 6 megabyte aan gegevens.
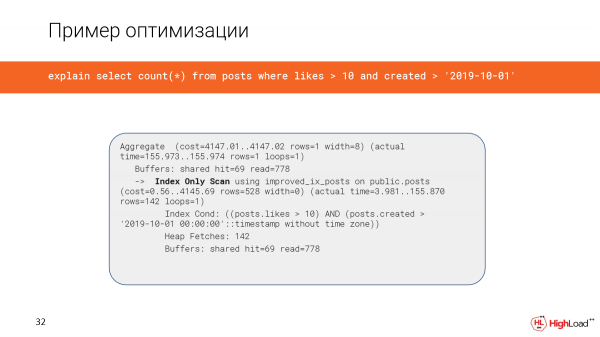
En nu gebruiken we een index only scan.
Een ander belangrijk verhaal is dat we het plan op een meer begrijpelijke manier willen presenteren. We hebben bij ons visuele weergaven geïmplementeerd met behulp van Flame Graphs.
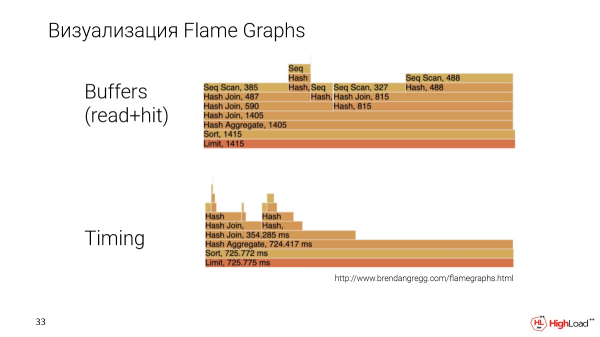
Dit is een andere query, rijker. En we bouwen Flame Graphs op basis van twee parameters: de hoeveelheid gegevens die een specifieke node in het plan heeft gelezen en de timing, dat wil zeggen de uitvoeringstijd van de node.
Hier kunnen we specifieke knooppunten met elkaar vergelijken. Het zal duidelijk zijn welk knooppunt groter of kleiner is, wat meestal moeilijk te doen is met andere visualisatietechnieken.
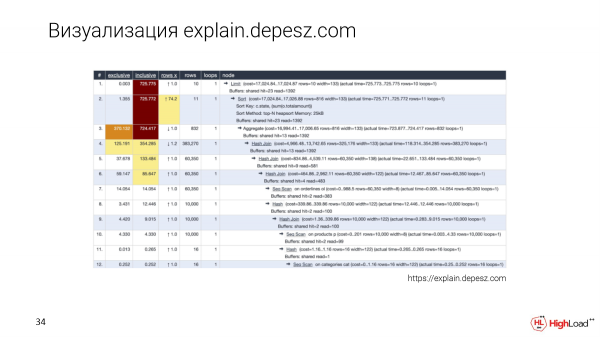
Natuurlijk kent iedereen explain.depesz.com. Een goede functie van deze visualisatie is dat we het tekstuele plan behouden en ook enkele belangrijke parameters in een tabel opnemen, zodat we kunnen sorteren.
En ontwikkelaars die zich nog niet in dit onderwerp hebben verdiept, gebruiken ook explain.depesz.com, omdat het voor hen gemakkelijker is om te begrijpen welke metrics belangrijk zijn en welke niet.
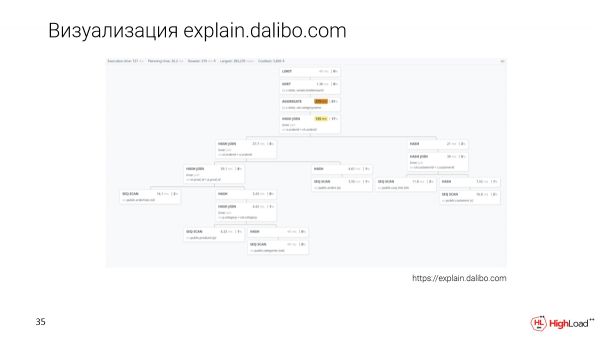
Er is een nieuwe benadering van visualisatie – explain.dalibo.com. Ze maken een boomstructuur visualisatie, maar het is hier erg lastig om knooppunten met elkaar te vergelijken. Hier kun je de structuur goed begrijpen, maar als er een grote query is, moet je heen en weer scrollen, maar het is ook een optie.
Samenwerking
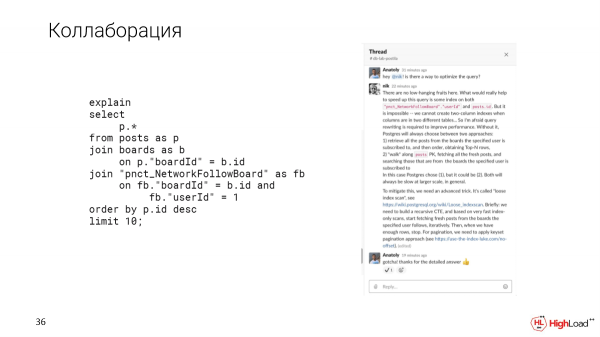
En zoals ik al zei, biedt Slack ons de mogelijkheid voor samenwerking. Bijvoorbeeld, als we een complexe query tegenkomen die moeilijk te optimaliseren is, kunnen we dit vraagstuk in een thread in Slack verduidelijken met onze collega's.
Wij vinden het belangrijk om te testen met volledige gegevenssets. Daarom hebben we het Update Database Lab ontwikkeld, dat beschikbaar is als open source. Je kunt ook de bot Joe gebruiken. Je kunt het nu meteen gebruiken en implementeren. Alle handleidingen zijn daar beschikbaar.
Het is ook belangrijk op te merken dat de oplossing op zichzelf niet revolutionair is, omdat er Delphix is, maar dat is een enterprise-oplossing. Het is volledig gesloten en zeer duur. Wij specialiseren ons specifiek in Postgres. Dit zijn allemaal open source producten. Sluit je bij ons aan!
Hiermee eindig ik. Dank u!
Vragen
Hallo! Bedankt voor de presentatie! Zeer interessant, vooral voor mij, omdat ik ongeveer een vergelijkbare taak een tijdje geleden heb opgelost. Daarom heb ik een aantal vragen. Hopelijk kan ik ten minste een deel vragen.
Het is interessant hoe u de ruimte voor deze omgeving berekent? De technologie gaat ervan uit dat onder bepaalde omstandigheden uw klonen tot maximale grootte kunnen groeien. Met andere woorden, als u een tien terabyte database heeft en 10 klonen, dan is het gemakkelijk om een situatie te modelleren waarin elke kloon 10 unieke gegevens weegt. Hoe berekent u deze ruimte, dat wil zeggen de delta waarover u sprak, waarin deze klonen zullen leven?
Een goede vraag. Het is belangrijk om specifiek op de klonen te letten. Als een kloon te grote veranderingen ondergaat en begin te groeien, kunnen we eerst een waarschuwing aan de gebruiker geven of deze kloon direct stoppen om een fail-situatie te voorkomen.
Ja, ik heb een vervolgvraag. Hoe zorgen jullie voor de levenscyclus van deze modules? Dit is een probleem voor ons en een heel apart verhaal. Hoe gaat dat in zijn werk?
Elke kloon heeft een bepaalde ttl. In principe hebben we een vaste ttl.
Welke, als ik vragen mag?
1 uur, dat wil zeggen, idle – 1 uur. Als hij niet wordt gebruikt, dan maken we hem onbruikbaar. Maar dit is geen verrassing, omdat we een kloon binnen enkele seconden kunnen opstarten. En als hij weer nodig is, dan is dat geen probleem.
Ik vind de keuze van technologieën ook interessant, omdat wij bijvoorbeeld om verschillende redenen meerdere methoden parallel gebruiken. Waarom precies ZFS? Waarom hebben jullie LVM niet gebruikt? Je noemde dat er problemen met LVM waren. Welke problemen waren dat? Naar mijn mening is de optie met een SAN optimaal wat betreft prestaties.
Wat is het belangrijkste probleem met ZFS? Dat je het op één host moet draaien, dat wil zeggen, alle instances zullen binnen dezelfde besturingssysteem leven. In het geval van SAN kun je verschillende hardware aansluiten. En het knelpunt zijn alleen de blokken die op de SAN zitten. Wat betreft de keuze van technologieën is het ook interessant. Waarom niet LVM?
We kunnen specifiek over LVM praten tijdens de meetup. Wat betreft de SAN – dat is gewoon duur. We kunnen het ZFS-systeem overal implementeren. Je kunt het op je eigen machine opzetten. Je kunt simpelweg de repository downloaden en het opzetten. ZFS kan praktisch overal worden geïnstalleerd, als we het over Linux hebben. Dat wil zeggen, we krijgen een zeer flexibele oplossing. En ZFS biedt uit de doos al veel functionaliteiten. Je kunt er onbeperkt data naartoe laden, een groot aantal schijven aansluiten, en het heeft snapshots. Zoals ik al zei, het is eenvoudig te beheren. Het lijkt erg prettig in gebruik. Het is betrouwbaar, heeft veel jaren achter de rug en heeft een grote, groeiende community. ZFS is een uiterst betrouwbaar oplossing.
Nikolay Samokhvalov: Mag ik nog een opmerking maken? Mijn naam is Nikolay, ik werk samen met Anatoly. Ik ben het ermee eens dat SAN geweldig is. En sommige van onze klanten hebben bijvoorbeeld Pure Storage enz.
Anatoli heeft terecht opgemerkt dat we ons richten op modulariteit. En in de toekomst kunnen we één interface implementeren – maak een snapshot, maak een clone, vernietig de clone. Dit is allemaal eenvoudig. En de opslag is geweldig als het er is.
Maar ZFS is voor iedereen beschikbaar. Genoeg van Delphix, zij hebben 300 klanten. Van deze klanten zitten er 50 in de Fortune 100, dat wil zeggen dat zij zich richten op NASA enzovoort. Het is tijd dat deze technologie voor iedereen beschikbaar komt. Daarom hebben we een open source kern. We hebben een deel van de interface dat niet open source is. Dit is het platform dat we zullen tonen. Maar we willen dat het voor iedereen toegankelijk is. We willen een revolutie teweegbrengen, zodat alle testers niet meer hoeven te gissen op laptops. We moeten SELECT kunnen schrijven en direct zien dat het traag is. Genoeg met wachten tot de DBA ons dit vertelt. Dat is het uiteindelijke doel. En ik denk dat we daar allemaal zullen komen. Dit ding maken we zodat het voor iedereen beschikbaar is. Daarom ZFS, omdat het overal beschikbaar zal zijn. Bedankt aan de community voor het oplossen van problemen en voor de open source licentie, enzovoort.
Hallo! Bedankt voor de presentatie! Mijn naam is Maxim. We hebben dezelfde problemen opgelost. We hebben het intern opgelost. Hoe splitsen jullie de resources tussen deze clones? Elke clone kan op elk moment zijn eigen taak uitvoeren: de één test het ene, de ander het andere, de een bouwt een index, de ander heeft zware jobs draaien. En als je CPU nog wel kunt verdelen, hoe delen jullie dat dan qua I/O? Dit is de eerste vraag.
En de tweede vraag betreft de ongelijkheid van de testomgeving. Stel dat ik hier ZFS heb en alles geweldig is, maar bij de klant in productie is het geen ZFS, maar bijvoorbeeld ext4. Hoe gaat het in dat geval?
Zeer goede vragen. Ik heb deze kwestie met het delen van resources kort aangestipt. De oplossing is als volgt. Stel je voor dat je op staging aan het testen bent. Het kan ook zijn dat tegelijkertijd iemand een bepaalde belasting genereert, terwijl een ander iets anders doet. En uiteindelijk zie je onduidelijke metrics. Zelfs dezelfde kwestie kan zich met productie voordoen. Wanneer je een bepaalde query wilt testen en je ziet dat er een probleem mee is – het is traag – dan ligt het probleem eigenlijk niet bij de query, maar bij de parallelle belasting.
En daarom is het hier belangrijk om je te concentreren op welk plan we gaan volgen, welke stappen we in dit plan zullen nemen en hoeveel gegevens we hiervoor verzamelen. Het feit dat onze schijven bijvoorbeeld belast zullen zijn met iets, zal specifiek invloed hebben op de timing. Maar we kunnen aan de hoeveelheid gegevens inschatten hoe zwaar deze aanvraag belast is. Het is niet zo belangrijk dat er tegelijkertijd nog iets anders uitgevoerd wordt.
Ik heb twee vragen. Dit is een echt geweldig systeem. Zijn er voorbeelden waarbij de gegevens op productie kritiek zijn, bijvoorbeeld creditcardnummers? Is er al iets beschikbaar of is dit een aparte taak? En de tweede vraag - is er iets dergelijks voor MySQL?
Over de gegevens gesproken. We zullen obfuscatie toepassen, maar dat doen we nog niet. Maar als je precies Joe implementeert, als je ontwikkelaars geen toegang geeft, is er geen toegang tot de gegevens. Waarom? Omdat Joe de gegevens niet laat zien. Hij toont alleen metrics, plannen, en dat is het. Dit is speciaal zo ontworpen omdat het een van de vereisten van onze klant was. Ze wilden de mogelijkheid hebben om te optimaliseren, maar daarbij niet iedereen toegang te geven.
Wat betreft MySQL. Dit systeem kan voor alles worden gebruikt dat de status op schijf opslaat. En omdat we met Postgres werken, richten we ons in eerste instantie volledig op de automatisering voor Postgres. We willen geautomatiseerd gegevens ophalen uit de backup. We configureren Postgres juist. We weten hoe we ervoor kunnen zorgen dat de plannen op elkaar afgestemd zijn, enzovoort.
Maar omdat het systeem uitbreidbaar is, kan het ook voor MySQL worden gebruikt. En dergelijke voorbeelden bestaan. Er is een vergelijkbaar systeem bij Yandex, maar zij publiceren het nergens. Ze gebruiken het intern in Yandex.Metrica. En daar gaat het inderdaad om MySQL. Maar de technologieën zijn dezelfde, ZFS.
Dank voor de presentatie! Ik heb ook een paar vragen. Je noemde dat klonen gebruikt kan worden voor analytics, bijvoorbeeld om extra indices te bouwen. Kun je iets meer vertellen over hoe dat werkt?
En ik stel meteen de tweede vraag over de gelijkmatigheid van de omgevingen, de gelijkmatigheid van de plannen. Het plan hangt onder andere af van de statistieken die door Postgres zijn verzameld. Hoe lossen jullie dit probleem op?
Er zijn geen specifieke casestudy-analyses, omdat we deze nog niet hebben gebruikt, maar er is wel een mogelijkheid. Stel je voor dat een verzoek wordt uitgevoerd op een tabel met honderd miljoen records, in een kolom die doorgaans niet is geïndexeerd in prod. En we willen daar gegevens over berekenen. Als we dit verzoek in prod uitvoeren, bestaat de kans dat er een vertraging optreedt, omdat het verzoek daar een minuut kan duren.
Oké, laten we een dunne kloon maken die we gerust een paar minuten kunnen stoppen. En om het gemakkelijker te maken om analytics te berekenen, voegen we indices toe aan de kolommen waarin we geïnteresseerd zijn.
Zal de index elke keer worden aangemaakt?
We kunnen het zo regelen dat we de gegevens aanraaken, snapshots maken, en dan herstellen vanuit die snapshot om nieuwe verzoeken uit te voeren. Dit betekent dat we nieuwe klonen kunnen maken met al ingestelde indices.
Wat betreft de vraag over statistieken: als we herstellen vanuit een back-up, of als we replicatie uitvoeren, dan zijn onze statistieken exact hetzelfde. Omdat we de volledige fysieke datastructuur hebben, dat wil zeggen dat we ook de gegevens meenemen zoals ze zijn, met alle statistische metrics.
Hier is een ander probleem. Als je een cloudoplossing gebruikt, zijn er alleen logische dumps beschikbaar, omdat Google en Amazon geen fysieke kopieën geven. Dit zal een probleem zijn.
Bedankt voor de presentatie. Hier werden twee goede vragen gesteld over MySQL en over resource-scheiding. Maar in wezen gaat alles terug op het feit dat dit onderwerp niet specifiek is voor bepaalde databases, maar over het algemeen voor het bestandssysteem. En dus moeten de vragen over resource-scheiding daar ook vandaan komen, niet aan het einde dat het Postgres is, maar in het bestandssysteem. de server, in instance.
Mijn vraag gaat iets anders. Het is dichter bij de gelaagdheid van de database, waar meerdere lagen zijn. We hebben bijvoorbeeld een update ingesteld voor een tien terabyte afbeelding, onze replicatie loopt. En we gebruiken deze oplossing specifiek voor databases. De replicatie vindt plaats, de gegevens worden bijgewerkt. Ondertussen werken er 100 medewerkers die voortdurend verschillende snapshots uitvoeren. Wat te doen? Hoe kunnen we ervoor zorgen dat er geen conflicten ontstaan, dat ze iets hebben gestart en vervolgens het bestandssysteem is gewijzigd, en al die snapshots niet meer kloppen?
Ze gaan niet rijden, omdat dat is hoe ZFS werkt. We kunnen wijzigingen in het bestandssysteem in één stroom afzonderlijk bijhouden, die via replicatie binnenkomen. En oudere versies van gegevens kunnen als klonen worden opgeslagen, die door de ontwikkelaars worden gebruikt. En dat werkt voor ons, daar is alles in orde mee.
Dus de update zal plaatsvinden als een extra laag, en alle nieuwe snapshots zullen al voortkomen uit deze laag, klopt dat?
Vanuit de vorige lagen, die voortkomen uit eerdere replicaties.
De vorige lagen zullen verdwijnen, maar ze zullen verwijzen naar de oude laag, terwijl de nieuwe beelden uit de laatste laag zullen worden gehaald die tijdens de update is verkregen?
In het algemeen, ja.
Als gevolg daarvan zullen we dus veel lagen hebben. En in de loop van de tijd moeten ze worden gecomprimeerd?
Ja, helemaal correct. Er is een bepaald venster. We bewaren wekelijkse snapshots. Dit hangt af van de middelen die je hebt. Als je in staat bent om veel gegevens op te slaan, kun je snapshots lange tijd bewaren. Ze worden niet vanzelf verwijderd. Er zal geen gegevenscorruptie zijn. Als de snapshots verouderd zijn, zoals wij denken, dat wil zeggen, dit hangt af van het beleid binnen het bedrijf, dan kunnen we ze gewoon verwijderen en ruimte vrijmaken.
Hallo, bedankt voor de presentatie! Over de vraag van Joe. U zei dat de klant niet wilde dat iedereen toegang had tot de gegevens. Strikt genomen, als iemand het resultaat van Explain Analyze heeft, kan hij de gegevens in de gaten houden.
Dat klopt. Bijvoorbeeld, we kunnen schrijven: "SELECT FROM WHERE email = iemand". Dat wil zeggen, we zullen de gegevens zelf niet zien, maar we kunnen enkele indirecte tekenen bekijken. Dit moet begrepen worden. Maar aan de andere kant is dat allemaal zichtbaar. We hebben log auditing, we hebben toezicht van collega's die ook zien waar de ontwikkelaars mee bezig zijn. En als iemand dat probeert te doen, zal de beveiligingsdienst naar hen toe komen en dit probleem aanpakken.
Goedemiddag! Dank u voor de presentatie! Ik heb een korte vraag. Als Slack binnen het bedrijf niet wordt gebruikt, is er dan momenteel enige binding ermee of kunnen we instances voor ontwikkelaars opzetten om de testapplicatie aan de databases te koppelen?
Momenteel hebben we alleen een koppeling met Slack, wat betekent dat er geen andere messagingdiensten zijn, maar we willen ook andere messagingdiensten ondersteunen. Wat kunt u doen? U kunt DB Lab zonder Joe opzetten, werken met de REST API of via ons platform clonen maken en verbinding maken met PSQL. Dit kan echter alleen als u bereid bent om uw ontwikkelaars toegang tot de gegevens te geven, omdat er dan geen interface meer zal zijn.
Ik heb deze tussenlaag niet nodig, maar ik heb wel die mogelijkheid nodig.
Dan – ja, dat kan gedaan worden.
Bron: habr.com
