

Hallo allemaal! Mijn naam is Oleg Sidorenkov, ik werk bij het bedrijf DomClick als teamleider van de infrastructuur. We hebben 'Cube' al meer dan drie jaar in productie en in die tijd hebben we veel interessante momenten meegemaakt. Vandaag zal ik jullie vertellen hoe je met de juiste aanpak nog meer prestaties uit 'vanilla' Kubernetes kunt halen voor je cluster. Klaar, set, go!
Jullie weten allemaal goed dat Kubernetes een schaalbaar open-source systeem is voor het orkestreren van containers; of beter gezegd, vijf binaries die magie verrichten door de levenscyclus van jullie microservices in een serveromgeving te beheren. Bovendien is het een vrij flexibele tool die, net als een Lego-bouwer, kan worden samengesteld voor maximale aanpassing aan verschillende taken.
En het lijkt allemaal goed: gooi servers in de cluster zoals brandhout in de kachel en je hebt geen zorgen. Maar als je voor ecologie bent, dan ga je nadenken: 'Hoe kan ik het vuur in de kachel ondersteunen en ook het bos sparen?'. Met andere woorden, hoe vind je manieren om de infrastructuur te verbeteren en de kosten te verlagen.
1. Houd de middelen van teams en applicaties in de gaten
Een van de meest alledaagse, maar effectieve methoden is het invoeren van requests/limits. Verdeel applicaties over namespaces en namespaces over ontwikkelingsteams. Stel de waarden voor CPU-tijd, geheugen en tijdelijke opslag in voor de applicatie voordat je deze uitrolt.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Via ervaring hebben we geconcludeerd: het heeft geen zin om requests meer dan twee keer de limits te laten zijn. De omvang van de cluster wordt berekend op basis van requests, en als je applicaties met een verschil in middelen opzet, bijvoorbeeld 5-10 keer, stel je je voor wat er met je node gebeurt wanneer deze vol raakt met pods en plotseling een belasting krijgt. Niets goeds. Op zijn minst throttling, en op zijn ergst zeg je vaarwel tegen de worker en krijg je cyclusbelasting op de andere nodes nadat de pods beginnen te migreren.
Bovendien kunt u met behulp van limitranges je kunt aan het begin waarden voor middelen voor de container instellen — minimaal, maximaal en standaard:
➜  ~ kubectl beschrijf limietranges --namespace ops
Naam:       limiet-bereik
Namespace:  ops
Type        Resource           Min   Max   Standaard Verzoek  Standaard Limiet  Max Limiet/Bericht Verhouding
----        --------           ---   ---   -------------------  ----------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   geheugen           64Mi  40Gi  128Mi            128Mi          2
Vergeet niet de resources van de namespace te beperken, zodat één team niet alle resources van het cluster kan opvorderen:
➜  ~ kubectl beschrijf resourcequota's --namespace ops
Naam:                   resource-quota
Namespace:              ops
Resource                Gebruikt       Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Zoals te zien in de beschrijving resourcequota's, als het ops-team pods wil implementeren die nog eens 10 cpu gaan verbruiken, dan zal de scheduler dit niet toestaan en een foutmelding geven:
Fout bij het maken: pods "nginx-proxy-9967d8d78-nh4fs" is verboden: quota overschreden: resource-quota, aangevraagd: limits.cpu=5, requests.cpu=5, gebruikt: limits.cpu=77250m, requests.cpu=53850m, beperkt: limits.cpu=10, requests.cpu=10Om een dergelijke taak op te lossen, kan je een tool schrijven, bijvoorbeeld zoals , dat in staat is om de status van de resources van teams op te slaan en te committen.
2. Kies een optimale opslagoplossing
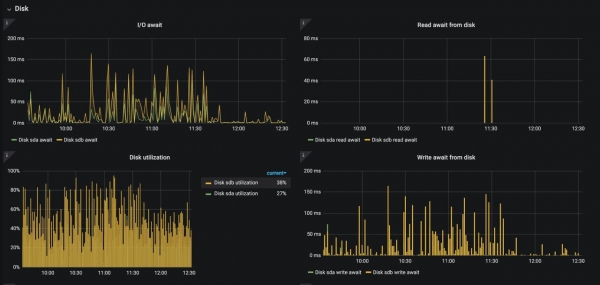
Hier wil ik het thema van persistente volumes en het schijfsysteem van Kubernetes worker nodes aansnijden. Ik hoop dat niemand in productie "Kube" op HDD gebruikt, maar soms is zelfs een gewone SSD niet genoeg meer. We zijn geconfronteerd met een probleem waarbij logs de schijf verwoestten door invoer- en uitvoerbewerkingen, en de oplossingen zijn hier beperkt:
Gebruik hoge-prestatie SSD's of schakel over naar NVMe (indien je zelf over je hardware beschikt).
Verminder het logniveau.
Voer "slimme" balans van pods uit die de schijf zwaar belasten (
podAntiAffinity).
De screenshot hierboven toont wat er met de schijf gebeurt onder de nginx-ingress-controller wanneer logging van access_logs is ingeschakeld (~12 duizend logs/sec). Een dergelijke staat kan uiteraard leiden tot degradatie van alle applicaties op deze node.
Wat betreft PV, ik heb helaas niet alle Persistente Volumes. Gebruik de beste optie die bij jou past. Historisch gezien heeft een klein deel van de services RWX-volumes nodig, en lang geleden begonnen we een NFS-opslag voor deze taak te gebruiken. Goedkoop en… genoeg. Natuurlijk hebben we flink wat problemen ondervonden — zowel met de uitvoering als met de configuratie, maar we hebben geleerd om het te tunen, en nu hebben we er geen hoofdpijn meer van. Als het mogelijk is, stap over naar objectstorage S3.
3. Verzamel geoptimaliseerde afbeeldingen
Het is het beste om geoptimaliseerde containerafbeeldingen te gebruiken, zodat Kubernetes ze sneller kan ophalen en efficiënter kan uitvoeren.
Geoptimaliseerd betekent dat de afbeeldingen:
slechts één applicatie bevatten of slechts één functie uitvoeren;
klein van formaat zijn, omdat grote afbeeldingen slechter door het netwerk worden verzonden;
eindpunten hebben voor gezondheid- en gereedtests, waarmee Kubernetes acties kan ondernemen in het geval van uitvaltijd;
container-vriendelijke besturingssystemen gebruiken (zoals Alpine of CoreOS), die beter bestand zijn tegen configuratiefouten;
multi-stage builds gebruiken, zodat je alleen gecompileerde applicaties hoeft te implementeren en niet de bijbehorende bronbestanden.
Er zijn veel tools en services beschikbaar die in realtime kunnen controleren en optimaliseren van afbeeldingen. Het is belangrijk om ze altijd up-to-date en beveiligd te houden. Uiteindelijk krijg je:
Vermindering van de netwerklast op het hele cluster.
Vermindering van de opstarttijd van de container.
Een kleiner volume van je hele Docker registry.
4. Gebruik DNS-cache
Als het gaat om hoge belasting, is het leven zonder optimalisatie van het DNS-systeem van het cluster behoorlijk slecht. Lang geleden ondersteunden Kubernetes-ontwikkelaars hun oplossing kube-dns. Dit werd ook bij ons geïmplementeerd, maar deze software werd nauwelijks getuned en leverde niet de vereiste prestaties, ook al leek de taak eenvoudig. Vervolgens kwam coredns, waar we naar overstapten en we ervaren geen problemen meer, uiteindelijk werd het de standaard DNS-service in K8s. Op een bepaald moment kwamen we aan 40.000 rps naar het DNS-systeem, en deze oplossing was ook niet genoeg. Maar, bij een gelukkige samenloop van omstandigheden, kwam Nodelocaldns uit, ook bekend als node local cache, ook wel .
Waarom gebruiken we dit? In de Linux-kernel is er een bug die bij meerdere verzoeken via conntrack NAT over UDP leidt tot een raceconditie bij het schrijven naar de conntrack-tabellen, waardoor een deel van het verkeer via NAT verloren gaat (elk bezoek via de Service is NAT). Nodelocaldns lost dit probleem op door NAT te elimineren en de verbinding te upgraden naar TCP naar upstream DNS, en door lokale caching van DNS-verzoeken naar upstreams (inclusief een korte negatieve cache van 5 seconden).
5. Schaal pods automatisch horizontaal en verticaal
Kun je met zekerheid zeggen dat al je microservices klaar zijn voor een twee- tot drievoudige toename in belasting? Hoe beheer je de resources voor je applicaties op de juiste manier? Het draaiende houden van een paar pods boven de werkbelasting kan overbodig blijken te zijn, terwijl het houden van de capaciteit op zijn maximale kan leiden tot downtime door een plotselinge toename van het verkeer naar de service. De gouden middenweg kan worden bereikt door middelen zoals en .
VPA die automatisch de requests/limits van je containers in de pod aanpast op basis van het werkelijke gebruik. Hoe kan dit nuttig zijn? Als je pods hebt die om een of andere reden niet horizontaal kunnen worden geschaald (wat niet echt betrouwbaar is), kun je overwegen om VPA het aanpassen van zijn resources te laten doen. Het kenmerk is het aanbevelingssysteem op basis van historische en actuele gegevens van de metric-server, dus als je niet automatisch requests/limits wilt wijzigen, kun je gewoon de aanbevolen resources voor je containers volgen en de instellingen optimaliseren om CPU en geheugen in de cluster te besparen.
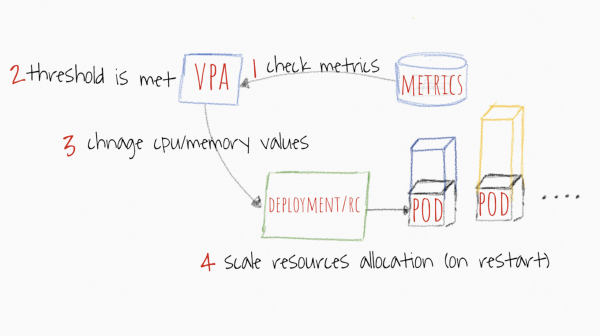 Afbeelding afkomstig van https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
De scheduler in Kubernetes is altijd gebaseerd op requests. Welke waarde je daar ook invoert, de scheduler zoekt een geschikte node op basis daarvan. Limits zijn nodig voor de kubelet om te begrijpen wanneer deze moet throttlen of pods moet beëindigen. En aangezien de enige belangrijke parameter de waarde van de requests is, werkt de VPA hiermee. Elke keer dat je verticaal schaling instelt voor een applicatie, geef je aan wat de requests moeten zijn. En wat gebeurt er dan met de limits? Deze parameter zal ook proportioneel worden geschaald.
Bijvoorbeeld, hier zijn de gebruikelijke instellingen voor een pod:
resources:
   requests:
     memory: 250Mi
     cpu: 200m
   limits:
     memory: 500Mi
     cpu: 350m
Het aanbevelingssysteem bepaalt dat uw toepassing voor normaal functioneren 300m CPU en 500Mi vereist. U krijgt de volgende configuratie:
resources:
   requests:
     memory: 500Mi
     cpu: 300m
   limits:
     memory: 1000Mi
     cpu: 525m
Zoals eerder vermeld, is dit een proportionele schaalvergroting op basis van de verhouding van requests/limits in het manifest:
CPU: 200m → 300m: verhouding 1:1.75;
Geheugen: 250Mi → 500Mi: verhouding 1:2.
Wat betreft HPA, dan is het mechanisme hier transparanter. Drempelwaarden voor metrics, zoals CPU en geheugen, worden ingesteld, en als de gemiddelde waarde van alle replica's de drempel overschrijdt, wordt de applicatie met +1 pod vergroot totdat de waarde onder de drempel valt of het maximale aantal replica's is bereikt.
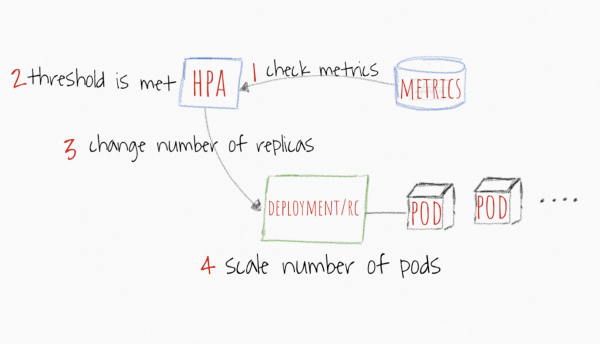 Afbeelding afkomstig van https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Naast reguliere metrics, zoals CPU en geheugen, kunt u drempelwaarden instellen op uw aangepaste metrics vanuit Prometheus en hiermee werken, als u dit de meest nauwkeurige manier vindt om te bepalen wanneer uw applicatie moet schalen. Zodra de applicatie zich stabiliseert onder de opgegeven drempelwaarde, zal HPA de pods naar beneden schalen tot het minimale aantal replica's of tot de toestand waarin de belasting aan de opgegeven drempel voldoet.
6. Vergeet Node Affinity en Pod Affinity niet
Niet alle nodes draaien op dezelfde hardware, en niet alle pods hoeven toepassingen uit te voeren die intensieve berekeningen vereisen. Kubernetes stelt u in staat om specialisaties voor nodes en pods in te stellen met behulp van Node Affinity en Pod Affinity.
Als u nodes hebt die geschikt zijn voor intensieve rekentaken, is het beter om toepassingen aan de juiste nodes te koppelen voor maximale efficiëntie. Gebruik daarvoor nodeSelector met het label van de node.
Stel dat u twee nodes heeft: de ene met CPUType=HIGHFREQ en een groot aantal snelle cores, de andere met MemoryType=HIGHMEMORY een grote hoeveelheid geheugen en hogere prestaties. Het is het eenvoudigst om de pod-distributie aan de node HIGHFREQte koppelen door de volgende selector toe te voegen in de sectie spec :
…
nodeSelector:
	CPUType: HIGHFREQ
Een meer kostbare en specifieke manier om dit te doen, is door gebruik te maken van nodeAffinity in het veld affinity de sectie spec. Er zijn twee opties:
requiredDuringSchedulingIgnoredDuringExecution: harde configuratie (de planner zal pods alleen op specifieke nodes implementeren (en nergens anders));preferredDuringSchedulingIgnoredDuringExecution: zachte configuratie (de planner zal proberen te deploegen op specifieke knooppunten, en als dat niet lukt, probeert hij het op het volgende beschikbare knooppunt).
Je kunt een specifieke syntaxis voor het beheren van knooppuntlabels opgeven, bijvoorbeeld, In, NotIn, Bestaat, BestaatNiet, Gt of Lt. Vergeet echter niet dat complexe methoden in lange lijsten van labels de besluitvorming in kritieke situaties zullen vertragen. Met andere woorden, maak het niet te ingewikkeld.
Zoals hierboven vermeld, stelt Kubernetes je in staat om de binding van huidige pods op te geven. Dat wil zeggen, je kunt ervoor zorgen dat bepaalde pods samenwerken met andere pods in dezelfde beschikbaarheidszone (relevant voor cloudomgevingen) of knooppunten.
In podAffinity velden affinity de sectie spec zijn dezelfde velden beschikbaar als in het geval van nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution en preferredDuringSchedulingIgnoredDuringExecution. Het enige verschil is dat matchExpressions pods bindt aan een knooppunt waarop al een pod met dat label draait.
Verder biedt Kubernetes het veld podAntiAffinity, dat, in tegenstelling tot, de pod niet bindt aan een knooppunt met bepaalde pods.
Wat betreft de uitdrukkingen, nodeAffinity kan dezelfde raad worden gegeven: probeer de regels eenvoudig en logisch te houden, en probeer de specificatie van pods niet te overladen met een complexe set regels. Het is heel gemakkelijk om een regel te creëren die niet voldoet aan de voorwaarden van het cluster, wat extra belasting op de planner creëert en de algehele prestaties verlaagt.
7. Taints & Tolerances
Er is nog een manier om de planner te beheren. Als je een groot cluster hebt met honderden knooppunten en duizenden microservices, is het zeer moeilijk om bepaalde pods niet toe te staan op bepaalde knooppunten.
Hier helpt het taints-mechanisme — beperkende regels. Bijvoorbeeld, in bepaalde scenario's kan het verboden zijn dat bepaalde knooppunten pods draaien. Om een taint op een specifiek knooppunt toe te passen, moet je de optie taint in kubectl gebruiken. Geef de sleutel en waarde op, en dan taint zoals NoSchedule of NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleHet is ook vermeldenswaard dat het taint-mechanisme drie belangrijke effecten ondersteunt: NoSchedule, NoExecute en PreferNoSchedule.
NoSchedulebetekent dat zolang er geen overeenkomstige vermelding in de pod-specificatie istolerances, deze niet op een knooppunt kan worden gedeployed (in dit gevalnode10).PreferNoSchedule— een vereenvoudigde versieNoSchedule. In dit geval zal de planner proberen geen pods zonder de betreffende vermeldingtolerancesop het knooppunt te distribueren, maar dit is geen harde beperking. Als er geen middelen in het cluster beschikbaar zijn, zullen de pods beginnen te deploegen op dit knooppunt.NoExecute— dit effect activeert onmiddellijke evacuatie van pods die geen overeenkomstige vermelding hebben.tolerances.
Interessant is dat dit gedrag kan worden teruggedraaid met behulp van het mechanisme tolerations. Dit is handig wanneer er een 'verboden' node is en je alleen infrastructuurservices op deze node wilt plaatsen. Hoe doe je dat? Sta alleen die pods toe waarvoor er een geschikte toleration is.
Zo zal de specificatie van de pod eruitzien:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Dit betekent niet dat bij de volgende redeploy de pod op deze node terechtkomt, dit is niet het Node Affinity mechanisme en nodeSelector. Maar door verschillende functies te combineren, kun je een zeer flexibele configuratie van de scheduler bereiken.
8. Stel de prioriteit van pod-implementaties in
Het feit dat je de binding van pods aan nodes hebt ingesteld, betekent niet dat alle pods met dezelfde prioriteit moeten worden verwerkt. Bijvoorbeeld, je wilt misschien bepaalde pods eerder implementeren dan anderen.
Kubernetes biedt verschillende manieren om de prioriteit van pods in te stellen (Pod Priority and Preemption). De configuratie bestaat uit verschillende delen: het object PriorityClass en de beschrijving van het veld priorityClassName in de specificatie van de pod. Laten we een voorbeeld bekijken:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Deze prioriteitsklasse mag alleen worden gebruikt voor zeer belangrijke pods"
We maken PriorityClass, geven het een naam, beschrijving en waarde. Hoe hoger value, hoe hoger de prioriteit. De waarde kan elk 32-bits geheel getal zijn dat kleiner is dan of gelijk aan 1.000.000.000. Hogere waarden zijn gereserveerd voor kritieke systeem-pods die doorgaans niet kunnen worden weggehaald. Wegnemen zal alleen gebeuren als er geen plek is voor de hoog-prioritaire pod om te worden geïmplementeerd, waarna bepaalde pods van een specifieke node zullen worden geëvacueerd. Als dit mechanisme te rigide voor je is, kun je de optie preemptionPolicy: Never, toevoegen, en dan zal er geen afname zijn, de pod staat bovenaan de wachtrij en wacht tot de scheduler vrije middelen voor hem vindt.
Vervolgens maken we een pod waarin we de naam opgeven priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Je kunt zoveel prioriteitsklassen creëren als je wilt, maar het wordt aanbevolen om dit niet te overdrijven (laten we zeggen, beperk je tot lage, gemiddelde en hoge prioriteit).
Zo kun je de efficiëntie van de uitrol van kritieke services zoals de nginx-ingress-controller, coredns, enzovoort verbeteren wanneer dat nodig is.
9. Optimaliseer je ETCD-cluster
ETCD kan worden gezien als de hersenen van het hele cluster. Het is erg belangrijk om deze database op hoog niveau te laten functioneren, omdat de snelheid van de operaties in 'Kube' ervan afhangt. Een standaard, maar toch goede oplossing is om het ETCD-cluster op de master-knooppunten te houden, zodat je een minimale latency naar kube-apiserver hebt. Als dit niet mogelijk is, positioneer ETCD dan zo dicht mogelijk bij elkaar, met goede bandbreedte tussen de deelnemers. Houd ook rekening met het aantal knooppunten dat uit ETCD kan vallen zonder schade aan het cluster.
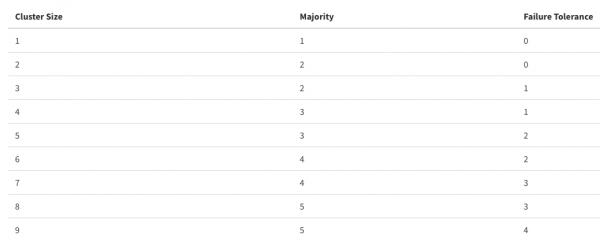
Houd er rekening mee dat een overmatig aantal deelnemers in het cluster de fouttolerantie kan verhogen ten koste van de prestaties; alles moet in evenwicht zijn.
Als het gaat om de configuratie van de service, zijn er niet veel aanbevelingen:
Zorg voor goede hardware, afhankelijk van de grootte van het cluster (meer hierover te lezen) ).
Pas een paar parameters aan als je het cluster verspreid hebt over een paar datacenters of als je netwerk en schijven te wensen overlaten (meer hierover te lezen) ).
Conclusie
In dit artikel worden punten beschreven die ons team probeert te volgen. Dit is geen stapsgewijze handleiding, maar opties die nuttig kunnen zijn voor het optimaliseren van overheadkosten voor het cluster. Het is duidelijk dat elk cluster uniek is, en de oplossingen voor configuratie kunnen sterk variëren, daarom zou het interessant zijn om van jullie te horen: hoe monitoren jullie jullie Kubernetes-cluster, waarmee verbeteren jullie de prestaties? Deel je ervaringen in de reacties, we zijn benieuwd naar je inzichten.
Bron: habr.com
