

Google heeft een nieuwe audiocodec genaamd Lyra geïntroduceerd, die is geoptimaliseerd voor het behalen van maximale spraakkwaliteit, zelfs bij het gebruik van zeer trage communicatielijnen. De implementatiecode van Lyra is geschreven in C++ en is beschikbaar onder de Apache 2.0-licentie, maar er is een proprietary bibliotheek libsparse_inference.so nodig voor de kern van wiskundige berekeningen. Het wordt opgemerkt dat de proprietary bibliotheek tijdelijk is — in de toekomst belooft Google een open vervanging te ontwikkelen en ondersteuning voor verschillende platforms te bieden.
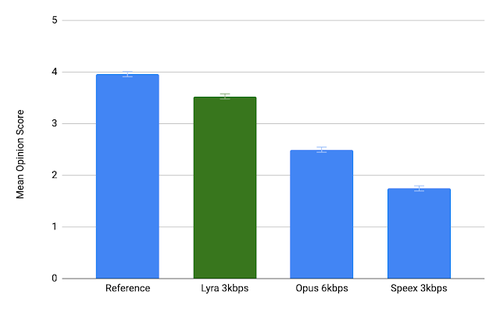
Wat betreft de kwaliteit van de overgedragen spraakgegevens bij lage snelheden, overtreft Lyra aanzienlijk traditionele codecs die gebruikmaken van digitale signaalverwerkingstechnieken. Om een hoge kwaliteit van spraakoverdracht te bereiken onder beperkende omstandigheden van gegevensoverdracht, worden naast conventionele geluidcompressiemethoden en signaaltransformaties, in Lyra een spraakmodel toegepast op basis van machine learning, waarmee ontbrekende informatie kan worden gereproduceerd op basis van typische spraakkenmerken. De gebruikte model voor geluidsgeneratie is getraind met behulp van duizenden uren geluidsopnamen in meer dan 70 talen.
De codec omvat een encoder en een decoder. De werking van de encoder bestaat uit het extraheren van parameters van spraakdata elke 40 milliseconden, het comprimeren van deze gegevens en het verzenden naar de ontvanger via het netwerk. Voor gegevensoverdracht is voldoende met een communicatielijn met een snelheid van 3 kilobit per seconde. De geëxtraheerde geluidsparameters omvatten logaritmische mel-spectrogrammen, die rekening houden met de energie-eigenschappen van spraak in verschillende frequentiebanden en zijn voorbereid met inachtneming van het menselijke auditieve waarnemingsmodel.
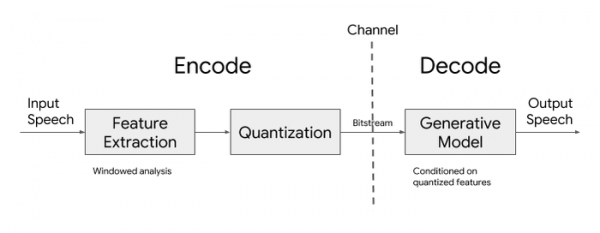
In de decoder wordt een generatief model gebruikt, dat op basis van de aangeleverde geluidsparameters het spraaksignaal weergeeft. Om de rekencomplexiteit te verlagen, is er een lichte model op basis van een recurrent neuraal netwerk toegepast, dat een variant is van het WaveRNN spraaksynthesemodel, waarin een lagere samplesnelheid wordt gebruikt, maar waarin meerdere signalen parallel worden gegenereerd in verschillende frequentiebereiken. De verkregen signalen worden vervolgens samengevoegd om één uitvoersignaal te verkrijgen dat overeenkomt met de opgegeven aftastfrequentie.
Om het proces te versnellen zijn ook gespecialiseerde processor-instructies toegepast die beschikbaar zijn in 64-bits ARM-processors. Uiteindelijk kan de Lyra-codec, ondanks het gebruik van machine learning, realtime spraak coderen en decoderen op smartphones in het middensegment, met een signaalvertraging van ongeveer 90 milliseconden.
Bron: opennet.ru
