

Hallo, Habr! In dit artikel wil ik een geweldig hulpmiddel voor de ontwikkeling van batchprocessen voor gegevensverwerking bespreken, bijvoorbeeld in de infrastructuur van een bedrijfs-DWH of uw DataLake. We hebben het hier over Apache Airflow (hierna Airflow). Het wordt onterecht onderbelicht op Habr, en in het belangrijkste deel zal ik proberen u ervan te overtuigen dat u Airflow tenminste moet overwegen bij het kiezen van een scheduler voor uw ETL/ELT-processen.
Eerder schreef ik een serie artikelen over het onderwerp DWH toen ik bij Tinkoff Bank werkte. Nu ben ik onderdeel van het team van Mail.Ru Group en houd ik me bezig met de ontwikkeling van een platform voor data-analyse in de gaming sector. Eigenlijk zullen we, naarmate er nieuws en interessante oplossingen beschikbaar komen, hier met het team vertellen over ons data-analyseplatform.
Proloog
Laten we beginnen. Wat is Airflow? Het is een bibliotheek (of eigenlijk ) voor de ontwikkeling, planning en monitoring van workflows. De belangrijkste eigenschap van Airflow is dat processen worden beschreven (ontwikkeld) met Python-code. Hieruit volgen talloze voordelen voor het organiseren van uw project en ontwikkeling: uw (bijvoorbeeld) ETL-project is in wezen gewoon een Python-project, en u kunt het organiseren zoals u dat wilt, rekening houdend met de infrastructuur, de omvang van het team en andere vereisten. Instrumenteel is alles eenvoudig. Gebruik bijvoorbeeld PyCharm + Git. Dit is geweldig en heel handig!
Laten we nu de belangrijkste entiteiten van Airflow bekijken. Door hun essentie en doel te begrijpen, kunt u de architectuur van processen optimaal organiseren. De belangrijkste entiteit is waarschijnlijk de Directed Acyclic Graph (hierna DAG).
DAG
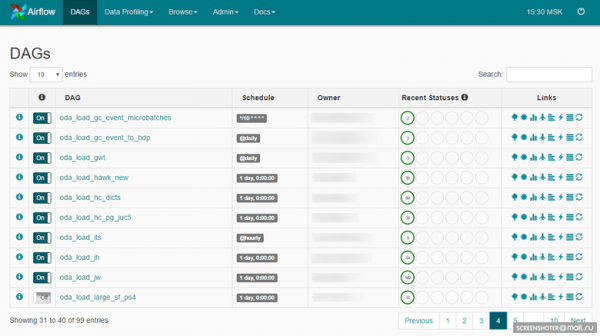
Een DAG is een semantische verzameling van de taken die u in een strikt bepaalde volgorde op een bepaald schema wilt uitvoeren. Airflow biedt een handige webinterface voor het werken met DAG's en andere entiteiten:
Een DAG kan er als volgt uitzien:
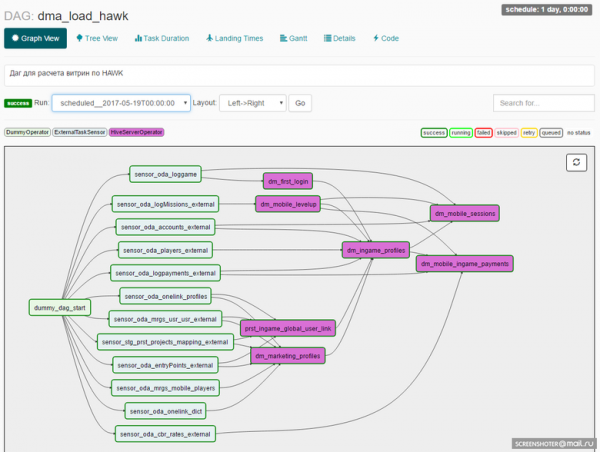
Een ontwikkelaar legt bij het ontwerpen van een DAG een set operators vast waarop de taken binnen de DAG zullen worden gebaseerd. Hier komen we nog bij een belangrijke entiteit: de Airflow Operator.
Operators
Een operator is een entiteit waaronder instances van taken worden gemaakt, waarin wordt beschreven wat er zal gebeuren tijdens de uitvoering van een taakinstance. bevatten al een set kant-en-klare operators. Voorbeelden:
- BashOperator — operator voor het uitvoeren van bash-commando's.
- PythonOperator — operator voor het aanroepen van Python-code.
- EmailOperator — operator voor het verzenden van e-mails.
- HTTPOperator — operator voor het werken met http-requests.
- SqlOperator — operator voor het uitvoeren van SQL-code.
- Sensor — operator die wacht op een gebeurtenis (zoals het bereiken van een bepaald tijdstip, het verschijnen van een vereiste bestand, een regel in de database, een antwoord van de API, enzovoort).
Er zijn meer specifieke operators: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Je kunt ook operators ontwikkelen, afgestemd op je eigen kenmerken, en deze in je project gebruiken. Bijvoorbeeld, we hebben MongoDBToHiveViaHdfsTransfer gemaakt, een operator voor het exporteren van documenten van MongoDB naar Hive, en verschillende operators voor het werken met: CHLoadFromHiveOperator en CHTableLoaderOperator. In wezen, zodra er in een project vaak gebruikte code ontstaat, gebouwd op basis van de basisoperators, kun je overwegen deze in een nieuwe operator samen te voegen. Dit vereenvoudigt verdere ontwikkelingen en je breidt je bibliotheek van operators in het project uit. Vervolgens moeten al deze voorbeelden van taken worden uitgevoerd, en nu gaat het om de scheduler.
De taakplanner in Airflow is gebaseerd op
Scheduler
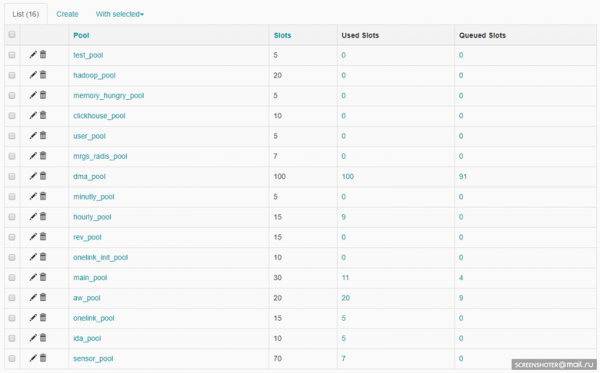
Celery. Elke pool heeft een beperking op het aantal slots. Wanneer er een DAG wordt aangemaakt, wordt er een pool toegewezen:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh") DAG_NAME = 'dma_load' OWNER = 'Vasya Pupkin' DEPENDS_ON_PAST = True EMAIL_ON_FAILURE = True EMAIL_ON_RETRY = True RETRIES = int(Variable.get('gv_dag_retries')) POOL = 'dma_pool' PRIORITY_WEIGHT = 10start_dt = datetime.today() - timedelta(1) start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)default_args = { 'owner': OWNER, 'depends_on_past': DEPENDS_ON_PAST, 'start_date': start_dt, 'email': ALERT_MAILS, 'email_on_failure': EMAIL_ON_FAILURE, 'email_on_retry': EMAIL_ON_RETRY, 'retries': RETRIES, 'pool': POOL, 'priority_weight': PRIORITY_WEIGHT } dag = DAG(DAG_NAME, default_args=default_args) dag.doc_md = __doc__
De pool die op DAG-niveau is ingesteld, kan op taakniveau worden overschreven.Een aparte proces, de Scheduler, is verantwoordelijk voor de planning van alle taken in Airflow. De Scheduler is verantwoordelijk voor alle mechanica van het inplannen van taken voor uitvoering. Een taak moet verschillende fasen doorlopen voordat deze voor uitvoering kan worden ingepland:
Een aparte proces, de Scheduler, is verantwoordelijk voor de planning van alle taken in Airflow. Eigenlijk zorgt de Scheduler voor alle mechanica van het inplannen van taken. Een taak doorloopt verschillende stappen voordat deze wordt uitgevoerd:
- In de DAG zijn de vorige taken uitgevoerd, de nieuwe kan in de wachtrij worden geplaatst.
- De wachtrij wordt gesorteerd op basis van de prioriteit van taken (prioriteiten kunnen ook worden beheerd), en als er een vrije slot in de pool is, kan de taak in behandeling worden genomen.
- Als er een vrije celery worker is, wordt de taak naar hem gestuurd; het werk dat je in de taak hebt geprogrammeerd met behulp van een bepaalde operator begint.
Eigenlijk heel eenvoudig.
De Scheduler werkt op alle DAG's en al hun taken binnen de DAG's.
Om de Scheduler met een DAG te laten werken, moet de DAG een schema krijgen:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Er is een set vooraf gedefinieerde preset’s: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Je kunt ook cron-expressies gebruiken:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Uitvoeringsdatum
Om te begrijpen hoe Airflow werkt, is het belangrijk te begrijpen wat de uitvoeringsdatum voor een DAG is. In Airflow heeft een DAG een dimensie van uitvoeringsdatum, dat wil zeggen, op basis van het werkrooster van de DAG worden instanties van taken aangemaakt voor elke uitvoeringsdatum. En voor elke uitvoeringsdatum kunnen taken opnieuw worden uitgevoerd — of bijvoorbeeld kan de DAG tegelijkertijd op meerdere uitvoeringsdata werken. Dit wordt hier duidelijk weergegeven:
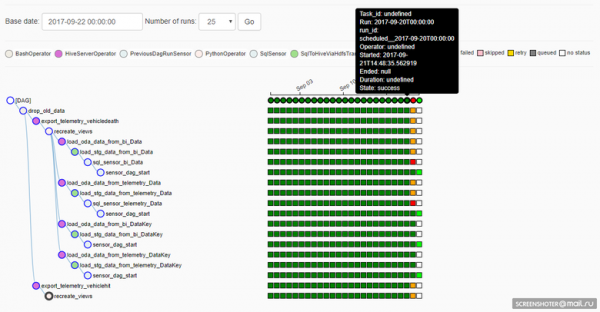
Helaas (of misschien gelukkig: afhankelijk van de situatie), als de implementatie van de taak in de DAG wordt gewijzigd, zal de uitvoering in de vorige uitvoeringsdata nu op basis van de correcties plaatsvinden. Dit is goed als je gegevens in vorige perioden opnieuw moet berekenen met een nieuw algoritme, maar slecht omdat de reproduceerbaarheid van het resultaat verloren gaat (natuurlijk kan niemand je tegenhouden om de benodigde versie van de broncode uit Git terug te halen en eenmalig te berekenen wat nodig is zoals nodig).
Taakgeneratie
De implementatie van de DAG is code in Python, dus we hebben een zeer handige manier om de hoeveelheid code te verkorten bij het werken met bijvoorbeeld gesplitste bronnen. Stel je hebt drie MySQL-shards als bron, dan moet je in elke shard gaan en gegevens ophalen. Dit gebeurt onafhankelijk en parallel. De Python-code in de DAG kan er als volgt uitzien:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
De DAG ziet er als volgt uit:
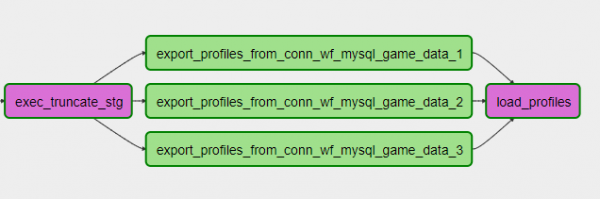
U kunt een shard toevoegen of verwijderen door eenvoudigweg de instellingen aan te passen en de DAG bij te werken. Handig!
U kunt ook complexere codegeneratie gebruiken, bijvoorbeeld door te werken met gegevensbronnen zoals databases of door de tabelstructuur en het algoritme voor de werking met de tabel te beschrijven, en met inachtneming van de kenmerken van de DWH-infrastructuur, een proces voor het laden van N tabellen in uw opslag te genereren. Of bijvoorbeeld bij het werken met een API die het gebruik van een parameter in de vorm van een lijst niet ondersteunt, kunt u op basis van deze lijst N taken in de DAG genereren, de gelijktijdigheid van API-verzoeken beperken tot een pool, en de benodigde gegevens uit de API halen. Flexibel!
Repository
Airflow heeft zijn eigen backend-repository, een database (dit kan MySQL of Postgres zijn, wij gebruiken Postgres), waarin de status van taken, DAG's, verbindingsinstellingen, globale parameters enz. worden opgeslagen. Hier moet ik zeggen dat de repository in Airflow heel eenvoudig is (ongeveer 20 tabellen) en handig als u een eigen proces bovenop wilt bouwen. Het doet me denken aan de 100500 tabellen in de Informatica-repository, die je eerst moest doorgronden voordat je begreep hoe je een query moest opstellen.
Monitoring
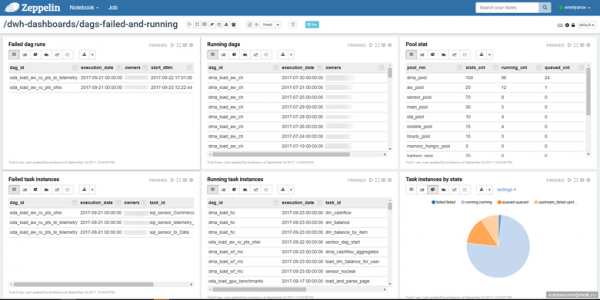
Gezien de eenvoud van de repository, kunt u zelf een handig proces voor het monitoren van taken opstellen. Wij gebruiken een notitieboek in Zeppelin, waar we de status van de taken bekijken:
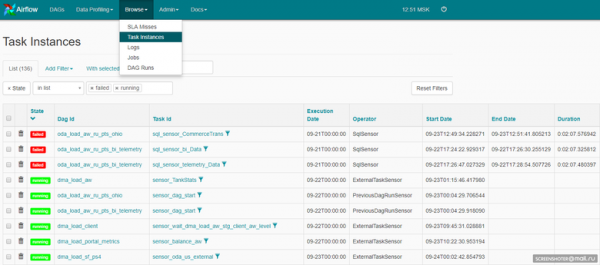
Dit kan ook de webinterface van Airflow zelf zijn:
De code van Airflow is open source, dus we hebben alerting via Telegram toegevoegd. Elke actieve instantie van een taak, als er een fout optreedt, spamt naar de groep in Telegram waar het hele ontwikkelings- en ondersteuningsteam zich bevindt.
We krijgen via Telegram snelle reacties (indien nodig), en via Zeppelin een algemeen overzicht van de taken in Airflow.
Total
Airflow is in de eerste plaats open source, en je moet niet verwachten dat het wonderen verricht. Wees voorbereid om tijd en moeite te investeren om een werkende oplossing op te zetten. Het doel is haalbaar, geloof me, het is het waard. De snelheid van ontwikkeling, de flexibiliteit, de eenvoud van het toevoegen van nieuwe processen – je zult het leuk vinden. Natuurlijk moet er veel aandacht worden besteed aan de organisatie van het project en de stabiliteit van Airflow zelf: wonderen bestaan niet.
Momenteel draait Airflow dagelijks ongeveer 6.500 taken. Ze zijn behoorlijk verschillend van aard. Er zijn taken voor het laden van gegevens in het hoofd-DWH vanuit veel verschillende en zeer specifieke bronnen, er zijn taken voor het berekenen van dataviews binnen het hoofd-DWH, er zijn taken voor de publicatie van gegevens in een snel DWH, er zijn veel verschillende taken — en Airflow verwerkt ze allemaal, dag na dag. Als we het in cijfers bekijken, dan betreft het 2,3 duizend ELT-taken van verschillende complexiteit binnen DWH (Hadoop), ongeveer 250 databases bronnen, dit is een team van vier ETL-ontwikkelaars, die zich bezighouden met ETL-data processing in DWH en met ELT-data processing binnen DWH en natuurlijk nog één admin, die verantwoordelijk is voor de infrastructuur van de service.
Toekomstplannen
Het aantal processen groeit onvermijdelijk, en het voornaamste waar we ons in termen van Airflow-infrastructuur mee bezig zullen houden, is schaalvergroting. We willen een Airflow-cluster opzetten, een paar nodes toewijzen voor Celery-workers en een zelfduplicerende hoofdnode creëren met taakplanning en een repository.
Epilog
Dit is natuurlijk lang niet alles wat ik over Airflow wilde vertellen, maar ik heb geprobeerd de belangrijkste punten te belichten. De eetlust komt terwijl je eet, probeer het — en je zult het leuk vinden 🙂
Bron: habr.com
