

Met de lancering van de cursus hebben we een vertaling gemaakt van nog een nuttig artikel.
Huffman-codering is een gegevenscompressie-algoritme dat het belangrijkste idee van bestandcompressie formuleert. In dit artikel zullen we het hebben over vaste en variabele lengtecodering, uniek decodere codes, prefixregels en het bouwen van de Huffman-boom.
We weten dat elk teken wordt opgeslagen als een reeks van 0 en 1 en 8 bits in beslag neemt. Dit wordt vaste lengtecodering genoemd, omdat elk teken dezelfde vaste hoeveelheid bits gebruikt voor opslag.
Stel dat we een tekst hebben. Hoe kunnen we de hoeveelheid ruimte die nodig is om één teken op te slaan, verkleinen?
Het belangrijkste idee is de codering van variabele lengte. We kunnen gebruikmaken van het feit dat sommige symbolen in de tekst vaker voorkomen dan andere (), om een algoritme te ontwikkelen dat dezelfde reeks symbolen voor minder bits zal vertegenwoordigen. Bij variabele lengtecodering wijzen we symbolen een variabel aantal bits toe, afhankelijk van de frequentie van hun voorkomen in de gegeven tekst. Uiteindelijk kunnen sommige symbolen slechts 1 bit in beslag nemen, terwijl andere 2 bits, 3 of meer in beslag kunnen nemen. Het probleem met variabele lengtecodering ligt echter in de latere decodering van de reeks.
Hoe decodeer je, wetende dat je een reeks bits hebt, deze eenduidig?
Laten we de string bekijken «aabacdab». Deze heeft 8 symbolen, en bij vaste lengtecodering zouden we 64 bits nodig hebben voor de opslag. Laten we opmerken dat de frequentie van de symbolen «a», «b», «c» en «d» is respectievelijk 4, 2, 1, 1. Laten we proberen deze te vertegenwoordigen met minder bits, gebruikmakend van het feit dat «aabacdab» «a» vaker voorkomt dan «b» , en . We beginnen met het coderen van, met behulp van 1 bit, gelijk aan 0, , en . We beginnen met het coderen van «b» «c» en «d»toewijzen we de code van 2 bits 11, en voor 3 bits coderen we vaker voorkomt dan 100 en 011 , en . We beginnen met het coderen van Als resultaat krijgen we: «c» en «d».
Dus coderen we de string
a
0
b
11
c
100
We verwijderen de huidige partitie om een nieuwe aan te maken voor in totaal 50 GB.
011
als «aabacdab» , gebruikmakend van de bovenstaande codes. De belangrijkste uitdaging ligt echter in de decodering. Wanneer we proberen de string 00110100011011 (0|0|11|0|100|011|0|11), te decoderen, krijgen we een ambigu resultaat, omdat het kan worden voorgesteld als: 001101000110110|011|0|100|011|0|11 adacdab 0|0|11|0|100|0|11|011 aabacabd 0|011|0|100|0|11|0|11 adacabab
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
enzovoorts.
Om deze ambiguïteit te vermijden, moeten we ervoor zorgen dat onze codering voldoet aan het concept van prefixregel, wat betekent dat codes op slechts één unieke manier kunnen worden gedecodeerd. De prefixregel garandeert dat geen enkele code een prefix is van een andere code. Met code bedoelen we de bits die worden gebruikt om een specifiek symbool weer te geven. In het bovenstaande voorbeeld 0 – is een prefix 011, wat de prefixregel schendt. Dus als onze codes voldoen aan de prefixregel, kan er eenduidig gedecodeerd worden (en vice versa).
Laten we het bovenstaande voorbeeld opnieuw bekijken. Dit keer zullen we codes toewijzen aan symbolen «a», «b», «c» en «d» , die voldoen aan de prefixregel.
a
0
b
10
c
110
We verwijderen de huidige partitie om een nieuwe aan te maken voor in totaal 50 GB.
111
Met een dergelijke codering zal de string «aabacdab» worden gecodeerd als 00100100011010 (0|0|10|0|100|011|0|10)Maar een 00100100011010 we kunnen al eenduidig decoderen en terugkeren naar onze oorspronkelijke string «aabacdab».
Huffman-codering
Nu we bekend zijn met variabele lengte codering en de prefixregel, laten we het hebben over Huffman-codering.
De methode is gebaseerd op het bouwen van binaire bomen. In deze bomen kan een knoop of een eindige of een interne zijn. Aanvankelijk worden alle knopen beschouwd als bladeren (eindig), die elk het symbool en zijn gewicht (frequentie van voorkomen) vertegenwoordigen. Interne knopen bevatten het gewicht van het symbool en verwijzen naar twee kindknopen. Over het algemeen geldt dat de bit "0" de linkse tak volgt, terwijl "1" de rechtertak volgt. In een volledige boom N bladeren en N-1 interne knopen. Het is aan te raden om onbenutte symbolen weg te laten bij het bouwen van de Huffman-boom voor het verkrijgen van codes van optimale lengte.
We zullen een prioriteitswachtrij gebruiken voor het bouwen van de Huffman-boom, waarbij de knoop met de laagste frequentie de hoogste prioriteit krijgt. Hieronder staan de stappen voor het bouwen:
- Maak een bladknoop voor elk symbool en voeg deze toe aan de prioriteitswachtrij.
- Zolang er meer dan één blad in de wachtrij is, doen we het volgende:
- Verwijder de twee knopen met de hoogste prioriteit (met de laagste frequentie) uit de wachtrij;
- Maak een nieuwe interne knoop, waarbij deze twee knopen kindknopen zijn en de frequentie van voorkomen gelijk is aan de som van de frequenties van deze twee knopen.
- Voeg de nieuwe knoop toe aan de prioriteitswachtrij.
- De enige overgebleven knoop zal de wortel zijn, en hiermee is de opbouw van de boom voltooid.
Stel je voor dat we een bepaalde tekst hebben die alleen uit de symbolen bestaat „a“, „b“, „c“, „d“ en «e», en dat hun frequenties respectievelijk 15, 7, 6, 6 en 5 zijn. Hieronder staan illustraties die de stappen van het algoritme weergeven.
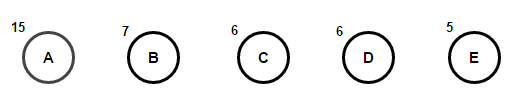
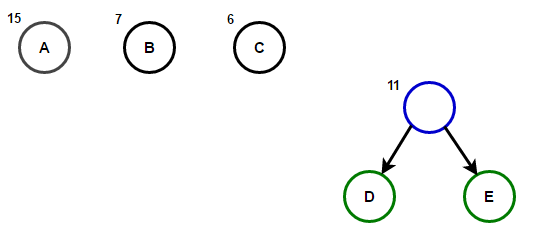
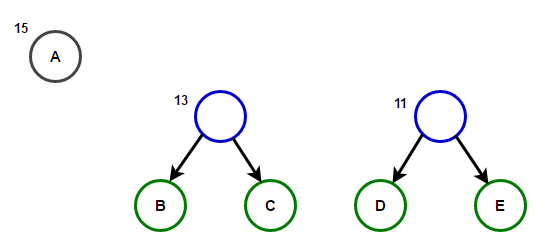
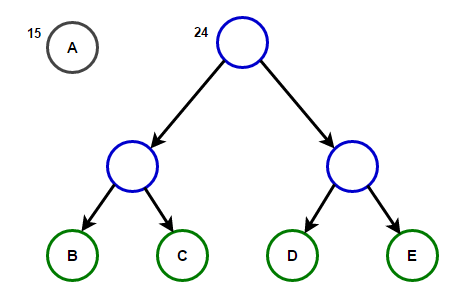
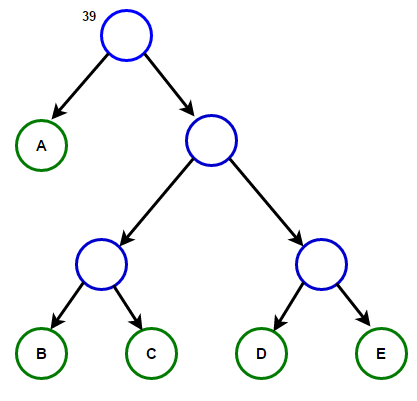
De weg van de wortel naar elke eindknoop zal de optimale prefixcode (ook bekend als de Huffman-code) bevatten, die overeenkomt met het symbool dat aan deze eindknoop is gekoppeld.
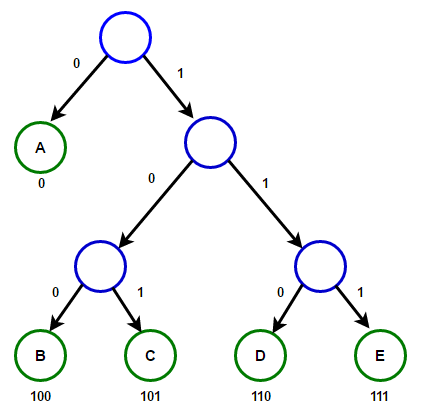
Huffman-boom
Hieronder vind je de implementatie van het Huffman-compressie-algoritme in de talen C++ en Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Een boomnode
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// door de Huffman-boom lopen en Huffman-codes opslaan
// in een map.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// leaf node gevonden
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// door de Huffman-boom lopen en de gecodeerde string decoderen
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// leaf node gevonden
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Bouwt de Huffman-boom en huffmanCode en decodeert de gegeven invoertekst
public static void buildHuffmanTree(String text)
{
// frequentie van verschijning van elk teken tellen
// en opslaan in een map
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Een prioriteitswachtrij maken om de actieve knooppunten van de Huffman-boom op te slaan
// Let op dat het hoogste prioriteitsitem de laagste frequentie heeft
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Maak een leaf node voor elk teken en voeg het toe
// aan de prioriteitswachtrij.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// blijf doorgaan totdat er meer dan één knoop in de wachtrij is
while (pq.size() != 1)
{
// Verwijder de twee knopen met de hoogste prioriteit
// (laagste frequentie) uit de wachtrij
Node left = pq.poll();
Node right = pq.poll();
// Maak een nieuwe interne knoop met deze twee knopen als kinderen
// en met een frequentie gelijk aan de som van de frequenties van de twee knopen.
// Voeg de nieuwe knoop toe aan de prioriteitswachtrij.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root slaat de pointer naar de root van de Huffman-boom op
Node root = pq.peek();
// loop door de Huffman-boom en sla de Huffman-codes op in een map
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// print de Huffman-codes
System.out.println("Huffman Codes zijn :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nDe originele string was :\n" + text);
// print de gecodeerde string
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nDe gecodeerde string is :\n" + sb);
// loop opnieuw door de Huffman-boom en deze keer
// decodeer de gecodeerde string
int index = -1;
System.out.println("\nDe gedecodeerde string is: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffman codering is een gegevenscompressie-algoritme.";
buildHuffmanTree(text);
}
}Opmerking: Het geheugen dat door de invoerstring wordt gebruikt, is 47 * 8 = 376 bits, terwijl de gecodeerde string slechts 194 bits kost, oftewel de gegevens worden met ongeveer 48% samengedrukt. In het C++-programma hierboven gebruiken we de klasse string om de gecodeerde string op te slaan, zodat het programma leesbaar is.
Aangezien effectieve datastructuren voor prioriteitsqueues vereisen dat de invoeging O(log(N)) tijd kost, en er in een volledig binaire boom N met bladeren 2N-1 knopen aanwezig zijn, en de Huffman-boom een volledige binaire boom is, werkt het algoritme in O(Nlog(N)) tijd, waarbij N – het aantal symbolen is.
Bronnen:
Bron: habr.com
