

Normaal gesproken worden commerciële producten of kant-en-klare open-source alternatieven zoals Prometheus + Grafana gebruikt voor de monitoring en analyse van Nginx. Dit is een goede optie voor monitoring of realtime-analyse, maar niet erg handig voor historische analyse. Bij elke populaire bron groeit het volume gegevens uit de Nginx-logboeken snel, en voor de analyse van grote hoeveelheden gegevens is het logisch om iets meer gespecialiseerd te gebruiken.
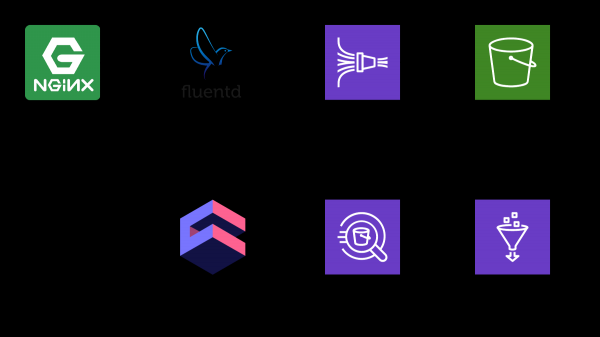
In dit artikel zal ik uitleggen hoe je kunnen gebruiken voor het analyseren van logboeken, met Nginx als voorbeeld, en ik zal laten zien hoe je uit deze gegevens een analytisch dashboard kunt samenstellen met het open-source framework cube.js. Hier is de volledige architectuur van de oplossing:
TL:DR;
.
Voor het verzamelen van informatie gebruiken we , voor de verwerking — en , voor de opslag — . Met deze combinatie kunnen we niet alleen de Nginx-logboeken opslaan, maar ook andere evenementen en de logboeken van andere services. Je kunt sommige onderdelen vervangen door vergelijkbare voor jouw stack, bijvoorbeeld, je kunt logboeken direct uit Nginx naar Kinesis schrijven, waarbij je Fluentd overslaat, of Logstash hiervoor gebruiken.
Logboeken van Nginx verzamelen
Standaard zien de Nginx-logboeken er ongeveer zo uit:
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, zoals Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, zoals Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
Je kunt ze ontleden, maar het is veel eenvoudiger om de configuratie van Nginx aan te passen zodat het logboeken in JSON-indeling levert:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 voor opslag
Om logboeken op te slaan, zullen we S3 gebruiken. Dit stelt ons in staat om logboeken op één plek op te slaan en te analyseren, aangezien Athena direct met gegevens in S3 kan werken. Verderop in het artikel zal ik uitleggen hoe je logboeken op de juiste manier opslaat en verwerkt, maar eerst hebben we een schone bucket in S3 nodig waar verder niets anders wordt opgeslagen. Het is raadzaam om van tevoren na te denken over welke regio je de bucket gaat aanmaken, omdat Athena niet in alle regio's beschikbaar is.
We maken een schema in de Athena-console
We creëren een tabel in Athena voor logs. Deze is nodig voor zowel schrijven als lezen, als je Kinesis Firehose wilt gebruiken. Open de Athena-console en maak een tabel aan:
SQL voor het maken van een tabel
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
We maken een Kinesis Firehose-stream
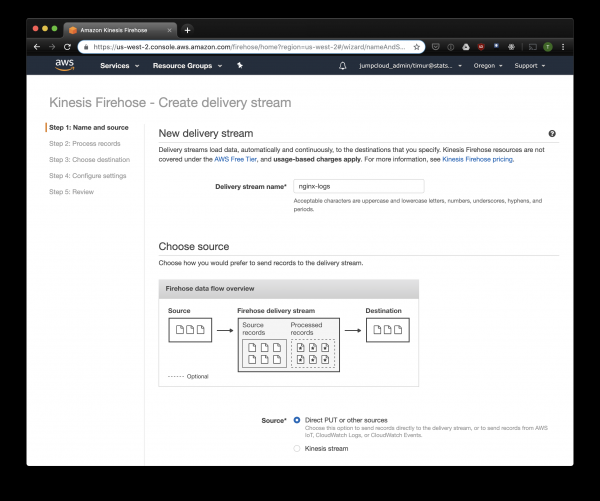
Kinesis Firehose zal de gegevens van Nginx opslaan in S3 in het gekozen formaat, verdeeld over directories in het formaat JJJJ/MM/DD/UU. Dit is handig bij het lezen van de gegevens. Natuurlijk kun je ook rechtstreeks naar S3 schrijven vanuit fluentd, maar dan moet je JSON schrijven en dat is niet efficiënt vanwege de grote bestandsgrootte. Bovendien is JSON, bij het gebruik van PrestoDB of Athena, het traagste gegevensformaat. Dus we openen de Kinesis Firehose-console, klikken op 'Create delivery stream', en kiezen 'direct PUT' in het veld 'delivery':
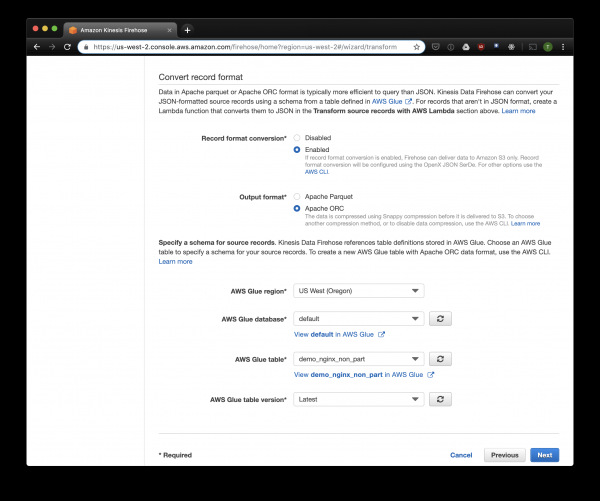
In het volgende tabblad kiezen we 'Record format conversion' — 'Enabled' en kiezen we 'Apache ORC' als formaat voor de verzending. Volgens onderzoeken van sommige , is dit het optimale formaat voor PrestoDB en Athena. Geef de tabel op die we hierboven hebben gemaakt als schema. Houd er rekening mee dat de S3-locatie in Kinesis elke locatie kan zijn, alleen het schema van de tabel wordt gebruikt. Maar als je een andere S3-locatie opgeeft, kun je die records uit deze tabel niet lezen.
Kies S3 voor opslag en de bucket die we eerder hebben gemaakt. AWS Glue Crawler, waar ik later over zal vertellen, kan niet werken met prefixen in een S3-bucket, dus het is belangrijk deze leeg te laten.
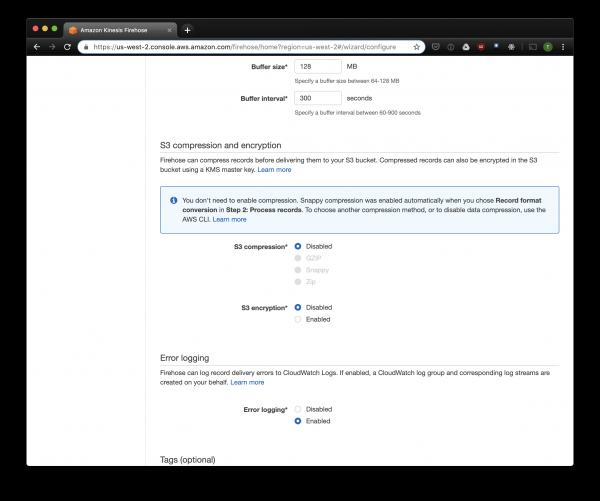
De overige opties kunnen worden gewijzigd afhankelijk van jouw belasting, ik gebruik meestal de standaardinstellingen. Houd er rekening mee dat compressie in S3 niet beschikbaar is, maar ORC gebruikt standaard zijn eigen compressie.
Fluentd
Nu we de opslag en het ophalen van logs hebben ingesteld, moeten we de verzending configureren. We gaan gebruiken , omdat ik van Ruby hou, maar je kunt ook Logstash gebruiken of logs direct naar Kinesis sturen. De Fluentd-server kan op verschillende manieren worden gestart, ik zal het over Docker hebben, omdat dit eenvoudig en handig is.
Eerst hebben we een configuratiebestand fluent.conf nodig. Maak dit aan en voeg de source toe:
forward
port 24224
bind 0.0.0.0
Nu kun je de Fluentd-server starten. Als je een meer geavanceerde configuratie nodig hebt, dan is er een gedetailleerde gids beschikbaar, inclusief hoe je je eigen afbeelding kunt samenstellen.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Deze configuratie gebruikt het pad /fluentd/log voor het cachen van logs voordat ze worden verzonden. Dit kan zonder, maar dan kun je bij het opnieuw opstarten alle waardevolle gecachete gegevens kwijt raken. De poort kan ook elke poort zijn, 24224 is de standaardpoort voor Fluentd.
Nu we Fluentd hebben draaiende, kunnen we logs naar daar verzenden vanuit Nginx. We draaien Nginx meestal in een Docker-container, en in dat geval heeft Docker een native logdriver voor Fluentd:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Als je Nginx op een andere manier draait, kun je logbestanden gebruiken, in Fluentd is er .
Laten we het Fluentd-configuratiebestand aanvullen met de eerder ingestelde logparser:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
En verzend de logs naar Kinesis, met behulp van :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Als je alles goed hebt ingesteld, zou je na enige tijd (standaard schrijft Kinesis ontvangen gegevens elke 10 minuten) de logbestanden in S3 moeten zien. In het menu 'monitoring' van Kinesis Firehose kun je zien hoeveel gegevens in S3 zijn geschreven, evenals fouten. Vergeet niet om schrijfrechten te geven aan de S3-bucket voor de Kinesis-rol. Als Kinesis iets niet kon parseren, worden de fouten in dezelfde bucket opgeslagen.
Nu kunnen we de gegevens in Athena bekijken. Laten we de recente aanvragen vinden waarop we fouten hebben gegeven:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Het scannen van alle records voor elke aanvraag
Nu zijn onze logs verwerkt en opgeslagen in S3 in ORC, gecomprimeerd en klaar voor analyse. Kinesis Firehose heeft ze zelfs per uur in mappen opgeslagen. Echter, zolang de tabel niet is gepartitioneerd, zal Athena bij elke aanvraag gegevens over een langere periode laden, met uitzonderingen. Dit is een groot probleem om twee redenen:
- De hoeveelheid gegevens groeit constant, wat de aanvragen vertraagt;
- De kosten voor Athena worden berekend op basis van de hoeveelheid gescande gegevens, met een minimum van 10 MB per aanvraag.
Om dit te corrigeren, gebruiken we de AWS Glue Crawler, die de gegevens in S3 scant en informatie over de partities in de Glue Metastore vastlegt. Dit stelt ons in staat om partities als filter te gebruiken bij verzoeken in Athena, en het zal alleen de directories scannen die in de aanvraag zijn opgegeven.
Amazon Glue Crawler instellen
De Amazon Glue Crawler scant alle gegevens in de S3-bucket en maakt tabellen met partities. Maak een Glue Crawler vanuit de AWS Glue-console en voeg de bucket toe waarin je gegevens opslaat. Je kunt één crawler voor meerdere buckets gebruiken; in dat geval maakt deze tabellen aan in de opgegeven database met namen die overeenkomen met de namen van de buckets. Als je van plan bent deze gegevens voortdurend te gebruiken, vergeet dan niet om een schema voor het draaien van de Crawler in te stellen dat aan jouw behoeften voldoet. We gebruiken één Crawler voor alle tabellen, die elk uur draait.
Gepartitioneerde tabellen
Na de eerste uitvoering van de crawler moeten er tabellen verschijnen in de database die zijn opgegeven in de instellingen, voor elke gescande bucket. Open de Athena-console en zoek naar de tabel met Nginx-logs. Laten we eens proberen iets te lezen:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Deze query selecteert alle records die van 6 tot 7 uur 's ochtends op 8 april 2019 zijn ontvangen. Maar hoe veel effectiever is dit vergeleken met gewoon lezen uit een niet-gepartitioneerde tabel? Laten we het erachter komen en dezelfde records selecteren, gefilterd op timestamp:
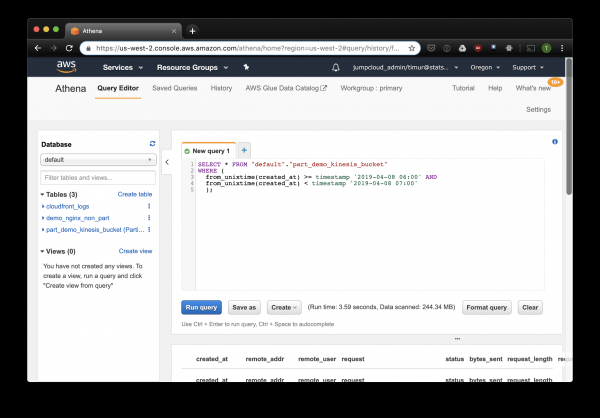
3.59 seconden en 244.34 megabyte aan gegevens op een dataset die uit een week aan logs bestaat. Laten we het filter op partities proberen:
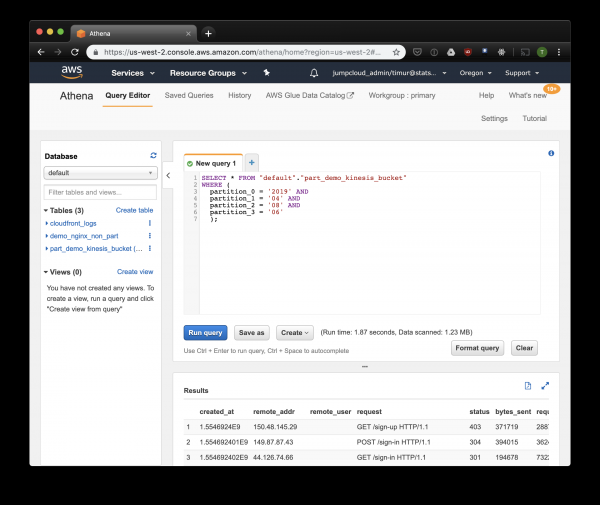
Iets sneller, maar het belangrijkste is — slechts 1.23 megabyte aan gegevens! Dit zou veel goedkoper zijn geweest als het niet voor de minimale 10 megabyte per query in de prijsstelling was. Maar het is nog steeds veel beter, en bij grote datasets zal het verschil veel indrukwekkender zijn.
Собираем дэшборд с помощью Cube.js
Om een dashboard samen te stellen, gebruiken we het analytische framework Cube.js. Het heeft behoorlijk wat functies, maar wij zijn geïnteresseerd in twee: de mogelijkheid om automatisch partitie-filters te gebruiken en het pre-aggregeren van gegevens. Het gebruikt een datamodel , geschreven in Javascript, om SQL te genereren en de query naar de database uit te voeren. Van ons wordt alleen gevraagd om aan te geven hoe we het partitie-filter in het datamodel gebruiken.
Laten we een nieuwe Cube.js-app maken. Aangezien we al de AWS-stack gebruiken, is het logisch om Lambda te gebruiken voor de implementatie. Je kunt de express-sjabloon gebruiken voor generatie als je van plan bent om de Cube.js-backend te hosten in Heroku of Docker. De documentatie beschrijft andere .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
Voor het instellen van toegang tot de database in cube.js worden omgevingsvariabelen gebruikt. De generator maakt een .env-bestand aan waarin je je sleutels kunt opgeven voor .
Nu hebben we nodig , waarin we zullen aangeven hoe onze logs worden opgeslagen. Hier kan ook worden opgegeven hoe de metrics voor dashboards moeten worden berekend.
In de directory schema, maak een bestand aan Logs.js. Hier is een voorbeeld van een datamodel voor nginx:
Modelcode
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Ja`
        }],
        else: { label: `Nee` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Hier gebruiken we de variabele , om de SQL-query te genereren met een filter op partities.
We stellen ook de metrics en parameters in die we op het dashboard willen weergeven, en geven pre-aggregaties op. Cube.js zal extra tabellen creëren met pre-geaggregeerde gegevens en zal de gegevens automatisch bijwerken naarmate ze binnenkomen. Dit versnelt niet alleen de queries, maar verlaagt ook de kosten van het gebruik van Athena.
Laten we deze informatie toevoegen aan het datamodelbestand:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `dag`,
    partitionGranularity: `maand`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
We geven in dit model aan dat we de gegevens voor alle gebruikte metrics moeten pre-aggregateren en partitie per maand moeten gebruiken. kan de verzameling en actualisatie van gegevens aanzienlijk versnellen.
Nu kunnen we een dashboard opbouwen!
De backend van Cube.js biedt en een set klantenbibliotheken voor populaire frontend-frameworks. We zullen de React-versie van de client gebruiken om het dashboard op te bouwen. Cube.js levert alleen gegevens, dus we hebben een bibliotheek voor visualisaties nodig - ik hou van , maar je kunt elke andere gebruiken.
De Cube.js-server accepteert aanvragen in , waarin de benodigde metrics zijn opgegeven. Bijvoorbeeld, om te berekenen hoeveel fouten Nginx per dag heeft geretourneerd, moet je de volgende aanvraag indienen:
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Laten we de Cube.js-client en de React-componentbibliotheek installeren via NPM:
$ npm i --save @cubejs-client/core @cubejs-client/reactImporteer de componenten cubejs en QueryRenderer, om gegevens te laden, en we bouwen het dashboard:
De code van het dashboard
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Loading...';
        }

        return (


        );
      }}
    />
  )
}
De bronnen van het dashboard zijn beschikbaar op .
Bron: habr.com
