

Als u virtuele infrastructuur beheert op basis van VMware vSphere (of een andere technologie-stack), hoort u waarschijnlijk vaak klachten van gebruikers: "De virtuele machine werkt traag!". In deze reeks artikelen behandel ik prestatiemetrieken en leg ik uit wat en waarom er "vertraging" optreedt en hoe u kunt zorgen dat het niet "traag" is.
Ik zal de volgende aspecten van de prestaties van virtuele machines bekijken:
- CPU,
- RAM,
- SCHIJF,
- Netwerk.
Ik begin met de CPU.
Voor de prestatieanalyse hebben we nodig:
- vCenter Prestatiestatistieken – prestatiestatistieken waarvan de grafieken kunnen worden bekeken via de vSphere Client. Informatie over deze statistieken is beschikbaar in elke versie van de client (de "thick" client op C#, de webclient op Flex en de webclient op HTML5). In deze artikelen zullen we screenshots gebruiken van de C#-client, simpelweg omdat ze beter zichtbaar zijn in miniatuurweergave:)
- ESXTOP – een hulpprogramma dat vanuit de opdrachtregel van ESXi kan worden gestart. Hiermee kunt u prestatiestatistieken in realtime ophalen of deze waarden voor een bepaalde periode exporteren naar een .csv-bestand voor verdere analyse. Later zal ik dit hulpmiddel uitgebreider bespreken en enkele nuttige links naar documentatie en artikelen over dit onderwerp geven.
Een beetje theorie
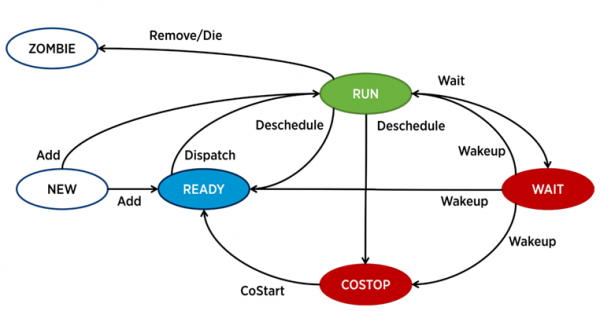
In ESXi is elk vCPU (kern van de virtuele machine) verantwoordelijk voor een aparte proces – world in de terminologie van VMware. Er zijn ook systeemprocessen, maar vanuit het oogpunt van prestatieanalyse van VM's zijn zij minder interessant.
Een proces in ESXi kan zich in een van de vier statussen bevinden:
- Run – het proces voert nuttig werk uit.
- Wait – het proces voert geen werk uit (idle) of wacht op invoer/uitvoer.
- Costop – een toestand die optreedt in multikern virtuele machines. Het ontstaat wanneer de CPU-scheduler van de hypervisor (ESXi CPU Scheduler) niet in staat is om gelijktijdige uitvoering op de fysieke kernen van de server voor alle actieve kernen van de virtuele machine te plannen. In de fysieke wereld werken alle processorkernen parallel; het gast-OS binnen de VM rekent op vergelijkbaar gedrag, waardoor de hypervisor de kernen van de VM moet vertragen die de cyclus sneller kunnen voltooien. In de moderne versies van ESXi gebruikt de CPU-scheduler een mechanisme dat relaxed co-scheduling wordt genoemd: de hypervisor houdt rekening met het verschil tussen de 'snelste' en de 'langzaamste' kern van de virtuele machine (skew). Als het verschil een bepaalde drempel overschrijdt, schakelt de 'snelle' kern over naar de toestand costop. Als de kernen van de VM veel tijd in deze toestand doorbrengen, kan dit prestatieproblemen veroorzaken.
- Klaar – het proces komt in deze staat wanneer de hypervisor niet in staat is om middelen toe te wijzen voor de uitvoering ervan. Hoge waarden voor ready kunnen prestatieproblemen voor de VM veroorzaken.
Belangrijkste prestatiestatistieken van de CPU van de virtuele machine
CPU-gebruik, %. Geeft het percentage CPU-gebruik aan gedurende een bepaalde periode.
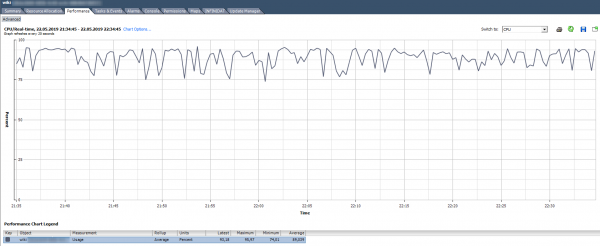
Hoe te analyseren? Als de VM constant 90% van de CPU gebruikt of pieken tot 100% vertoont, hebben we problemen. Problemen kunnen zich niet alleen uiten in 'langzame' prestaties van de applicatie binnen de VM, maar ook in de onbereikbaarheid van de VM via het netwerk. Als het bewakingsysteem aangeeft dat de VM af en toe uitvalt, let dan op de pieken op de grafiek van het CPU-gebruik.
Er is een standaardalarm dat de CPU-belasting van de virtuele machine toont:
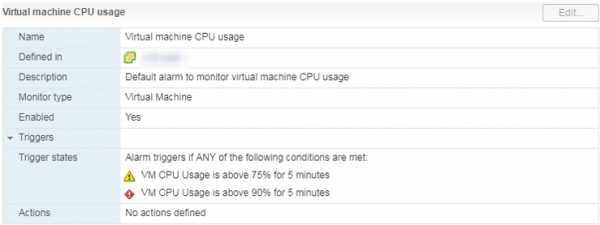
Wat te doen? Als de CPU-gebruik van de VM constant hoog is, kan het een idee zijn om het aantal vCPU's te verhogen (helaas helpt dit niet altijd) of de VM naar een server met krachtigere processors te verplaatsen.
CPU-gebruik in MHz
In de grafieken op vCenter kan het gebruik in % alleen voor de hele virtuele machine worden bekeken; er zijn geen grafieken voor afzonderlijke kernen (in Esxtop zijn de waarden in % per kern beschikbaar). Voor elke kern kan het gebruik in MHz worden bekeken.
Hoe te analyseren? Het kan voorkomen dat een applicatie niet is geoptimaliseerd voor multi-core architectuur: het gebruikt slechts één kern voor 100%, terwijl de andere inactief blijven. Bijvoorbeeld, bij de standaardinstellingen van een MS SQL-backup draait het proces alleen op één kern. Hierdoor vertraagt de back-up niet door langzame schijfsnelheden (waarover de gebruiker oorspronkelijk klaagde), maar omdat de processor het niet aankan. Het probleem werd opgelost door parameters te wijzigen: de back-up begon gelijktijdig in meerdere bestanden te draaien (d.w.z. in meerdere processen).
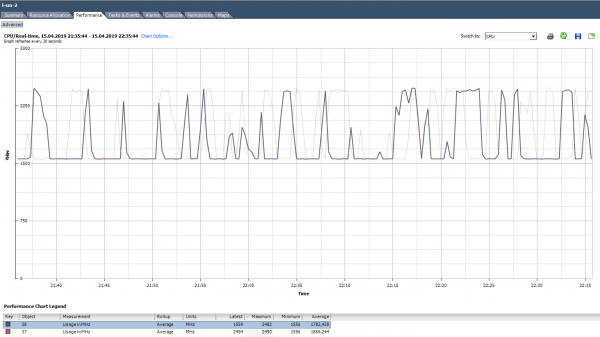
Voorbeeld van ongelijke belasting van kernen.
Het komt ook voor dat (zoals in de bovenstaande grafiek) de kernen ongelijkmatig belast zijn en sommige kernen pieken tot 100% laten zien. Net als bij de belasting van slechts één kern, zal de alarmmelding voor CPU-gebruik niet afgaan (het is over de hele VM), maar er zullen prestatieproblemen zijn.
Wat te doen? Als software in de virtuele machine de kernen ongelijkmatig belast (slechts één kern of een deel van de kernen gebruikt), heeft het geen zin om het aantal kernen te verhogen. In dat geval is het beter om de VM naar een server met krachtigere processors te verplaatsen.
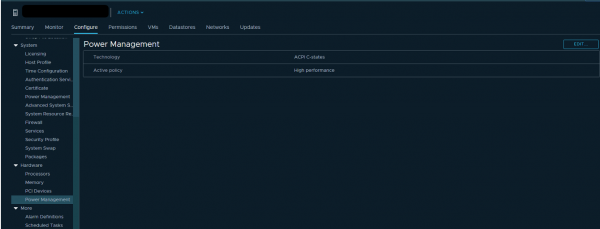
Het kan ook nuttig zijn om de energie-instellingen in de BIOS van de server te controleren. Veel beheerders schakelen de High Performance-modus in BIOS in en schakelen zo de energiebesparende technologieën C-states en P-states uit. In moderne Intel-processors wordt de Turbo Boost-technologie gebruikt, die de frequentie van afzonderlijke kernen verhoogt ten koste van andere kernen. Maar deze werkt alleen als de energiebesparende technologieën ingeschakeld zijn. Als we ze uitschakelen, kan de processor het energieverbruik van de ongebruikte kernen niet verminderen.
VMware adviseert om energiebesparende technologieën op servers niet uit te schakelen, maar om modi te kiezen die de controle over energiebesparing maximaal aan de hypervisor geven. Daarnaast moet bij de energie-instellingen van de hypervisor de High Performance-modus worden gekozen.
Als binnen uw infrastructuur afzonderlijke VM's (of kernen van VM's) een hogere CPU-frequentie vereisen, kan een correcte instelling van het energieverbruik hun prestaties aanzienlijk verbeteren.
CPU Ready (Readiness)
Als de VM-kern (vCPU) in de status Ready is, voert deze geen nuttig werk uit. Deze status ontstaat wanneer de hypervisor geen vrij fysiek kern kan vinden om de vCPUp voor de virtuele machine toe te wijzen.
Hoe te analyseren? Over het algemeen, als de kernen van de virtuele machine meer dan 10% van de tijd in de status Ready zijn, zult u prestatieproblemen opmerken. Simpel gezegd, meer dan 10% van de tijd wacht de VM op de beschikbaarheid van fysieke bronnen.
In vCenter kunnen twee tellers met betrekking tot CPU Ready worden bekeken:
- Readiness,
- Ready.
De waarden van beide tellers kunnen zowel voor de gehele VM als voor afzonderlijke kernen worden bekeken.
Readiness toont de waarde direct in percentages, maar alleen in Real-time (gegevens van het laatste uur, meetinterval van 20 seconden). Deze teller kan het beste alleen worden gebruikt voor het opsporen van problemen 'ter plaatse'.
De waarden van de Ready-teller kunnen ook historisch worden bekeken. Dit is nuttig voor het vaststellen van patronen en voor een diepgaande analyse van het probleem. Bijvoorbeeld, als een virtuele machine op een bepaald tijdstip prestatieproblemen begint te vertonen, kan men de intervallen met verhoogde CPU Ready-waarden vergelijken met de totale serverbelasting waarop de VM draait en maatregelen nemen om de belasting te verlagen (als DRS niet heeft geholpen).
Ready, in tegenstelling tot Readiness, wordt niet in percenten, maar in milliseconden weergegeven. Dit is een Summation-teller, wat betekent dat het aangeeft hoe lang de kern van de VM gedurende de meetperiode in de status Ready is geweest. Deze waarde kan met een eenvoudige formule naar procenten worden omgezet:
(CPU ready summation value / (standaard update-interval van de grafiek in seconden * 1000)) * 100 = CPU ready %
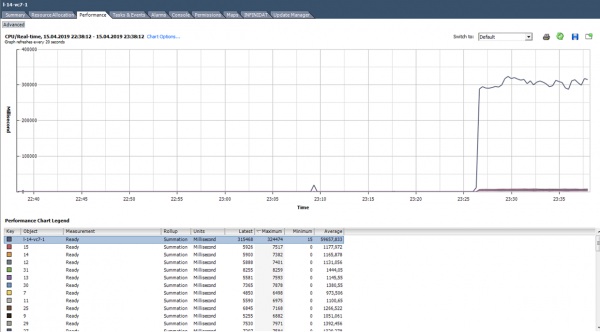
Bijvoorbeeld, voor de VM in de onderstaande grafiek zal de piekwaarde van Ready voor de gehele virtuele machine als volgt zijn:

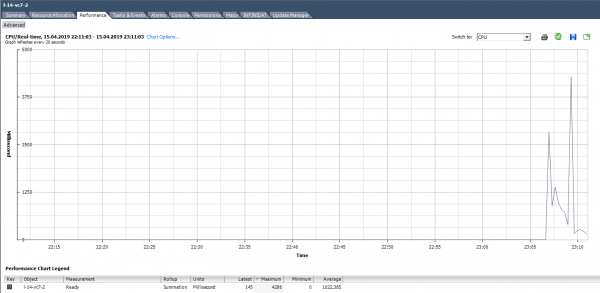
Bij het berekenen van de Ready-waarde in procenten moet men op twee punten letten:
- De Ready-waarde voor de gehele VM is de som van de Ready-waarde per kern.
- Het meetinterval. Voor Real-time is dit 20 seconden, en bijvoorbeeld op dagelijkse grafieken is dit 300 seconden.
Bij actieve probleemoplossing kunnen deze eenvoudige punten gemakkelijk worden gemist, waardoor kostbare tijd verloren gaat met het oplossen van niet-bestaande problemen.
We calculate Ready based on the data from the chart below. (324474/(20*1000))*100 = 1622% for the entire VM. Looking at the cores, it doesn’t seem so alarming: 1622/64 = 25% per core. In this case, detecting the trick is quite simple: the Ready value is unrealistic. But if we’re talking about 10–20% for the entire VM with multiple cores, then for each core the value might be within normal limits.
Wat te doen? A high Ready value indicates that the server lacks CPU resources for the normal operation of virtual machines. In such a situation, the only solution is to reduce the CPU overcommitment (vCPU:pCPU). Clearly, this can be achieved by decreasing the parameters of existing VMs or by migrating some VMs to other servers.
Co-stop
Hoe te analyseren? This counter also has a Summation type and is converted to percentages similarly to Ready:
(CPU co-stop summation value / (chart default update interval in seconds * 1000)) * 100 = CPU co-stop %
One should also pay attention to the number of cores on the VM and the measurement interval.
In a co-stop state, a core does not perform useful work. With the proper selection of VM size and normal server load, the co-stop counter should be close to zero.
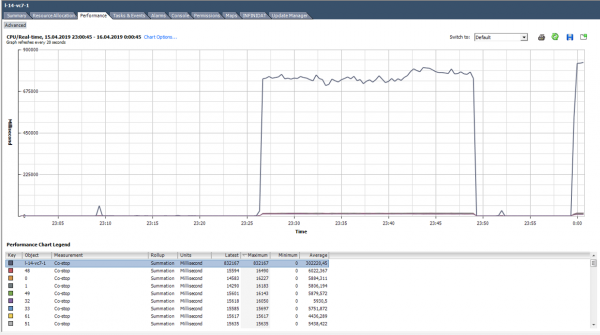
In this case, the load is clearly abnormal :)
Wat te doen? If multiple VMs with a large number of cores are running on one hypervisor and there is CPU overcommitment, the co-stop counter may increase, leading to performance issues for those VMs.
Co-stop will also increase if the active cores of one VM are using threads on the same physical core of the server with hyper-threading enabled. This situation may arise, for example, if the VM has more cores than physically available on the server it runs on, or if the VM has the 'preferHT' setting enabled. You can read about this setting. .
To avoid performance issues for the VM due to high co-stop, select the size of the VM according to the recommendations of the software manufacturer that runs on this VM and the capabilities of the physical server where the VM operates.
Do not add cores just in case; this may cause performance issues not only for the VM itself but also for its neighbors on the server.
Other useful CPU metrics
Run – how much time (ms) during the measurement period the vCPU was in the RUN state, that is, actually performing useful work.
Idle – hoeveel tijd (ms) vCPU in de meetperiode in een staat van inactiviteit was. Hoge waarden voor Idle zijn geen probleem, het is simpelweg dat de vCPU 'niets te doen had'.
Wait – hoeveel tijd (ms) vCPU in de meetperiode in een staat van wachten was. Omdat in deze teller IDLE is opgenomen, zeggen hoge waarden voor Wait ook niets over een probleem. Als echter bij hoge Wait de IDLE laag is, betekent dit dat de VM wachtte op de voltooiing van invoer-/uitvoeroperaties, wat kan wijzen op problemen met de schijfprestaties of andere virtuele apparaten van de VM.
Max gelimiteerd – hoeveel tijd (ms) vCPU in de meetperiode in een staat van gereedheid was vanwege een ingestelde resource-limiet. Als de prestaties onverklaarbaar laag zijn, is het nuttig om deze teller en de CPU-limiet in de VM-instellingen te controleren. De VM kan inderdaad limieten hebben die je niet kent. Dit gebeurt bijvoorbeeld wanneer de VM is gekloond van een sjabloon waarop een CPU-limiet was ingesteld.
Swap wacht – hoeveel tijd de vCPU in de meetperiode wachtte op een operatie met VMkernel Swap. Als de waarden van deze teller boven nul zijn, heeft de VM duidelijk prestatieproblemen. Meer over SWAP bespreken we in het artikel over geheugentellers.
ESXTOP
Als de prestatiecijfers in vCenter goed zijn voor het analyseren van historische gegevens, dan is het beter om een actuele probleemanalyse in ESXTOP uit te voeren. Hier zijn alle waarden direct beschikbaar (je hoeft niets te vertalen) en de minimale meetperiode is 2 seconden.
Het ESXTOP-scherm voor CPU wordt geopend met de toets 'c' en ziet er als volgt uit:

Voor de eenvoud kun je alleen de processen van virtuele machines behouden door Shift-V in te drukken.
Om de metriek voor individuele cores van de VM te bekijken, druk je op 'e' en voer je het GID van de betreffende VM in (30919 op de onderstaande screenshot):
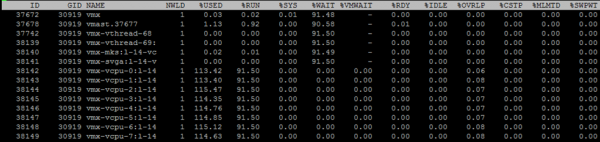
Ik loop kort door de kolommen die standaard worden weergegeven. Extra kolommen kunnen worden toegevoegd door 'f' in te drukken.
NWLD (Aantal Werelden) – het aantal processen in de groep. Om de groep uit te vouwen en de metriek voor elk proces te zien (bijvoorbeeld voor elke kern van een multi-core VM), druk je op “e”. Als er meer dan één proces in de groep is, zijn de metriekwaarden voor de groep gelijk aan de som van de metriekwaarden voor de afzonderlijke processen.
%GEGEVEN – hoeveel CPU-cycli de server gebruikt door een proces of groep processen.
%LOOP – hoeveel tijd de proces tijdens de meetperiode in de RUN-toestand was, d.w.z. nuttig werk verrichtte. Verschilt van %USED omdat hyper-threading, frequentieschaling en de tijd besteed aan systeemtaken (%SYS) niet worden meegerekend.
%SYS – tijd besteed aan systeemtaken, bijvoorbeeld: verwerking van onderbrekingen, input/output, netwerkactiviteiten, enz. De waarde kan hoog zijn als de VM veel invoer/uitvoer heeft.
%OVRLP – hoeveel tijd de fysieke core waarop de VM-proces draait, heeft besteed aan taken van andere processen.
Deze metrics hebben de volgende relatie:
%USED = %RUN + %SYS — %OVRLP.
Gewoonlijk is de %USED-metric informatiever.
%WAIT – hoeveel tijd het proces tijdens de meetperiode in de Wait-toestand was. Inclusief IDLE.
%IDLE – hoeveel tijd het proces tijdens de meetperiode in de IDLE-toestand was.
%SWPWT – hoeveel tijd het vCPU tijdens de meetperiode wachtte op een operatie met VMkernel Swap.
%VMWAIT – hoeveel tijd het vCPU tijdens de meetperiode in een wachttoestand was voor een gebeurtenis (meestal input/output). Er is geen vergelijkbare teller in vCenter. Hoge waarden duiden op problemen met invoer/uitvoer op de VM.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Als de VM geen VMkernel Swap gebruikt, is het verstandig om bij het analyseren van prestatieproblemen naar %VMWAIT te kijken, aangezien deze metric de tijd wanneer de VM niets deed (%IDLE) niet meerekent.
%RDY – hoeveel tijd het proces tijdens de meetperiode in de Ready-toestand was.
%CSTP – hoeveel tijd het proces tijdens de meetperiode in de costop-toestand was.
%MLMTD – hoeveel tijd het vCPU tijdens de meetperiode in de Ready-toestand was vanwege een opgelegd hulpbronlimiet.
%WAIT + %RDY + %CSTP + %RUN = 100% – de core van de VM bevindt zich altijd in een van deze vier toestanden.
CPU op de hypervisor
In vCenter zijn er ook CPU-prestatietellers voor de hypervisor, maar deze zijn niet interessant – het is gewoon de som van de tellers van alle VM's op de server.
Het is het gemakkelijkst om de CPU-status op de server te bekijken op het tabblad Samenvatting:
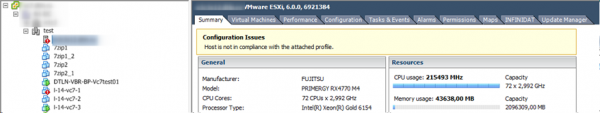
Voor de server, net als voor de virtuele machine, zijn er standaard Alarmen:
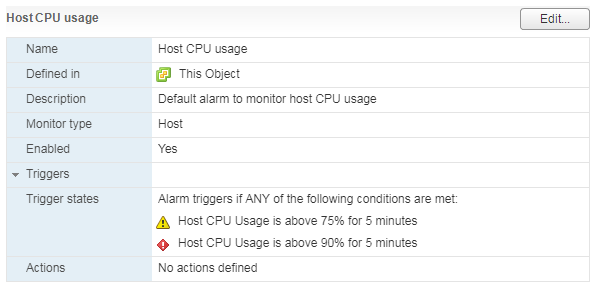
Bij hoge belasting van de CPU van de server beginnen de VM's die erop draaien prestatieproblemen te vertonen.
In ESXTOP, the CPU load data of the server is displayed at the top of the screen. In addition to the standard CPU load, which is not very informative for hypervisors, there are three more metrics:
CORE UTIL(%) – load of the physical server core. This counter shows how much time the core was working during the measurement period.
PCPU UTIL(%) – if hyper-threading is enabled, each physical core has two threads (PCPU). This metric shows how much time each thread was working.
PCPU USED(%) – the same as PCPU UTIL(%), but considers frequency scaling (either a decrease in core frequency for power saving or an increase in core frequency thanks to Turbo Boost) and hyper-threading.
PCPU_USED% = PCPU_UTIL% * effective core frequency / nominal core frequency.
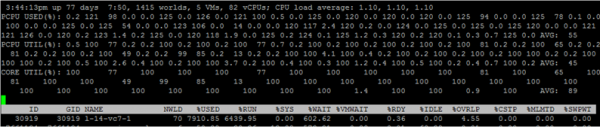
In this screenshot, for some cores, due to Turbo Boost operation, the USED value exceeds 100%, as the core frequency is higher than nominal.
A few words about how hyper-threading is taken into account. If processes are executed 100% of the time on both threads of the physical server core while the core operates at nominal frequency, then:
- CORE UTIL for the core will be 100%,
- PCPU UTIL for both threads will be 100%,
- PCPU USED for both threads will be 50%.
If both threads were not working 100% of the time during the measurement period, then in the periods when the threads were working in parallel, PCPU USED for the cores is halved.
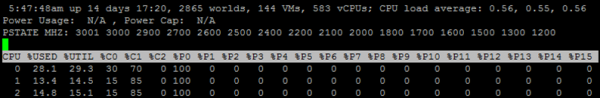
ESXTOP also has a screen with CPU power consumption parameters for the server. Here you can check if the server uses power-saving technologies: C-states and P-states. It is called by pressing the ‘p’ key:
Standard CPU Performance Issues
Lastly, I'll go over typical causes of CPU performance issues in VMs and give short tips on how to solve them:
Insufficient core frequency. If it is not possible to move the VM to more powerful cores, you can try changing power settings so that Turbo Boost works more efficiently.
Incorrect VM sizing (too many/few cores). If you allocate too few cores, there will be high CPU load on the VM. If you allocate too many, you will experience high co-stop.
High CPU oversubscription on the server. If there is high Ready on the VM, reduce the CPU oversubscription.
Incorrect NUMA topology on large VMs. De NUMA-topologie die de VM ziet (vNUMA) moet overeenkomen met de NUMA-topologie van de server (pNUMA). Over de diagnose en mogelijke oplossingen voor dit probleem is bijvoorbeeld geschreven in het boek . Als u zich niet wilt verdiepen en geen licentiebeperkingen heeft voor het besturingssysteem dat op de VM is geïnstalleerd, kunt u op de VM veel virtuele sockets met elk één kern maken. U verliest er niet veel mee 🙂
Dat was alles over de CPU. Stel gerust vragen. In het volgende deel zal ik het over het werkgeheugen hebben.
Nuttige links
Bron: habr.com
