

Een tijdreeksdatabase (TSDB, time series database) in Prometheus 2 is een uitstekend voorbeeld van een technische oplossing die aanzienlijke verbeteringen biedt ten opzichte van de opslag v2 in Prometheus 1, zowel in termen van snelheid van gegevensverzameling als het uitvoeren van queries en de efficiëntie van hulpbronnen. We hebben Prometheus 2 geïmplementeerd in Percona Monitoring and Management (PMM), en ik had de gelegenheid om de prestaties van de Prometheus 2 TSDB te onderzoeken. In dit artikel deel ik de resultaten van deze observaties.
Gemiddelde werklast van Prometheus
Voor degenen die gewend zijn om met relationele databases te werken, is de gebruikelijke werklast van Prometheus behoorlijk interessant. De snelheid van gegevensverzameling neigt naar een stabiele waarde: meestal sturen de diensten die je monitort ongeveer dezelfde hoeveelheid metrics, en de infrastructuur verandert relatief langzaam.
Aanvragen kunnen vanuit verschillende bronnen komen. Sommige, zoals waarschuwingen, neigen ook naar een stabiele en voorspelbare waarde. Andere, zoals gebruikersaanvragen, kunnen pieken veroorzaken, hoewel dit niet kenmerkend is voor de meeste belasting.
Stress-test
Tijdens de test concentreerde ik me op de capaciteit om gegevens te verzamelen. Ik rolde Prometheus 2.3.2 uit, gecompileerd met Go 1.10.1 (als onderdeel van PMM 1.14) op een Linode-service met behulp van dit script: . Voor de meest realistische generatie van belasting, gebruikte ik deze om verschillende MySQL-nodes met een echte belasting (Sysbench TPC-C Test) te starten, waarbij elke node 10 Linux/MySQL-nodes emuleerde.
Alle onderstaande tests werden uitgevoerd op een Linode-server met acht virtuele cores en 32 GB RAM, waarop 20 belasting-simulaties draaien voor het monitoren van tweehonderd MySQL-instanties. Of, in termen van Prometheus, 800 targets, 440 scrapes per seconde, 380.000 samples per seconde en 1,7 miljoen actieve tijdreeksen.
Ontwerp
De gebruikelijke aanpak van traditionele databases, waaronder die gebruikt door Prometheus 1.x, bestaat uit . Als daar niet genoeg van is om de belasting aan te kunnen, zul je grote vertragingen ondervinden en zullen sommige aanvragen niet worden uitgevoerd. Het geheugenbeheer in Prometheus 2 wordt geconfigureerd via de sleutel storage.tsdb.min-block-duration, die bepaalt hoe lang gegevens in het geheugen worden opgeslagen voordat ze naar de schijf worden weggeschreven (standaard is dit 2 uur). De benodigde hoeveelheid geheugen is afhankelijk van het aantal tijdreeksen, labels en de intensiteit van gegevensverzameling in samenhang met de netto inkomende stroom. Wat betreft schijfruimte streeft Prometheus ernaar om 3 bytes per record (sample) te gebruiken. Aan de andere kant zijn de geheugeneisen veel hoger.
Hoewel het mogelijk is om de blokgrootte te configureren, wordt het niet aanbevolen om dit handmatig aan te passen, waardoor u verplicht bent om Prometheus zoveel geheugen te geven als het vraagt voor uw belasting.
Als er niet genoeg geheugen is om de inkomende stroom van metrics te ondersteunen, zal Prometheus crashen met out of memory of het zal door de OOM killer worden bereikt.
Het toevoegen van swap om het moment van falen uit te stellen wanneer Prometheus zonder geheugen komt te zitten, helpt niet echt, omdat het gebruik van deze functie leidt tot explosief geheugenverbruik. Ik denk dat het te maken heeft met Go, zijn garbage collector en hoe het werkt met swap.
Een andere interessante benadering lijkt het instellen van de head block flush naar de schijf op een bepaald tijdstip, in plaats van deze vanaf de starttijd van het proces te tellen.
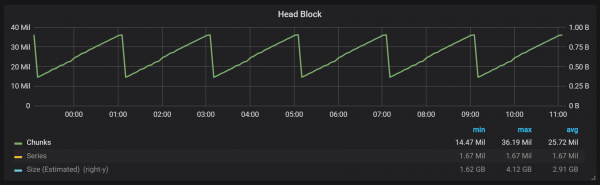
Zoals u in de grafiek kunt zien, vinden flushes naar de schijf elke twee uur plaats. Als u de parameter min-block-duration op een uur wijzigt, zullen deze flushes elk uur plaatsvinden, beginnend over een half uur.
Als u deze en andere grafieken in uw Prometheus-installatie wilt gebruiken, kunt u deze . Het is ontworpen voor PMM, maar met een paar kleine aanpassingen is het geschikt voor elke Prometheus-installatie.
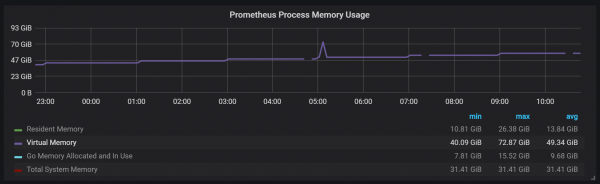
We hebben een actieve blok, de head block genoemd, die in het geheugen wordt opgeslagen; oudere gegevensblokken zijn toegankelijk via mmap(). Dit elimineert de noodzaak om de cache apart te configureren, maar betekent ook dat u voldoende ruimte moet laten voor de systeemcache als u gegevens wilt opvragen die ouder zijn dan wat de head block kan bevatten.
Dit betekent ook dat het geheugengebruik van Prometheus vrij hoog zal lijken, waarover u zich geen zorgen hoeft te maken.
Een ander interessant ontwerpkenmerk is het gebruik van WAL (write ahead log). Zoals te zien is in de documentatie over de opslag, gebruikt Prometheus WAL om gegevensverlies bij crashes te voorkomen. De specifieke mechanismen die de duurzaamheid van gegevens waarborgen zijn helaas onvoldoende gedocumenteerd. Versie Prometheus 2.3.2 schrijft WAL elke 10 seconden naar de schijf, en deze parameter kan niet door de gebruiker worden geconfigureerd.
Compaction
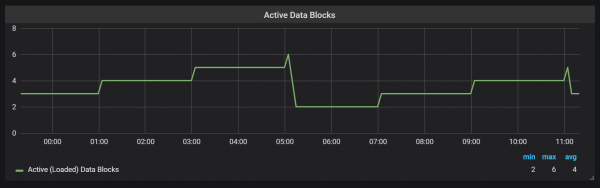
Prometheus TSDB is ontworpen naar het voorbeeld van LSM-opslag (Log Structured Merge - log-gestuctureerde samengevoegde bomen): het hoofdblok wordt periodiek naar de schijf geschreven, terwijl het compaction-mechanisme meerdere blokken samenvoegt om te voorkomen dat er te veel blokken gescand moeten worden tijdens verzoeken. Hier is het aantal blokken te zien dat ik heb waargenomen in het testsysteem na een dag belasting.
Als u meer wilt weten over de opslag, kunt u het bestand meta.json bekijken, dat informatie bevat over de beschikbare blokken en hoe ze zijn ontstaan.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Compactions in Prometheus zijn gebonden aan het tijdstip waarop het hoofdblok naar de schijf wordt geschreven. Op dat moment kunnen meerdere van dergelijke bewerkingen plaatsvinden.
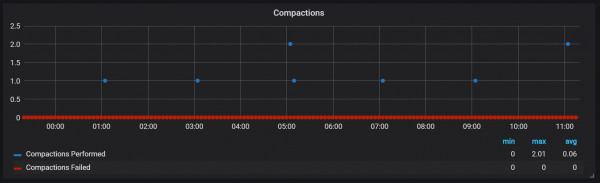
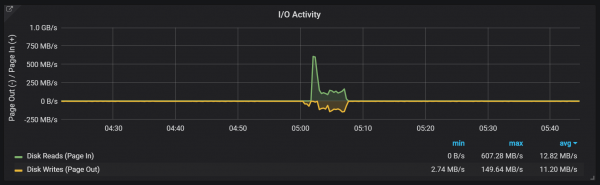
Het lijkt erop dat de compressie niet beperkt is en kan leiden tot grote schommelingen in de schijf I/O tijdens verwerking.
Schommelingen in CPU-load
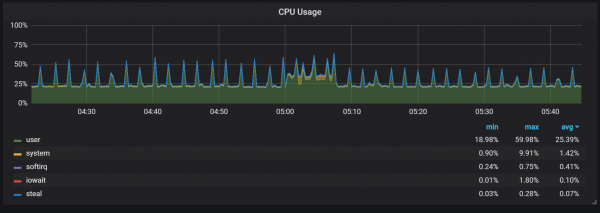
Natuurlijk heeft dit een vrij negatieve invloed op de systeemsnelheid en vormt het ook een serieus probleem voor LSM-opslag: hoe compressie te implementeren om hoge snelheden van aanvragen te ondersteunen zonder te veel overhead te veroorzaken?
Het geheugengebruik tijdens compressie ziet er ook best interessant uit.
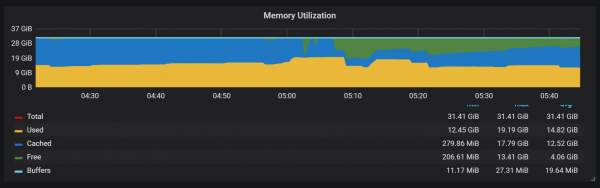
We kunnen zien dat na compressie het grootste deel van het geheugen van Cached naar Free verandert: dit betekent dat potentieel waardevolle informatie daar is verwijderd. Ik ben benieuwd of hier fadvice() of een andere techniek voor minimalisatie wordt gebruikt, of dat dit is veroorzaakt doordat de cache is vrijgemaakt van blokken die tijdens de compressie zijn vernietigd?
Herstel na storing
Herstel na storingen kost tijd, en dat is begrijpelijk. Voor een inkomende stroom van een miljoen records per seconde moest ik ongeveer 25 minuten wachten totdat het herstel plaatsvond, rekening houdend met de SSD-schijf.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Starting Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Start listening for connections" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Starting TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router prefix" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="found healthy block" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="WAL corruption detected; truncating" err="unexpected CRC32 checksum d0465484, want 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB started"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Loading configuration file" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Completed loading of configuration file" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Server is ready to receive web requests."
Het belangrijkste probleem van het herstelproces is het hoge geheugenverbruik. Hoewel de server in normale situaties stabiel kan draaien met dezelfde hoeveelheid geheugen, kan hij na een crash mogelijk niet opnieuw opstarten vanwege OOM. De enige oplossing die ik heb gevonden, is het uitschakelen van gegevensverzameling, de server op te starten, hem te laten herstellen en vervolgens opnieuw op te starten met gegevensverzameling ingeschakeld.
Opwarming
Een ander gedrag waar rekening mee moet worden gehouden tijdens de opwarming is de verhouding tussen lage prestaties en hoog verbruik van middelen direct na de start. Tijdens sommige, maar niet alle starts, heb ik aanzienlijke belasting van de CPU en het geheugen waargenomen.
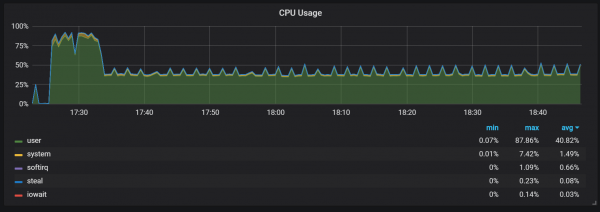
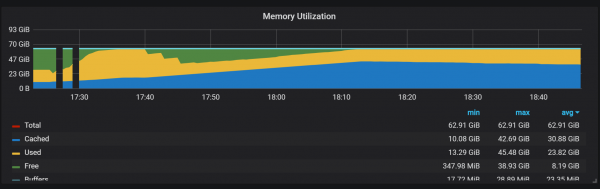
Gaten in het geheugenverbruik geven aan dat Prometheus niet in staat is om bij de start alle verzamelingen te configureren, waardoor bepaalde informatie verloren gaat.
Ik heb de exacte oorzaken van de hoge belasting van de CPU en het geheugen niet vastgesteld. Ik vermoed dat dit verband houdt met het creëren van nieuwe tijdseries in het hoofdblok met een hoge frequentie.
Schommelingen in de CPU-belasting
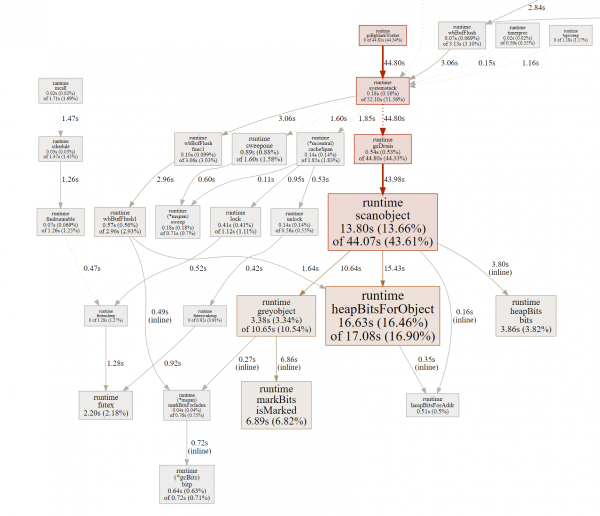
Naast de compressies die een behoorlijk hoge belasting op I/O veroorzaken, heb ik ernstige schommelingen in de CPU-belasting opgemerkt om de twee minuten. De pieken zijn langer bij een hoge inkomende flow en het lijkt erop dat ze veroorzaakt worden door de garbage collector van Go, tenminste sommige cores zijn volledig belast.
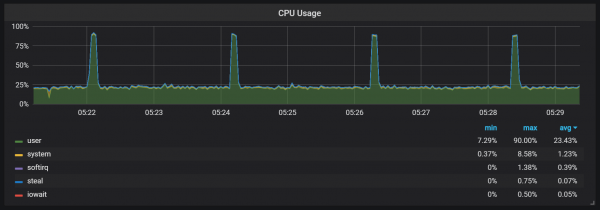
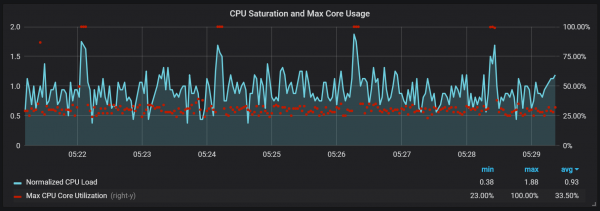
Deze schommelingen zijn niet zo onbelangrijk. Het lijkt erop dat wanneer ze optreden, de interne instap en de Prometheus-metrieken niet toegankelijk zijn, wat leidt tot gegevensmisslagen in die tijdsperioden.
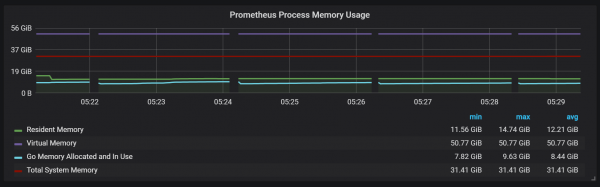
Het is ook merkbaar dat de Prometheus-exporteur één seconde vastloopt.
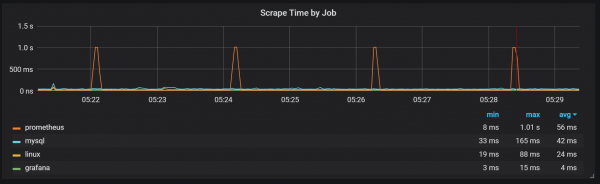
We kunnen correlaties opmerken met garbage collection (GC).
Conclusie
TSDB in Prometheus 2 functioneert snel, kan miljoenen tijdseries aan en tegelijkertijd duizenden records per seconde verwerken, waarbij het vrij bescheiden hardware gebruikt. De benutting van CPU en schijf-I/O is ook indrukwekkend. Mijn voorbeeld toonde tot 200.000 metrics per seconde op één gebruikte core.
Voor het plannen van uitbreiding moet men rekening houden met voldoende geheugen, en dit moet daadwerkelijk RAM zijn. Het volume van het gebruikte geheugen dat ik heb waargenomen, was ongeveer 5 GB per 100.000 records per seconde van inkomende stroom, wat, samen met de cache van het besturingssysteem, resulteerde in ongeveer 8 GB aan gebruikt geheugen.
Natuurlijk is er nog veel werk te verzetten om de pieken in CPU en schijf-I/O te temmen, en dat is niet verrassend, gezien hoe jong TSDB Prometheus 2 nog is in vergelijking met InnoDB, TokuDB, RocksDB, WiredTiger, maar zij hadden allemaal soortgelijke problemen aan het begin van hun levenscyclus.
Bron: habr.com
