

Hallo, ik ben Dmitry Logvinenko - Data Engineer van de analytics afdeling van de groep bedrijven 'Vezёт'.
Ik zal jullie vertellen over een geweldig hulpmiddel voor het ontwikkelen van ETL-processen - Apache Airflow. Maar Airflow is zo veelzijdig dat je er zelfs naar moet kijken als je geen datastromen beheert, maar af en toe processen moet starten en hun uitvoering moet volgen.
En ja, ik zal niet alleen vertellen, maar ook laten zien: het programma bevat veel code, screenshots en aanbevelingen.
Wat je meestal ziet als je het woord Airflow googelt / Wikimedia Commons
Inhoudsopgave
Inleiding
Apache Airflow - het is net als Django:
- geschreven in Python,
- heeft een uitstekende admininterface,
- onbeperkt uitbreidbaar,
— alleen beter, en het is gemaakt voor heel andere doelen, namelijk (zoals eerder geschreven):
- uitvoering en monitoring van taken op een onbeperkt aantal machines (zoveel als Celery/Kubernetes en je geweten toestaan)
- met dynamische workflow-generatie uit heel eenvoudig te schrijven en te begrijpen Python-code
- en de mogelijkheid om elke database en API met elkaar te verbinden met zowel kant-en-klare componenten als op maat gemaakte plugins (wat extreem eenvoudig te doen is).
Wij gebruiken Apache Airflow als volgt:
- we verzamelen gegevens uit verschillende bronnen (meerdere SQL Server- en PostgreSQL-instanties, verschillende API's met gebruiksstatistieken van applicaties, zelfs 1C) in DWH en ODS (voor ons zijn dat Vertica en Clickhouse).
- als een geavanceerde
cron, die processen voor datacongregatie op ODS start en ook toezicht houdt op hun onderhoud.
Tot voor kort werd in onze behoeften voorzien door één kleine server met 32 cores en 50 GB RAM. In Airflow draait dit:
- meer dan 200 dags (eigenlijk workflows, waarin we taken hebben gestopt),
- met gemiddeld 70 taken,
- dit goedje wordt (ook gemiddeld) een keer per uur.
En over hoe we zijn uitgebreid, daarover schrijf ik hieronder, maar laten we nu de über-taak definiëren die we gaan oplossen:
Er zijn drie oorspronkelijke SQL-servers, elk met 50 databases - instanties van één project, waardoor hun structuur vrijwel identiek is (bijna overal, muah-ha-ha), en dat betekent dat er in elk een tabel genaamd Orders zit (gelukkig kan een tabel met die naam in elke onderneming worden gestopt). We halen gegevens op door servicevelden toe te voegen (bronserver, brondatabase, ETL-taakidentificator) en gooien deze naïef in, laten we zeggen, Vertica.
Laten we beginnen!
De belangrijkste, praktische (en een beetje theoretische) deel
Waarom hebben we dit nodig (en jullie)
Toen de bomen groot waren en ik een eenvoudige SQL-werker in één Russische retail was, schoten we ETL-processen aka datastromen door middel van twee beschikbare hulpmiddelen:
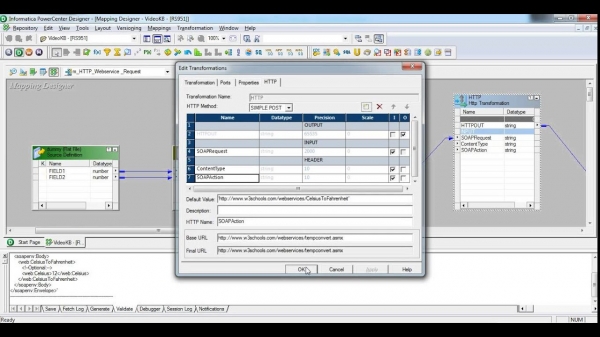
- Informatica Power Center — een extreem uitgebreide systeem, zeer productief, met eigen hardware, en eigen versiebeheer. Ik gebruikte misschien 1% van zijn mogelijkheden. Waarom? Nou, ten eerste, deze interface komt uit de nuljaren en drukte mentaal op ons. Ten tweede, dit ding is ontworpen voor extreem complexe processen, heftig hergebruik van componenten en andere zeer belangrijke enterprise-functies. Over de prijs, die als een vleugel van een Airbus A380 per jaar is, zullen we maar zwijgen.
Pas op, een screenshot kan voor mensen onder de 30 een beetje pijn doen.

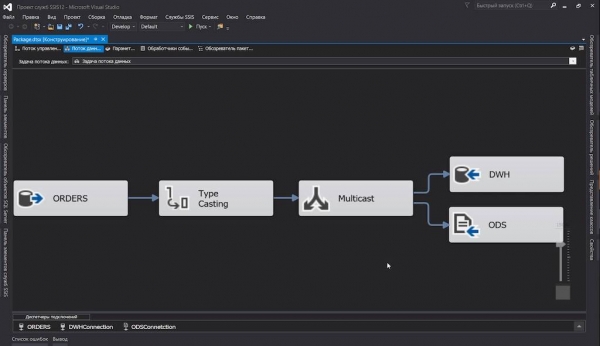
- SQL Server Integration Server — deze kameraad gebruikten we in onze interne projectstromen. Nou ja, in feite: SQL Server gebruiken we al, en het zou niet logisch zijn om zijn ETL-tools niet te gebruiken. Alles is goed aan hem: de interface is mooi, en de uitvoeringsrapporten… Maar dat is niet waarom we softwareproducten leuk vinden, oh nee. We kunnen er een
dtsx(dat een XML voorstelt met door elkaar gemengde knooppunten bij het opslaan), maar wat heeft dat voor zin? Maar een takenpakket maken dat honderd tabellen van de ene server naar de andere verplaatst? Ja, wat honderd, je gaat je wijsvinger verliezen na twintig klikken op de muisknop. Maar het ziet er zeker modieus uit:
We waren absoluut op zoek naar oplossingen. De zaak ging zelfs bijna over naar een zelfgeschreven SSIS-pakketgenerator...
… en toen vond ik een nieuwe baan. En daar vond Apache Airflow mij.
Toen ik ontdekte dat de beschrijvingen van ETL-processen gewoon eenvoudige Python-code zijn, begon ik bijna te dansen van blijdschap. Zo werden datastromen onder versiebeheer en diff geplaatst, en het samenvoegen van tabellen met een uniforme structuur uit honderden databases in één doel werd een zaak van Python-code op anderhalf tot twee 13-inch schermen.
We bouwen een cluster
Laten we niet geheel kinderlijke toestanden creëren door over totaal voor de hand liggende zaken te praten, zoals de installatie van Airflow, de door u gekozen database, Celery en andere zaken die in de documentatie zijn beschreven.
Zodat we meteen kunnen beginnen met experimenteren, heb ik een schets gemaakt docker-compose.yml waarin:
- Laten we nu inderdaad Airflow: Scheduler, Webserver. Ook zal Flower draaien om Celery-taken te monitoren (omdat het al is toegevoegd aan
apache/airflow:1.10.10-python3.7, en daar zijn we niet tegen); - PostgreSQL, waarin Airflow zijn operationele informatie (plannergegevens, uitvoeringsstatistieken, enz.) zal schrijven, en Celery zal voltooide taken registreren;
- Redis, dat als takenbroker voor Celery zal functioneren;
- Celery worker, die zich zal bezighouden met het uitvoeren van de taken.
- In de map
./dagswe zullen onze bestanden met de beschrijving van de dags hierin plaatsen. Ze zullen on-the-fly worden opgepikt, dus het is niet nodig om de hele stack na elke kleine wijziging opnieuw op te bouwen.
Sommige delen van de code in de voorbeelden zijn niet volledig weergegeven (om de tekst niet te overladen), terwijl andere tijdens het proces worden gemodificeerd. Volledige werkende codevoorbeelden kunt u bekijken in de repository. .
docker-compose.yml
versie: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis als Celery-broker
  broker:
    image: redis:6.0.5-alpine

  # DB voor de Airflow-metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Hoofdcontainer met Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery-werker, wordt geschaald met `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Aantekeningen:
- Bij de samenstelling van de compositiebestanden baseerde ik me grotendeels op het bekende afbeelding – bekijk het zeker. Misschien heb je in je leven verder niets meer nodig.
- Alle instellingen van Airflow zijn niet alleen toegankelijk via
airflow.cfg, maar ook via omgevingsvariabelen (in het eerbetoon aan de ontwikkelaars), waar ik schandalig gebruik van heb gemaakt. - Natuurlijk is het niet productie-klaar: ik heb opzettelijk geen heartbeats ingesteld voor de containers en heb me niet beziggehouden met beveiliging. Maar ik heb het minimum gedaan dat geschikt is voor onze experimenten.
- Let op dat:
- De map met de dags moet toegankelijk zijn voor zowel de planner als de werkers.
- Hetzelfde geldt voor alle externe bibliotheken — deze moeten ook zijn geïnstalleerd op de machines met de scheduler en workers.
Nou, nu eenvoudig:
$ docker-compose up --scale worker=3Nadat alles is opgestart, kun je de web-interfaces bekijken:
- Airflow:
- Flower:
Belangrijke begrippen
Als je geen idee hebt wat al deze "DAGs" inhouden, hier is een korte woordenlijst:
- Scheduler — de belangrijkste man in Airflow, die ervoor zorgt dat robots werken en niet mensen: hij houdt het schema in de gaten, werkt DAGs bij en start taken.
In oudere versies had hij eigenlijk problemen met geheugen (nee, geen amnesie, maar lekken) en in de configuraties bleef zelfs een legacy-parameter bestaan
run_duration— het interval voor zijn herstart. Maar nu gaat alles goed. - DAG (ook wel "dag") — "directed acyclic graph", maar deze definitie zegt de meeste mensen niet zoveel, het is in wezen een container voor taken die met elkaar interageren (zie hieronder) of vergelijkbaar met Package in SSIS en Workflow in Informatica.
Naast DAGs kunnen er ook subdag's zijn, maar daar komen we waarschijnlijk niet aan toe.
- DAG Run — een geïnitieerd DAG, dat zijn eigen
execution_date. DAG-runs van één DAG kunnen prima parallel werken (tenzij je natuurlijk je taken idempotent hebt gemaakt). - Operator — dit zijn stukjes code die verantwoordelijk zijn voor het uitvoeren van een specifieke actie. Er zijn drie typen operators:
- actie, zoals onze favoriete
PythonOperator, die in staat is om elke (geldige) Python-code uit te voeren; - transfer, die gegevens van de ene plek naar de andere verplaatsen, bijvoorbeeld,
MsSqlToHiveTransfer; - sensor kan reageren of de verdere uitvoering van de DAG vertragen tot het optreden van een bepaalde gebeurtenis.
HttpSensorkan een opgegeven endpoint aanroepen, en wanneer hij het juiste antwoord krijgt, de overdracht startenGoogleCloudStorageToS3Operator. Een nieuwsgierige geest vraagt zich af: "waarom? Je kunt herhalingen direct in de operator doen!" En daarna, om de taskpool niet te verstoppen met vastlopende operators. De sensor start, controleert en sterft tot de volgende poging.
- actie, zoals onze favoriete
- Taak — de gedefinieerde operators ongeacht het type en gekoppeld aan de DAG worden verhoogd tot de rang van taak.
- Taakinstantie — wanneer de hoofdplanner besluit dat het tijd is om de taken aan de uitvoerende werkers te sturen (ter plaatse, als we gebruikmaken van
LocalExecutorof op een externe node in het geval vanCeleryExecutor), wijst hij een context aan (dat wil zeggen, een set variabelen — uitvoeringsparameters), rolt commando- of query-sjablonen uit en voegt deze samen in een pool.
We genereren taken
Laten we eerst het algemene schema van onze DAG schetsen, en daarna steeds dieper ingaan op de details, omdat we enkele niet-triviale oplossingen toepassen.
Dus, in de eenvoudigste vorm zou zo'n DAG eruitzien als volgt:
van datetime import timedelta, datetime

van airflow import DAG
van airflow.operators.python_operator import PythonOperator

van commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

voor conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Laten we het uitzoeken:
- Eerst importeren we de benodigde bibliotheken en nog wat andere dingen;
sql_server_dsisList[namedtuple[str, str]]met namen van connecties uit Airflow Connections en de databases waaruit we onze tabel zullen ophalen;dagis de verklaring van onze dag, die absoluut in moet liggen inglobals(), anders kan Airflow deze niet vinden. We moeten de dag ook vertellen:- wat zijn naam is
ordersdit is de naam die zal verschijnen in de webinterface, - wanneer hij zal beginnen, vanaf middernacht op 8 juli,
- en dat hij ongeveer elke 6 uur moet draaien (voor de coole jongens is hier in plaats van
timedelta()zal eencron-string0 0 0/6 ? * * *, voor minder coole is een uitdrukking zoals@daily);
- wat zijn naam is
workflow()zal het belangrijkste werk doen, maar niet nu. Nu zullen we gewoon onze context naar de log afvoeren.- En nu de eenvoudige magie van taakcreatie:
- we lopen door onze bronnen;
- initialiseren
PythonOperator, die onze lege functie zal uitvoerenworkflow(). Vergeet niet om een unieke (binnen de dag) taaknaam op te geven en verbind de dag zelf. De vlagprovide_contextdaarentegen zal extra argumenten in de functie aanleveren, die we zorgvuldig zullen verzamelen met behulp van**context.
Dat is voorlopig alles. Wat hebben we gekregen:
- een nieuwe dag in de webinterface,
- ongeveer anderhalve honderd taken die parallel uitgevoerd zullen worden (als de instellingen van Airflow, Celery en de servercapaciteiten het toestaan).
Nou, bijna gekregen.
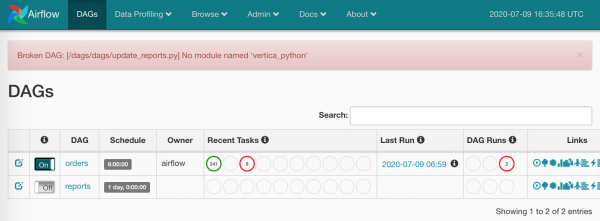
Wie zal de afhankelijkheden instellen?
Om dit allemaal te vereenvoudigen, heb ik het toegevoegd aan docker-compose.yml de verwerking requirements.txt op alle knooppunten.
Nu gaat het echt beginnen:
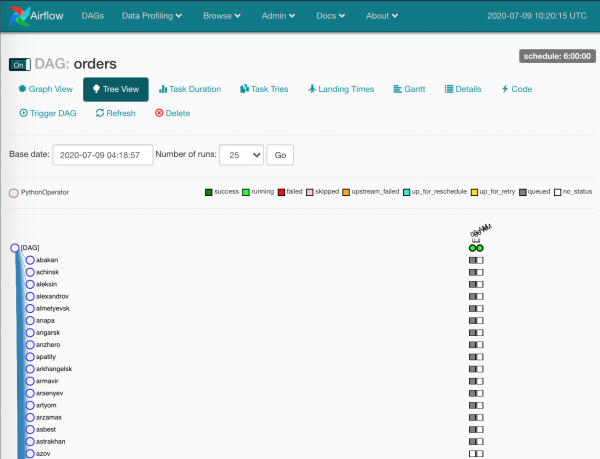
Grijze vakjes zijn task instances, verwerkt door de planner.
Even wachten, de taken worden opgepikt door de werknemers:
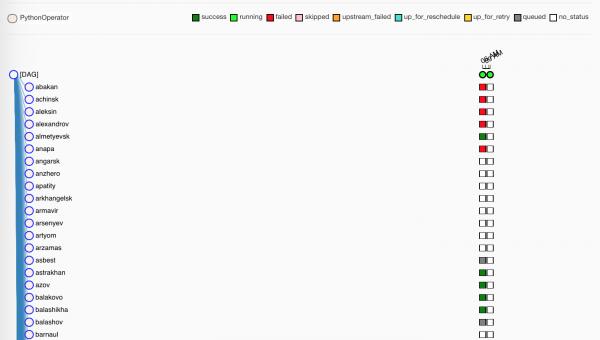
Groenen, dat spreekt voor zich, zijn succesvol uitgevoerd. Rood — minder succesvol.
Overigens, op onze productie is er geen map
./dags, die tussen de machines synchroniseert — alle dags liggen ingitop onze Gitlab, en Gitlab CI verspreidt de updates naar de machines bij het mergen inmaster.
Een beetje over Flower
Terwijl de werknemers onze lege taken aan het verwerken zijn, laten we een ander hulpmiddel herinnert dat ons iets kan tonen — Flower.
De allereerste pagina met samenvattende informatie over de worker-knooppunten:
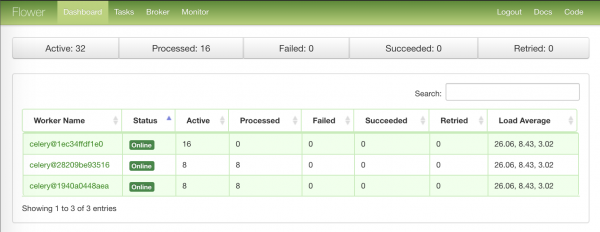
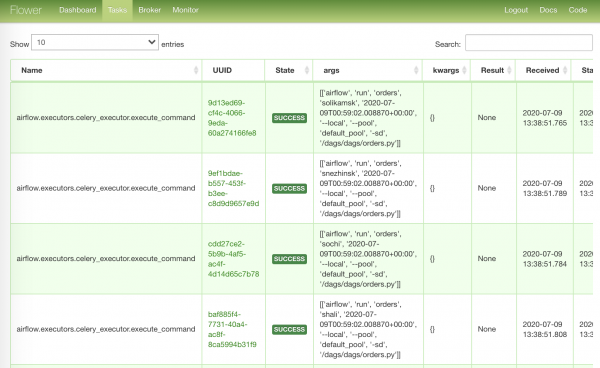
De meest informatieve pagina met taken die in behandeling zijn genomen:
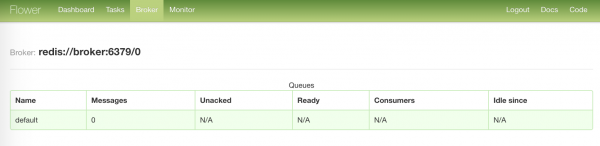
De saaiste pagina over de status van onze broker:
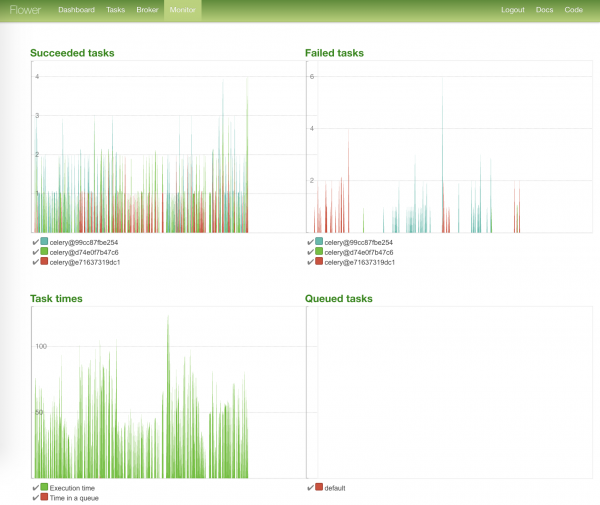
De meest opvallende pagina - met grafieken van de status van taken en hun uitvoeringstijden:
We laden niet-gedownloade data bij
Dus, alle taken zijn uitgevoerd, we kunnen de gewonden evacueren.
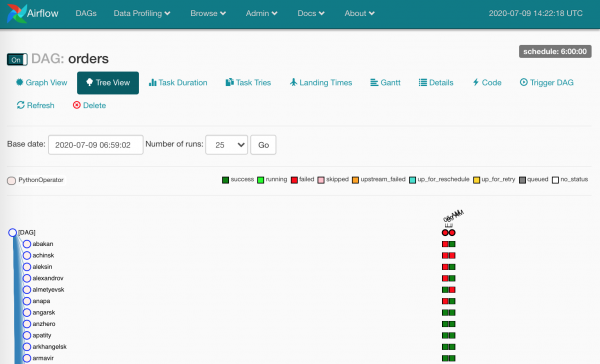
En het aantal gewonden was niet gering - om verschillende redenen. Bij correct gebruik van Airflow geven deze vierkanten aan dat de gegevens zeker niet zijn aangekomen.
We moeten de log bekijken en de mislukte taakinstellingen opnieuw starten.
Door op een van de vierkanten te klikken, zien we de beschikbare acties voor ons:
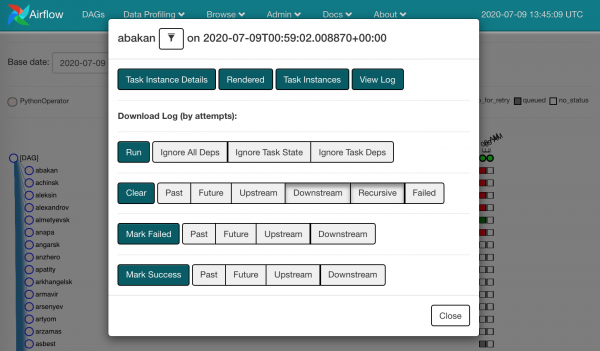
We kunnen de mislukte taak gewoon wissen. Dat wil zeggen, we vergeten dat er iets is vastgelopen, en dezelfde taakinstantie gaat verder naar de planner.
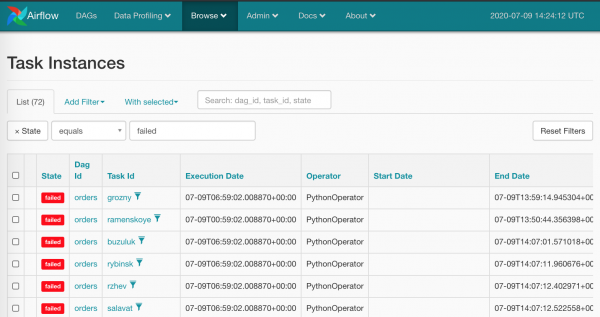
Het is duidelijk dat het niet erg menselijk is om met de muis al die rode vierkanten aan te klikken - dat is niet wat we van Airflow verwachten. Natuurlijk hebben we een massavernietigingswapen: Browse/Task Instances
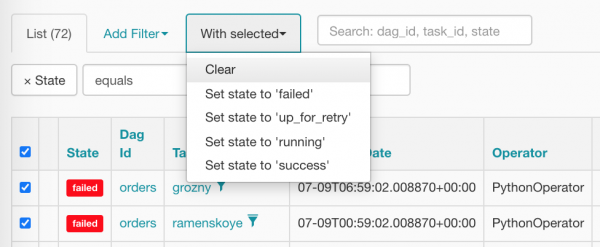
Laten we alles tegelijk selecteren en op de juiste optie klikken om alles te resetten:
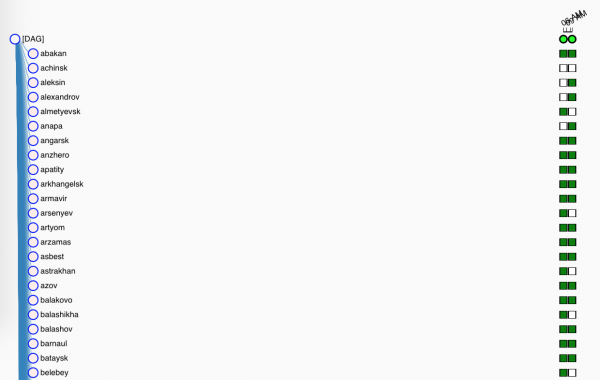
Na de wisactie zien onze taxi's er zo uit (ze kunnen niet wachten tot de scheduler ze plant):
Verbinden, hooks en andere variabelen
Het is tijd om naar de volgende DAG te kijken, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Geachte dames en heren, de rapporten zijn bijgewerkt"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasha, word wakker, we hebben {{ dag.dag_id }} laten vallen
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Heeft iedereen ooit een rapportage-update gemaakt? Hier is hij weer: er is een lijst met bronnen waaruit we gegevens moeten halen; er is een lijst met bestemmingen waar we ze moeten plaatsen; en vergeet niet een signaal te geven wanneer alles is gebeurd of kapot is gegaan (nou, dat betreft ons niet, toch).
Laten we nogmaals het bestand doornemen en kijken naar de nieuwe onduidelijke dingen:
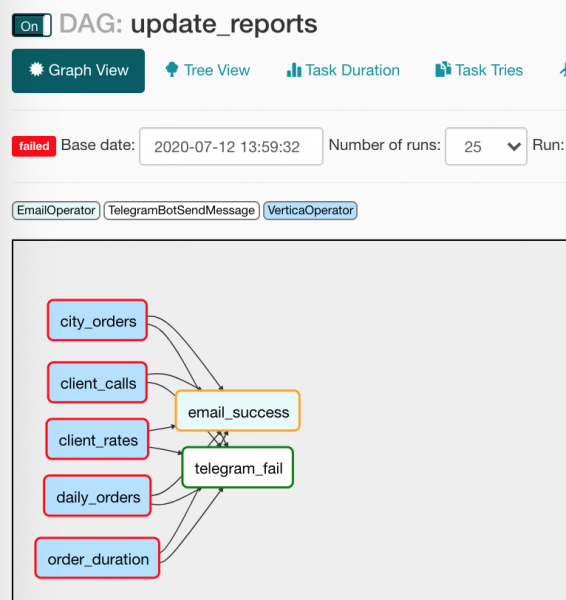
from commons.operators import TelegramBotSendMessage— er staat niets ons in de weg om onze eigen operators te maken, wat we hebben gedaan met een kleine wrapper voor het verzenden van berichten naar Unblocked. (Over deze operator zullen we hieronder nog praten);default_args={}— de DAG kan dezelfde argumenten aan al zijn operators toekennen;to='{{ var.value.all_the_kings_men }}'— veld— is leeg, en kiest daardoor indirectzal niet hardcoded zijn, maar dynamisch worden gegenereerd met behulp van Jinja en een variabele met een lijst van e-mailadressen, die ik zorgzaam heb geplaatst inAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— voorwaarde voor het activeren van de operator. In ons geval zal de e-mail alleen naar de bazen worden gestuurd als alle afhankelijkheden succesvol zijn uitgevoerd succesvol;tg_bot_conn_id='tg_main'— argumentenconn_idontvangen de identificaties van de verbindingen die we aanmaken inAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— berichten naar Telegram worden alleen verzonden als er mislukte taken zijn;task_concurrency=1— we staan gelijktijdige uitvoering van meerdere task instances van dezelfde taak niet toe. Anders krijgen we gelijktijdige uitvoering van meerdereVerticaOperator(die naar dezelfde tabel kijken);report_update >> [email, tg]— allesVerticaOperatorzal samenkomen in het versturen van de e-mail en het bericht, zo:

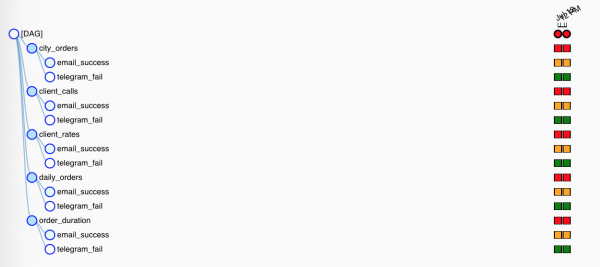
Maar omdat de notificatie-operators verschillende activeringsvoorwaarden hebben, zal er maar één werken. In de Tree View lijkt het iets minder duidelijk:

Ik zal een paar woorden zeggen over macro's en hun vrienden — van variabelen.
Macro's zijn Jinja placeholders die verschillende nuttige informatie in de argumenten van operators kunnen plaatsen. Bijvoorbeeld zo:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} zal worden omgevormd tot de inhoud van de contextvariabele execution_date in het formaat YYYY-MM-DD: 2020-07-14. Het leuke is dat contextvariabelen aan een bepaalde task instance (de vierkant in Tree View) zijn vastgemaakt, en bij het opnieuw starten zullen de placeholders zich openen met dezelfde waarden.
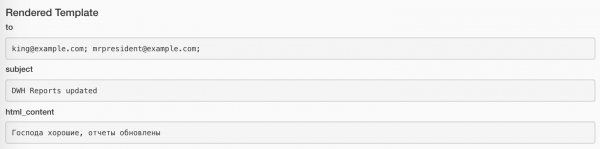
Toegewezen waarden kunnen worden bekeken met de Rendered-knop op elke task instance. Zo ziet het eruit voor de taak die de e-mail verzendt:
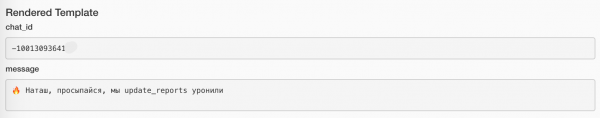
En zo voor de taak die het bericht verzendt:
Een volledige lijst van ingebouwde macro's voor de laatste beschikbare versie is hier beschikbaar:
Bovendien kunnen we met behulp van plugins onze eigen macro's declareren, maar dat is een heel ander verhaal.
Naast de vooraf gedefinieerde dingen kunnen we ook de waarden van onze variabelen invullen (ik heb dit eerder in de code al gedaan). Laten we in Admin/Variables een paar dingen maken:
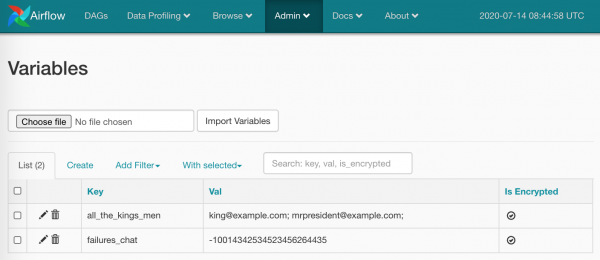
Dat is het, we kunnen aan de slag:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')In de waarde kan een scalar zijn, maar het kan ook JSON bevatten. In het geval van JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
gewoon het pad naar de juiste sleutel gebruiken: {{ var.json.bot_config.bot.token }}.
Ik zal letterlijk één woord zeggen en een screenshot tonen over verbindingen. Hier is alles eenvoudig: op de pagina Admin/Connections maken we een verbinding, zetten we onze inloggegevens/wachtwoorden en meer specifieke parameters daarin. Zo:
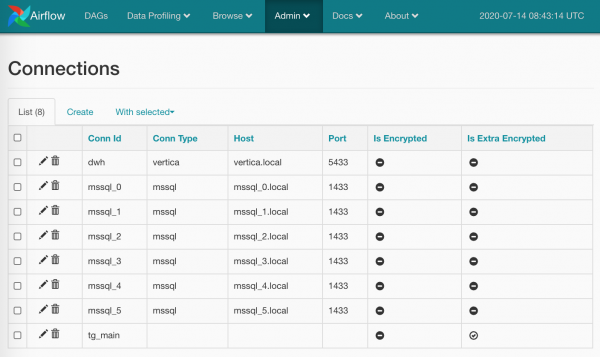
Wachtwoorden kunnen versleuteld worden (zorgvuldiger dan in de standaardoptie), en je kunt het type verbinding ook weglaten (zoals ik deed voor tg_main) — het punt is dat de lijst van types ingebakken is in de modellen van Airflow en niet kan worden uitgebreid zonder in de broncode te duiken (als ik per ongeluk iets niet heb gevonden — laat het me weten), maar het verkrijgen van referenties puur op naam zal ons niet kunnen tegenhouden.
Bovendien kun je meerdere verbindingen met dezelfde naam maken: in dat geval zal de methode BaseHook.get_connection(), die verbindingen op naam ophaalt, een willekeurige kiezen uit meerdere homoniemen (het zou logischer zijn om dit met Round Robin te doen, maar laten we dit aan de ontwikkelaars van Airflow overlaten).
Variables en Connections zijn ongetwijfeld geweldige hulpmiddelen, maar het is belangrijk om de balans niet te verliezen: welke delen van je workflows houd je daadwerkelijk in de code en welke geef je uit handen aan Airflow. Aan de ene kant kan het handig zijn om snel een waarde te veranderen, bijvoorbeeld een verzenddoos, via de UI. Aan de andere kant is dit toch een terugkeer naar klikwerk, waar we (ik) vanaf wilden.
Werken met verbindingen is een van de taken hooks. Over het algemeen zijn Airflow-hooks verbindingspunten voor aansluiting op externe diensten en bibliotheken. Bijvoorbeeld, JiraHook biedt ons een client voor interactie met Jira (we kunnen taken heen en weer verplaatsen), en met SambaHook kun je een lokaal bestand uploaden naar smb-punt.
We ontleden een aangepaste operator
En we zijn nu dicht bij het kijken naar hoe TelegramBotSendMessage
Code commons/operators.py is gemaakt met de operator:
van typing import Union

van airflow.operators import BaseOperator

van commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Stuur een bericht naar chat_id met behulp van TelegramBotHook

    Voorbeeld:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} is mislukt :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Stuur "{self.message}" naar de chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Hier, net als de rest in Airflow, is alles heel eenvoudig:
- We zijn overgenomen van
BaseOperator, die veel Airflow-specifieke dingen implementeert (bekijk het gerust op een rustig moment) - We hebben de velden
template_fieldsaangekondigd, waarin Jinja zal zoeken naar macro's voor verwerking. - We hebben de juiste argumenten voor
__init__()opgesteld, met standaardwaarden waar nodig. - We zijn ook de initialisatie van de ouder niet vergeten.
- We hebben de bijbehorende hook geopend
TelegramBotHook, en hebben het clientobject van hem gekregen. - We hebben de methode
BaseOperator.execute()overriden, die Airflow zal oproepen wanneer het tijd is om de operator te starten - daarin realiseren we de hoofdactie, zonder te vergeten in te loggen. (We loggen ons trouwens in viastdoutenstderr— Airflow zal alles onderscheppen, mooi inpakken, en op de juiste plek leggen.)
Laten we kijken wat we hebben in commons/hooks.py. Het eerste deel van het bestand, met de hook zelf:
van typing import Union

van airflow.hooks.base_hook import BaseHook
van requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Opmerking: voeg een verbinding toe met een lege Conn Type en vergeet niet
    om Extra in te vullen:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Ik weet zelfs niet wat ik hier kan uitleggen, ik wil gewoon belangrijke punten opmerken:
- We zijn overgenomen, denken na over de argumenten - in de meeste gevallen is er maar één:
conn_id; - We override de standaardmethoden: ik heb me beperkt tot
get_conn(), waarin ik de verbindingsparameters op naam krijg en gewoon de sectie ophaal.extra(dit is een JSON-veld), waarin ik (volgens mijn eigen instructies!) de Telegram-bottoken heb neergelegd:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Ik maak een instantie van onze
TelegramBot, waarbij ik hem al een specifieke token geef.
Dat is alles. De client van de webhook kan worden verkregen met behulp van TelegramBotHook().client of TelegramBotHook().get_conn().
En het tweede deel van het bestand, waarin ik een micro-wrapper maak voor de Telegram REST API, zodat ik niet dezelfde voor maar één methode sendMessage.
class TelegramBot:
    """Telegram Bot API wrapper

    Voorbeelden:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hi, schat')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hi, schat', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
De juiste manier – al dit samenvoegen:
TelegramBotSendMessage,TelegramBotHook,TelegramBot– in een plugin, deze in een openbaar repository plaatsen en open source maken.
Terwijl we dit allemaal bestudeerden, zijn onze rapportupdates succesvol vastgelopen en hebben ze een foutmelding naar mijn kanaal gestuurd. Ik ga eens kijken wat er weer aan de hand is…
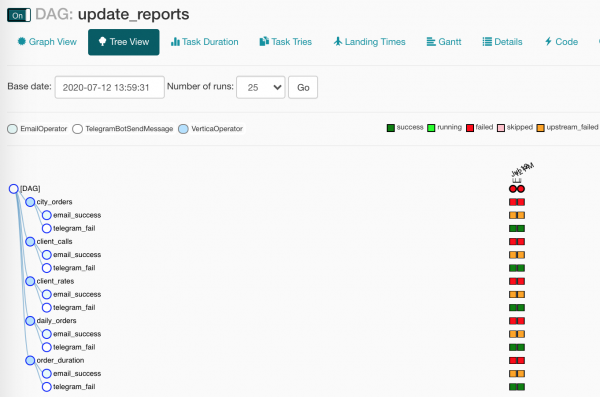
In onze DAG is er iets kapot! Was dat niet waar we op wachtten? Juist!
Ga je nog inschenken?
Voelt u dat ik iets gemist heb? Blijkbaar had ik beloofd om gegevens van SQL Server naar Vertica te migreren, en nu ben ik afgedwaald van het onderwerp, schurk!
Dit kwaad was opzettelijk, ik moest je een beetje terminologie uitleggen. Nu kunnen we verder.
Ons plan was als volgt:
- Een DAG maken
- Taken genereren
- Kijken hoe alles er mooi uitziet
- Sessienummers toewijzen aan uploads
- Gegevens van SQL Server ophalen
- Gegevens in Vertica plaatsen
- Statistieken verzamelen
Dus, om dit allemaal te laten draaien, heb ik een kleine aanvulling gemaakt op onze docker-compose.yml:
docker-compose.db.yml
versie: '3.4'

x-mssql-base: &mssql-base
  afbeelding: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  herstart: altijd
  omgeving:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

diensten:
  dwh:
    afbeelding: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    afbeelding: mio101/py3-sql-db-client-base
    opdracht: python3 ./mssql_init.py
    afhankelijk_van:
      - mssql_0
      - mssql_1
      - mssql_2
    omgeving:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Daar zetten we op:
- Vertica als host
dwhmet de meest standaardinstellingen, - drie exemplaren van SQL Server,
- vullen we de databases met een paar gegevens (kijk vooral niet in de
mssql_init.py!)
We starten alles op met een iets ingewikkelder commando dan de vorige keer:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Wat onze wonderrandomizer heeft gegenereerd, kan worden bekeken, met behulp van de optie Data Profiling/Ad Hoc Query:
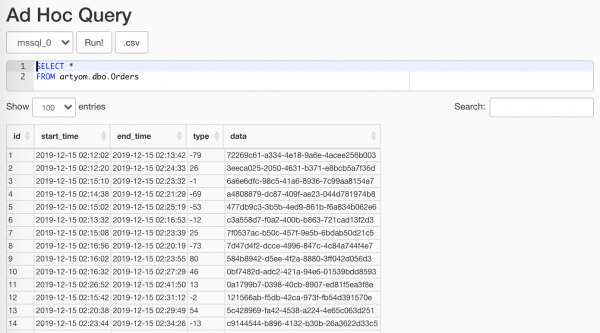
Belangrijk, dit niet aan analisten laten zien
Gedetailleerd ingaan op ETL-sessies ik zal niet doen, het is allemaal triviaal: we maken een database, daarin een tabel, verpakken alles in een contextmanager, en nu doen we het zo:
met Sessie(task_name) als sessie:
    print('Load', sessie.id, 'gestart')

    # Laad workflow
    ...

    sessie.succesvol = Waar
    sessie.geladen_rijen = 15
session.py
van sys import stderr

class Session:
    """ETL workflow sessie

    Voorbeeld:
        met Session(task_name) als sessie:
            print(sessie.id)
            sessie.successful = True
            sessie.loaded_rows = 15
            sessie.comment = 'Goed gedaan'
    """

    def __init__(self, verbinding, taak_naam):
        self.verbinding = verbinding
        self.verbinding.autocommit = True

        self._taak_naam = taak_naam
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._taak_naam

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.verbinding.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                taak_naam   VARCHAR(200) NOT NULL,

                gestart     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                beëindigd    TIMESTAMPTZ           DEFAULT current_timestamp,
                succesvol  BOOL,

                geladen_rijen INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (taak_naam, beëindigd)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'geopend')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Sessie is niet geopend')
        query = """
            UPDATE sessions
            SET
                beëindigd    = DEFAULT,
                succesvol  = %s,
                geladen_rijen = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'gesloten',
              ', succesvol: ', self.successful,
              ', Geplaatst: ', self.loaded_rows,
              ', comment:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Het is tijd om onze gegevens op te halen uit onze anderhalve honderd tabellen. Laten we dit doen met een paar eenvoudige regels:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Met de hook halen we het uit Airflow
pymssql-verbinding - We voegen een datumrestrictie aan de query toe - de sjabloonrenderer zal deze invoegen.
- We voeren onze query in
pandas, die voor ons zal ophalenDataFrame— dat zal we later nodig hebben.
Ik gebruik substitutie
{dt}in plaats van de parameters in de query%sniet omdat ik een boosaardige Pinocchio ben, maar omdatpandaskan niet omgaan metpymssqlen geeft het aan de laatste doorparams: Lijst, hoewel die dat heel graag wiltuple.
Houd er ook rekening mee dat de ontwikkelaarpymssqlheeft besloten om het niet langer te ondersteunen, en het is tijd om over te stappen naarpyodbc.
Laten we eens kijken hoe Airflow de argumenten van onze functies heeft gevuld:
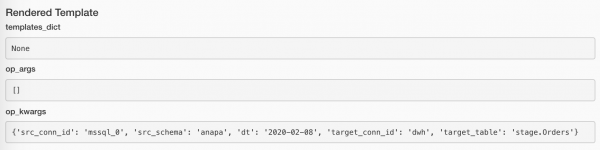
Als er geen data is, heeft het geen zin om door te gaan. Maar het is ook vreemd om te zeggen dat de upload succesvol was. Maar dit is ook geen fout. A-a-a, wat te doen?! Dit is wat:
if df.empty:
    raise AirflowSkipException('Geen rijen om te laden')
AirflowSkipException zal Airflow zeggen dat er eigenlijk geen fout is, en dat we de taak overslaan. In de interface zal er geen groene en geen rode vierkant zijn, maar in de kleur roze.
Laten we onze gegevens een paar kolommen geven:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Namelijk:
- De database waaruit we de bestellingen hebben gehaald,
- Identifier van onze uploadsessie (deze zal verschillend zijn voor elke taak),
- Hash van de bron en de identificatie van de bestelling — zodat we in de uiteindelijke database (waar alles in één tabel wordt samengevoegd) een unieke identificatie van de bestelling hebben.
We zijn bij de op één na laatste stap: alles in Vertica laden. En, zoals het toeval wil, een van de meest effectieve manieren om dit te doen – is via CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- We maken een speciale ontvanger
StringIO. pandaszal vriendelijk onsDataFramein de vorm vanCSV-regels hierin plaatsen.- Laten we de verbinding openen met onze geliefde Vertica hook.
- En nu, met behulp van
copy()sturen we onze gegevens rechtstreeks naar Vertica!
We halen het aantal rijen op dat is geladen vanuit de driver, en zeggen de sessiemanager dat alles goed is:
session.loaded_rows = cursor.rowcount
session.successful = True
Dat is alles.
In productie maken we de doeltabel handmatig aan. Hier heb ik mezelf een klein automatisme toegestaan:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Met behulp van
VerticaOperator()maak ik de database-schema en de tabel aan (als deze nog niet bestaan, natuurlijk). Het belangrijkste is om de afhankelijkheden correct in te stellen:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Laten we de balans opmaken
— Nou kijk, — zei het muisje, — is het niet waar dat nu
Ben je er zeker van dat ik het engste beest in het bos ben?
Julia Donaldson, "De Gruffalo"
Ik denk dat als mijn collega's en ik een wedstrijd zouden houden: wie het snelst een ETL-proces vanaf nul opzet en uitvoert: zij met hun SSIS en muis en ik met Airflow... En daarna zouden we ook het gemak van onderhoud vergelijken... Och, ik denk dat u het met me eens bent dat ik ze op alle fronten zal verslaan!
Serieuzer genomen, heeft Apache Airflow — door processen te beschrijven in programmeercode — mijn werk veel handiger en aangenamer gemaakt.
De onbeperkte uitbreidbaarheid: zowel qua plugs als de neiging tot schaalbaarheid — stelt je in staat om Airflow praktisch in elk domein toe te passen: of het nu gaat om de volledige cyclus van gegevensverzameling, -voorbereiding en -verwerking, of het lanceren van raketten (naar Mars, natuurlijk).
Het slotdeel, informatief en referentieel
De valkuilen die we voor jullie hebben verzameld
start_date. Ja, dat is al een lokale meme. Via het belangrijkste argument van de dagstart_datedoorlopen ze allemaal. Kort samengevat, als je destart_datehuidige datum opgeeft, en in deschedule_interval— één dag, dan wordt de DAG morgen niet eerder gestart.start_date = datetime(2020, 7, 7, 0, 1, 2)En verder geen problemen meer.
Daarmee hangt ook een andere uitvoeringsfout samen:
Task is missing the start_date parameter, wat meestal aangeeft dat je vergeten bent de DAG-operator te koppelen.- Alles op één machine. Ja, zowel de databases (van Airflow zelf en onze laag), de webserver, de planner en de werkers. En het werkte zelfs. Maar na verloop van tijd groeide het aantal taken bij de diensten, en toen PostgreSQL een antwoord op de index gaf in 20 ms in plaats van 5 ms, hebben we het verhuisd.
- LocalExecutor. Ja, we gebruiken het nog steeds, en we zijn al aan de rand van de afgrond gekomen. LocalExecutor was tot nu voldoende, maar nu is het tijd om uit te breiden met minstens één werker, en we zullen ons moeten inspannen om over te stappen op CeleryExecutor. Aangezien je daarmee zelfs op één machine kunt werken, staat niets in de weg om Celery te gebruiken op een server die "natuurlijk, nooit in productie gaat, dat beloof ik!"
- Het niet gebruiken van ingebouwde middelen:
- Connections voor het opslaan van inloggegevens van diensten,
- SLA Misses om te reageren op taken die niet op tijd zijn uitgevoerd,
- XCom voor het uitwisselen van metadata (ik zei metagegevens!) tussen de taken van de DAG.
- Misbruik van e-mail. Wat kan ik zeggen? Er waren meldingen ingesteld voor alle herhalingen van mislukte taken. Nu heb ik in mijn werk Gmail >90k e-mails van Airflow, en de webinterface van de e-mail weigert meer dan 100 tegelijk te verwerken en te verwijderen.
Meer verborgen valkuilen:
Middelen voor nog meer automatisering
Om ons nog meer met ons hoofd dan met onze handen te laten werken, heeft Airflow het volgende voor ons voorbereid:
- — het heeft nog steeds de status Experimenteel, wat niet in de weg staat dat het werkt. Hiermee kun je niet alleen informatie over DAG's en taken verkrijgen, maar ook een DAG stoppen/starts, een DAG Run of pool creëren.
- — via de opdrachtregel zijn er veel hulpmiddelen beschikbaar die niet alleen onhandig zijn om via de WebUI te gebruiken, maar soms helemaal afwezig zijn. Bijvoorbeeld:
backfillis nodig voor het opnieuw starten van instanties van taken.
Stel je voor dat analisten komen en zeggen: "U heeft, mijnheer, rommel in de gegevens van 1 tot 13 januari! Maak het, maak het, maak het!". En jij doet zo:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Onderhoud van de database:
initdb,resetdb,upgradedb,checkdb. (hetzelfde proces als, waarmee je één instantie van een taak kunt starten, zonder rekening te houden met afhankelijkheden. Bovendien kun je het starten viaLocalExecutor, zelfs als je een Celery-cluster hebt.- Ongeveer hetzelfde doet
test, maar schrijft nog niets in de database. connectionsmaakt massaal aanmaken van verbindingen vanuit de shell mogelijk.
- — een behoorlijk hardcore manier van interactie, die bedoeld is voor plugins en niet voor handmatig rommelen. Maar wie houdt ons tegen om naar
/home/airflow/dags, te gaan enipythonte starten en ons uit te leven? Je kunt bijvoorbeeld alle verbindingen exporteren met de volgende code:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Verbinding met de Airflow metadata-database. Ik raad aan hier niet in te schrijven, maar het ophalen van takenstatussen voor verschillende specifieke statistieken kan veel sneller en eenvoudiger dan via een van de API's.
Laten we zeggen dat verreweg niet al onze taken idempotent zijn, en soms kunnen ze falen en dat is normaal. Maar verschillende storingen — dat is al verdacht, en dat moet gecontroleerd worden.
Voorzichtig, SQL!
MET last_executions AS (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' DAG
),
failed AS (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM last_executions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failed
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Links
En natuurlijk, de eerste tien links uit de Google-resultaten zijn de inhoud van de Airflow-map uit mijn bladwijzers.
- — natuurlijk moet je beginnen met de officiële documentatie, maar wie leest er instructies?
- — lees in ieder geval de aanbevelingen van de makers.
- — het begin: gebruikersinterface in afbeeldingen
- — goed beschreven basisconcepten, voor het geval je iets niet begreep van mij.
- — een korte gids voor het instellen van een Airflow-cluster.
- — een bijna even interessant artikel, behalve dat het wat formeler is en minder voorbeelden bevat.
- — over werken met Celery.
- — over de idempotentie van taken, laden op ID in plaats van datum, transformaties, bestandsstructuren en andere interessante zaken.
- — afhankelijkheden van taken en Trigger Rule, die ik slechts terloops heb genoemd.
- — hoe je enkele "werkt zoals bedoeld" problemen van de planner kunt overwinnen, verloren gegevens kunt laden en prioriteiten voor taken kunt stellen.
- — nuttige SQL-query's voor de Airflow-metadata.
- — er is een nuttig gedeelte over het maken van een aangepaste sensor.
- — een interessante korte opmerking over het opbouwen van infrastructuur op AWS voor Data Science.
- — veelvoorkomende fouten (wanneer iemand de instructies toch niet leest).
- — lach even, hoe mensen het opslaan van wachtwoorden omzeilen, terwijl je gewoon Connections kunt gebruiken.
- — impliciete doorgifte van de DAG, contextinjectie in functies, opnieuw over afhankelijkheden, en ook over het overslaan van het starten van taken.
- — over het gebruik van
standaardargumentenenparamsin sjablonen, evenals over variabelen en verbindingen. - — een verhaal over hoe de scheduler voorbereid wordt op Airflow 2.0.
- — een beetje verouderd artikel over het uitrollen van onze cluster in
docker-compose. - — dynamische taken met behulp van sjablonen en contextinjectie.
- — standaard en aangepaste meldingen via e-mail en Slack.
- — vertakkingen van taken, macro's en XCom.
En de verwijzingen die in het artikel zijn gebruikt:
- — beschikbare placeholders voor gebruik in sjablonen.
- — Vaak voorkomende fouten bij het creëren van DAG's.
- —
docker-composevoor experimenten, debugging en meer. - — Python-wrapper voor de Telegram REST API.
Bron: habr.com
