

Misschien is het voor niemand een geheim dat het afgelopen jaar voor Apache Hadoop een jaar van grote veranderingen is geweest. Vorig jaar vond de fusie tussen Cloudera en Hortonworks plaats (in wezen de overname van de laatste), en Mapr werd, vanwege ernstige financiële problemen, verkocht aan Hewlett Packard. Terwijl we enkele jaren geleden bij on-premises installaties meestal moesten kiezen tussen Cloudera en Hortonworks, is die keuze vandaag de dag helaas verdwenen. Een verrassing was ook het feit dat Cloudera in februari van dit jaar aankondigde te stoppen met het uitbrengen van binaire versies van zijn distributie in de openbare repository, en nu zijn ze alleen beschikbaar op basis van een betaalde abonnement. Natuurlijk is het nog steeds mogelijk om de laatste versies van CDH en HDP, uitgebracht voor het einde van 2019, te downloaden, en ondersteuning voor deze versies wordt verwacht voor de komende een tot twee jaar. Maar wat nu? Voor degenen die eerder voor een abonnement hebben betaald, is er niets veranderd. Maar voor degenen die niet willen overstappen op de betaalde versie van de distributie, maar wel toegang willen hebben tot nieuwe versies van clustercomponenten, evenals patches en andere updates, hebben we dit artikel voorbereid. Hierin bespreken we mogelijke opties om met de huidige situatie om te gaan.
Dit artikel is voornamelijk een overzicht. Er zal geen vergelijking van distributies of een gedetailleerde analyse zijn, en er komen geen recepten voor installatie en configuratie aan bod. Wat dan wel? We zullen kort vertellen over een distributie zoals Arenadata Hadoop, die onze aandacht verdient vanwege zijn toegankelijkheid, wat tegenwoordig een zeldzaamheid is. Daarna zullen we het hebben over Vanilla Hadoop, voornamelijk over hoe je het kunt 'bereiden' met behulp van Apache Bigtop. Klaar? Dan heten we je welkom onder de kat.
Arenadata Hadoop
Dit is een geheel nieuwe en, tot nu toe, weinig bekende distributie van nationale ontwikkeling. Helaas is er op dit moment op Habr slechts .
Meer gedetailleerde informatie is te vinden op de officiële van het project. De laatste versies van de distributie zijn gebaseerd op Hadoop 3.1.2 voor versie 3 en 2.8.5 voor versie 2.
Informatie over de roadmap is te vinden .
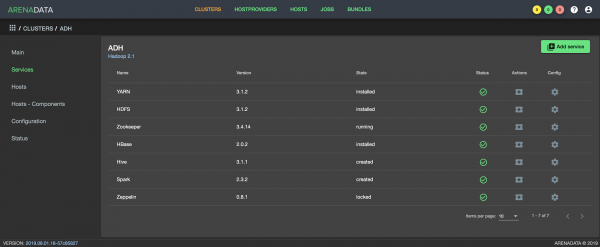
De interface van Arenadata Cluster Manager
Het belangrijkste product van Arenadata is , dat wordt gebruikt voor de installatie, configuratie en monitoring van verschillende software-oplossingen van het bedrijf. ADCM is gratis beschikbaar en de functionaliteit wordt uitgebreid door het toevoegen van bundels, die een set ansible-playbooks vertegenwoordigen. De bundels worden onderverdeeld in twee soorten: enterprise en community. Laatstgenoemden zijn gratis te downloaden van de website van Arenadata. Er is ook de mogelijkheid om een eigen bundel te ontwikkelen en deze aan ADCM te koppelen.
Voor de deployment en het beheer van Hadoop 3 is er een community-versie van de bundel in combinatie met ADCM, en voor Hadoop 2 is er enkel als alternatief. Wat betreft de pakketrepositories, deze zijn openbaar toegankelijk en kunnen op de gebruikelijke manier worden gedownload en geïnstalleerd voor alle componenten van het cluster. Over het algemeen ziet de distributie er zeer interessant uit. Ik ben er zeker van dat er mensen zijn die gewend zijn aan oplossingen zoals Cloudera Manager en Ambari, en die ADCM aantrekkelijk zullen vinden. Voor sommigen zal het een groot pluspunt zijn dat de distributie voor importvervanging.
Wat de nadelen betreft, deze zijn dezelfde als die van alle andere Hadoop-distributies. Namelijk:
- De zogenaamde 'vendor lock-in'. Aan de hand van Cloudera en Hortonworks hebben we al geleerd dat er altijd een risico is van het veranderen van bedrijfsbeleid.
- Een aanzienlijke achterstand ten opzichte van upstream Apache.
Vanilla Hadoop
Zoals u weet, is Hadoop geen monolithisch product, maar in feite een hele reeks services rond zijn gedistribueerde bestandssysteem HDFS. Weinig mensen zullen genoeg hebben aan slechts één bestandcluster. De een heeft Hive nodig, de ander Presto, en er zijn ook HBase en Phoenix, terwijl Spark steeds vaker wordt gebruikt. Voor orkestratie en gegevenslading komen we soms Oozie, Sqoop en Flume tegen. En als het gaat om beveiliging, dan denken we meteen aan Kerberos in combinatie met Ranger.
Binaire versies van Hadoop-componenten zijn beschikbaar op de website van elk van de projecten binnen het ecosysteem in de vorm van tarballs. Je kunt ze downloaden en beginnen met installeren, maar met één voorwaarde: naast het zelf samenstellen van pakketten uit 'ruwe' binaire bestanden, waarvan je hoogstwaarschijnlijk wilt dat je dit doet, heb je geen enkele garantie dat de versies die je hebt gedownload onderling compatibel zijn. Een betere optie is om te bouwen met behulp van Apache Bigtop. Bigtop stelt je in staat om te bouwen vanuit de Maven-repositories van Apache, tests uit te voeren en pakketten te maken. Maar, wat voor ons heel belangrijk is, Bigtop zal die versies van componenten samenstellen die onderling compatibel zijn. Hierover zullen we verderop meer gedetailleerde informatie geven.
Apache Bigtop
Apache Bigtop is een tool voor het bouwen, verpakken en testen van een reeks
open source-projecten, zoals Hadoop en Greenplum. Bigtop heeft veel
versies. Op het moment van schrijven was de laatste stabiele versie 1.4,
terwijl in master 1.5 aanwezig was. In verschillende versies worden verschillende versies van
componenten gebruikt. Bijvoorbeeld, voor 1.4 hebben de core-componenten van Hadoop versie 2.8.5, terwijl in master
2.10.0 wordt gebruikt. Ook de samenstelling van de ondersteunde componenten verandert. Verouderde en
niet-geüpdatete onderdelen verdwijnen, terwijl nieuwe, meer gevraagde onderdelen naar voren komen, en
het hoeft niet per se iets te zijn uit de Apache-familie.
Daarnaast heeft Bigtop veel .
Toen we kennismaakten met Bigtop, waren we in de eerste instantie verrast door de bescheidenheid, in vergelijking met andere Apache-projecten, van de verspreiding en bekendheid, evenals de zeer kleine community. Hieruit volgt dat er minimale informatie over het product beschikbaar is, en het zoeken naar oplossingen voor opkomende problemen via forums en mailinglijsten kan zelfs niets opleveren. Aanvankelijk bleek het voor ons een uitdagende taak om een volledige distributie samen te stellen vanwege de aard van de tool, maar daarover vertellen we iets later meer.
Als teaser: voor degenen die in de tijd dat Linux-projecten zoals Gentoo en LFS populair waren, iets vergelijkbaars leuk vonden, zal het wellicht nostalgisch aanvoelen om met deze tool te werken en die 'gelijke' tijden te herinneren, waarin we zelf ebuilds zochten (en soms schreven) en regelmatig nieuwe patches voor Mozilla samenstelden.
Een van de grote voordelen van Bigtop is de openheid en veelzijdigheid van de tools waarop het is gebaseerd. De fundamenten bestaan uit Gradle en Apache Maven. Gradle is vrij goed bekend als de tool waarmee Google Android samenstelt. Het is flexibel en, zoals men zegt, 'in de strijd bewezen'. Maven is de standaardtool voor het bouwen van projecten in Apache zelf, en aangezien de meeste producten via Maven worden uitgegeven, kan het hier niet worden genegeerd. Een belangrijk aspect is het POM (project object model) – een 'fundamenteel' xml-bestand dat alles beschrijft wat nodig is voor Maven om met uw project te werken, waarop al het werk is gebouwd. Het is precies in
het deel van Maven waar enkele obstakels ontstaan, waar beginners vaak tegenaan lopen wanneer ze voor het eerst met Bigtop aan de slag gaan.
Praktijk
Dus, waar beginnen we? Laten we naar de downloadpagina gaan en de laatste stabiele versie in de vorm van een archief downloaden. Daar vindt u ook de binaire artefacten die door Bigtop zijn samengesteld. Overigens worden de gangbare pakketbeheerders YUM en APT ondersteund.
Een alternatieve manier is om de laatste stabiele release rechtstreeks van
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitKlont in 'bigtop'…
remote: Objecten aan het tellen: 46, klaar.
remote: Tellen van objecten: 100% (46/46), klaar.
remote: Comprimeren van objecten: 100% (41/41), klaar.
remote: Totaal 40217 (delta 14), hergebruikt 10 (delta 1), pack-hergebruikt 40171
Objecten verkrijgen: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, klaar.
Wijzigingen vaststellen: 100% (20503/20503), klaar.
Bestanden bijwerken: 100% (1998/1998), klaar.
De resulterende map .\/bigtop ziet er ongeveer zo uit:
.\/bigtop-bigpetstore — demonstratie-applicaties, synthetische voorbeelden
.\/bigtop-ci — CI-tools, jenkins
.\/bigtop-data-generators — gegevensgeneratie, synthetisch, voor smoke-tests, enz.
.\/bigtop-deploy — tools voor uitrol
.\/bigtop-packages — configuraties, scripts, patches voor de samenstelling, het belangrijkste deel van de tool
.\/bigtop-test-framework — testframework
.\/bigtop-tests — de tests zelf, belasting- en smoke-tests
.\/bigtop_toolchain — bouwomgeving, voorbereiding van de omgeving voor de werking van de tool
.\/build — werkdirectory voor de bouw
.\/dl — directory voor gedownloade bronnen
.\/docker — bouwen in docker-images, testen
.\/gradle — gradle-configuratie
.\/output — directory waar de bouwartefacten binnenkomen
.\/provisioner — provisioning
Het meest interessante in dit stadium voor ons is de belangrijkste configuratie .\/bigtop\/bigtop.bom, waarin we alle ondersteunde componenten met versies zien. Hier kunnen we een andere productversie opgeven (als we deze willen uitproberen) of de buildversie (bijvoorbeeld als we een aanzienlijke patch hebben toegevoegd).
Ook de subdirectory .\/bigtop\/bigtop-packages, die rechtstreeks verband houdt met het proces van het bouwen van componenten en pakketten.
Dus, we hebben het archief gedownload, uitgepakt of een kloon van GitHub gemaakt, kunnen we beginnen met bouwen?
Nee, laten we eerst de omgeving voorbereiden.
Omgeving voorbereiden
En hier is een kleine toelichting nodig. Voor het bouwen van vrijwel elk meer of minder geavanceerd product is een bepaalde omgeving vereist — in ons geval is dat JDK, de benodigde gedeelde bibliotheken, headerbestanden, enz., tools zoals ant, ivy2 en nog veel meer. Een van de manieren om de benodigde omgeving voor Bigtop te krijgen, is door de benodigde componenten op de build-host te installeren. Ik kan de chronologie fout hebben, maar het lijkt erop dat vanaf versie 1.0 ook de optie om in vooraf geconfigureerde en beschikbare Docker-images te bouwen, is toegevoegd; daar kun je hier meer over lezen.
Wat betreft de voorbereiding van de omgeving, hiervoor is er een helper — Puppet.
Je kunt de volgende commando's gebruiken, het uitvoeren gebeurt vanuit de hoofdmap
tool, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
Of rechtstreeks via Puppet:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"Helaas kunnen zich al in deze fase problemen voordoen. Een algemene tip is om een ondersteunde distributie te gebruiken, die up-to-date is op de build-host, of probeer de weg met Docker.
Bouwen
Wat kunnen we proberen te bouwen? Het antwoord op deze vraag wordt gegeven door de uitvoer van het commando
.\/gradlew tasks In de sectie Package-taken zijn er verschillende producten die eindartefacten van Bigtop zijn.
Ze kunnen worden herkend aan de suffix -rpm of -pkg-ind (in het geval van een build
in Docker). In ons geval is het meest interessant Hadoop.
Laten we proberen de build uit te voeren in de omgeving van onze build-server:
.\/gradlew hadoop-rpmBigtop download de benodigde bronbestanden die specifiek zijn voor de component en begint met de opbouw. Op deze manier is het werk van de tool afhankelijk van Maven-repositories en andere bronnen, wat betekent dat het toegang tot het internet nodig heeft.
Tijdens de werking ontstaat er een standaarduitvoer. Soms kan je aan deze uitvoer of foutmeldingen begrijpen wat er mis is gegaan. Soms is het nodig om extra informatie te verkrijgen. In dat geval is het verstandig om argumenten toe te voegen. --info of --debug, en kan ook nuttig zijn –stacktrace. Er is een handige manier om een set gegevens te genereren voor latere verwijzing in distributielijsten, het sleutelwoord --scan.
Met deze sleutel verzamelt bigtop alle informatie en plaatst deze in gradle, waarna het een link geeft,
waar je op kunt klikken zodat een bevoegde persoon kan begrijpen waarom de build is mislukt.
Houd er rekening mee dat deze optie ongewenste informatie voor jou openbaar kan maken, zoals gebruikersnamen, knooppunten, omgevingsvariabelen, enzovoort, dus wees voorzichtig.
Vaak zijn fouten het gevolg van de onmogelijkheid om sommige noodzakelijke componenten voor de build te verkrijgen. Gewoonlijk kan het probleem worden opgelost door een patch te maken om iets in de bronbestanden te corrigeren, bijvoorbeeld een adres in pom.xml in de hoofdmap van de bronnen. Dit wordt gedaan door deze te creëren en in de juiste map te plaatsen. .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ Een patch, bijvoorbeeld in de vorm van patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@


central
- http:\/\/repo1.maven.org\/maven2
+ https:\/\/repo1.maven.org\/maven2

false
Waarschijnlijk hoef je de bovenstaande correctie niet zelf te maken op het moment dat je dit artikel leest.
Bij het toepassen van patches en wijzigingen in het buildmechanisme kan het nodig zijn om de build "te resetten" via de schoonmaakopdracht:
.\/gradlew hadoop-clean
> Taak :hadoop_vardefines
> Taak :hadoop-clean
BUILD SUCCESSFUL in 5s
2 uitvoerbare taken: 2 uitgevoerd
Deze operatie herstelt alle wijzigingen die zijn aangebracht in de build van deze component, waarna de build opnieuw zal worden uitgevoerd. Dit keer proberen we het project te bouwen in een docker-image:
.\/gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Taak :hadoop-pkg-ind
Aan het bouwen van 1.2.1 hadoop-pkg op centos-7 in Docker...
+++ dirname .\/bigtop-ci\/build.sh
++ cd .\/bigtop-ci\/..
++ pwd
+ BIGTOP_HOME=\/tmp\/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ sleutel=--prefix
+ case $sleutel in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ sleutel=--os
+ case $sleutel in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ sleutel=--target
+ case $sleutel in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop\/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop\/slaves:1.2.1-centos-7 \/sbin\/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
veel uitvoer
....
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-secondarynamenode-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-journalnode-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-resourcemanager-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-nodemanager-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-proxyserver-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-timelineserver-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-historyserver-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-client-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Geschreven: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ cd hadoop-2.8.5-src
+ \/usr\/bin\/rm -rf \/bigtop\/build\/hadoop\/rpm\/BUILDROOT\/hadoop-2.8.5-1.el7.x86_64
Uitvoeren(%clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Uitvoeren(--clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.CwDb22
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Aanmaken \/bigtop\/build\/hadoop\/.rpm
:hadoop-rpm (Thread[Taakwerker voor ':',5,main]) voltooid. Duurde 38 minuten 1.151 seconden.
:hadoop-pkg (Thread[Taakwerker voor ':',5,main]) gestart.
> Taak :hadoop-pkg
Taak ':hadoop-pkg' is niet up-to-date omdat:
Taak heeft geen uitvoer gedeclareerd ondanks het uitvoeren van acties.
:hadoop-pkg (Thread[Taakwerker voor ':',5,main]) voltooid. Duurde 0.0 seconden.
BOUW SUCCESVOL in 40m 37s
6 uitvoerbare taken: 6 uitgevoerd
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Fout: Geen dergelijke container:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BOUW SUCCESVOL in 41m 24s
1 uitvoerbare taak: 1 uitgevoerd
De build is uitgevoerd onder CentOS, maar kan ook onder Ubuntu worden uitgevoerd:
./gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indNaast het bouwen van pakketten voor verschillende Linux-distributies, kan de tool ook een repository met de gebouwde pakketten maken, bijvoorbeeld:
./gradlew yumOok kunnen we de smoke-tests en de implementatie in Docker niet vergeten.
Een cluster met drie nodes aanmaken:
./gradlew -Pnum_instances=3 docker-provisionerVoer smoke-tests uit in een cluster met drie nodes:
./gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerVerwijder het cluster:
./gradlew docker-provisioner-destroyKrijg commando's om binnen de docker-containers te verbinden:
./gradlew docker-provisioner-sshToon de status:
./gradlew docker-provisioner-statusVoor meer details over Deployment-taken kunt u de documentatie lezen.
Als het gaat om tests, zijn er voldoende, voornamelijk smoke- en integratietests. Een grondige analyse daarvan valt buiten het bereik van dit artikel. Ik zeg alleen dat het bouwen van de distributie niet zo'n complexe taak is als het op het eerste gezicht lijkt. Alle componenten die we in productie gebruiken, zijn succesvol gebundeld en er zijn tests doorlopen, en we hebben ook geen problemen ondervonden met de implementatie en het uitvoeren van basisoperaties in de testomgeving.
Naast de bestaande componenten in Bigtop, is het ook mogelijk om iets anders toe te voegen, zelfs uw eigen softwareontwikkeling. Dit wordt uitstekend geautomatiseerd en past binnen het CI/CD-concept.
Conclusie
Het is duidelijk dat een op deze manier gebouwde distributie niet meteen naar productie gestuurd moet worden. Men moet begrijpen dat als er een echte behoefte is aan het bouwen en onderhouden van uw eigen distributie, hier financieel en qua tijd in geïnvesteerd moet worden.
Toch kan het, in combinatie met de juiste aanpak en een professioneel team, mogelijk zijn om zonder commerciële oplossingen toe te kunnen.
Het is belangrijk op te merken dat het Bigtop-project zelf ontwikkeling nodig heeft en het lijkt erop dat er op dit moment geen actieve ontwikkelingen plaatsvinden. Ook is de toekomst van het verschijnen van Hadoop 3 daarin onduidelijk. Ter info, als u een echte behoefte heeft aan het bouwen van Hadoop 3, kunt u kijken naar van Arenadata, dat naast de standaard
componenten ook een aantal aanvullende bevat (Ranger, Knox, NiFi).
Wat betreft Rostelecom, is Bigtop voor ons een van de overweegde mogelijkheden op dit moment. Of we uiteindelijk voor deze keuze gaan of niet, zal de tijd leren.
Aanvulling
Om een nieuwe component aan de bundel toe te voegen, moet je de beschrijving ervan toevoegen aan bigtop.bom en ./bigtop-packages. Je kunt dit proberen te doen aan de hand van bestaande componenten. Probeer te begrijpen. Het is niet zo moeilijk als het op het eerste gezicht lijkt.
Wat denken jullie? We kijken ernaar uit om jullie mening in de reacties te zien en bedankt voor jullie aandacht!
Dit artikel is voorbereid door het data management team van "Rostelecom"
Bron: habr.com
