

door St-Pete
Hallo iedereen! Ik ben Mons Anderson, platformarchitect , en ik ga uitleggen hoe we onze S3-opslag hebben gebouwd, hoe het werkt, welke oplossingen succesvol waren en welke we zouden veranderen als we dit project nu opnieuw zouden starten.
Dit artikel is gebaseerd op een presentatie op door Mail.ru Cloud Solutions & Tarantool. In dit artikel bespreken we:
- hoe de opslag van Mail.ru was ingericht, waar we de S3-opslag op hebben gebouwd;
- wat we hebben toegevoegd om Mail.ru Cloud Storage te maken;
- hoe het objectmodel voor opslag werkt en welke stappen zijn gezet om naar productie te gaan;
- over verbeteringen aan het productie-systeem: failover en schaling;
- hoe we sharding en re-sharding hebben geïmplementeerd;
- en ook over het werken met SSL-certificaten.
Als je niet wilt lezen, kun je .
Hoe de opslag van Mail.ru was ingericht, waar we de S3-opslag op hebben gebouwd
De ontwikkeling van onze S3 is begonnen bovenop de opslag van Mail.ru Cloud, dus eerst moeten we uitleggen hoe het is opgebouwd en wat het kan.
De cloudopslag van Mail.ru bestaat uit servers met schijven. Gemiddeld is een moderne storage-server voorzien van 36 schijven van 12–14 terabyte. Eerder waren de schijven kleiner, maar in de afgelopen drie jaar zijn de schijfcapaciteiten gegroeid en momenteel is het bijna een halve petabyte aan ruwe data.
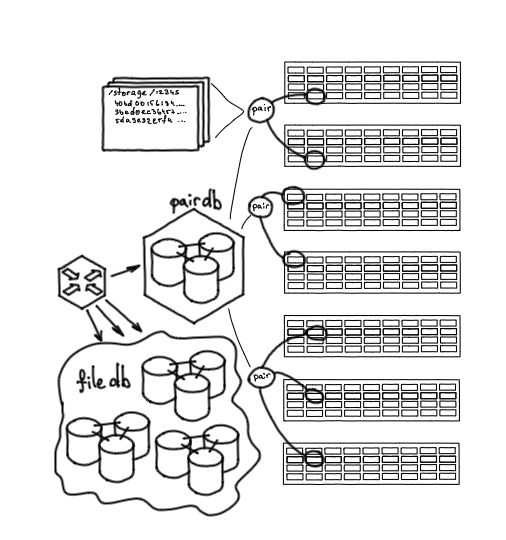
De schijven van verschillende opslagservers worden gecombineerd in zogenaamde 'paren'. Een paar is een enkele opslagunit voor bestanden. In wezen is dit een schijf die is gemonteerd in een bepaalde partitie op een specifieke locatie, waar bestanden kunnen worden opgeslagen, geïdentificeerd door hashes.
Een paar is een historische benaming, die tot op heden is behouden, hoewel het in een paar niet per se alleen om twee schijven hoeft te gaan. Er kunnen drie schijven zijn, en er kunnen ook verschillende hybride opslagmethoden zijn, bijvoorbeeld 3/2.
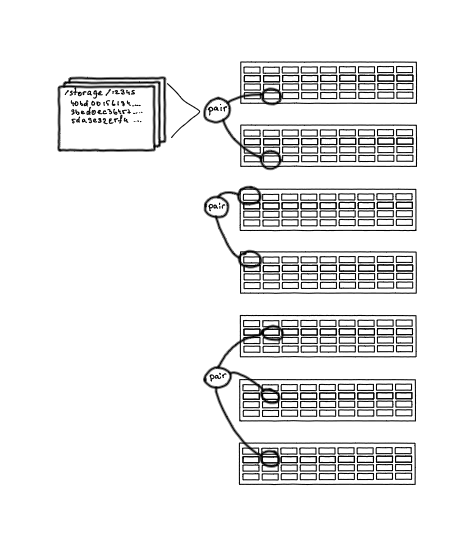
Paren (pair) - opslagunits voor objecten
Alle paren worden opgeslagen in PairDB - een applicatie gebaseerd op Tarantool. Alle databases in onze opslag, vanaf de vroegste, zijn Tarantool, we gebruiken geen andere databases.
PairDB slaat alle paren, hun status, vrije ruimte, fail-overmogelijkheden, en recente fouten op. Het kan ook zelf naar de paren gaan om hun status te actualiseren en te controleren of ze werken. Dus PairDB biedt een algemeen overzicht van de status van alle schijven in ons systeem.
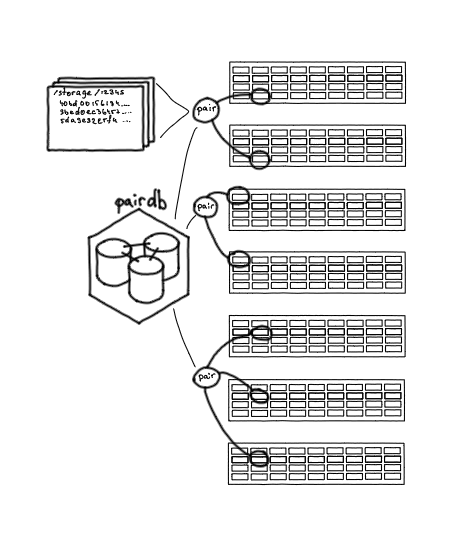
Pair DB: database met de status van paren
Op de paren worden bestanden opgeslagen, en om te weten welk bestand zich op welk paar bevindt, is een andere database nodig — FileDB. Deze slaat de mapping op, die de overeenkomst definieert: dat bestand behoort tot dit paar, evenals een klein aantal benodigde attributen.
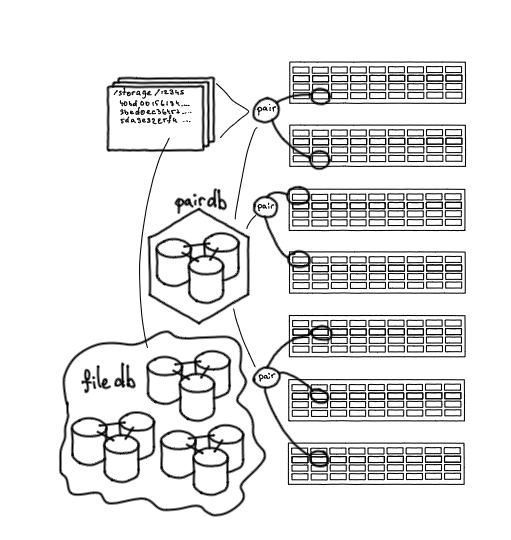 File DB: de plaats waar het bestand wordt opgeslagen
Een andere belangrijke schakel is de service Nylon, een router voor het werken met databases. Hij is het enige toegangspunt en maakt het mogelijk om via één interface met zowel PairDB als FileDB te werken. Dit is een stateless-service die verzoeken balanceert, begrijpt naar welk shard van FileDB moet worden gegaan, en weet welke paren actief zijn en welke niet.
Nylon: router voor het werken met databases
Daarnaast is er ook een manier om inhoud in de opslag te plaatsen. Hiervoor hebben we een service — Streamer. Deze biedt twee HTTP-methoden: de PUT-methode om inhoud naar de opslag te uploaden, en de GET-methode om het daaruit te halen. HTTP is een vrij populair en handig protocol voor gegevensoverdracht.
Wanneer we Streamer aanroepen, vraagt hij via Nylon aan PairDB op welk paar het bestand kan worden geüpload, waarna hij de gegevens via WebDAV naar dat paar doorstuurt.
In wezen is elke storage server een nginx plus schijven die op de aangegeven paden zijn gemonteerd. We kunnen vanuit Streamer een bestand naar de opslag uploaden, het verwijderen, hernoemen of integriteitscontroles uitvoeren. Dat wil zeggen dat dit een handige interface is voor laagdrempelige interactie met de opslag.
Streamer: toegangspunt tot de opslag
Wat we hebben toegevoegd om de S3-opslag te maken
Dus, we hebben de algemene basisstructuur van de opslag bekeken op het moment dat we van plan waren om de S3-opslag te lanceren. Met de PUT-methode konden we willekeurige inhoud daar plaatsen en kregen we als identificatie van die gegevens een hash. Met deze identificatie konden we later terugkomen en het oorspronkelijke bestand ophalen. Maar dit is niet voldoende voor de implementatie van S3. In het S3-protocol, naast de opslag van objecten, zijn er:
- opslag van metadata — aanvullende eigenschappen van objecten;
- organisatie van toegang tot objecten via HTTP;
- groepering van objecten in collecties — buckets;
- HTTP-S3 Endpoint. S3 organiseert gegevens in bepaalde structuren — buckets, die elk een toegangspunt bieden voor het opslaan van bestanden.
Voor de implementatie van deze logica was een aparte service nodig. We wilden ook meteen de architectuur voor toekomstige groei van de service met lineaire schaalbaarheid overwegen.
Eerste componenten
Een demon die de S3 API implementeert. Dit is de standaard S3 API van Amazon, die XML ondersteunt voor metadata en het mogelijk maakt om content direct over te dragen. We hoefden niets uit te vinden, alles is beschreven en gedocumenteerd.
Ook hebben we Nginx voor de service geplaatst. Dit gebruikten we voor SSL-terminatie, load balancing en voor een deel van de logica op Lua (metrics, logging en tracing).
Voor het opslaan van S3-metadata kozen we ook voor Tarantool. In de eerste versie ging de S3-demon naar deze database voor metadata, terwijl de content in een grote opslag werd bewaard via Streamer.
Nginx + S3 API + metadata
Objectmodel voor opslag
Laten we eens kijken hoe S3 werkt. Een gebruiker kan een bucket maken — een collectie van objecten. De bucket wordt aangesproken met de hostnaam en is een subdomein van de service. Binnen de bucket kan de gebruiker objecten creëren. De identificatie van een object is de URL. De inhoud van het object is een blob, een array van binaire gegevens die we in de opslag zullen bewaren. Het object heeft ook attributen: de naam — dat is diezelfde URL, ACL (Access Control List), en andere aanvullende of willekeurige attributen — dit alles wordt bewaard in de metadata.
Een genormaliseerd schema van deze gegevens kan er als volgt uitzien: er zijn projecten die de buckets bezitten, die op hun beurt de objecten bezitten, en de objecten kunnen samengesteld zijn. Aangezien een object op delen kan worden geüpload, zijn er twee hulptabellen voor de upload: uploads en chunks. Ook hebben projecten inloggegevens voor toegang en facturatie.
Gegevensschema
Omdat we een b2b-service met betaalde toegang maakten, was er in dit schema behoefte aan facturatie.
De facturatieservice hebben we ook op Tarantool geïmplementeerd.
Verbeteringen van de S3-opslag: stappen naar productie
We hebben al een werkend model gemaakt dat kan worden gebruikt: objecten en metadata werden opgeslagen, maar voor de productie-implementatie ontbraken nog enkele zaken.
Ten eerste is er het rate-limiting systeem. Als we de service zonder dit systeem starten, kunnen we bij een piekbelasting onvoorspelbaar een deel van het systeem overbelasten. Het rate-limiting moet als volgt werken: elke S3-aanroep komt aan bij een specifieke host, en deze host is de identifier van de bucket, die toebehoort aan een bepaalde klant. We moeten een functie definiëren op basis van de bucket waarmee het rate-limiting kan worden berekend.
Bovendien moet het rate-limiting systeem voldoende performant zijn om de belasting die op S3 binnenkomt te kunnen verwerken.
Hier hebben we opnieuw Tarantool gebruikt. De rate-limiting bestaat uit een cluster van 21 instanties, verdeeld over groepen, verspreid over drie fysieke knooppunten en samengevoegd in een grote topologische cluster. Configuratie wijzigingen worden automatisch verspreid: er worden rate-limits, standaardwaarden en configuraties ingesteld. Elke bucket wordt strikt door één instantie bediend. Wanneer er een verzoek voor een specifieke bucket binnenkomt, wordt de instantie berekend die verantwoordelijk is voor deze bucket. Binnen dit knooppunt wordt het huidige aanvraagpercentage geteld met een algoritme dat lijkt op Token Bucket. Daarna bepaalt het rate-limiting systeem, op basis van de huidige belasting en de eigenschappen die voor de specifieke bucket zijn ingesteld, of het verzoek kan worden uitgevoerd of niet. De limietcontrole vindt plaats in de vroegste fase van de uitvoering van de S3-aanroep, waardoor alle andere elementen van het systeem worden beschermd tegen overbelasting.
Ook onder belasting is het behoorlijk moeilijk om zonder cache te werken. In S3 is het aantal keren dat naar dezelfde objecten wordt verwezen impliciet, wat betekent dat dit een hot storage is. Normaal gesproken wordt een verzoek aan een individueel bestand afgehandeld door de volledige keten: Streamer, FileDB, PairDB, Storage. Maar bij herhaaldelijk verzoek naar een bestand optimaliseren we de toegang tot deze inhoud met behulp van een lokale cache.
De cache is gelaagd en gerealiseerd met behulp van nginx, lokale SSD's en RAM-schijven. Hier hebben we geen Tarantool gebruikt, omdat het handiger is om objecten vanuit het bestandssysteem te leveren, zodat we caching kunnen tier-en. Bovendien hebben we grote objecten met een maximale grootte van 32 gigabyte, terwijl in Tarantool alleen kleine objecten gecached kunnen worden.
Dit was het eerste systeem waarmee we zijn gestart, en het had een bepaalde berekende capaciteit, die voldoende was voor het verkennen en begrijpen van het product en om ervoor te zorgen dat het zou werken.
Verbeteringen van het gevechtssysteem: failover en schaling
Het systeem was al operationeel, maar we hadden bij de opstart iets gemist - we moesten failover en schaling toevoegen.
Onze S3-daemon haalde metadata op via het Tarantool-protocol. We hebben Tarantool geïnstalleerd als de originele database, en dit fungeerde als een proxy-router voor metadata-verzoeken. Vanuit het perspectief van de toepassing die de API implementeerde, was er niets veranderd - het bleef de database aanspreken via het Tarantool-protocol, maar de router kon actieve failover bieden. Dit betekende dat we de beschikbaarheid van knooppunten konden controleren, pauzes konden inlassen tijdens overschakelingen en storingen, enzovoort. De toepassing zelf hebben we niet aangepast.
Meer over hoe we sharding hebben geïmplementeerd
De volgende kwestie die onze aandacht vroeg, was sharding. Het systeem groeide, het aantal objecten nam toe en we moesten mogelijkheden voor verdere groei waarborgen.
Laten we terugkeren naar het datamodel: er zijn projecten, buckets, credentials en facturering. Dit zijn objecten die in de nabije toekomst waarschijnlijk niet boven een enkele instantie zullen groeien, zowel in termen van volume als van verzoeken. Daarom heeft het geen zin om ze te sharden, en we hebben ze in een aparte instantie geplaatst die niet is geschard. Dit stelt ons in staat om projecten en buckets consistenter te beheren, aangezien er een enige niet-gescharde plek is.
Daarnaast zijn er in het model objecten die lineair groeien - eerst waren het er enkele honderden duizenden, nu loopt het aantal op in de miljarden. Dergelijke objecten, samen met hun onderdelen, moesten we naar een gescharde cluster verplaatsen.
We hebben het model gesplitst, maar objecten moeten met buckets werken: een object behoort altijd tot een specifieke bucket, plus de bucket heeft een ACL. Daarom houden we voor elke shard met objecten een schaduwkopie van elke bucket. Bovendien, tijdens het wijzigen van objecten en het verwerken van verzoeken, moet het volume voor facturering worden geteld, dus elke shard heeft factureringsmeters.
We hebben ook nog een paar tabellen en componenten toegevoegd:
- een prullenbak voor het verwijderen van oude projecten die worden verwijderd of bevroren;
- een wachtrij voor achtergrondtaken, wat betekent dat de primaire opslag achtergrondtaken kan uitvoeren die gedaan moeten worden op het cluster;
- ondersteuning voor lifecycle - een mechanisme dat het mogelijk maakt om met objecten te werken en hun levenscyclus te beheren.
Aangezien we een deel van de gegevens naar shards hebben verplaatst, was er een sharding proxy nodig. We zouden de router voor deze rol kunnen hergebruiken, maar een aparte sharding proxy, die alleen verantwoordelijk is voor het sharden van de gegevens, maakt het mogelijk om vanuit de router naar de gegevens te gaan zonder te denken aan sharding.
Ik zal apart uitleggen waarom we geen kant-en-klaar oplossing hebben genomen, maar een aangepaste functie voor sharding wilden maken.
Laten we eens kijken hoe het is ingericht. We hebben 256 beschikbare shards. Voor elke bucket reserveren we een bereik met behulp van een bepaalde consistente functie. Dit is eenvoudig: net zoals je met een consistente functie de toewijzing aan een shard bepaalt, bepaal je het startshard en reserveer je een bereik:
f(bucket, shards) = subset
Dat wil zeggen dat als je een bucket neemt, je kunt zeggen dat deze en zijn gegevens altijd zullen liggen op een specifieke subset van alle shards. Dit vermindert de invloed van de ene bucket op de andere en vereenvoudigt het werken met map-reduce queries, bijvoorbeeld wanneer je een lijst van objecten in een bucket wilt maken. Hiervoor moet je alle shards raadplegen waar deze objecten zijn opgeslagen. Als de objecten over alle shards verspreid zouden zijn, zou elke listing het hele systeem beïnvloeden, maar hier raakt het alleen een specifieke subset.
Verder behoort elk object tot een specifieke bucket, dus wanneer we een object opvragen, doen we dit op basis van de naam in een specifieke bucket. Dit betekent dat we een functie voor een object kunnen definiëren niet uit het volledige beschikbare bereik van shards, maar alleen uit de subset van zijn bucket:
f(object, subset) = shard
We nemen een specifiek object, en als argumenten voor de functie geven we niet alle shards door, maar de subset van zijn bucket - en we krijgen het specifieke shard.
Dus, sharding is geïmplementeerd, er is een sharding proxy. Daarna blijft het om vanuit de router en de database met metadata naar de sharding proxy te schakelen. Bijvoorbeeld voor het creëren van objects van schaduwkopieën - wanneer we een bucket creëren, moet de primaire opslag een vertegenwoordiger van deze bucket op alle shards aanmaken waar deze aanwezig moet zijn.
Hoe we resharding hebben geïmplementeerd
Het grootste probleem van sharding is re-sharding. Het was belangrijk voor ons om dit zonder downtime te doen, aangezien het systeem al in productie was. Ik laat zien hoe we het probleem hebben opgelost aan de hand van een vergelijkbare taak met live migratie van gegevens van het ene project naar het andere.
Hieronder zie je het schema van ons cluster, dat is ontstaan na de implementatie van sharding. We hebben nginx, S3 API, een router, een primaire database met projecten, een sharding proxy en de shard zelf.
Eerder heb ik verzuimd te vermelden dat er op een bepaald moment in het project een productvraag was: 'Start nog een opslag, Icebox, als Hotbox, maar dan voor koude gegevens.' Eigenlijk is het een soortgelijke opslag, maar met andere URL's en zonder caches.
Icebox werd minder gebruikt dan Hotbox, dus het kwam een lange tijd zonder enige sharding. Uiteindelijk hebben we besloten om het op te geven en Hotbox en Icebox samen te voegen in één service, gewoon door de opslagklassen te splitsen.
De buckets in de opslagen waren niet overlapping, ze konden gemakkelijk worden samengevoegd en verplaatst, maar klanten gebruikten zowel de ene als de andere opslag, dus we moesten het probleem van de afwezigheid van downtime oplossen. We konden niet gewoon uitschakelen en kopiëren. We hebben de migratie in verschillende fasen uitgevoerd.
Als eerste hebben we de primaire opslag gesynchroniseerd. We hadden Tarantool en konden bij het aanmaken van een object het volgende doen:
- de database ontvangt een verzoek om een bucket aan te maken, bijvoorbeeld in Hotbox;
- Tarantool controleert in een andere database (in dit geval in Icebox) of zo'n bucket niet bestaat;
- als de bucket bestaat, zegt de database dat hij niet kan worden aangemaakt en synchroniseert hij als bestaand.

Synchronisatie van buckets
In die opslag, die alle gegevens zou moeten ontvangen, introduceerden we voor projecten en buckets een kenmerk dat aangeeft waar dit object is opgeslagen. Het kon lokaal worden opgeslagen, dat wil zeggen in Hotbox, in Icebox — dan zijn er geen gegevens van dat object in de nieuwe opslag, of het kon zijn in de staat van migratie.
Als een project of bucket het kenmerk Migrating had, dan werd tijdens de migratie het verzoek eerst uitgevoerd in de nieuwe opslag, waar de gegevens zouden moeten zijn, en als daar niets was, werden de verzoeken doorgestuurd naar de alternatieve opslag.
Daarna hebben we het verkeer omgeleid. Aangezien de API zowel verzoeken van Icebox als verzoeken van Hotbox kon verwerken, konden we het verkeer zonder downtime omleiden door gewoon de hosts te verplaatsen en de juiste records aan Nginx toe te voegen.
Nadat het verkeer was omgeleid, konden Nginx en de API van Icebox worden verwijderd.
Daarna hebben we Icebox nginx en S3 API verwijderd — en het werkte meteen:
Vervolgens hebben we een achtergrondproces voor migratie gestart dat binnen de database draait — het doorloopt elk project en hun buckets, zet ze op de status Migrating, verplaatst de gegevens en stelt na voltooiing de status in op Local.
Na de gegevensmigratie hebben we geen oude opslag meer nodig, en verwijderen we de resterende onderdelen van het oude systeem en verwijderen we de ondersteuning voor de migratiestatus uit de code.
De herverdeling van de oude opslag naar de geschardinaiseerde opslag werd op dezelfde principes uitgevoerd:
- Alle buckets werden gemarkeerd als
Non-sharded. Alle verzoeken gingen naar de originele, niet-geschardinaiseerde opslag. - Nieuwe buckets werden meteen in de status
Sharded. - gezet. Eén voor één namen we de buckets, stelden de status in op
Migratingen verplaatsten we de gegevens.
Verzoeken werden behandeld volgens het principe:
- Lezen in de nieuwe, daarna in de oude.
- Alleen in de nieuwe creëren.
- Bijwerken in twee fasen: als het er niet is in de nieuwe, verplaatsen we het van oud naar nieuw, daarna werken we bij.
Werken met SSL-certificaten
Aan de frontend gebruiken we Nginx. In ons geval is het geen gewone Nginx, maar OpenResty, Nginx met ondersteuning voor LuaJIT.
Een ander onderdeel van het systeem is het werken met SSL-certificaten. In S3-opslag kunt u een eigen domein instellen voor toegang tot een specifieke bucket, gewoon met behulp van CNAME. Maar zonder HTTPS kan dat vandaag de dag niet: een eigen domein vereist een eigen SSL-certificaat.
Zoals ik al zei, is Nginx verantwoordelijk voor de load balancing en de terminatie van SSL. In ons geval is het geen gewone Nginx, maar OpenResty, Nginx met ondersteuning voor LuaJIT.
Dit stelde ons in staat om redelijk eenvoudig onze Nginx te leren om willekeurige certificaten uit te geven. Bovendien moesten we certificaten dynamisch uitgeven (zonder dat ze in het configuratiebestand hoefden te worden vermeld). We hebben gebruik gemaakt van de extensie ssl_certificate_by_lua, die het mogelijk maakt om het certificaat uit een willekeurige bron te lezen tijdens de TLS-handshake. Als certificaatopslag hebben we ook Tarantool gekozen: dit maakt het mogelijk om certificaten extern te beheren en biedt een zeer snelle levering.
Er is ook een aparte daemon geïmplementeerd, wiens taak is om certificaten die zijn uitgegeven via Let’s Encrypt regelmatig bij te werken.
Wat zou ik behouden en wat anders doen als ik de opslag opnieuw zou ontwikkelen
Wat vanaf het begin gebruikt had moeten worden
Sharding direct. Ik heb behoorlijk wat problemen ondervonden met resharding. Het is gemakkelijk te doen, maar als je begint met projecten die moeten schalen, is het beter om meteen een sharded cluster te nemen, zelfs al is het met het minimum aantal knooppunten. De implementatie van sharding aan het begin is bijna gratis in vergelijking met het invoeren van sharding in een werkend systeem.
Werken met Tarantool via load balancers. Tegenwoordig koppelen we alle nieuwe databases direct aan via load balancers. Dit maakt het mogelijk om functionaliteit uit te breiden en een hogere beschikbaarheid te bereiken.
Auto-failover. Ik zou alle tools die nodig zijn voor auto-failover installeren, aangezien de eerste mislukkingen na de lancering verband hielden met het ontbreken daarvan. Na de ervaring met S3 werden alle volgende producten gelanceerd met dit in gedachten.
S3-functie 'Versiebesturing'. Aanvankelijk leek het geen veelgevraagde functionaliteit. Deze mogelijkheid in te bouwen in de architectuur van een werkend systeem is uiterst complex.
Gescheiden facturering. De manier waarop we de facturering in ons systeem hebben geïntegreerd, bleek in het begin goed te zijn, maar later begon het te storen; het zou beter zijn geweest om het als een volledig aparte service te hebben.
Wat een succesvolle beslissing was
Datamodel. De geschiedenis heeft aangetoond dat we naarmate de dienst zich ontwikkelde, vrij goed overeenkwamen met het datamodel van Amazon, waardoor we de functies konden implementeren die daar beschikbaar zijn.
Sharding-schema. Ik zou dezelfde bereikshardingen per buckets ondersteunen, aangezien dit helpt om de verzoeken van verschillende buckets goed over een grote cluster te verdelen.
Gebruik van Tarantool. Tarantool heeft enorm geholpen bij de ontwikkeling en modificatie van de dienst; we werkten gemakkelijk met gegevens, transformeerden en sharded de opslag zonder de applicatielaag te hoeven betreden.
Deze presentatie werd voor het eerst gegeven op door Mail.ru Cloud Solutions & Tarantool. Bekijk andere presentaties en abonneer je op evenementaankondigingen in Telegram .
Je kunt ook mijn oude presentatie over S3 bekijken of het artikel van mijn collega over block storage lezen.
- .
- .
Bron: habr.com
