

In Ik heb een kader voor netwerkautomatisering beschreven. Volgens feedback van sommige mensen heeft zelfs deze eerste benadering van het probleem al enkele vragen helderheid gegeven. Dit maakt me erg blij, omdat ons doel in de cyclus niet is om Ansible vol te stoppen met Python-scripts, maar om een systeem op te bouwen.
Ditzelfde kader stelt de volgorde vast waarin we de kwestie zullen aanpakken.
En netwerkvirtualisatie, waar deze aflevering aan gewijd is, valt niet helemaal binnen het thema van ADSM, waar we de automatisering behandelen.
Maar laten we er vanuit een ander perspectief naar kijken.
Al geruime tijd maken veel diensten gebruik van hetzelfde netwerk. Voor een telecomoperator gaat dit om 2G, 3G, LTE, DSL en B2B, bijvoorbeeld. Voor datacenters: connectiviteit voor verschillende klanten, internet, block storage, object storage.
En alle diensten vereisen isolatie van elkaar. Dit heeft geleid tot de ontwikkeling van overlay-netwerken.
En alle diensten willen niet wachten tot iemand ze handmatig instelt. Dit heeft geleid tot de ontwikkeling van orchestrators en SDN.
De eerste benadering van systematische netwerkautomatisering, of beter gezegd een deel daarvan, is al geruime tijd ondernomen en op veel plaatsen geïmplementeerd: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
Daar zullen we vandaag dieper op ingaan.
Inhoud
- Redenen
- Terminologie
- Underlay — fysieke netwerk
- Overlay — virtueel netwerk
- Overlay met ToR
- Overlay vanaf de host
- Aan het voorbeeld van Tungsten Fabric
- Communicatie binnen één fysieke machine
- Communicatie tussen VM's op verschillende fysieke machines
- Toegang tot de buitenwereld
- FAQ
- Conclusie
- Nuttige links
Redenen
En aangezien we het daarover hebben, is het de moeite waard om de voorwaarden voor netwerkvirtualisatie te noemen. Dit proces is in werkelijkheid al een tijd aan de gang.
Misschien hebt u wel eens gehoord dat netwerken altijd de meest trage schakel van elk systeem zijn geweest. En dat is in alle opzichten waar. Het netwerk is de basis waarop alles steunt, en veranderingen aanbrengen is vrij lastig — diensten kunnen niet wachten als het netwerk uitvalt. Vaak kan het buiten gebruik stellen van één knooppunt een groot aantal applicaties beïnvloeden en talloze klanten raken. Dit is deels de reden waarom het netwerkteam kan terughoudend zijn wat betreft wijzigingen — omdat het nu op zijn minst werkt (misschien weten we zelfs niet hoe), en nu moet er iets nieuws worden ingesteld, en het is onbekend hoe dit het netwerk zal beïnvloeden.
Om niet te hoeven wachten tot netwerkbeheerders VLAN instellen en om services niet op elk knooppunt van het netwerk te hoeven configureren, hebben mensen overlays bedacht - op elkaar liggende netwerken - waarvan er vele soorten zijn: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE, enzovoort.
Hun aantrekkelijkheid ligt in twee simpele dingen:
- Alleen de eindknopen hoeven te worden geconfigureerd - transitknooppunten blijven onaangeroerd. Dit versnelt het proces aanzienlijk en stelt soms zelfs in staat om de afdeling netwerkinfrastructuur uit het proces van het invoeren van nieuwe services te verwijderen.
- De belasting is diep verborgen in de headers - transitknooppunten hoeven hier niet van op de hoogte te zijn, noch van de adressering op hosts of de routes van het overlay-netwerk. Dit betekent dat er minder informatie in de tabellen hoeft te worden opgeslagen, waardoor eenvoudiger/goedkopere apparatuur kan worden gebruikt.
In deze niet helemaal volwaardige aflevering ga ik niet alle mogelijke technologieën bespreken, maar eerder de werkstructuur van overlay-netwerken in datacenters beschrijven.
De hele serie zal een datacenter beschrijven dat bestaat uit rijen identieke racks, waarin identieke servers zijn geïnstalleerd.
Op deze apparatuur worden virtuele machines/container/serverless uitgevoerd die de diensten realiseren.
Terminologie
In de cyclus server zal ik het programma dat de serverzijde van de client-servercommunicatie implementeert, aanduiden.
Fysieke machines in racks zullen we servers noemen niet .
Een fysieke machine is een x86-computer die in een rack is geïnstalleerd. Het meest gebruikte begrip is host. We zullen het zo noemen «machineof host.
Hypervisor is een applicatie die op een fysieke machine draait en fysieke middelen emuleert waarop Virtuele Machines worden uitgevoerd. Soms wordt in de literatuur en op het internet het woord 'hypervisor' als synoniem voor 'host' gebruikt.
Virtuele machine - een besturingssysteem dat bovenop de hypervisor op een fysieke machine draait. Voor ons in deze cyclus is het niet zo belangrijk of het werkelijk een virtuele machine of gewoon een container is. We zullen dit 'VM«
Tenant is een brede term die ik in dit artikel zal definiëren als een afzonderlijke service of een afzonderlijke klant.
Multi-tenancy of multi-huur is het gebruik van dezelfde applicatie door verschillende klanten/diensten. Hierbij wordt de isolatie van klanten van elkaar bereikt door de architectuur van de applicatie en niet door afzonderlijk uitgevoerde instanties.
ToR — Top of the Rack switch — een switch die in een rack is geïnstalleerd, waaraan alle fysieke machines zijn aangesloten.
Naast de ToR-topologie passen verschillende providers End of Row (EoR) of Middle of Row toe (hoewel de laatste zeldzaam is en ik de afkorting MoR nog niet ben tegengekomen).
Underlay netwerk of het onderliggende netwerk of underlay — de fysieke netwerkinfrastructuur: switches, routers, kabels.
Overlay netwerk of het overlay netwerk — een virtueel netwerk van tunnels dat bovenop de fysieke laag werkt.
L3-fabriek of IP-fabriek — een geweldig uitvinding van de mensheid, waardoor je tijdens gesprekken niet STP hoeft te herhalen en TRILL niet hoeft te leren. Een concept waarbij het hele netwerk tot aan de toegang laag uitsluitend L3 is, zonder VLAN's en bijgevolg enorme, uitgestrekte broadcast domeinen. Waar de term 'fabriek' vandaan komt, bespreken we in het volgende deel.
SDN — Software Defined Network. Heeft nauwelijks introductie nodig. Een benadering voor netwerken waarbij veranderingen niet door mensen, maar door software worden uitgevoerd. Betekent meestal dat het Control Plane buiten de eindnetwerkapparaten naar een controller wordt verhuisd.
NFV — Network Function Virtualization — de virtualisatie van netwerkapparaten, waarbij sommige functies van het netwerk kunnen worden uitgevoerd als virtuele machines of containers om de implementatie van nieuwe services, het organiseren van Service Chaining en eenvoudiger horizontale schaalbaarheid te versnellen.
VNF — Virtual Network Function. Een specifiek virtueel apparaat: router, switch, firewall, NAT, IPS/IDS, enz.
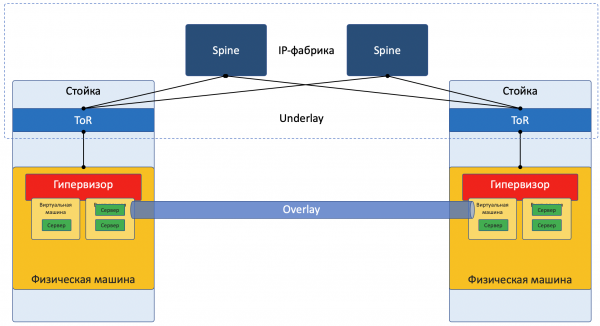
Ik vereenvoudig de beschrijving opzettelijk tot een specifieke implementatie om de lezer niet te verwarren. Voor een zorgvuldiger lezen verwijs ik naar de sectie . Bovendien belooft Roma Gorgé, die dit artikel bekritiseert vanwege onnauwkeurigheden, een aparte editie te schrijven over server- en netwerktechnologieën, die dieper ingaat op de details.
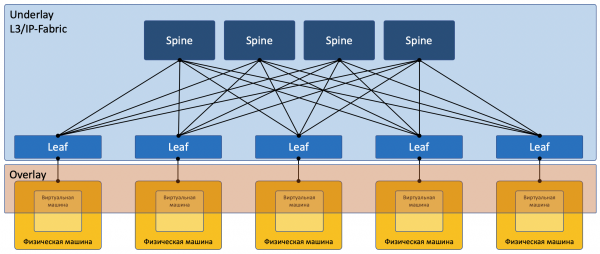
De meeste netwerken kunnen vandaag de dag duidelijk in twee delen worden opgesplitst:
Underlay — een fysiek netwerk met een stabiele configuratie.
Overlay — een abstractie bovenop de Underlay voor isolatie van tenants.
Dit geldt zowel voor datacenters (die we in dit artikel bespreken) als voor ISP's (die we niet zullen bespreken, omdat dit al in ). De situatie is natuurlijk iets anders bij enterprise-netwerken.
Afbeelding met focus op het netwerk:
Underlay
Underlay is a physical network: hardware switches and cables. Devices in the underlay know how to reach the physical machines.
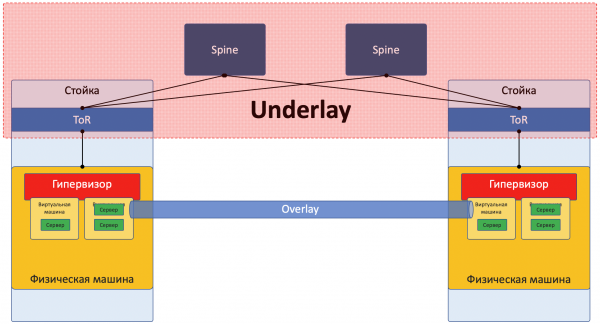
It relies on standard protocols and technologies. Not least because hardware devices still operate on proprietary software that does not allow chip programming or the implementation of their own protocols, making compatibility with other vendors and standardization necessary.
But someone like Google can afford to develop its own switches and abandon commonly accepted protocols. However, LAN_DC is not Google.
Underlay changes relatively rarely because its task is basic IP connectivity between physical machines. The underlay knows nothing about the services, clients, or tenants running above it — it only needs to deliver packets from one machine to another.
An example of Underlay might be:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
The Underlay network is configured in the classic way: CLI/GUI/NETCONF.
Manually, with scripts, proprietary utilities.
A more detailed article on the underlay will be dedicated to the next part of the series.
Overlay
Overlay is a virtual network of tunnels stretched over the Underlay, allowing a client's VMs to communicate with each other while ensuring isolation from other clients.
Client data is encapsulated in tunneling headers for transmission across the shared network.
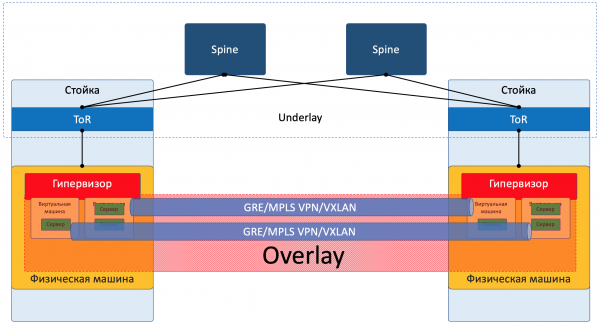
Thus, a client's VMs (from one service) can communicate with each other through the Overlay without even realizing the actual path the packet takes.
An example of Overlay could be, as I mentioned earlier:
- GRE tunnel
- VXLAN
- EVPN
- L3VPN
- GENEVE
The Overlay network is usually configured and maintained via a central controller. From there, the configuration, Control Plane, and Data Plane are delivered to the devices that handle routing and encapsulation of client traffic. Just we will break this down with examples.
Yes, this is pure SDN.
There are two fundamentally different approaches to organizing an Overlay network:
- Overlay met ToR
- Overlay vanaf de host
Overlay met ToR
Overlay can start on an access switch (ToR) located in the rack, as is the case, for example, in a VXLAN factory.
This is a time-tested mechanism in ISP networks, and all network equipment vendors support it.
In dit geval moet de ToR-switch verschillende diensten kunnen scheiden, en de netwerkbeheerder moet in zekere mate samenwerken met de beheerders van virtuele machines en wijzigingen (zelfs automatisch) in de configuratie van de apparaten aanbrengen.
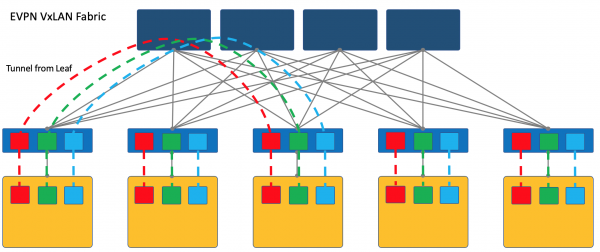
Hierverwijs ik de lezer naar het artikel over onze oude vriend .
In dit gaan de benaderingen voor de constructie van datacenter-netwerken met EVPN VXLAN-fabrieken uitgebreid aan bod.
Voor een completer inzicht in de realiteit kan men het boek van Cisco lezen, .
Ik merk op dat VXLAN slechts een methode voor encapsulatie is, en de terminatie van de tunnels kan niet op de ToR plaatsvinden, maar op de host, zoals bijvoorbeeld het geval is bij OpenStack.
Toch is een VXLAN-fabriek waar de overlay begint op de ToR een van de gevestigde ontwerpen van overlay-netwerken.
Overlay vanaf de host
Een andere benadering is om de tunnels op de eindhosts te starten en te termineren.
In dit geval blijft het netwerk (Underlay) zo eenvoudig en statisch mogelijk.
De host zelf voert alle benodigde encapsulaties uit.
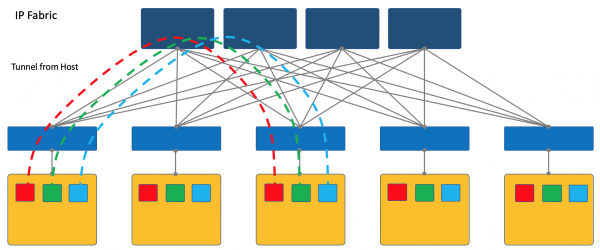
Dit vereist inderdaad het draaien van een speciale applicatie op de hosts, maar dat is het waard.
Ten eerste is het eenvoudiger om een cliënt op een Linux-machine te starten of, laten we zeggen, is het überhaupt mogelijk, terwijl je op de switch waarschijnlijk gebruik zult moeten maken van propriëtaire SDN-oplossingen, wat het idee van multi-vendor-compatibiliteit tenietdoet.
Ten tweede kan de ToR-switch in dit geval zo eenvoudig mogelijk worden gehouden, zowel vanuit het Control Plane als het Data Plane. Inderdaad, met de SDN-controller hoeft hij dan geen gegevens uit te wisselen en hoeft hij geen netwerken/ARP’s van alle aangesloten clients op te slaan; het is voldoende om het IP-adres van de fysieke machine te kennen, wat de switching/routing-tabellen aanzienlijk vereenvoudigt.
In de ADSK-serie kies ik voor de overlay-benadering vanaf de host — hier bespreken we alleen dat onderwerp en we zullen niet terugkeren naar de VXLAN-fabriek.
Het is het eenvoudigst om dit aan de hand van voorbeelden te bekijken. En als proeftuin nemen we het open source SDN-platform OpenContrail, dat tegenwoordig bekend staat als .
Aan het einde van het artikel zal ik enkele overpeinzingen delen over de analogie met OpenFlow en OpenvSwitch.
Aan het voorbeeld van Tungsten Fabric
Op elke fysieke machine zijn er vRouter — een virtuele router die kennis heeft van de netwerken die verbonden zijn en aan welke klanten ze toebehoren — in wezen een PE-router. Voor elke klant ondersteunt het een geïsoleerde routeringstabel (lees VRF). Eigenlijk maakt de vRouter overlay-tunneling mogelijk.
Wat betreft de vRouter — aan het einde van het artikel meer.
Elke VM, die op de hypervisor is geplaatst, is verbonden met de vRouter van deze machine via .
TAP — Terminal Access Point — een virtuele interface in de Linux-kernel, die netwerkintegratie mogelijk maakt.
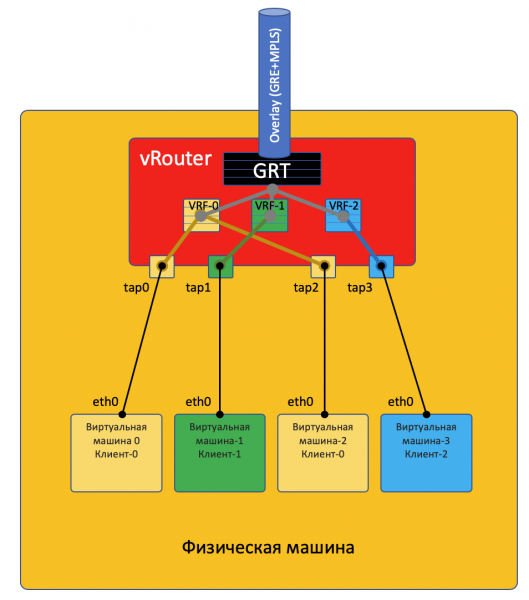
Als er meerdere netwerken achter de vRouter zijn, wordt er voor elk netwerk een virtuele interface gecreëerd, waarvoor een IP-adres wordt toegewezen — dit is het standaard gateway-adres.
Alle netwerken van één klant worden in één VRF (één tabel) geplaatst, verschillende — in verschillende.
Ik wil hier een kanttekening maken dat niet alles zo eenvoudig is en ik stuur de nieuwsgierige lezer naar het einde van het artikel..
Om ervoor te zorgen dat vRouter's met elkaar kunnen communiceren, en dus ook de VM's die zich daarachter bevinden, wisselen ze routeringsinformatie uit via SDN-controller.
Om de buitenwereld te bereiken, is er een uitgangspunt uit de matrix — de gateway van het virtuele netwerk. VNGW — Virtual Network GateWay (de term is van mij)).
Laten we nu voorbeelden van communicatie bekijken — dan zal het duidelijk zijn.
Communicatie binnen één fysieke machine
VM0 wil een pakket naar VM2 sturen. Laten we voorlopig aannemen dat dit VM's van dezelfde klant zijn.
Data Plane
- VM-0 heeft een standaardroute naar zijn interface eth0. Het pakket wordt daarheen gestuurd.
Deze interface eth0 is in feite virtueel verbonden met de virtuele router vRouter via de TAP-interface tap0. - vRouter analyseert via welke interface het pakket is ontvangen, dat wil zeggen aan welke klant (VRF) het behoort, en vergelijkt het ontvangstadres met de routeringstabel van die klant.
- Nadat vastgesteld is dat de ontvanger op dezelfde machine achter een andere poort zit, stuurt de vRouter het pakket eenvoudig naar die poort zonder extra headers — in dit geval heeft de vRouter al een ARP-vermelding.
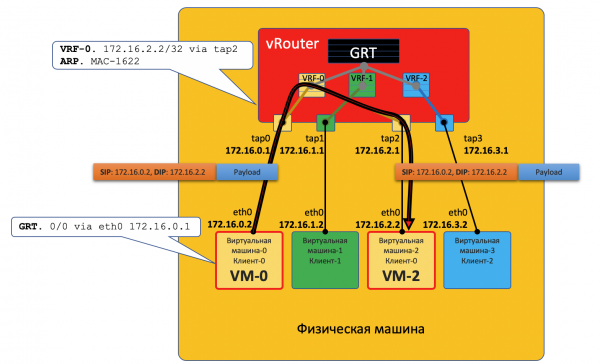
Het pakket komt in dit geval niet in het fysieke netwerk — het is intern binnen de vRouter gerouteerd.
Control Plane
De hypervisor geeft bij het opstarten van de virtuele machine aan:
- Haar eigen IP-adres.
- De standaardroute — via het IP-adres van de vRouter in dit netwerk.
Via een speciale API laat de hypervisor aan de vRouter weten:
- Dat er een virtuele interface moet worden aangemaakt.
- Welke Virtual Network (VN) er moet worden aangemaakt.
- Aan welke VRF deze (VN) moet worden gekoppeld.
- De statische ARP-vermelding voor deze VM - achter welke interface haar IP-adres zich bevindt en aan welk MAC-adres het is gekoppeld.
En opnieuw is de werkelijke interactieprocedure vereenvoudigd ten behoeve van het begrip van het concept.
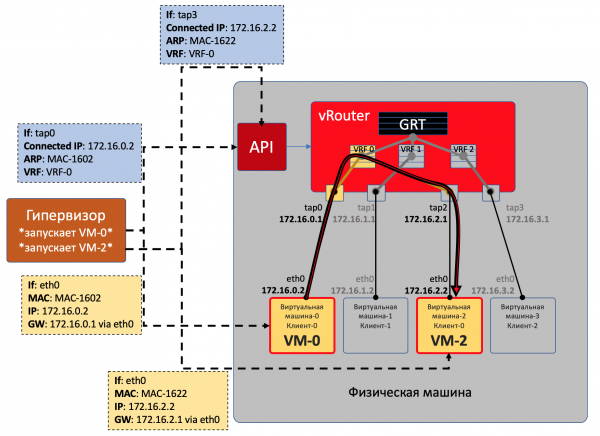
Zo ziet vRouter alle VM's van dezelfde klant op deze machine als direct aangesloten netwerken en kan hij zelfstandig tussen deze netwerken routeren.
VM0 en VM1 behoren echter tot verschillende klanten en bevinden zich dus in verschillende tabellen van de vRouter.
Of ze rechtstreeks met elkaar kunnen communiceren hangt af van de instellingen van de vRouter en het netwerkontwerp.
Bijvoorbeeld, als beide VM's openbare adressen gebruiken of als NAT op de vRouter plaatsvindt, kan directe routering op de vRouter worden gedaan.
In een andere situatie kunnen de adresruimten zich overlappen - je moet via een NAT-server om een publiek adres te verkrijgen - dit lijkt op het naar externe netwerken gaan, waarover hieronder meer.
Communicatie tussen VM's op verschillende fysieke machines
Data Plane
- Het begin is precies hetzelfde: VM-0 verzendt een pakket met als bestemmingsadres VM-7 (172.17.3.2) volgens zijn standaard.
- vRouter ontvangt het en ziet deze keer dat de ontvanger zich op een andere machine bevindt en bereikbaar is via tunnel Tunnel0.
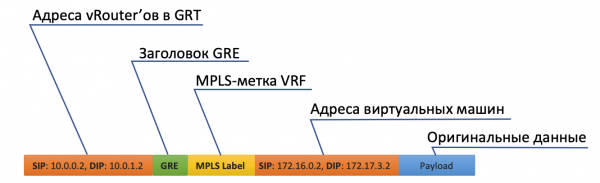
- Eerst hangt hij een MPLS-label aan, dat de externe interface identificeert, zodat de vRouter aan de andere kant weet waar hij dit pakket zonder aanvullende haken moet plaatsen.
- Tunnel0 heeft een bron van 10.0.0.2, bestemmeling: 10.0.1.2.
vRouter voegt GRE (of UDP) headers toe en een nieuw IP aan het oorspronkelijke pakket. - In de routingtabel heeft vRouter een standaardroute via adres ToR1 10.0.0.1. Dat is waar hij naartoe verzendt.

- ToR1, als deelnemer aan het Underlay-netwerk, weet (bijvoorbeeld via OSPF) hoe hij 10.0.1.2 moet bereiken en verzendt het pakket via de route. Let op dat hier ECMP wordt ingeschakeld. In de illustratie zijn er twee next-hops, en verschillende stromen worden volgens de hash verdeeld.
Hij hoeft echter niet te weten wat er onder de externe IP-header ligt. Dit betekent dat er feitelijk onder IP een sandwich van IPv6 over MPLS over Ethernet over MPLS over GRE over over over GRE kan zijn.
- Aan de ontvangende zijde verwijdert vRouter GRE en begrijpt hij aan de hand van het MPLS-label naar welke interface dit pakket moet worden doorgestuurd, opent het en verzendt het in zijn oorspronkelijke vorm naar de ontvanger.
Control Plane
Bij het opstarten van de machine gebeurt alles wat hierboven is beschreven.
En daarnaast nog het volgende:
- Voor elke klant wijst de vRouter een MPLS-label toe. Dit is een service-label voor L3VPN, waarmee klanten binnen dezelfde fysieke machine van elkaar worden gescheiden.
In feite wordt het MPLS-label altijd zonder twijfel door de vRouter toegewezen — het is immers niet van tevoren bekend of de machine alleen met andere machines achter dezelfde vRouter zal communiceren, en waarschijnlijk is dat zelfs niet het geval.
- De vRouter maakt verbinding met de SDN-controller via het BGP-protocol (of een vergelijkbaar protocol — in het geval van TF is dat XMPP 0_o).
- Via deze sessie geeft de vRouter de SDN-controller de routes naar de aangesloten netwerken door:
- Netwerkadres
- Incapsulatiemethode (MPLSoGRE, MPLSoUDP, VXLAN)
- MPLS-label van de klant
- Eigen IP-adres als nexthop
- De SDN-controller ontvangt deze routes van alle aangesloten vRouters en geeft ze aan anderen door. Dit betekent dat hij als Route Reflector optreedt.
Hetzelfde gebeurt ook in de omgekeerde richting.
De overlay kan elke minuut veranderen. Zo gaat het ongeveer in publieke clouds, wanneer klanten regelmatig hun virtuele machines opstarten en uitschakelen.
De centrale controller neemt alle moeilijkheden op zich met het onderhouden van de configuratie en het beheren van de switch-/routertabellen op de vRouter.
In grove termen verbindt de controller zich met alle vRouters via BGP (of een vergelijkbaar protocol) en geeft simpelweg route-informatie door. BGP heeft bijvoorbeeld al een Address-Family voor het verzenden van de incapsulatiemethode. of .
De configuratie van het Underlay-netwerk verandert hierbij op geen enkele manier, wat overigens aanzienlijk moeilijker te automatiseren is, terwijl het gemakkelijker is om het met een onhandige beweging te verstoren.
Toegang tot de buitenwereld
Op een bepaald moment moet de simulatie eindigen en moet je de virtuele wereld verlaten om de echte binnen te gaan. En daarvoor is een gateway-telefoon nodig.
Er worden twee benaderingen toegepast:
- Er wordt een hardware-router geplaatst.
- Er wordt een appliance opgestart die de functies van een router uitvoert (ja, ja, na SDN hebben we ook met VNF te maken gehad). Laten we het de virtuele gateway noemen.
Het voordeel van de tweede benadering is de goedkope horizontale schaalbaarheid — als er niet genoeg vermogen is, start je gewoon nog een virtuele machine met een gateway. Op elke fysieke machine, zonder dat je hoeft te zoeken naar beschikbare racks, eenheden, voeding, de hardware zelf aan te schaffen, deze te vervoeren, te installeren, te verbinden, in te stellen, en daarna ook nog eens de defecte componenten te vervangen.
De nadelen van een virtuele gateway zijn echter dat de eenheid van de fysieke router nog steeds veel krachtiger is dan de multicore virtuele machine, en dat de software, die is afgestemd op zijn hardware, aanzienlijk stabieler werkt (nee). Het is ook moeilijk om het feit te ontkennen dat het software-hardwarecomplex gewoon werkt, vereist alleen configuratie, terwijl de implementatie en het onderhoud van een virtuele gateway een taak is voor sterke ingenieurs.
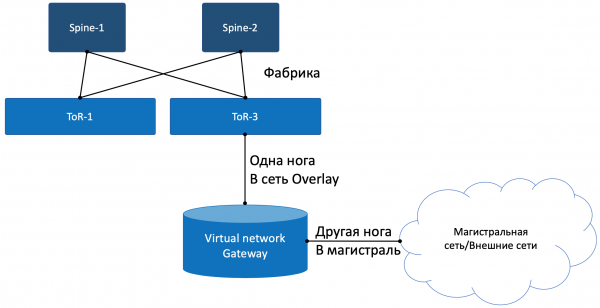
Met één voet kijkt de gateway naar het virtuele Overlay-netwerk, zoals een gewone Virtuele Machine, en kan het met alle andere VM's communiceren. Tegelijkertijd kan het de netwerken van alle klanten afhandelen en dus routing tussen hen uitvoeren.
Met de andere voet kijkt de gateway naar het backbone-netwerk en weet hoe het naar het internet moet.
Data Plane
Dus het proces ziet er als volgt uit:
- VM-0, met de standaard naar de vRouter, verzendt een pakket met een bestemming in de externe wereld (185.147.83.177) naar de interface eth0.
- De vRouter ontvangt dit pakket en kijkt naar het bestemmingsadres in de routeringstabel — vindt de standaardroute via de gateway VNGW1 via Tunnel 1.
Het ziet ook dat dit een GRE-tunnel is met SIP 10.0.0.2 en DIP 10.0.255.2, en dat eerst de MPLS-tag van deze klant moet worden toegevoegd, die VNGW1 verwacht. - De vRouter verpakt het oorspronkelijke pakket in MPLS-, GRE- en nieuwe IP-koppen en verzendt het naar het adres ToR1 10.0.0.1 volgens de standaard.
- Het onderliggende netwerk levert het pakket af bij de gateway VNGW1.
- De gateway VNGW1 verwijdert de tunneling-koppen GRE en MPLS, ziet het bestemmingsadres, raadpleegt zijn routeringstabel en begrijpt dat het naar het internet is gericht — dus via Full View of Default. Indien nodig voert het NAT-vertaling uit.
- Van VNGW naar de border kan een gewone IP-netwerk zijn, wat onwaarschijnlijk is.
Het kan een klassieke MPLS-netwerk zijn (IGP+LDP/Rsvp TE), een terugfabriek met BGP LU of een GRE-tunnel van VNGW naar de border via een IP-netwerk.
Hoe dan ook, VNGW1 voert de noodzakelijke encapsulaties uit en verzendt het oorspronkelijke pakket in de richting van de border.
Het verkeer in de omgekeerde richting doorloopt dezelfde stappen in omgekeerde volgorde.
- De border levert het pakket af bij VNGW1.
- Die ontledigt het, kijkt naar het ontvangstadres en ziet dat het beschikbaar is via de tunnel Tunnel1 (MPLSoGRE of MPLSoUDP).
- Daarom plaatst het een MPLS-tag, GRE/UDP-kop en nieuw IP en verzendt het naar zijn ToR3 10.0.255.1.
Het bestemmingsadres van de tunnel is het IP-adres van de vRouter, achter welke de doel-WM zich bevindt — 10.0.0.2. - Het onderliggende netwerk levert het pakket aan de juiste vRouter.
- De doel-vRouter verwijdert GRE/UDP, bepaalt via de MPLS-label de interface en verzendt het pure IP-pakket naar zijn TAP-interface, die verbonden is met eth0 van de WM.
Control Plane
VNGW1 stelt een BGP-buurtvorming in met de SDN-controller, van wie het alle route-informatie over klanten ontvangt: achter welk IP-adres (vRouter) zich welke klant bevindt en met welk MPLS-label hij wordt geïdentificeerd.
Evenzo informeert hij de SDN-controller over de standaardroute met het label van deze klant, waarbij hij zichzelf als nexthop aangeeft. En daarna komt deze standaardroute aan bij de vRouteren.
Op VNGW vindt meestal route-aggregatie of NAT-translatie plaats.
En in de andere richting geeft hij in de sessie met de borders of Route Reflectors precies deze geaggregeerde route terug. En van hen ontvangt hij de standaardroute of Full-View, of iets anders.
In termen van encapsulatie en verkeeruitwisseling verschilt VNGW niet van vRouter.
Als men het gebied een beetje uitbreidt, kunnen andere netwerkapparaten zoals firewalls, schoonmaak- of verrijkingsfarms, IPS, enzovoort aan VNGW en vRouter worden toegevoegd.
En door VRF sequentieel te creëren en de routes correct aan te kondigen, kan men het verkeer laten cirkelen zoals men dat wil, wat service chaining wordt genoemd.
Dus ook hier fungeert de SDN-controller als Route-Reflector tussen VNGW, vRouteren en andere netwerkapparaten.
Maar in feite geeft de controller ook informatie over ACL en PBR (Policy Based Routing) door, waardoor individuele verkeersstromen niet gaan zoals de route het voorschrijft.
FAQ
Waarom maak je voortdurend de opmerking GRE/UDP?
Nou, eigenlijk is dit, laten we zeggen, specifiek voor Tungsten Fabric — je kunt het helemaal negeren.
Maar als je het overweegt, ondersteunde de TF, terwijl het nog OpenContrail was, beide encapsulaties: MPLS in GRE en MPLS in UDP.
UDP heeft het voordeel dat het in de Source Port in zijn header heel eenvoudig een hashfunctie van de oorspronkelijke IP+Proto+Port kan coderen, wat load balancing mogelijk maakt.
In het geval van GRE zijn er helaas alleen de externe IP- en GRE-headers, die hetzelfde zijn voor alle ingekapselde verkeersstromen, en is load balancing niet mogelijk — weinig mensen kunnen zo diep in het pakket kijken.
Tot een tijdje geleden konden routers, als ze in staat waren tot dynamische tunnels, dat alleen via MPLSoGRE, en pas recentelijk leerden ze MPLSoUDP. Daarom moeten we altijd een kanttekening maken over de mogelijkheid van twee verschillende encapsulaties.
Ter rechtvaardigheid moet worden opgemerkt dat TF ook L2-connectiviteit ondersteunt via VXLAN.
Je beloofde parallellen te trekken met OpenFlow.
Die dienen zich inderdaad aan. vSwitch in datzelfde OpenStack doet vrij vergelijkbare dingen met VXLAN, dat trouwens ook een UDP-header heeft.
In de Data Plane werken ze ongeveer hetzelfde, maar de Control Plane verschilt aanzienlijk. Tungsten Fabric gebruikt XMPP voor het versturen van route-informatie naar vRouter, terwijl OpenStack OpenFlow gebruikt.
Kun je iets meer vertellen over vRouter?
Het is onderverdeeld in twee delen: vRouter Agent en vRouter Forwarder.
De eerste draait in de User Space van het hostbesturingssysteem en communiceert met de SDN-controller, waarbij informatie over routes, VRF en ACL word uitgewisseld.
De tweede implementeert de Data Plane — meestal in de Kernel Space, maar kan ook draaien op SmartNIC's — netwerkkaarten met een CPU en een apart programmeerbaar switchchip, wat de belasting van de CPU van de hostmachine verlicht en het netwerk sneller en voorspelbaarder maakt.
Er is ook een scenario mogelijk waarin de vRouter een DPDK-applicatie in User Space is.
vRouter Agent geeft instellingen door aan vRouter Forwarder.
Wat is er aan de hand met het Virtuele Netwerk?
Ik heb in het begin van het artikel gesproken over VRF, waarbij elk huurder aan zijn eigen VRF is gekoppeld. En als dit voor een oppervlakkig begrip van de werking van het overlay-netwerk voldoende was, dan zijn er bij de volgende iteratie verduidelijkingen nodig.
Meestal wordt in virtualisatiemechanismen de entiteit Virtueel Netwerk (dit kan als een eigennaam worden beschouwd) apart ingevoerd van klanten/huurders/virtuele machines — het is geheel zelfstandig. Dit Virtuele Netwerk kan via interfaces aan de ene huurder, de andere, twee of waar dan ook worden gekoppeld. Zo wordt bijvoorbeeld Service Chaining gerealiseerd, waarbij het verkeer door bepaalde nodes in de juiste volgorde moet worden geleid, door eenvoudigweg de Virtuele Netwerken in de juiste volgorde te creëren en te koppelen.
Daarom is er niet echt een directe overeenkomst tussen het Virtuele Netwerk en de huurder.
Conclusie
Dit is een vrij oppervlakkige beschrijving van hoe een virtueel netwerk met overlay werkt vanaf een host en een SDN-controller. Maar welke virtualisatieplatform je ook vandaag de dag gebruikt, het zal op een vergelijkbare manier werken, of het nu VMWare, ACI, OpenStack, CloudStack, Tungsten Fabric of Juniper Contrail is. Ze zullen verschillen in soorten encapsulaties en headers, protocollen voor het afleveren van informatie aan eindnetwerkapparaten, maar het principe van een programmatisch instelbaar overlay-netwerk dat bovenop een relatief eenvoudig en statisch onderliggend netwerk werkt, blijft hetzelfde.
Je zou kunnen zeggen dat het gebied van privé-cloud creatie tegenwoordig SDN op basis van overlay-netwerken heeft overwonnen. Dit betekent echter niet dat OpenFlow geen plaats heeft in de moderne wereld - het wordt gebruikt in OpenStack en evenzeer in VMWare NSX, en voor zover ik weet maakt Google gebruik van OpenFlow voor het instellen van het onderliggende netwerk.
Hieronder heb ik links gegeven naar meer gedetailleerde materialen als je het onderwerp dieper wilt bestuderen.
En wat is er met ons Underlay?
Eigenlijk niets. Het is gedurende de hele tijd niet veranderd. Alles wat het moet doen in het geval van een overlay van een host is routes en ARP's bijwerken wanneer vRouter/VNGW verschijnen en verdwijnen, en pakketten tussen hen doorgeven.
Laten we een lijst met vereisten voor het Underlay-netwerk opstellen.
- Moet in staat zijn tot een bepaald routeringsprotocol, in onze situatie - BGP.
- Moet een hoge bandbreedte hebben, bij voorkeur zonder herondertekening, zodat er geen pakketten verloren gaan door overbelasting.
- Ondersteuning voor ECMP is een essentieel onderdeel van de fabriek.
- Moet QoS kunnen bieden, inclusief complexe functies zoals ECN.
- Ondersteuning voor NETCONF - een basis voor de toekomst.
Ik heb niet veel tijd gewijd aan de werking van het Underlay-netwerk hier. Dit komt omdat ik me in de vervolgserie juist daarop ga concentreren, terwijl we het Overlay slechts terloops zullen aansteken.
Het is duidelijk dat ik ons allemaal sterk beperk door als voorbeeld een datacenter netwerk te gebruiken dat is gebouwd op een Clos-fabriek met pure IP-routing en een overlay van een host.
Toch ben ik ervan overtuigd dat elke netwerk met een ontwerp kan worden beschreven in formele termen en geautomatiseerd. Mijn doel hier is gewoon om de benaderingen van automatisering te begrijpen, niet om iedereen in de war te brengen door de taak in het algemeen aan te pakken.
Binnen het ADSM plannen Roman Gorgh en ik om een aparte uitgave te publiceren over de virtualisatie van computermiddelen en de interactie ervan met netwerkvirtualisatie. Blijf op de hoogte.
Nuttige links
- .
- . 6 uur over Yandex.Cloud, waarin ook het virtuele netwerk op TF wordt besproken.
- .
- . Hier wordt het hele datacenter netwerk besproken, inclusief Underlay, Overlay, benaderingen voor multi-homing en beheer.
Bedankt
- — de voormalige host van de podcast linkmeup, en nu een expert op het gebied van cloudplatforms. Voor de opmerkingen en correcties. We kijken ook uit naar zijn diepgaandere artikel over virtualisatie in de nabije toekomst.
- — mijn collega en expert op het gebied van het ontwikkelen van virtuele netwerken. Voor de opmerkingen en correcties.
- — mijn collega en expert op het gebied van Tungsten Fabric. Voor de opmerkingen en correcties.
- — illustrator van linkmeup. Voor de KDPV.
- Alexander Limonov. Voor de meme 'automato'.
Bron: habr.com
