

Schaalbaarheid is een belangrijke vereiste voor cloudapplicaties. Met Kubernetes is het schalen van een applicatie net zo eenvoudig als het verhogen van het aantal replica's voor de betreffende deployment of ReplicaSet — maar dit is een handmatig proces.
Kubernetes maakt het mogelijk om applicaties automatisch te schalen (dat wil zeggen Pods in een deployment of ReplicaSet) op declaratieve wijze met behulp van de specificatie van de Horizontal Pod Autoscaler. Standaard is de criteria voor automatische schaling de CPU-gebruik metrics (resource metrics), maar het is mogelijk om aangepaste metrics en metrics van externe bronnen te integreren.
Opdracht heeft een artikel vertaald over hoe externe metrics te gebruiken voor het automatisch schalen van een Kubernetes-applicatie. Om te laten zien hoe het allemaal werkt, gebruikt de auteur HTTP-verzoeken metrics, die worden verzameld met Prometheus.
In plaats van horizontaal autoschalen van pods, wordt Kubernetes Event Driven Autoscaling (KEDA) toegepast — een open-source Kubernetes-operator. Het integreert aanvankelijk met de Horizontal Pod Autoscaler om naadloos autoschaling (ook tot/van nul) te bieden voor gebeurtenissen-gebaseerde workloads. De code is beschikbaar op .
Kort overzicht van hoe het systeem werkt
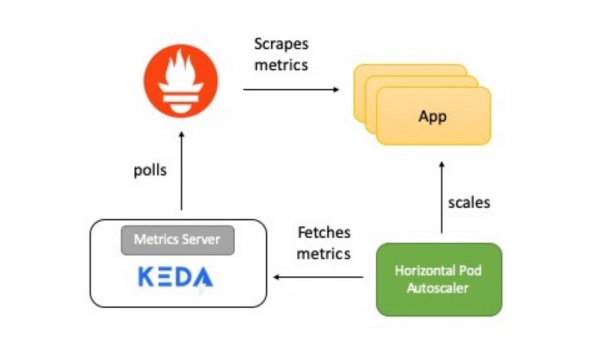
In het diagram staat een beknopte beschrijving van hoe alles werkt:
- De applicatie biedt metrics van het aantal HTTP-toegangen in Prometheus-formaat.
- Prometheus is ingesteld om deze metrics te verzamelen.
- De Prometheus-scaler in KEDA is ingesteld om de applicatie automatisch te schalen op basis van het aantal HTTP-aanroepen.
Nu zal ik elk element in detail bespreken.
KEDA en Prometheus
Prometheus is een open-source monitoring- en waarschuwingssysteem, onderdeel van . Het verzamelt metrics uit verschillende bronnen en slaat deze op als tijdreeksgegevens. Voor datavisualisatie kunnen of andere visualisatietools die met de Kubernetes API werken, worden gebruikt.
KEDA ondersteunt het concept van een scaler — het fungeert als een brug tussen KEDA en een extern systeem. De implementatie van de scaler is specifiek voor elk doelsysteem en haalt gegevens uit dat systeem. Vervolgens gebruikt KEDA deze gegevens voor het beheer van de automatische schaling.
Scalers ondersteunen meerdere gegevensbronnen, zoals Kafka, Redis, Prometheus. Dat betekent dat KEDA kan worden gebruikt voor automatische schaalvergroting van Kubernetes-implementaties, waarbij de metrics van Prometheus als criteria worden gebruikt.
Testapplicatie
De test Golang-toepassing biedt toegang via HTTP en voert twee belangrijke functies uit:
- Het maakt gebruik van de Prometheus Go-clientbibliotheek voor het instrumenteren van de applicatie en het verstrekken van de metric http_requests, die een teller van verzoeken bevat. Het eindpunt waar de metrics van Prometheus beschikbaar zijn, bevindt zich op de URI
/metrics.var httpRequestsCounter = promauto.NewCounter(prometheus.CounterOpts{ Name: "http_requests", Help: "aantal http verzoeken", }) - In antwoord op het verzoek
GETverhoogt de applicatie de waarde van de sleutel (access_count) in Redis. Dit is een eenvoudige manier om het werk te doen als onderdeel van de HTTP-handler en tegelijkertijd de metrics van Prometheus te controleren. De waarde van de metric moet gelijk zijn aan de waardeaccess_countin Redis.func main() { http.Handle("/metrics", promhttp.Handler()) http.HandleFunc("/test", func(w http.ResponseWriter, r *http.Request) { defer httpRequestsCounter.Inc() count, err := client.Incr(redisCounterName).Result() if err != nil { fmt.Println("Kon de redis-teller niet verhogen", err) os.Exit(1) } resp := "Toegang op " + time.Now().String() + "nToegangsnummer " + strconv.Itoa(int(count)) w.Write([]byte(resp)) }) http.ListenAndServe(":8080", nil) }
De applicatie wordt geïmplementeerd in Kubernetes via Deployment. Er wordt ook een service aangemaakt ClusterIP, die de Prometheus-server in staat stelt om metrics van de applicatie te ontvangen.
Hier is .
Prometheus-server
De implementatiemachtiging voor Prometheus bestaat uit:
ConfigMap— voor het doorgeven van de Prometheus-configuratie;Deployment— voor het implementeren van Prometheus in het Kubernetes-cluster;ClusterIP— service voor toegang tot de UI van Prometheus;ClusterRole,ClusterRoleBindingenServiceAccount— voor het uitvoeren van automatische serviceontdekking in Kubernetes.
Hier is .
KEDA Prometheus ScaledObject
De scaler fungeert als een brug tussen KEDA en het externe systeem waaruit metrics moeten worden gehaald. ScaledObject — een configureerbare resource die moet worden geïmplementeerd om de implementatie te synchroniseren met de gebeurtenissenbron, in dit geval Prometheus.
ScaledObject bevat informatie over de schaalvergroting van de implementatie, metadata over de gebeurtenisbron (zoals verbindingsecrets, naam van de queue), pollinterval, herstelperiode en andere gegevens. Het leidt tot de bijbehorende autoschaalresource (definitie HPA) voor het schalen van de implementatie.
Wanneer het object ScaledObject wordt verwijderd, de bijbehorende HPA-definitie wordt gewist.
Hier is de definitie ScaledObject voor ons voorbeeld, waarin een scaler wordt gebruikt Prometheus:
apiVersion: keda.k8s.io/v1alpha1
kind: ScaledObject
metadata:
 name: prometheus-scaledobject
 namespace: default
 labels:
   deploymentName: go-prom-app
spec:
 scaleTargetRef:
   deploymentName: go-prom-app
 pollingInterval: 15
 cooldownPeriod:  30
 minReplicaCount: 1
 maxReplicaCount: 10
 triggers:
 - type: prometheus
   metadata:
     serverAddress:
http://prometheus-service.default.svc.cluster.local:9090
     metricName: access_frequency
     threshold: '3'
     query: sum(rate(http_requests[2m]))
Houd rekening met de volgende punten:
- Het is een verwijzing naar
Deploymentmet de naamgo-prom-app. - Type trigger is -
Prometheus. Het adres van de Prometheus-server wordt genoemd samen met de metrieknaam, drempelwaarde en , die zal worden gebruikt. De PromQL-query is -sum(rate(http_requests[2m])). - Volgens
pollingInterval, KEDA vraagt elk vijftien seconden het doel bij Prometheus op. Minimaal één pod wordt ondersteund (minReplicaCount), en het maximale aantal pods overschrijdt nietmaxReplicaCount(in dit voorbeeld - tien).
Het kan worden ingesteld minReplicaCount op nul. In dat geval activeert KEDA de implementatie van nul naar één, en daarna biedt het HPA aan voor verdere automatische schaling. De omgekeerde volgorde is ook mogelijk, dat wil zeggen schaling van één naar nul. In het voorbeeld hebben we nul niet gekozen omdat dit een HTTP-service is, geen op verzoek gebaseerde systeem.
De magie binnen autoscaling
De drempelwaarde wordt gebruikt als een trigger voor het schalen van de implementatie. In ons voorbeeld geeft de PromQL-query sum(rate(http_requests[2m])) de geaggregeerde waarde van de snelheid van HTTP-verzoeken (aantal verzoeken per seconde) weer, gemeten over de laatste twee minuten.
Aangezien de drempelwaarde drie is, zal er één pod zijn zolang de waarde sum(rate(http_requests[2m])) lager is dan drie. Als de waarde echter stijgt, wordt er elke keer een extra pod toegevoegd wanneer sum(rate(http_requests[2m])) het met drie toeneemt. Bijvoorbeeld, als de waarde van 12 naar 14 gaat, dan is het aantal pods vier.
Laten we nu proberen te configureren!
Vooraf instellen
Alles wat u nodig heeft, is een Kubernetes-cluster en een geconfigureerde tool kubectl. In dit voorbeeld wordt een cluster gebruikt minikube, maar u kunt elk ander gebruiken. Voor het installeren van het cluster zijn er .
Installeer de laatste versie op Mac:
curl -Lo minikube
https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64
&& chmod +x minikube
sudo mkdir -p /usr/local/bin/
sudo install minikube /usr/local/bin/
Installeer , om toegang te krijgen tot het Kubernetes-cluster.
Installeer de laatste versie op Mac:
curl -LO
"https://storage.googleapis.com/kubernetes-release/release/$(curl -s
https://storage.googleapis.com/kubernetes-release/release/stable.txt)/bin/darwin/amd64/kubectl"
chmod +x ./kubectl
sudo mv ./kubectl /usr/local/bin/kubectl
kubectl version
Installatie van KEDA
U kunt KEDA op verschillende manieren implementeren, deze zijn opgesomd in . Ik gebruik een monolithische YAML:
kubectl apply -f
https://raw.githubusercontent.com/kedacore/keda/master/deploy/KedaScaleController.yaml
KEDA en zijn componenten worden geïnstalleerd in de namespace keda. Commando om te controleren:
kubectl get pods -n keda
Wacht tot de KEDA Operator pod start — overgaat naar Running State. En ga daarna verder.
Installatie van Redis met Helm
Als u Helm niet heeft geïnstalleerd, gebruik dan deze . Commando voor installatie op Mac:
brew install kubernetes-helm
helm init --history-max 200
helm init initialiseert de lokale commandoregelinterface en installeert ook Tiller in de Kubernetes-cluster.
kubectl get pods -n kube-system | grep tiller
Wacht tot de Tiller pod in Running staat.
Opmerking van de vertaler: De auteur gebruikt Helm@2, wat vereist dat de servercomponent Tiller wordt geïnstalleerd. Momenteel is Helm@3 actueel, waarvoor de servercomponent niet nodig is.
Na installatie van Helm kunt u Redis met één commando starten:
helm install --name redis-server --set cluster.enabled=false --set
usePassword=false stable/redis
Zorg ervoor dat Redis succesvol is opgestart:
kubectl get pods/redis-server-master-0
Wacht tot de Redis-pod overgaat naar Running.
Implementatie van de applicatie
Commando voor implementatie:
kubectl apply -f go-app.yaml

//output
deployment.apps/go-prom-app created
service/go-prom-app-service created
Controleer of alles is opgestart:
kubectl get pods -l=app=go-prom-app
Wacht tot Redis overgaat naar de status Running.
Implementatie van de Prometheus-server
De manifest van Prometheus gebruikt . Het maakt het mogelijk om applicatiepods dynamisch te ontdekken op basis van servicelabels.
kubernetes_sd_configs:
   - role: service
   relabel_configs:
   - source_labels: [__meta_kubernetes_service_label_run]
     regex: go-prom-app-service
     action: keep
Voor implementatie:
kubectl apply -f prometheus.yaml

//output
clusterrole.rbac.authorization.k8s.io/prometheus created
serviceaccount/default configured
clusterrolebinding.rbac.authorization.k8s.io/prometheus created
configmap/prom-conf created
deployment.extensions/prometheus-deployment created
service/prometheus-service created
Controleer of alles is opgestart:
kubectl get pods -l=app=prometheus-server
Wacht tot de Prometheus pod overgaat naar de status Running.
Gebruik kubectl port-forward voor toegang tot de gebruikersinterface van Prometheus (of de API-server) op adres .
kubectl port-forward service/prometheus-service 9090
Implementatie van KEDA autoscaling-configuratie
Commando voor aanmaken ScaledObject:
kubectl apply -f keda-prometheus-scaledobject.yaml
Controleer de logs van de KEDA-operator:
KEDA_POD_NAME=$(kubectl get pods -n keda
-o=jsonpath='{.items[0].metadata.name}')
kubectl logs $KEDA_POD_NAME -n keda
Het resultaat ziet er ongeveer zo uit:
time="2019-10-15T09:38:28Z" level=info msg="Watching ScaledObject:
default/prometheus-scaledobject"
time="2019-10-15T09:38:28Z" level=info msg="Created HPA with
namespace default and name keda-hpa-go-prom-app"
Controleer de applicatiepods. Er moet één instantie draaien, omdat minReplicaCount gelijk is aan 1:
kubectl get pods -l=app=go-prom-app
Controleer of de HPA-resource succesvol is aangemaakt:
kubectl get hpa
U zou iets moeten zien zoals:
NAME                   REFERENCE                TARGETS     MINPODS   MAXPODS   REPLICAS   AGE
keda-hpa-go-prom-app   Deployment/go-prom-app   0/3 (gem.)   1         10        1          45s
Bereikbaarheid controleren: toegang tot de applicatie
Om toegang te krijgen tot het REST-eindpunt van onze applicatie, voert u uit:
kubectl port-forward service/go-prom-app-service 8080
Nu kunt u de Go-applicatie benaderen met het adres . Voer hiervoor het volgende commando uit:
curl http://localhost:8080/test
Het resultaat ziet er ongeveer zo uit:
Toegang op 2019-10-21 11:29:10.560385986 +0000 UTC
m=+406004.817901246
Toegangsnummer 1
Controleer op dit moment ook Redis. U zult zien dat de sleutel access_count is verhoogd tot 1:
kubectl exec -it redis-server-master-0 -- redis-cli get access_count
//output
"1"
Zorg ervoor dat de waarde van de metriek http_requests dezelfde is:
curl http://localhost:8080/metrics | grep http_requests
//output
# HELP http_requests aantal http-aanvragen
# TYPE http_requests counter
http_requests 1
Laadbelasting creëren
We zullen gebruik maken van — een tool voor het genereren van belasting:
curl -o hey https://storage.googleapis.com/hey-release/hey_darwin_amd64
&& chmod a+x hey
U kunt ook de tool downloaden voor of .
Voer deze uit:
./hey http://localhost:8080/test
Standaard verstuurt de tool 200 verzoeken. U kunt dit verifiëren met de Prometheus-metrieken, evenals Redis.
curl http://localhost:8080/metrics | grep http_requests
//output
# HELP http_requests aantal http-aanvragen
# TYPE http_requests counter
http_requests 201
kubectl exec -it redis-server-master-0 -- redis-cli get access_count
//output
201
Bevestig de waarde van de werkelijke metriek (teruggegeven door de PromQL-query):
curl -g
'http://localhost:9090/api/v1/query?query=sum(rate(http_requests[2m]))'
//output
{"status":"success","data":{"resultType":"vector","result":[{"metric":{},"value":[1571734214.228,"1.686057971014493"]}]}}
In dit geval is het werkelijke resultaat 1,686057971014493 en wordt weergegeven in het veld value. Dit is onvoldoende voor schaalvergroting, omdat onze ingestelde drempel 3 is.
Meer belasting!
Houd in een nieuw terminalvenster het aantal applicatiepods in de gaten:
kubectl get pods -l=app=go-prom-app -w
Laten we de belasting vergroten met het commando:
./hey -n 2000 http://localhost:8080/test
Na enige tijd zult u zien dat de HPA de uitrol opschaalt en nieuwe pods start. Controleer de HPA om dit te bevestigen:
kubectl get hpa
NAME                   REFERENCE                TARGETS         MINPODS   MAXPODS   REPLICAS   AGE
keda-hpa-go-prom-app   Deployment/go-prom-app   1830m/3 (gemiddeld)   1         10        6          4m22s
Als de belasting onregelmatig is, zal de uitrol worden verlaagd tot het punt waarop er slechts één pod is die draait. Als je de feitelijke metric wilt controleren (teruggegeven door de PromQL-query), gebruik dan de opdracht:
curl -g
'http://localhost:9090/api/v1/query?query=sum(rate(http_requests[2m]))'
Opruimen
//Delete KEDA
kubectl delete namespace keda
//Delete the app, Prometheus server and KEDA scaled object
kubectl delete -f .
//Delete Redis
helm del --purge redis-server
Conclusie
KEDA stelt je in staat om je Kubernetes-implementaties automatisch te schalen (tot/van nul) op basis van gegevens van externe metrics. Bijvoorbeeld, op basis van Prometheus metrics, de lengte van de wachtrij in Redis, de latentie van de consument in een Kafka-onderwerp.
KEDA integreert met een externe bron en biedt ook metrics via de Metrics Server voor de Horizontal Pod Autoscaler.
Veel succes!
Wat verder te lezen:
- .
- .
- .
Bron: habr.com
