

Vroeg of laat komt in het gebruik van elk systeem de vraag naar veiligheid op: het waarborgen van authenticatie, het scheiden van rechten, audits en andere taken. Voor Kubernetes zijn er al , die voldoen aan de normen, zelfs in zeer veeleisende omgevingen... Dit artikel is gewijd aan de basisaspecten van veiligheid die zijn geïmplementeerd in de ingebouwde mechanismen van K8s. In de eerste plaats is het nuttig voor degenen die beginnen met Kubernetes, als een startpunt voor het bestuderen van veiligheidsgerelateerde vragen.
Authenticatie
In Kubernetes zijn er twee typen gebruikers:
- Service Accounts — accounts die worden beheerd door de Kubernetes API;
- Gebruikers — "gewone" gebruikers, beheerd door externe, onafhankelijke diensten.
Het belangrijkste onderscheid tussen deze typen is dat er voor Service Accounts speciale objecten in de Kubernetes API bestaan (ze worden ook zo genoemd — ServiceAccounts), die zijn gekoppeld aan een namespace en een set van autorisatiegegevens die in het cluster zijn opgeslagen in objecten van het type Secrets. Deze gebruikers (Service Accounts) zijn voornamelijk bedoeld voor het beheren van de toegang tot de Kubernetes API van processen die binnen het Kubernetes-cluster draaien.
Normale Users hebben geen vermeldingen in de Kubernetes API: het beheer van hen moet door externe mechanismen worden uitgevoerd. Ze zijn bedoeld voor mensen of processen die buiten het cluster leven.
Elke aanvraag bij de API is verbonden aan een Service Account, een User of wordt als anoniem beschouwd.
De authenticatiegegevens van de gebruiker omvatten:
- gebruikersnaam — gebruikersnaam (hoofdlettergevoelig!);
- UID — een machine-leesbare identificatiestring van de gebruiker, die "consistentere en uniekere is dan de gebruikersnaam";
- Groups — een lijst van groepen waartoe de gebruiker behoort;
- Extra — extra velden die door het autorisatiemechanisme kunnen worden gebruikt.
Kubernetes kan een groot aantal authenticatiemechanismen gebruiken: X509-certificaten, Bearer-tokens, authenticerende proxy's, HTTP Basic Auth. Met deze mechanismen kunnen een groot aantal autorisatieschema's worden geïmplementeerd: van een statisch bestand met wachtwoorden tot OpenID OAuth2.
Bovendien is het gebruik van meerdere autorisatieschema's tegelijkertijd toegestaan. Standaard worden er in het cluster gebruikt:
- service account tokens — voor Service Accounts;
- X509 — voor Users.
De vraag over het beheer van ServiceAccounts valt buiten de reikwijdte van dit artikel. Voor degenen die zich verder in dit onderwerp willen verdiepen, raad ik aan te beginnen met . We zullen de werking van X509-certificaten uitgebreider bespreken.
Gebruikerscertificaten (X.509)
De klassieke manier om met certificaten te werken, omvat:
- het genereren van een sleutel:
mkdir -p ~/mynewuser/.certs/ openssl genrsa -out ~/certs/mynewuser.key 2048 - het genereren van een certificaatverzoek:
openssl req -new -key ~/certs/mynewuser.key -out ~/certs/mynewuser.csr -subj "/CN=mynewuser/O=company" - de verwerking van het certificaatverzoek met behulp van de CA-sleutels van de Kubernetes-cluster, het verkrijgen van het gebruikerscertificaat (voor het verkrijgen van een certificaat moet een account worden gebruikt die toegang heeft tot de sleutel van het certificeringscentrum van de Kubernetes-cluster, dat standaard te vinden is in
/etc/kubernetes/pki/ca.key):openssl x509 -req -in ~/certs/mynewuser.csr -CA /etc/kubernetes/pki/ca.crt -CAkey /etc/kubernetes/pki/ca.key -CAcreateserial -out ~/certs/mynewuser.crt -days 500 - het creëren van een configuratiebestand:
- de beschrijving van de cluster (geef het adres en de locatie van het CA-certificaat bestand voor de specifieke installatie van de cluster):
kubectl config set-cluster kubernetes --certificate-authority=/etc/kubernetes/pki/ca.crt --server=https://192.168.100.200:6443 - of — als nietde aanbevolen optie — het is niet nodig om het rootcertificaat op te geven (dan zal kubectl de juistheid van de api-server van de cluster niet controleren):
kubectl config set-cluster kubernetes --insecure-skip-tls-verify=true --server=https://192.168.100.200:6443 - het toevoegen van een gebruiker aan het configuratiebestand:
kubectl config set-credentials mynewuser --client-certificate=.certs/mynewuser.crt --client-key=.certs/mynewuser.key - het toevoegen van een context:
kubectl config set-context mynewuser-context --cluster=kubernetes --namespace=target-namespace --user=mynewuser - het instellen van de standaardcontext:
kubectl config use-context mynewuser-context
- de beschrijving van de cluster (geef het adres en de locatie van het CA-certificaat bestand voor de specifieke installatie van de cluster):
Na de bovenstaande handelingen wordt in het bestand .kube/config een configuratie van de volgende indeling gemaakt:
apiVersion: v1
clusters:
- cluster:
    certificate-authority: /etc/kubernetes/pki/ca.crt
    server: https://192.168.100.200:6443
  name: kubernetes
contexts:
- context:
    cluster: kubernetes
    namespace: target-namespace
    user: mynewuser
  name: mynewuser-context
current-context: mynewuser-context
kind: Config
preferences: {}
users:
- name: mynewuser
  user:
    client-certificate: /home/mynewuser/.certs/mynewuser.crt
    client-key: /home/mynewuser/.certs/mynewuser.key
Om het verplaatsen van de configuratie tussen accounts en servers te vergemakkelijken, is het nuttig om de waarden van de volgende sleutels te bewerken:
-
certificate-authority -
client-certificate -
client-key
Hiervoor kunnen de in deze bestanden aangegeven specifieke waarden worden gecodeerd met base64 en in de configuratie worden opgenomen door de suffix -datatoe te voegen, zoals certificate-authority-data enz.
Certificaten met kubeadm
Met de release van Het werken met certificaten is aanzienlijk eenvoudiger geworden dankzij de alpha-versie van de ondersteuning in . Bijvoorbeeld, zo kan de generatie van een configuratiebestand met gebruikerssleutels eruitzien:
kubeadm alpha kubeconfig user --client-name=mynewuser --apiserver-advertise-address 192.168.100.200 NB: Vereiste advertentieadres is te vinden in de config van de api-server, die standaard is gelegen in /etc/kubernetes/manifests/kube-apiserver.yaml.
De resulterende config wordt naar stdout uitgevoerd. Je moet deze opslaan in ~/.kube/config het gebruikersaccount of in een bestand dat is aangegeven in de omgevingsvariabele KUBECONFIG.
Dieper graven
Voor degenen die meer willen begrijpen over de beschreven kwesties:
- over het werken met certificaten in de officiële Kubernetes-documentatie;
- , waarin het onderwerp certificaten vanuit een praktisch perspectief wordt behandeld.
- over authenticatie in Kubernetes.
Autorisatie
Standaard heeft het geautoriseerde account geen rechten om acties in de cluster uit te voeren. Voor het verlenen van machtigingen in Kubernetes is er een autorisatiemechanisme geïmplementeerd.
Tot versie 1.6 werd in Kubernetes een type autorisatie gebruikt dat ABAC (Attribute-based access control) wordt genoemd. Details hierover zijn te vinden in . Tegenwoordig wordt deze benadering als verouderd (legacy) beschouwd, maar je kunt het nog steeds gebruiken naast andere autorisatietypes.
De actuele (en flexibele) manier om toegangsrechten tot de cluster te scheiden wordt RBAC () genoemd. Het werd stabiel verklaard vanaf versie . RBAC implementeert een model van rechten, waarin alles verboden is dat niet expliciet is toegestaan.
Om RBAC in te schakelen,, moet je de Kubernetes api-server starten met de parameter --authorization-mode=RBAC. De parameters worden ingesteld in de manifest met de configuratie van de api-server, die standaard op het pad staat /etc/kubernetes/manifests/kube-apiserver.yaml, in de sectie command. Echter, standaard is RBAC al ingeschakeld, dus waarschijnlijk hoef je je daar niet veel zorgen over te maken: je kunt dit controleren aan de hand van de waarde authorization-mode (in het al eerder genoemde kube-apiserver.yaml). Trouwens, onder de waarden kunnen ook andere types autorisatie voorkomen (node, webhook, altijd toestaan), maar een behandeling hiervan laten we buiten beschouwing in dit materiaal.
Trouwens, we hebben eerder al gepubliceerd met een vrij gedetailleerde uitleg over de principes en kenmerken van werken met RBAC, dus daarna beperk ik me tot een korte opsomming van de basisprincipes en voorbeelden.
Voor het beheren van toegang in Kubernetes via RBAC worden de volgende API-entiteiten gebruikt:
-
RoleenClusterRole— rollen die dienen om de toegangsrechten te beschrijven: -
Rolebeschrijft de rechten binnen een naamruimte; -
ClusterRole— binnen het cluster, inclusief cluster-specifieke objecten zoals knooppunten, non-resource urls (dat wil zeggen, niet gerelateerd aan Kubernetes-resources — bijvoorbeeld,/version,/logs,/api*); -
RoleBindingenClusterRoleBinding— dient voor het bindenRoleenClusterRoleaan een gebruiker, een groep gebruikers of een ServiceAccount.
De entiteiten Role en RoleBinding zijn beperkt tot de namespace, dat wil zeggen dat ze binnen één naamruimte moeten zijn. RoleBinding kan echter verwijzen naar een ClusterRole, waardoor een set standaardrechten kan worden gemaakt en toegang daarmee kan worden beheerd.
Roles beschrijven rechten met behulp van sets regels, bestaande uit:
- API-groepen — zie over apiGroups en het commando
kubectl api-resources; - resources (geeft aan welke (resources) Kustomize zal wijzigen. In dit geval zal het resources zoeken in de bestanden:
pod,namespace,deploymentenzovoort); - werkwoorden (verbs:
set,updateetc.). - resource namen (
resourceNames) — voor het geval dat toegang moet worden verleend tot een specifieke resource en niet tot alle resources van dat type.
Een gedetailleerdere bespreking van autorisatie in Kubernetes is te vinden op de pagina . In plaats daarvan (of beter gezegd — ter aanvulling hiervan) geef ik voorbeelden die de werking ervan illustreren.
Voorbeelden van RBAC-entiteiten
Eenvoudig Role, waardoor je de lijst en status van pods kunt ophalen en deze kunt volgen in de naamruimte target-namespace:
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: target-namespace
  name: pod-reader
rules:
- apiGroups: [""]
  resources: ["pods"]
  verbs: ["get", "watch", "list"]
Voorbeeld ClusterRole, waardoor je de lijst en status van pods kunt ophalen en deze kunt volgen in het hele cluster:
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  # er is geen sectie "namespace", aangezien ClusterRole het hele cluster gebruikt
  name: secret-reader
rules:
- apiGroups: [""]
  resources: ["secrets"]
  verbs: ["get", "watch", "list"]
Voorbeeld RoleBinding, waardoor de gebruiker mynewuser "leest" pods in de naamruimte my-namespace:
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: read-pods
  namespace: target-namespace
subjects:
- kind: User
  name: mynewuser # de gebruikersnaam is hoofdlettergevoelig!
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role # hier moet “Role” of “ClusterRole” staan
  name: pod-reader # de naam van Role die zich in dezelfde namespace bevindt,
                   # of de naam van ClusterRole waarvan
                   # we willen dat de gebruiker deze gebruikt
  apiGroup: rbac.authorization.k8s.io
Audit van gebeurtenissen
De architectuur van Kubernetes kan schematisch als volgt worden gepresenteerd:
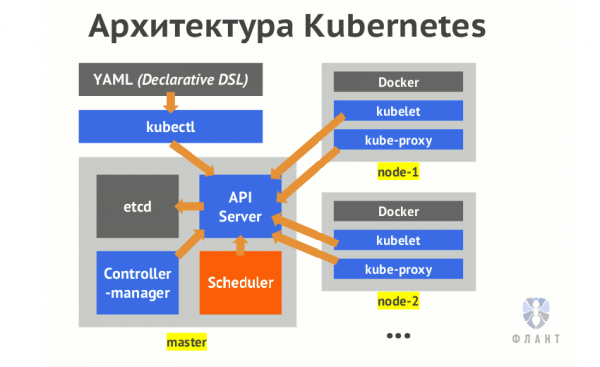
De sleutelcomponent van Kubernetes, verantwoordelijk voor het verwerken van verzoeken, is de api-server. Alle bewerkingen op het cluster verlopen via hem. Meer over deze interne mechanismen is te lezen in het artikel "».
Audit systemen is een interessante functie in Kubernetes, die standaard is uitgeschakeld. Het stelt je in staat om alle aanvragen aan de Kubernetes API te loggen. Zoals je gemakkelijk kunt raden, worden via deze API alle handelingen uitgevoerd die verband houden met het controleren en wijzigen van de status van de cluster. Een goede beschrijving van de mogelijkheden ervan is te vinden in K8s. Verder zal ik proberen het onderwerp in eenvoudigere taal uit te leggen.
So, Om auditing in te schakelen, moeten we de container in de api-server drie verplichte parameters doorgeven, waarvan meer details hieronder worden besproken:
-
--audit-policy-file=/etc/kubernetes/policies/audit-policy.yaml -
--audit-log-path=/var/log/kube-audit/audit.log -
--audit-log-format=json
Naast deze drie vereiste parameters zijn er veel extra instellingen gerelateerd aan auditing: van logrotatie tot beschrijvingen van webhook. Voorbeeldparameters voor logrotatie:
-
--audit-log-maxbackup=10 -
--audit-log-maxsize=100 -
--audit-log-maxage=7
Maar laten we hier niet verder op ingaan — alle details zijn te vinden in .
Zoals eerder vermeld, worden alle parameters ingesteld in de manifest met de configuratie van de api-server (standaard /etc/kubernetes/manifests/kube-apiserver.yaml), in de sectie command. Laten we terugkeren naar de drie verplichte parameters en deze bespreken:
-
audit-policy-file— het pad naar het YAML-bestand met de audit policy. We komen nog terug op de inhoud ervan, maar laten we opmerken dat het bestand toegankelijk moet zijn voor het api-server proces. Daarom moet het in de container worden gemonteerd, waarvoor de volgende code kan worden toegevoegd aan de relevante secties van de configuratie:volumeMounts: - mountPath: /etc/kubernetes/policies name: policies readOnly: true volumes: - hostPath: path: /etc/kubernetes/policies type: DirectoryOrCreate name: policies -
audit-log-path— het pad naar het logbestand. Het pad moet ook toegankelijk zijn voor het api-server proces, daarom beschrijven we op dezelfde manier de montage:volumeMounts: - mountPath: /var/log/kube-audit name: logs readOnly: false volumes: - hostPath: path: /var/log/kube-audit type: DirectoryOrCreate name: logs -
audit-log-format— het formaat van het auditlog. Standaard is ditjson, maar er is ook een verouderd tekstformaat beschikbaar (legacy).
Audit policy
Laten we nu het genoemde bestand met de beschrijving van de logbeleid bespreken. Het eerste begrip van audit policy is level, logniveau. Deze kunnen zijn:
-
None— niet loggen; -
Metadata— log de metadata van de aanvraag: gebruiker, tijd van aanvraag, doelfiche, (pod, namespace, enz.), actie type (verb), enz.; -
Request— log metadata en de body van de aanvraag; -
RequestResponse— log metadata, de body van de aanvraag en de body van de reactie.
De laatste twee niveaus (Request en RequestResponse) loggen geen verzoeken die niet zijn gericht aan bronnen (verzoeken aan zogenoemde non-resources urls).
Daarnaast doorlopen alle verzoeken meerdere stadia:
-
RequestReceived— de fase waarin het verzoek is ontvangen door de handler en nog niet verder is doorgegeven in de keten van handlers; -
ResponseStarted— de reactieheaders zijn verzonden, maar vóór de verzending van de body van de reactie. Dit wordt gegenereerd voor langdurige verzoeken (bijvoorbeeld,watch); -
ResponseComplete— de body van de reactie is verzonden, er zal geen verdere informatie worden verzonden; -
Panic— gebeurtenissen worden gegenereerd wanneer een ongewone situatie wordt gedetecteerd.
Om bepaalde stadia over te slaan, kan men omitStages.
In het beleidsdocument kunnen we verschillende secties beschrijven met verschillende niveaus van logging. De eerste geschikte regel die in de beschrijving van het beleid wordt gevonden, zal van toepassing zijn.
De kubelet demon houdt de veranderingen in het manifest met de configuratie van de api-server in de gaten en herstart de container met de api-server bij detectie van deze veranderingen. Maar er is een belangrijk detail: wijzigingen in het beleidsdocument zullen door hen worden genegeerd. Na wijzigingen in het beleidsdocument is het nodig om de api-server handmatig opnieuw op te starten. Aangezien de api-server is gestart als , het commando kubectl delete zal niet leiden tot een herstart. Men zal handmatig moeten doen docker stop op de kube-master nodes, waar het auditbeleid is gewijzigd:
docker stop $(docker ps | grep k8s_kube-apiserver | awk '{print $1}')Bij het inschakelen van audit is het belangrijk om te onthouden dat de belasting op de kube-apiserver toeneemt. In het bijzonder neemt het geheugengebruik voor het opslaan van de context van verzoeken toe. De logging begint pas na de verzending van de header van de reactie. Ook is de belasting afhankelijk van de configuratie van het auditbeleid.
Voorbeelden van beleidsdocumenten
Laten we de structuur van beleidsdocumenten aan de hand van voorbeelden bekijken.
Hier is een eenvoudig bestand policyom alles te loggen op niveau Metadata:
apiVersion: audit.k8s.io/v1
kind: Policy
rules:
- level: Metadata
In het beleidsdocument kan een lijst van gebruikers (Gebruikers en ServiceAccounts) en gebruikersgroepen worden opgegeven. Bijvoorbeeld, zo zullen we systeemgebruikers negeren, maar alles loggen op niveau Request:
apiVersion: audit.k8s.io/v1
kind: Policy
rules:
  - level: None
    userGroups:
      - "system:serviceaccounts"
      - "system:nodes"
    users:
      - "system:anonymous"
      - "system:apiserver"
      - "system:kube-controller-manager"
      - "system:kube-scheduler"
  - level: Request
Ook is er de mogelijkheid om doelgroepen te beschrijven:
- namenruimten (
namespaces); - werkwoorden (verbs:
krijgen,update,Verwijder afbeeldingenen anderen); - resources (geeft aan welke (resources) Kustomize zal wijzigen. In dit geval zal het resources zoeken in de bestanden, namelijk:
pod,configmapsenzovoort) en groepen middelen (apiGroups).
Let op! Hulpmiddelen en middelen groepen (API-groepen, d.w.z. apiGroups), evenals hun versies die in de cluster zijn geïnstalleerd, kunnen worden verkregen met de volgende opdracht:
kubectl api-resources
kubectl api-versions
Het volgende auditbeleid is een voorbeeld van beste praktijken in de :
apiVersion: audit.k8s.io/v1beta1
kind: Policy
# Niet loggen van de RequestReceived fase
omitStages:
  - "RequestReceived"
rules:
  # Niet loggen van gebeurtenissen die als onbeduidend en niet gevaarlijk worden beschouwd:
  - level: None
    users: ["system:kube-proxy"]
    verbs: ["watch"]
    resources:
      - group: "" # dit is de api groep met een lege naam, waar de
                  # basisbronnen van Kubernetes, de "core" genoemd, onder vallen
        resources: ["endpoints", "services"]
  - level: None
    users: ["system:unsecured"]
    namespaces: ["kube-system"]
    verbs: ["get"]
    resources:
      - group: "" # core
        resources: ["configmaps"]
  - level: None
    users: ["kubelet"]
    verbs: ["get"]
    resources:
      - group: "" # core
        resources: ["nodes"]
  - level: None
    userGroups: ["system:nodes"]
    verbs: ["get"]
    resources:
      - group: "" # core
        resources: ["nodes"]
  - level: None
    users:
      - system:kube-controller-manager
      - system:kube-scheduler
      - system:serviceaccount:kube-system:endpoint-controller
    verbs: ["get", "update"]
    namespaces: ["kube-system"]
    resources:
      - group: "" # core
        resources: ["endpoints"]
  - level: None
    users: ["system:apiserver"]
    verbs: ["get"]
    resources:
      - group: "" # core
        resources: ["namespaces"]
  # Niet loggen van verzoeken aan read-only URLs:
  - level: None
    nonResourceURLs:
      - /healthz*
      - /version
      - /swagger*
  # Niet loggen van berichten die betrekking hebben op het type bronnen "events":
  - level: None
    resources:
      - group: "" # core
        resources: ["events"]
  # Bronnen van het type Secret, ConfigMap en TokenReview kunnen gevoelige gegevens bevatten,
  # dus loggen we alleen de metadata van gerelateerde verzoeken
  - level: Metadata
    resources:
      - group: "" # core
        resources: ["secrets", "configmaps"]
      - group: authentication.k8s.io
        resources: ["tokenreviews"]
  # Acties van het type get, list en watch kunnen bronnen-intensief zijn; we loggen ze niet
  - level: Request
    verbs: ["get", "list", "watch"]
    resources:
      - group: "" # core
      - group: "admissionregistration.k8s.io"
      - group: "apps"
      - group: "authentication.k8s.io"
      - group: "authorization.k8s.io"
      - group: "autoscaling"
      - group: "batch"
      - group: "certificates.k8s.io"
      - group: "extensions"
      - group: "networking.k8s.io"
      - group: "policy"
      - group: "rbac.authorization.k8s.io"
      - group: "settings.k8s.io"
      - group: "storage.k8s.io"
  # Standaard logniveau voor standaard API-bronnen
  - level: RequestResponse
    resources:
      - group: "" # core
      - group: "admissionregistration.k8s.io"
      - group: "apps"
      - group: "authentication.k8s.io"
      - group: "authorization.k8s.io"
      - group: "autoscaling"
      - group: "batch"
      - group: "certificates.k8s.io"
      - group: "extensions"
      - group: "networking.k8s.io"
      - group: "policy"
      - group: "rbac.authorization.k8s.io"
      - group: "settings.k8s.io"
      - group: "storage.k8s.io"
  # Standaard logniveau voor alle andere verzoeken
  - level: Metadata
Een ander goed voorbeeld van audit policy — .
Er is een mogelijkheid voor snelle respons op audit gebeurtenissen beschrijf webhook. Dit onderwerp wordt verder besproken in , dit laat ik buiten het bereik van dit artikel.
Conclusies
In dit artikel wordt een overzicht gegeven van de mechanismen voor basisbeveiliging in Kubernetes-clusters, waarmee gepersonaliseerde accounts voor gebruikers kunnen worden aangemaakt, hun rechten kunnen worden verdeeld en hun acties kunnen worden geregistreerd. Ik hoop dat het nuttig zal zijn voor degenen die met dergelijke vragen in de theorie of in de praktijk zijn geconfronteerd. Ik raad ook aan om de lijst met andere materialen over veiligheid in Kubernetes te bekijken die in 'P.S.' is opgenomen - misschien vindt u daarin de benodigde details over de actuele problemen die u heeft.
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «»;
- «».
Bron: habr.com
