

KDB+, een product van het bedrijf is een in bepaalde kringen zeer bekende, uitzonderlijk snelle kolomdatabase, ontworpen voor het opslaan van tijdreeksen en analytische berekeningen op basis daarvan. Oorspronkelijk genoot het vooral veel populariteit in de financiële sector - het wordt gebruikt door alle top-10 investeringsbanken en veel bekende hedgefondsen, beurzen en andere organisaties. Recentelijk heeft KX besloten om de klantenbasis uit te breiden en biedt nu ook oplossingen aan in andere gebieden met een grote hoeveelheid data, georganiseerd op tijd of op andere manieren – telecommunicatie, bio-informatica, productie, enzovoort. Ze zijn ook een partner van het Aston Martin Red Bull Racing-team in de ‘Formule 1’, waar ze helpen bij het verzamelen en verwerken van gegevens van de sensors van de raceauto’s en het analyseren van testen in de windtunnel. In dit artikel wil ik uitleggen welke kenmerken KDB+ extreem efficiënt maken, waarom bedrijven bereid zijn er veel geld aan uit te geven, en vooral, waarom dit echt geen database is.
In dit artikel zal ik proberen een algemeen beeld te schetsen van wat KDB+ is, welke mogelijkheden en beperkingen het heeft, en wat de voordelen zijn voor bedrijven die grote hoeveelheden gegevens willen verwerken. Ik zal niet ingaan op de details van de implementatie van KDB+ en op de details van de programmeertaal Q. Deze twee onderwerpen zijn zeer uitgebreid en verdienen aparte artikelen. Veel informatie over deze onderwerpen is te vinden op de website code.kx.com, inclusief het boek over Q - Q For Mortals (zie de link hieronder).
Enkele termen
- In-memory database. Een database die gegevens opslaat in het RAM voor snellere toegang. De voordelen van zo'n database zijn duidelijk, maar de nadelen zijn de kans op dataverlies en de noodzaak om veel geheugen op de server te hebben.
- Kolomdatabase. Een database waar gegevens kolomgewijs worden opgeslagen in plaats van record voor record. Het belangrijkste voordeel van zo'n database is dat gegevens uit één kolom samen op de schijf en in het geheugen worden opgeslagen, wat de toegang aanzienlijk versnelt. Het is niet nodig om kolommen te laden die niet in de query worden gebruikt. Het belangrijkste nadeel is dat het moeilijk is om records te modificeren en te verwijderen.
- Tijdreeks. Gegevens met een kolom van het type datum of tijd. In de regel is de volgorde in de tijd belangrijk voor dergelijke gegevens, zodat je gemakkelijk kunt bepalen welke opname voorafgaat aan of volgt op de huidige, of om functies toe te passen waarvan het resultaat afhankelijk is van de volgorde van de opnames. Klassieke databases zijn gebaseerd op een heel ander principe — de weergave van een verzameling opnames als een set, waarbij de volgorde van de opnames in principe niet is gedefinieerd.
- Vector. In de context van KDB+ — dit is een lijst van elementen van één atomair type, bijvoorbeeld getallen. Met andere woorden, een array van elementen. In tegenstelling tot lijsten kunnen arrays compact worden opgeslagen en worden verwerkt met behulp van vectorinstructies van de processor.
Historische achtergrond
Het bedrijf KX werd in 1993 opgericht door Arthur Whitney, die eerder bij Morgan Stanley werkte aan de taal A+, de opvolger van APL — een zeer originele en destijds populaire taal in de financiële wereld. Uiteraard ging Arthur bij KX verder in dezelfde geest en creëerde hij de vector-functionele taal K, geleid door de ideeën van radicale minimalisme. Programma's in K zien eruit als een chaotische reeks leestekens en speciale symbolen, de betekenis van de symbolen en functies is contextafhankelijk, en elke bewerking bevat veel meer betekenis dan in gebruikelijke programmeertalen. Hierdoor neemt een programma in K minimaal ruimte in — een paar regels kunnen pagina's tekst van een omslachtige taal zoals Java vervangen — en is het een supergeconcentreerde uitvoering van het algoritme.
Een functie in K die het grootste deel van de LL1-parser-generator implementeert op basis van de gegeven grammatica:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Deze filosofie van extreme efficiëntie met minimale bewegingen heeft Arthur ook geïmplementeerd in KDB+, dat in 2003 werd geïntroduceerd (ik denk dat het nu duidelijk is waar de letter K in de naam vandaan komt) en niets anders is dan een interpreter van de vierde versie van de K-taal. Bovenop K is een gebruiksvriendelijkere versie van K toegevoegd, genaamd Q. In Q is ook ondersteuning toegevoegd voor een specifieke SQL-dialect — QSQL, en in de interpreter — ondersteuning voor tabellen als systeemdatatypes, middelen voor het werken met tabellen in het geheugen en op schijf, enzovoort.
Dus, vanuit het perspectief van de gebruiker is KDB+ eenvoudigweg een interpreter van de Q-taal met ondersteuning voor tabellen en SQL-achtige expressies in de stijl van LINQ uit C#. Dit is het belangrijkste onderscheid van KDB+ ten opzichte van andere databases en haar belangrijkste concurrentievoordeel, dat vaak over het hoofd wordt gezien. Het is geen database + een hulptaal, maar een volwaardige krachtige programmeertaal + ingebouwde ondersteuning voor databasefuncties. Dit onderscheid zal een bepalende rol spelen bij het opsommen van alle voordelen van KDB+. Bijvoorbeeld...
Grootte
Volgens moderne maatstaven heeft KDB+ gewoonweg een microscopische grootte. Dit is in letterlijke zin één uitvoerbaar bestand van minder dan een megabyte en één klein tekstbestand met enkele systeemfuncties. Echt — minder dan één megabyte, en bedrijven betalen tientallen duizenden dollars per jaar voor één processor op de server voor dit programma.
- Een dergelijke grootte stelt KDB+ in staat om prima te functioneren op elke hardware — van de microcomputer Pi tot servers met terabytes aan geheugen. Dit heeft geen invloed op de functionaliteit; sterker nog, Q start onmiddellijk op, wat het ook mogelijk maakt om het als een scripttaal te gebruiken.
- Bij zo'n formaat past de Q-interpreter volledig in de procesorkern, wat de uitvoering van programma's versnelt.
- Met zo'n grootte neemt het uitvoerbare bestand van Q verwaarloosbaar weinig ruimte in het geheugen in beslag; je kunt ze honderden tegelijk draaien. Bovendien kan Q indien nodig ook tientallen tot honderden gigabytes geheugen gebruiken binnen één proces.
Veelzijdigheid
Q is uitermate geschikt voor verschillende taken. Het Q-proces kan fungeren als een historische database en biedt snelle toegang tot terabytes aan informatie. Wij hebben bijvoorbeeld tientallen historische databases, waarvan sommige één ongecomprimeerde dag aan gegevens meer dan 100 gigabyte innemen. Desondanks zal een verzoek aan de database, binnen redelijke grenzen, worden uitgevoerd in tientallen tot honderden milliseconden. Over het algemeen hebben we een universele time-out voor gebruikersverzoeken van 30 seconden, en dit gebeurt heel zelden.
Met evenveel gemak kan Q een in-memory database zijn. Het toevoegen van nieuwe gegevens aan de tabellen in het geheugen gaat zo snel dat de beperkende factor de verzoeken van gebruikers zijn. Gegevens in de tabellen worden kolomgewijs opgeslagen, wat betekent dat elke kolomoperatie de processorcache optimaal benut. Bovendien heeft KX geprobeerd om alle basisbewerkingen, zoals rekenkundige, via vectorinstructies van de processor te implementeren, om hun snelheid te maximaliseren. Q kan ook taken uitvoeren die niet typisch zijn voor databases, bijvoorbeeld het verwerken van streaminggegevens en het in 'realtime' (met vertraging van enkele tientallen milliseconden tot enkele seconden, afhankelijk van de taak) berekenen van verschillende aggregatiefuncties voor financiële instrumenten over verschillende tijdsintervallen, of het bouwen van een model van de impact van een voltooide transactie op de markt en het profileren ervan vrijwel onmiddellijk na voltooiing. Bij dergelijke taken is het vaak het geval dat de grootste vertraging niet door Q wordt veroorzaakt, maar door de noodzaak om gegevens uit verschillende bronnen te synchroniseren. Hoge snelheid wordt bereikt doordat de gegevens en de functies die deze verwerken, zich in hetzelfde proces bevinden, en de verwerking beperkt is tot het uitvoeren van enkele QSQL-expressies en joins, die niet geïnterpreteerd maar uitgevoerd worden in binaire code.
Ten slotte kan je op Q ook elke serviceprocessen schrijven. Bijvoorbeeld Gateway-processen die automatisch gebruikersverzoeken verdelen over de juiste databases en servers. De programmeur heeft volledige vrijheid om elk algoritme voor balans, prioritering, fouttolerantie, toegangsrechten, quota en eigenlijk alles wat je maar wilt te implementeren. Het grootste probleem hierbij is dat je dit allemaal zelf moet implementeren.
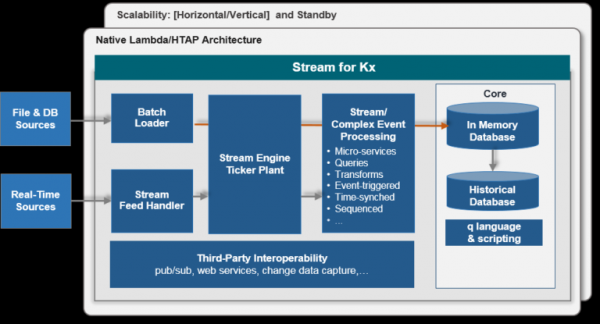
Ter illustratie noem ik een paar procestypes die we hebben. Al deze processen worden actief gebruikt en werken samen, waarbij ze tientallen verschillende databases combineren, gegevens uit meerdere bronnen verwerken en honderden gebruikers en applicaties bedienen.
- Connectoren (feedhandler) voor gegevensbronnen. Deze processen maken doorgaans gebruik van externe bibliotheken die in Q worden geladen. De C-interface in Q is bijzonder eenvoudig en maakt het gemakkelijk om proxyfuncties te creëren voor elke C/C++-bibliotheek. Q is snel genoeg om bijvoorbeeld de verwerking van een stroom FIX-berichten van alle Europese beursmarkten tegelijk aan te kunnen.
- Gegevensdistributeurs (tickerplant), die fungeren als tussenstation tussen connectoren en consumenten. Tegelijkertijd schrijven ze de binnenkomende gegevens in een speciale binaire log, waardoor consumenten bestand zijn tegen verbindingsverlies of herstarts.
- In-memory databases (rdb). Deze databases bieden de snelst mogelijke toegang tot verse ruwe gegevens door ze in het geheugen op te slaan. Gewoonlijk accumuleren ze gegevens in tabellen gedurende de dag en resetten ze 's nachts.
- Persist databases (pdb). Deze databases zorgen ervoor dat gegevens van de huidige dag worden opgeslagen in een historische database. Gewoonlijk, in tegenstelling tot rdb, slaan ze geen gegevens in het geheugen op, maar gebruiken ze een speciale cache op de schijf gedurende de dag en kopiëren ze de gegevens middernacht naar de historische database.
- Historische databases (hdb). Deze databases bieden toegang tot gegevens van voorgaande dagen, maanden en jaren. De omvang ervan (in dagen) is slechts beperkt door de grootte van de harde schijven. Gegevens kunnen overal zijn opgeslagen, waaronder op verschillende schijven om de toegang te versnellen. Er is de mogelijkheid om gegevens te comprimeren met behulp van verschillende algoritmen naar keuze. De database-structuur is goed gedocumenteerd en eenvoudig, gegevens worden kolom voor kolom in gewone bestanden opgeslagen, zodat ze ook met besturingssystemen kunnen worden verwerkt.
- Databanken met geaggregeerde informatie. Deze slaan verschillende aggregaties op, meestal gegroepeerd op instrumentnaam en tijdsintervallen. In-memory databases actualiseren hun status bij elk binnenkomend bericht, terwijl historische databases vooraf berekende gegevens opslaan voor snellere toegang tot historische gegevens.
- Ten slotte, gateway-processen, die applicaties en gebruikers ondersteunen. Q maakt het mogelijk om volledig asynchrone verwerking van binnenkomende berichten te realiseren, ze over databases te verdelen, toestemming te verifiëren, enzovoort. Ik wil opmerken dat berichten niet beperkt zijn en meestal geen SQL-uitdrukkingen zijn, zoals het geval kan zijn met andere databases. Meestal wordt de SQL-uitdrukking verborgen in een speciale functie en geconstrueerd op basis van de parameters die door de gebruiker zijn opgevraagd — tijdsconversie wordt uitgevoerd, filtering, gegevens worden genormaliseerd (bijvoorbeeld, aandelenprijzen worden aangepast als er dividenduitkeringen zijn geweest), enzovoort.
Typische architectuur voor één type gegevens:
Snelheid
Hoewel Q een geïnterpreteerde taal is, is het tegelijkertijd een vectoriële taal. Dit betekent dat veel ingebouwde functies, met name wiskundige, argumenten van elke vorm kunnen aannemen — getallen, vectoren, matrices, lijsten, en van de programmeur wordt verwacht dat hij het programma als operaties op arrays implementeert. In zo’n taal, als je twee vectoren met een miljoen elementen optelt, maakt het niet meer uit dat de taal geïnterpreteerd is, de som zal worden uitgevoerd door een supergeoptimaliseerde binaire functie. Aangezien het merendeel van de tijd in Q-programma's wordt besteed aan operaties met tabellen die deze fundamentele vectorisatiefuncties gebruiken, hebben we een behoorlijk goede verwerkingssnelheid, die het mogelijk maakt om enorme hoeveelheden gegevens zelfs in één proces te verwerken. Dit lijkt op wiskundige bibliotheken in Python — hoewel Python zelf een vrij trage taal is, zijn er veel uitstekende bibliotheken, zoals numpy, die de verwerking van numerieke gegevens mogelijk maken met de snelheid van een gecompileerde taal (overigens is numpy ideologisch verwant aan Q).
Daarnaast is KX zeer zorgvuldig geweest in het ontwerpen van tabellen en het optimaliseren van het werken ermee. Ten eerste worden verschillende soorten indexen ondersteund, die worden ondersteund door ingebouwde functies en kunnen worden toegepast op niet alleen de kolommen van tabellen, maar ook op elke vector — groepering, sortering, uniekheidsattributen en speciale groepering voor historische databases. De index wordt eenvoudig toegepast en automatisch gecorrigeerd bij het toevoegen van elementen aan de kolom/vector. Indexen kunnen met evenveel succes worden toegepast op kolommen van tabellen, zowel in het geheugen als op schijf. Bij het uitvoeren van QSQL-query's worden indexen automatisch gebruikt, indien mogelijk. Ten tweede wordt het werken met historische gegevens gerealiseerd via het mechanisme voor het weergeven van bestandsbesturingssystemen (memory map). Grote tabellen worden nooit volledig in het geheugen geladen; in plaats daarvan worden de benodigde kolommen direct in het geheugen weergegeven en wordt alleen dat deel geladen wat nodig is (waarbij indexen ook helpen). Voor de programmeur maakt het niet uit of de gegevens in het geheugen zijn of niet, het werkingsmechanisme van mmap is volledig verborgen in de diepten van Q.
KDB+ is een niet-relationele database, tabellen kunnen willekeurige gegevens bevatten, waarbij de volgorde van de rijen in de tabel niet verandert bij het toevoegen van nieuwe elementen en kan en moet worden gebruikt bij het schrijven van queries. Deze eigenschap is cruciaal voor het werken met tijdreeksen (gegevens van beurzen, telemetrie, gebeurtenislogs), omdat als de gegevens op tijd zijn gesorteerd, de gebruiker geen SQL-trucs hoeft te gebruiken om de eerste of laatste rij in de tabel of N rijen te vinden, te bepalen welke rij volgt op de N-de rij, enzovoorts. Joins van tabellen worden nog eenvoudiger, bijvoorbeeld het vinden van de laatste notering in de tabel voor 16000 transacties van VOD.L (Vodafone) neemt ongeveer een seconde op schijf en een tiental milliseconden in het geheugen in beslag.
Een voorbeeld van een join op tijd — de quote-tabel wordt in het geheugen weergegeven, waardoor het niet nodig is om VOD.L in de where op te geven, de index op de sym-kolom en het feit dat de gegevens op tijd zijn gesorteerd worden impliciet gebruikt. Bijna alle joins in Q zijn gewone functies, en geen deel van een select-expressie:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Ten slotte is het vermeldenswaard dat de ingenieurs bij KX, met inbegrip van Arthur Whitney, echt gepassioneerd zijn over efficiëntie en alles doen om het maximale uit de standaardfuncties van Q te halen en de meest voorkomende gebruikspatronen te optimaliseren.
Conclusie
KDB+ is vooral populair bij bedrijven vanwege zijn uitzonderlijke veelzijdigheid — het fungeert zowel als in-memory database, als opslag voor terabytes aan historische gegevens, en als platform voor data-analyse. Doordat de dataverwerking rechtstreeks in de database plaatsvindt, worden hoge verwerkingsefficiëntie en besparing van middelen bereikt. Een volwaardige programmeertaal, geïntegreerd met de databasefuncties, stelt gebruikers in staat om op één platform de gehele benodigde processtapel te realiseren — van gegevensverzameling tot het verwerken van gebruikersverzoeken.
Aanvullende informatie
Nadelen
Een aanzienlijk nadeel van KDB+/Q is de hoge instapdrempel. De taal heeft een vreemde syntaxis, sommige functies zijn sterk overbelast (zoals value, dat zo'n 11 gebruiksvarianten heeft). Het belangrijkste is dat het een radicale andere benadering van programmeren vereist. In de vector taal moet je continu denken in termen van array-transformaties, en alle loops via verschillende types van map/reduce functies (die adverbs in Q worden genoemd) implementeren, daarbij nooit proberen te besparen door vectoroperaties te vervangen door atomische. Bijvoorbeeld, om de index van het N-de voorkomen van een element in een array te vinden, moet je schrijven:
1. (where element=vector)[N]
ook al lijkt dit vreselijk inefficiënt vergeleken met C/Java (= het creëert een booleaanse vector, waar where de indexen van true elementen teruggeeft). Maar deze schrijfwijzen maken de betekenis van de expressie duidelijker en je maakt gebruik van snelle vectoroperaties in plaats van langzame atomische. Het conceptuele verschil tussen de vector taal en andere talen is vergelijkbaar met het verschil tussen imperatieve en functionele programmeerbenaderingen, en daar moet je op voorbereid zijn.
Sommige gebruikers zijn ook ontevreden over QSQL. Het punt is dat het slechts lijkt op echte SQL. In werkelijkheid is het simpelweg een interpreter voor SQL-achtige uitdrukkingen die geen query-optimalisatie ondersteunt. De gebruiker moet zelf optimale queries schrijven, en dat in Q, waar velen niet op voorbereid zijn. Aan de andere kant is het natuurlijk altijd mogelijk om zelf een optimale query te schrijven in plaats van op een zwart-doos optimalisator te vertrouwen.
Een voordeel is dat het boek over Q — Q For Mortals gratis beschikbaar is op , waar ook veel andere nuttige materialen zijn verzameld.
Een ander groot nadeel is de licentiekosten. Dit zijn tienduizenden dollars per jaar per CPU. Alleen grote bedrijven kunnen dergelijke uitgaven zich veroorloven. Recent heeft KX het licentiebeleid flexibeler gemaakt en biedt het de mogelijkheid om alleen te betalen voor gebruikstijd of KDB+ in de cloud van Google en Amazon te huren. KX biedt ook een (32-bit versie of 64-bit versie op aanvraag).
Concurrenten
Er zijn behoorlijk wat gespecialiseerde databases die zijn opgebouwd op vergelijkbare principes — kolomgeoriënteerd, in-memory, gericht op zeer grote datavolumes. Het probleem is dat dit echt gespecialiseerde databases zijn. Een sprekend voorbeeld hiervan is Clickhouse. Deze database heeft een opslagprincipe op schijf dat erg lijkt op KDB+ en de bouw van indexen; sommige queries voert het sneller uit dan KDB+, hoewel niet significant. Maar zelfs als database is Clickhouse meer gespecialiseerd dan KDB+ — webanalyse versus willekeurige tijdreeksen (dit onderscheid is erg belangrijk — hierdoor is er bijvoorbeeld in Clickhouse geen mogelijkheid om gebruik te maken van de volgorde van records). Maar het belangrijkste is dat Clickhouse de veelzijdigheid van KDB+ mist, de taal die het mogelijk maakt om gegevens rechtstreeks in de database te verwerken in plaats van ze vooraf in een aparte applicatie te laden, willekeurige SQL-uitdrukkingen op te bouwen, willekeurige functies in de query toe te passen en processen te creëren die niet verbonden zijn met de uitvoering van functies van de historische database. Daarom is het moeilijk om KDB+ met andere databases te vergelijken; ze kunnen beter zijn in specifieke gebruiksscenario's of gewoon beter als het gaat om klassieke database taken, maar ik ken geen andere tool die zo effectief en veelzijdig is voor het verwerken van tijdsgebonden data.
Integratie met Python
Om het werken met KDB+ te vereenvoudigen voor mensen die niet vertrouwd zijn met de technologie, heeft KX bibliotheken ontwikkeld voor nauwe integratie met Python binnen één proces. Je kunt elke Python-functie vanuit Q aanroepen en vice versa — elke Q-functie vanuit Python aanroepen (in het bijzonder QSQL-uitdrukkingen). De bibliotheken converteren indien nodig (voor de efficiëntie niet altijd) gegevens van het ene taalformaat naar het andere. Uiteindelijk leven Q en Python in zo'n nauwe symbiose dat de grenzen tussen hen vervagen. Hierdoor heeft de programmeur enerzijds volledige toegang tot talrijke nuttige Python-bibliotheken, terwijl hij anderzijds een geïntegreerde, snelle database krijgt voor het werken met big data, wat vooral nuttig is voor degenen die zich bezighouden met machine learning of modellering.
Werken met Q in Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Links
Bedrijfssite —
Ontwikkelaarssite —
Boek Q For Mortals (in het Engels) —
Artikelen over toepassingen van KDB+/Q door medewerkers van kx —
Bron: habr.com
