

Hoe kunnen zakelijke vereisten worden omgezet in specifieke datastructuren aan de hand van het ontwerpen van een database voor een messenger ‘from scratch’?
- Deel 1: we ontwerpen de basisstructuur van de database
Onze database zal niet zo grootschalig en gedistribueerd zijn, of , maar ‘zodat het er is’, zoals het goed is — functioneel, snel en past op één server PostgreSQL — zodat we een aparte instantie van de service ergens aan de zijkant kunnen uitrollen, bijvoorbeeld.
Daarom zullen we geen vragen over sharding, replicatie en geografisch gedistribueerde systemen behandelen, maar ons concentreren op schematische oplossingen binnen de database.
Stap 1: Een beetje zakelijke specificiteit
Onze berichtwisseling gaan we niet abstract ontwerpen, maar integreren in de omgeving van een . Dat wil zeggen, mensen ‘ruilen gewoon berichten uit’, maar communiceren met elkaar in de context van het oplossen van specifieke zakelijke taken.
Wat voor taken heeft een bedrijf?.. Laten we kijken naar het voorbeeld van Vasily — de leidinggevende van de ontwikkelingsafdeling.
- ‘Nikolay, voor deze taak is de patch al vandaag nodig!’
Dat betekent dat de correspondentie kan plaatsvinden in de context van een Inkomstenstructuur van een PhD-student en Post-Doc aan de EPFL. - ‘Kolya, laten we vanavond Dota spelen?’
Dat wil zeggen, zelfs bij één paar gesprekspartners kan de communicatie gelijktijdig plaatsvinden over verschillende onderwerpen. - ‘Peter, Nikolay, kijk naar de bijlage voor de prijs van de nieuwe server.’
Dus een bericht kan meerdere ontvangers hebben. Daarbij kan een bericht bijlagen bevatten. - ‘Semen, jij ook even kijken.’
En er moet de mogelijkheid zijn om in een bestaande correspondentie een nieuwe deelnemer uit te nodigen.
Laten we voor nu bij deze lijst van ‘voor de hand liggende’ behoeften blijven.
Zonder begrip van de toegepaste specificiteit van de taak en de gestelde beperkingen is het praktisch onmogelijk om een effectieve databasestructuur voor de oplossing ervan te ontwerpen.
Stap 2: Minimale logische schema
Het schema lijkt voorlopig zeer op e-mailcommunicatie — een traditioneel hulpmiddel voor zakelijk beheer. Inderdaad, ‘algoritmisch’ zijn veel zakelijke taken vergelijkbaar, waardoor ook de hulpmiddelen voor hun oplossingen structureel overeenkomen.
Laten we het al verkregen logische schema van de relaties tussen entiteiten vastleggen. Voor de eenvoud van ons model zullen we de meest primitieve weergave gebruiken van zonder complicaties van UML of IDEF-notaties:
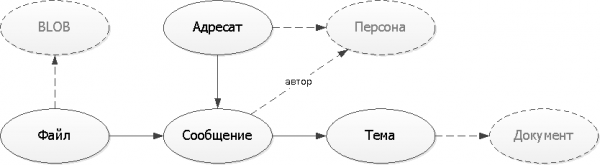
In ons voorbeeld zijn de entiteiten persoon, document en binaire "lichaam" van het bestand "externe" eenheden die zelfstandig bestaan en onafhankelijk van onze service. Daarom nemen we ze in de vervolg gewoon waar als verwijzingen "ergens" via UUID.
Teken schema's zo eenvoudig mogelijk — de meeste mensen aan wie je ze laat zien zijn geen experts in het lezen van UML/IDEF. Maar — teken zeker.
Stap 3: We schetsen de structuur van de tabellen
Over de namen van tabellen en veldenMen kan op verschillende manieren naar "Russische" namen van velden en tabellen kijken, maar dat is een kwestie van smaak. Aangezien geen buitenlandse ontwikkelaars hebben, en PostgreSQL ons toestaat om namen zelfs in hiërogliefen te geven, als ze tussen aanhalingstekensstaan, geven we de voorkeur aan eenduidige namen voor objecten zodat er geen misverstanden ontstaan.
Aangezien berichten door veel mensen tegelijkertijd worden geschreven, kunnen sommige dit zelfs in offline-modus, is de eenvoudigste optie om UUID te gebruiken als identificatoren niet alleen voor externe entiteiten, maar ook voor alle objecten binnen onze service. Bovendien kunnen ze zelfs aan de clientzijde worden gegenereerd — dit helpt ons om de verzending van berichten te ondersteunen bij korte onbeschikbaarheid van de database, en de kans op een botsing is uiterst klein.
De ruwe structuur van de tabellen in onze database zal er als volgt uitzien:
Tabellen : RU
CREATE TABLE "Thema"(
  "Thema"
    uuid
      PRIMARY KEY
, "Document"
    uuid
, "Titel"
    text
);

CREATE TABLE "Bericht"(
  "Bericht"
    uuid
      PRIMARY KEY
, "Thema"
    uuid
, "Auteur"
    uuid
, "DatumTijd"
    timestamp
, "Tekst"
    text
);

CREATE TABLE "Adressee"(
  "Bericht"
    uuid
, "Persoon"
    uuid
, PRIMARY KEY("Bericht", "Persoon")
);

CREATE TABLE "Bestand"(
  "Bestand"
    uuid
      PRIMARY KEY
, "Bericht"
    uuid
, "BLOB"
    uuid
, "Naam"
    text
);
Tabellen : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Het gemakkelijkste bij het beschrijven van het formaat is te beginnen met "ontknopen" het netwerk van relaties van tabellen die niet naar iets anders verwijzen. Stap 4: We ontdekken niet-overduidelijke behoeften
Dat is alles, we hebben een database ontworpen die uitstekend is voor schrijven en
op een bepaalde manier lezen. lezen.
Laten we ons inleven in de gebruiker van onze dienst — wat willen we daarmee doen?
- Laatste berichten
Dit is chronologisch gesorteerd een register van "mijn" berichten op verschillende criteria. Waar ik een van de ontvangers ben, waar ik de auteur ben, waar iemand mij heeft geschreven en ik niet heb geantwoord, waar ik niet ben geantwoord, … - Deelnemers aan de correspondentie
Wie doet er eigenlijk mee aan deze lange chat?
Onze structuur kan beide taken "in het algemeen" oplossen, maar snel — nee. Het probleem is dat voor het sorteren binnen de eerste taak het onmogelijk is een index te creëren, geschikt voor elke deelnemer (en we zullen alle berichten moeten extraheren), en om de tweede op te lossen, is het noodzakelijk alle berichten over het onderwerp te extraheren.
Onvoorziene gebruikersvragen kunnen een zware streep zetten door de prestaties.
Stap 5: Redelijke denormalisatie
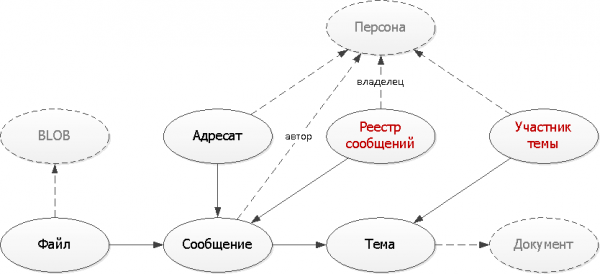
Beide problemen worden geholpen door extra tabellen waarin we een deel van de gegevens, die nodig zijn voor het vormen van geschikte indices voor onze taken, dupliceren.
Tabellen : RU
CREATE TABLE "BerichtenRegister"(
  "Eigenaar"
    uuid
, "TypeRegister"
    smallint
, "DatumTijd"
    timestamp
, "Bericht"
    uuid
, PRIMARY KEY("Eigenaar", "TypeRegister", "Bericht")
);
CREATE INDEX ON "BerichtenRegister"("Eigenaar", "TypeRegister", "DatumTijd" DESC);

CREATE TABLE "DeelnemerOnderwerp"(
  "Onderwerp"
    uuid
, "Persoon"
    uuid
, PRIMARY KEY("Onderwerp", "Persoon")
);
Tabellen : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Hier hebben we twee typische benaderingen toegepast die vaak gebruikt worden bij het creëren van ondersteunende tabellen:
- Vermenigvuldiging van records
We creëren uit één oorspronkelijke bericht direct meerdere gevolgrecords in verschillende soorten registers voor verschillende eigenaren — zowel voor de afzender als voor de ontvanger. Nu komt elke register echter op een index — want in de typische situatie willen we alleen de eerste pagina zien. - Unificatie van records
Bij iedere verzending van een bericht binnen een specifiek onderwerp is het genoeg om te controleren of zo'n record al bestaat. Als dat niet het geval is, voegen we het toe aan ons "woordenboek".
In het volgende deel van het artikel zullen we het hebben over in de structuur van onze database.
Bron: habr.com
