

Hallo, onlangs kreeg ik een interessante uitdaging om een opslag voor de backup van een groot aantal block devices te configureren.
Elke week maken we een back-up van alle virtuele machines in onze cloud, waardoor we in staat moeten zijn om duizenden back-ups te beheren en dit zo snel en efficiënt mogelijk te doen.
Helaas zijn standaardconfiguraties RAID5, RAID6 in dit geval niet geschikt omdat het herstelproces op zulke grote schijven als de onze uiterst traag zal zijn en waarschijnlijk nooit zal eindigen.
Laten we kijken naar de alternatieven:
— Een equivalent van RAID5, RAID6, maar met een instelbaar pariteitsniveau. Hierbij wordt de redundantie niet blockgewijs uitgevoerd, maar voor elk object afzonderlijk. De eenvoudigste manier om erasure coding uit te proberen, is door .
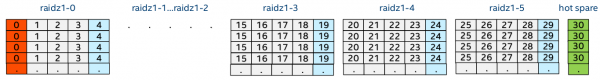
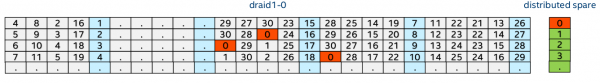
— dit is op dit moment nog niet vrijgegeven in ZFS. In tegenstelling tot RAIDZ heeft DRAID een gedistribueerd pariteitsblok en maakt bij herstel gebruik van alle schijven in de array, waardoor het beter bestand is tegen schijfstoringen en sneller herstelt na een storing.
We hebben de server Fujitsu Primergy RX300 S7 met een processor Intel Xeon CPU E5-2650L 0 @ 1.80GHz, negen modules werkgeheugen Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), een schijfbehuizing Supermicro SuperChassis 847E26-RJBOD1, aangesloten via Dual LSI SAS2X36 Expander en 45 schijven Seagate ST6000NM0115-1YZ110 voor 6TB elke.
Voordat we iets beslissen, moeten we eerst alles goed testen.
Daarvoor heb ik me voorbereid en ik heb verschillende configuraties getest. Hiervoor heb ik minio gebruikt, dat fungeerde als S3-backend en heb het in verschillende modi met verschillende aantallen targets gedraaid.
Meestal werd de case van minio in erasure coding versus software raid met hetzelfde aantal schijven en pariteitsschijven getest, namelijk: RAID6, RAIDZ2 en DRAID2.
Ter informatie: wanneer je minio met slechts één target start, werkt minio in de modus van een S3-gateway die je lokale bestandssysteem als S3-opslag aanbiedt. Als je echter minio start met meerdere targets, wordt automatisch de modus Erasure Coding ingeschakeld, die gegevens verspreidt over je targets met het bieden van fouttolerantie.
Standaard verdeelt MinIO doelwitten in groepen van 16 schijven, waarbij elke groep 2 pariteit heeft. Dit betekent dat er tegelijkertijd twee schijven kunnen falen zonder gegevensverlies.
Voor prestatietests gebruikte ik 16 schijven van elk 6 TB en schreef ik kleine objecten van 1 MB op deze schijven. Dit beschreef onze toekomstige belasting het nauwkeurigst, aangezien alle moderne back-uptools gegevens in blokken van enkele megabytes splitsen en deze vervolgens op deze manier schrijven.
Voor het uitvoeren van de benchmark werd de tool s3bench gebruikt, die op een externe server draait en tienduizenden van zulke objecten naar MinIO verzendt in honderden stromen. Daarna werd geprobeerd om ze op dezelfde manier terug te vragen.
De resultaten van de benchmark zijn in de volgende tabel weergegeven:
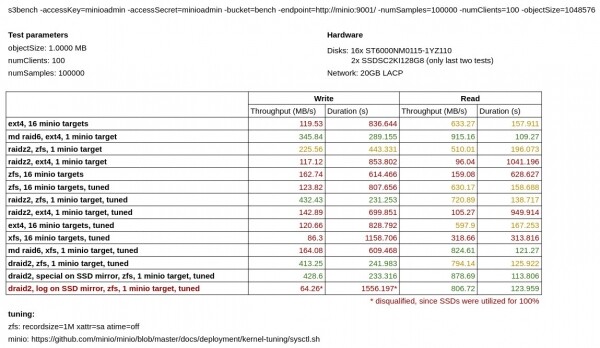
Zoals we zien, werkt MinIO in de modus van eigen erasure coding aanzienlijk slechter op writing dan MinIO dat draait bovenop software RAID6, RAIDZ2 en DRAID2 in dezelfde configuratie.
Separaat werd ik om MinIO op ext4 vs XFS te testen. Verassend genoeg bleek XFS voor mijn type belasting aanzienlijk trager dan ext4.
In de eerste reeks tests toonde MDADM superioriteit boven ZFS, maar later , dat de prestaties van ZFS verbeterd konden worden door de volgende opties in te stellen:
xattr=sa atime=off recordsize=1Men daarna werden de tests met ZFS veel beter.
Ook kan worden opgemerkt dat DRAID geen bijzondere prestatiewinst geeft ten opzichte van RAIDZ, maar theoretisch gezien zou het veel veiliger moeten zijn.
In de laatste twee tests probeerde ik ook de metadata (special) en ZIL (log) naar een spiegel van SSD's te verplaatsen. Maar het verplaatsen van de metadata gaf geen significante snelheidswinst bij het schrijven, en bij het verplaatsen van de ZIL bereikte ik een plafond met 100% benutting, dus beschouw ik deze test als mislukt. Ik sluit niet uit dat als ik snellere SSD's had gehad, dit mijn resultaten aanzienlijk had kunnen verbeteren, maar helaas had ik ze niet.
Uiteindelijk besloot ik om bij DRAID te blijven en ondanks zijn bètastatus is het de snelste en meest effectieve oplossing voor opslag in ons geval.
Ik creëerde een eenvoudige DRAID2-configuratie met drie groepen en twee distributed spares:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Goed, dat is het opslaggedeelte. Nu over wat we gaan gebruiken voor back-ups. Hier wil ik graag drie oplossingen benoemen die ik heb kunnen proberen, namelijk:
— een fork , een gespecialiseerde oplossing voor het back-uppen van blokapparaten, heeft een nauwe integratie met Ceph. Het kan diff's tussen snapshots ophalen en daaruit incrementele back-ups vormen. Ondersteunt een groot aantal opslag-backends, waaronder zowel lokale als S3. Vereist een aparte database voor het opslaan van de hash-tabel voor deduplicatie. Nadelen: geschreven in Python, heeft een iets onresponsive cli.
— een fork , een al lang bekend en betrouwbaar middel voor back-ups, kan gegevens back-uppen en deduplicateert ze goed. Kan back-ups opslaan zowel lokaal als op een externe server via scp. Kan blokapparaten back-uppen als het wordt uitgevoerd met de vlag --special, nadelen: tijdens het maken van een back-up wordt de repository volledig geblokkeerd, daarom wordt aangeraden voor elke virtuele machine een aparte repository te creëren, in principe is dit geen probleem, gelukkig worden ze heel eenvoudig aangemaakt.
— een actief ontwikkeling project, geschreven in Go, is vrij snel en ondersteunt een groot aantal opslag-backends, waaronder zowel lokale opslag als scp, S3 en nog veel meer. Het is vooral vermeldenswaardig dat er een speciaal gemaakte voor restic is, die het mogelijk maakt om het opslagmedium het snelst te exporteren voor gebruik op afstand. Van alle bovengenoemden vond ik deze het leukst. Kan back-ups maken vanuit stdin. Bijna geen merkbare nadelen, maar er zijn enkele bijzonderheden:
Ten eerste heb ik geprobeerd het te gebruiken in de modus van een algemene repository voor alle virtuele machines (zoals Benji), en dit werkte zelfs redelijk goed, maar de hersteloperaties kostten behoorlijk veel tijd, omdat restic elke keer opnieuw probeert de metadata van alle back-ups te lezen voordat het herstel plaatsvindt. Dit probleem werd gemakkelijk opgelost door, net als bij borg, voor elke virtuele machine een aparte repository aan te maken. Deze aanpak bleek ook zeer effectief voor het beheren van back-ups. Afzonderlijke repositories kunnen een apart wachtwoord voor toegang tot de gegevens hebben, en we kunnen ook gerust zijn dat de globale repo op de een of andere manier niet kapot gaat. Nieuwe repositories kunnen ook net zo eenvoudig worden aangemaakt als in borg backup.
In ieder geval wordt deduplicatie alleen uitgevoerd ten opzichte van de vorige versie van de back-up. De vorige back-up wordt bepaald aan de hand van het pad voor de opgegeven back-up, dus als u verschillende objecten van stdin naar een gemeenschappelijke repository back-upt, vergeet dan niet de optie
--stdin-filename, of geef elke keer expliciet de optie--parent.
Ten tweede kost het herstellen naar stdout aanzienlijk meer tijd dan het herstellen naar het bestandssysteem vanwege zijn paralleliteit. In de toekomst is het de bedoeling om een nauwere ondersteuning voor back-ups van blokapparaten toe te voegen.
Ten derde wordt op dit moment aangeraden om , omdat versie 0.9.6 een bug heeft bij het langzaam herstellen van grote bestanden.
Om de effectiviteit van de back-up en de snelheid van schrijven/herstellen uit de back-up te testen, heb ik een aparte repository aangemaakt en geprobeerd een kleine afbeelding van een virtuele machine (21 GB) te back-uppen. Er zijn twee back-ups uitgevoerd zonder wijzigingen aan het origineel, met elk van de genoemde oplossingen om te controleren hoe veel sneller/langzamer gededupliceerde gegevens worden gekopieerd.
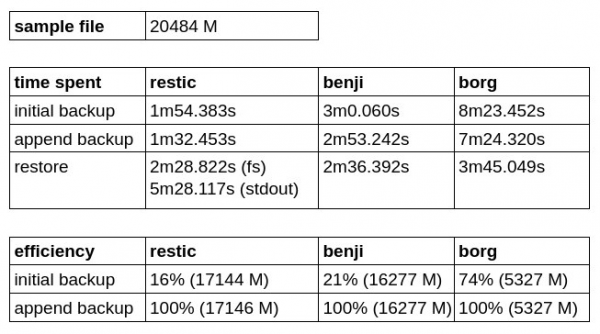
Zoals we kunnen opmerken, heeft Borg Backup de beste efficiëntiefactor voor de initiële back-up, maar verliest het op snelheid bij zowel het schrijven als het herstellen.
Restic bleek sneller dan Benji Backup, maar herstelt langzamer naar stdout, en kan helaas nog niet rechtstreeks naar een blokapparaat schrijven.
Na alles af te wegen, besloot ik me te richten op restic met rest-server als de meest gebruiksvriendelijke en veelbelovende oplossing voor back-up.
In deze screencast kunt u zien hoe een 10-gigabit kanaal volledig wordt benut tijdens verschillende gelijktijdig uitgevoerde back-up operaties. Het is vermeldenswaard dat de schijfutilisatie daarbij niet boven de 30% uitkomt.
Met de verkregen oplossing ben ik meer dan tevreden!
Bron: habr.com
