

RabbitMQ – een op Erlang gebaseerde berichtenbroker die het mogelijk maakt om een fouttolerante clustering te organiseren met volledige datareplicatie over meerdere knooppunten, waarbij elk knooppunt verzoeken voor lezen en schrijven kan afhandelen. Met een breed scala aan Kubernetes-clusters in productie ondersteunen we talloze RabbitMQ-installaties en hebben we te maken gekregen met de noodzaak om gegevens van het ene cluster naar het andere te migreren zonder downtime.
Deze operatie was voor ons noodzakelijk in minimaal twee gevallen:
- Gegevensoverdracht van een RabbitMQ-cluster dat niet op Kubernetes draait, naar een nieuwe – al 'gekubernetiseerde' (d.w.z. functionerend in K8s-pods) – cluster.
- Migratie van RabbitMQ binnen Kubernetes van de ene namespace naar de andere (bijvoorbeeld als de omgevingen zijn gescheiden door namespaces, voor het verplaatsen van infrastructuur van de ene omgeving naar de andere).
Het recept dat in dit artikel wordt voorgesteld, is gericht op situaties (maar zeker niet beperkt tot) waarin een oud RabbitMQ-cluster (bijvoorbeeld met 3 knooppunten) zich al dan niet in K8s bevindt, of op enkele oudere servers. Een applicatie die draait binnen Kubernetes (of daar binnenkomt) werkt ermee:
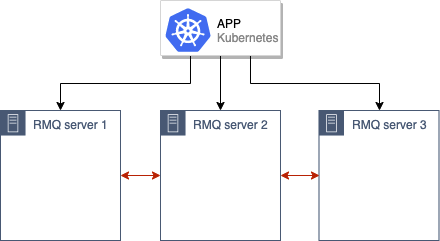
… en we hebben de taak om het naar een nieuwe productie in Kubernetes te migreren.
Eerst wordt de algemene benadering van de migratie beschreven, gevolgd door de technische details van de uitvoering.
Migratie-algoritme
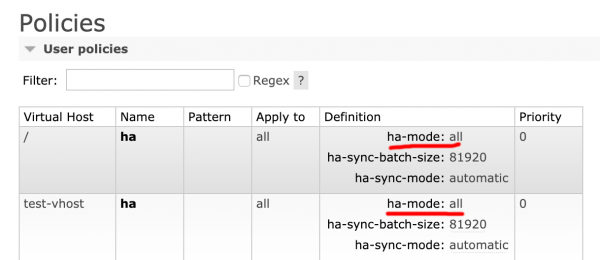
De eerste, voorbereidende stap voordat er enige acties worden ondernomen, is te controleren dat de oude RabbitMQ-installatie het hoogbeschikbaarheidsmodus heeft ingeschakeld (). De reden is duidelijk – we willen namelijk geen gegevens verliezen. Om deze controle uit te voeren, kan men in de RabbitMQ-admininterface gaan en op het tabblad Admin → Policies controleren of de waarde is ingesteld op ha-mode: all:
De volgende stap is het opzetten van een nieuwe RabbitMQ-cluster in K8s-pods (in ons geval bijvoorbeeld bestaande uit 3 knooppunten, maar hun aantal kan ook anders zijn).
Daarna combineren we de oude en nieuwe RabbitMQ-clusters, waardoor we één cluster (van 6 knooppunten) krijgen:
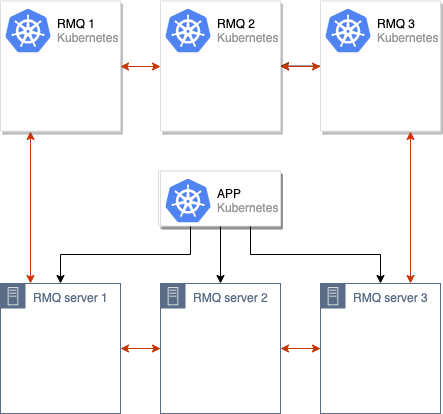
Het proces van gegevenssynchronisatie tussen de oude en nieuwe RabbitMQ-clusters wordt geinitieerd. Zodra alle gegevens tussen alle knooppunten in het cluster zijn gesynchroniseerd, kunnen we de applicatie overschakelen op het gebruik van het nieuwe cluster:
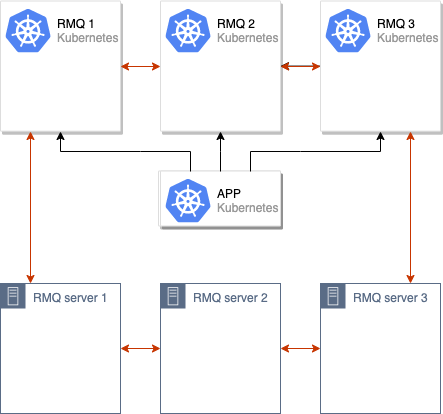
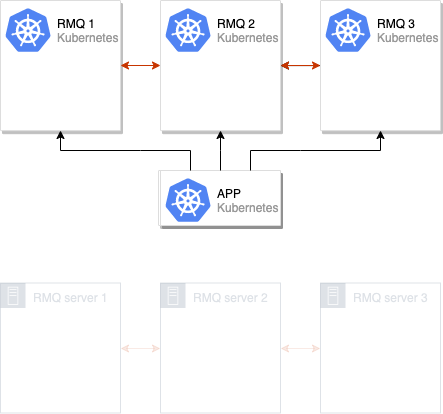
Na deze handelingen is het voldoende om de oude knooppunten uit de RabbitMQ-cluster te halen, en kan de verhuizing als voltooid worden beschouwd:
Deze opstelling hebben we herhaaldelijk in onze productie gebruikt. Voor ons gemak hebben we het echter geïmplementeerd binnen een gespecialiseerd systeem dat standaardconfiguraties van RMQ verspreidt over meerdere Kubernetes-clusters. (voor degenen die nieuwsgierig zijn: het gaat om , waar we ). Hieronder zullen afzonderlijke instructies worden weergegeven die iedereen op zijn eigen installaties kan toepassen om de voorgestelde oplossing in de praktijk uit te proberen.
Laten we het in de praktijk proberen
Vereisten
De gegevens zijn heel eenvoudig:
- Kubernetes-cluster (minikube is ook geschikt);
- Een RabbitMQ-cluster (dat kan worden uitgerold op bare metal, of zoals een gewoon cluster in Kubernetes uit de officiële Helm-chart).
Voor het onderstaande voorbeeld heb ik RMQ in Kubernetes uitgerold en het genoemd rmq-old.
Voorbereiding van de testomgeving
1. Download de Helm-chart en bewerk deze een beetje:
helm fetch --untar stable/rabbitmq-ha Voor het gemak stellen we een wachtwoord in, ErlangCookie en stellen we het beleid in op ha-all, zodat de wachtrijen standaard synchroniseren tussen alle knooppunten van het RMQ-cluster:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
    "definition": {
      "ha-mode": "all",
      "ha-sync-mode": "automatic",
      "ha-sync-batch-size": 81920
    }
  }
2. Installeer de chart:
helm install . --name rmq-old --namespace rmq-old3. Ga naar de RabbitMQ-admin, maak een nieuwe wachtrij aan en voeg een paar berichten toe. Deze hebben we nodig om na de migratie te kunnen bevestigen dat alle gegevens behouden zijn en we niets verloren zijn:

De testomgeving is klaar: we hebben een 'oude' RabbitMQ met gegevens die we moeten overzetten.
Migratie van het RabbitMQ-cluster
1. Laten we als eerste een nieuwe RabbitMQ uitrollen in een vriend de namespace met dezelfde naam ErlangCookie en wachtwoord voor de gebruiker. Hiervoor voeren we de bovengenoemde stappen uit, waarbij we de eindopdracht voor de installatie van RMQ aanpassen naar het volgende:
helm install . --name rmq-new --namespace rmq-new2. Nu is het nodig om het nieuwe cluster te combineren met het oude. Daarom gaan we naar elk van de pod’s nieuwe RabbitMQ en voeren we de commando's uit:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
In de variabele OLD_RMQ verwijst naar het adres van een van de knooppunten van het oude RMQ-cluster.
Deze commando's zullen de huidige knoop nieuwe van het RMQ-cluster stoppen, verbinden met het oude cluster en opnieuw opstarten.
3. Het RMQ-cluster met 6 knooppunten is gereed:
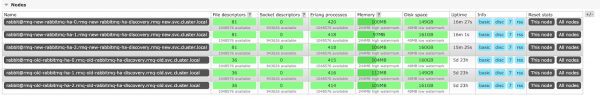
Wacht tot de berichten zijn gesynchroniseerd tussen alle knooppunten. Het is niet moeilijk te raden dat de tijd voor de synchronisatie van berichten afhangt van de kracht van de hardware waarop het cluster is geïmplementeerd en het aantal berichten. In het beschreven scenario zijn er slechts 10 berichten, dus de gegevens zijn onmiddellijk gesynchroniseerd, maar bij een groot aantal berichten kan de synchronisatie uren duren.
Dus, de status van de synchronisatie:

Hier +5 betekent dat de berichten al zijn nog op 5 knooppunten (behalve die in het veld Node). Daarom is de synchronisatie succesvol verlopen.
4. Het enige wat je nog hoeft te doen is het adres van RMQ in de applicatie om te schakelen naar het nieuwe cluster (specifieke stappen hiervoor zijn afhankelijk van de technologie-stack die je gebruikt en andere specificaties van de applicatie), waarna je afscheid kunt nemen van het oude.
Voor de laatste operatie (d.w.z. het worden toegevoegd na overschakelen van de applicatie naar het nieuwe cluster) ga je naar elk knooppunt van het oude van het cluster en voer je de commando's uit:
rabbitmqctl stop_app
rabbitmqctl reset
Het cluster "vergeet" de oude knooppunten: je kunt de oude RMQ verwijderen, waarmee de verhuizing is voltooid.
Opmerking: Als je RMQ met certificaten gebruikt, verandert er principieel niets — het verhuisproces zal op dezelfde manier plaatsvinden.
Conclusies
Het beschreven schema is praktisch geschikt voor alle gevallen waarin we RabbitMQ moeten verplaatsen of simpelweg naar een nieuw cluster moeten verhuizen.
In ons geval ontstonden er slechts moeilijkheden toen RMQ vanuit veel plekken werd aangesproken en we geen mogelijkheid hadden om overal het adres van RMQ naar het nieuwe te wijzigen. Toen hebben we een nieuwe RMQ opgezet in dezelfde namespace met dezelfde labels, zodat deze onder de reeds bestaande services en Ingress'en viel, en bij het starten van de pod hebben we de labels handmatig gemanipuleerd, ze in het begin verwijderd zodat er geen verzoeken naar de lege RMQ gingen, en ze weer toegevoegd na de synchronisatie van de berichten.
We hebben dezelfde strategie toegepast bij de upgrade van RabbitMQ naar een nieuwe versie met gewijzigde configuratie — alles werkte als een zonnetje.
P.S.
Als logisch vervolg op dit materiaal bereiden we artikelen voor over MongoDB (migratie van een fysieke server naar Kubernetes) en MySQL (hoe we deze database binnen Kubernetes voorbereiden). Ze zullen binnen enkele maanden worden gepubliceerd.
P.P.S.
Lees ook op onze blog:
- «»;
- «».
Bron: habr.com
