

Mijn naam is Denis Rozhkov, ik ben de hoofdontwikkelaar bij het bedrijf 'Gazinformservice', in het productteam. . Wetgeving en bedrijfsnormen stellen bepaalde vereisten aan de beveiliging van gegevensopslag. Niemand wil dat derden toegang krijgen tot vertrouwelijke informatie, daarom zijn de volgende vragen belangrijk voor elk project: identificatie en authenticatie, toegangsbeheer tot gegevens, waarborging van de integriteit van de informatie in het systeem, registratie van beveiligingsgebeurtenissen. Daarom wil ik enkele interessante punten over de beveiliging van databases bespreken.
Dit artikel is voorbereid op basis van een presentatie op georganiseerd door . Als je niet wilt lezen, kun je kijken:
Het artikel bestaat uit drie delen:
- Hoe verbindingen te beschermen.
- Wat is audit van acties en hoe vast te leggen wat er met de database en de verbinding ermee gebeurt.
- Hoe gegevens in de database zelf te beschermen en welke technologieën daarvoor beschikbaar zijn.
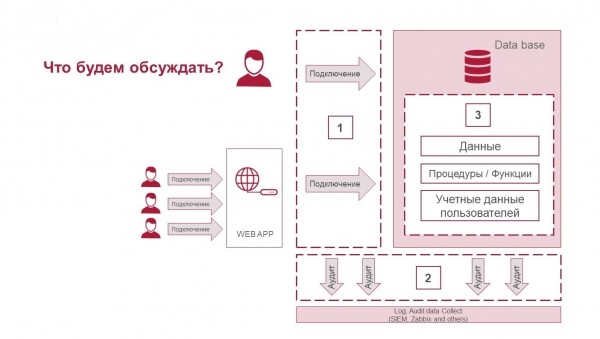
Drie componenten van databasebeveiliging: bescherming van verbindingen, audit van acties en gegevensbescherming.
Bescherming van verbindingen
Je kunt verbinding maken met de database zowel rechtstreeks als indirect via webapplicaties. Over het algemeen interacteert de eindgebruiker uit het bedrijfsleven, dat wil zeggen de persoon die met de database werkt, niet rechtstreeks met deze.
Voordat we over de bescherming van verbindingen praten, moeten we belangrijke vragen beantwoorden die van invloed zijn op hoe beveiligingsmaatregelen worden opgesteld:
- is één zakelijke gebruiker gelijk aan één gebruiker van de database;
- wordt toegang tot gegevens van de database uitsluitend via de API verleend die jij beheert, of is er directe toegang tot de tabellen;
- is de database toegewezen aan een afzonderlijk beveiligd segment en wie en hoe werkt ermee samen;
- wordt er gebruikgemaakt van pooling/proxy en tussentijdse lagen die informatie kunnen wijzigen over hoe de verbinding is opgebouwd en wie de database gebruikt.
Laten we nu kijken welke tools we kunnen gebruiken voor de bescherming van verbindingen:
- Gebruik database firewall-oplossingen. Een extra laag van beveiliging verhoogt in elk geval de transparantie van wat er in de database gebeurt en in het beste geval kun je extra gegevensbescherming garanderen.
- Gebruik wachtwoordbeleid. De implementatie ervan hangt af van hoe uw architectuur is opgebouwd. In ieder geval is één wachtwoord in het configuratiebestand van de webtoepassing die zich met de DBMS verbindt, niet voldoende voor bescherming. Er zijn verschillende DBMS-tools beschikbaar die kunnen controleren of gebruiker en wachtwoord vernieuwing vereisen.
Lees meer over de functies voor gebruikersbeoordeling. , en u kunt ook meer te weten komen over MS SQL Vulnerability Assessment. .
- Verrijk de context van de sessie met de benodigde informatie. Als de sessie niet transparant is, begrijpt u niet wie binnen de DBMS werkt; het is mogelijk om tijdens de uitgevoerde operatie informatie toe te voegen over wie, wat en waarom iets doet. Deze informatie kan worden bekeken in de audit.
- Configureer SSL als u geen netwerksegmentatie heeft tussen de DBMS en eindgebruikers, en als deze niet in een aparte VLAN is. In dergelijke gevallen is het essentieel om de verbinding tussen de consument en de DBMS te beveiligen. Beschermingsinstrumenten zijn ook beschikbaar onder open-source.
Hoe beïnvloedt dit de prestaties van de DBMS?
Laten we aan de hand van PostgreSQL bekijken hoe SSL de CPU-belasting, wachttijden en de vermindering van TPS beïnvloedt en of er niet te veel middelen verloren gaan door het in te schakelen.
We belasten PostgreSQL met pgbench — een eenvoudig programma om prestatietests uit te voeren. Het voert herhaaldelijk een reeks opdrachten uit, mogelijk in parallelle databasesessies, en berekent vervolgens de gemiddelde transactiesnelheid.
Test 1 zonder SSL en met gebruik van SSL. — de verbinding wordt bij elke transactie tot stand gebracht:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Test 2 zonder SSL en met gebruik van SSL. — alle transacties worden uitgevoerd in één verbinding:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Overige instellingen::
schalingsfactor: 1
query mode: eenvoudig
aantal clients: 10
aantal threads: 1
aantal transacties per client: 5000
aantal daadwerkelijk verwerkte transacties: 50000/50000Testresultaten:
GEEN SSL
SSL
Verbinding wordt bij elke transactie tot stand gebracht.
gemiddelde latentie
171,915 ms
187,695 ms
tps inclusief het tot stand brengen van verbindingen.
58.168112
53.278062
tps exclusief het tot stand brengen van verbindingen.
64.084546
58.725846
CPU
24%
28%
Alle transacties worden uitgevoerd in één verbinding.
gemiddelde latentie
6,722 ms
6,342 ms
tps inclusief het tot stand brengen van verbindingen.
1587.657278
1576.792883
tps exclusief het tot stand brengen van verbindingen.
1588.380574
1577.694766
CPU
17%
21%
Bij lichte belasting is de invloed van SSL vergelijkbaar met de meetfout. Wanneer de hoeveelheid verzonden gegevens echter zeer groot is, kan de situatie anders zijn. Als we voor elke transactie een aparte verbinding opzetten (wat zelden voorkomt, meestal delen gebruikers de verbinding), heb je veel verbindingen/verbindingen loskoppelen, dan kan de invloed iets groter zijn. Dat wil zeggen, er kunnen risico's zijn voor prestaties, maar het verschil is niet zo groot dat je geen beveiliging moet gebruiken.
Let op: er is een groot verschil wanneer je werkt in sessiemodus of in verschillende sessies. Dit is logisch: het kost middelen om elke verbinding te creëren.
We hadden een geval waarin we Zabbix in trust-modus verbonden, dat wil zeggen dat we md5 niet controleerden en er geen authenticatie nodig was. Toen vroeg de klant om md5-authenticatie in te schakelen. Dit leidde tot een hoge CPU-belasting en de prestaties daalden. We zijn op zoek gegaan naar optimalisatiemogelijkheden. Een van de mogelijke oplossingen voor het probleem is om netwerkbeperkingen toe te passen, aparte VLAN's voor de DBMS te maken, instellingen toe te voegen zodat het duidelijk is wie en van waar verbinding maakt en de authenticatie te verwijderen. Daarnaast kunnen we ook de authentificatie-instellingen optimaliseren om de kosten van inschakeling van authenticatie te verlagen, maar over het algemeen heeft het gebruik van verschillende authenticatiemethoden invloed op de prestaties en moeten deze factoren in aanmerking worden genomen bij het ontwerpen van servercapaciteit (hardware) voor de DBMS.
Conclusie: in sommige oplossingen kunnen zelfs kleine nuances in authenticatie een grote impact hebben op het project, en het is problematisch wanneer dit alleen duidelijk wordt bij de implementatie in productie.
Activiteitenaudit
Audit kan niet alleen voor de DBMS zijn. Audit is het verkrijgen van informatie over wat er op verschillende segmenten gebeurt. Dit kan zowel een database-firewall zijn als een besturingssysteem waarop de DBMS is gebouwd.
Bij commerciële Enterprise-niveau DBMS is auditing goed geregeld, maar bij open source is dat niet altijd het geval. Dit is wat er in PostgreSQL beschikbaar is:
- default log - ingebouwde logging;
- uitbreidingen: pgaudit - als de standaardlogging niet voldoende is, kun je gebruikmaken van aparte instellingen die een deel van de taken oplossen.
Aanvulling op de presentatie in de video:
De basisregistratie van operators kan worden verzorgd met behulp van de standaard logtool met log_statement = all.
Dit is geschikt voor monitoring en andere soorten gebruik, maar biedt niet het detailniveau dat meestal nodig is voor een audit.
Het is niet voldoende om alleen een lijst van alle handelingen met de database te hebben.
Er moet ook de mogelijkheid zijn om specifieke uitspraken te vinden die interessant zijn voor de auditor.
De standaard logtool toont wat de gebruiker heeft opgevraagd, terwijl pgAudit zich richt op de details van wat er is gebeurd toen de database de aanvraag uitvoerde.
Bijvoorbeeld, een auditor wil misschien bevestigen dat een specifieke tabel is aangemaakt in een gedocumenteerd onderhoudsvenster.
Dit lijkt een eenvoudige taak voor basisauditing en grep, maar wat als je iets soortgelijks tegenkomt (bewust verwarrend) voorbeeld:
DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;
De standaard logging zal je dit geven:
LOG: statement: DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;
Het lijkt erop dat het enige kennis van de code kan vereisen om de relevante tabel te vinden wanneer tabellen dynamisch worden aangemaakt.
Dit is niet ideaal, aangezien het beter zou zijn om gewoon op de naam van de tabel te zoeken.
Hier komt pgAudit van pas.
Voor dezelfde invoer zal het deze output in de log genereren:
AUDIT: SESSION,33,1,FUNCTION,DO,,,"DO $$
BEGIN
EXECUTE 'CREATE TABLE import' || 'ant_table (id INT)';
END $$;"
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Niet alleen het DO-blok wordt geregistreerd, maar ook de volledige CREATE TABLE tekst met type operator, type object en volledige naam, wat het zoeken vergemakkelijkt.
Bij het loggen van SELECT- en DML-operators kan pgAudit worden geconfigureerd om een afzonderlijke registratie voor elke relatie die in de operator wordt verwezen vast te leggen.
Er is geen syntactische analyse nodig om alle operatoren te vinden die betrekking hebben op een specifieke tabel ()».
Hoe beïnvloedt dit de prestaties van de DBMS?
Laten we testen met het inschakelen van volledige auditing en kijken wat het effect op de prestaties van PostgreSQL is. We zullen de maximale DB-logging inschakelen voor alle parameters.
We veranderen bijna niets in het configuratiebestand, belangrijk - we schakelen de debug5-modus in om zoveel mogelijk informatie te krijgen.
postgresql.conf
log_destination = 'stderr'
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = aan
log_checkpoints = aan
log_connections = aan
log_disconnections = aan
log_duration = aan
log_hostname = aan
log_lock_waits = aan
log_replication_commands = aan
log_temp_files = 0
log_timezone = 'Europe/Moscow'
Op de PostgreSQL DB met parameters 1 CPU, 2,8 GHz, 2 GB RAM, 40 GB HDD voeren we drie belastingstests uit met de volgende commando's:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Testresultaten:
Zonder logging
Met logging
Eindtijd voor het vullen van de DB
43,74 sec
53,23 sec
RAM
24%
40%
CPU
72%
91%
Test 1 (50 connecties)
Aantal transacties in 10 minuten
74169
32445
Transacties/sec
123
54
Gemiddelde latentie
405 ms
925 ms
Test 2 (150 connecties bij 100 mogelijke)
Aantal transacties in 10 minuten
81727
31429
Transacties/sec
136
52
Gemiddelde latentie
550 ms
1432 ms
Over de groottes
Grootte van de DB
2251 MB
2262 MB
Grootte van de DB-logs
0 MB
4587 MB
Concluderend: een volledige audit is niet zo goed. De gegevens van de audit zullen qua volume gelijk zijn aan de gegevens in de database zelf, of zelfs meer. Dergelijke omvangrijke logging die wordt gegenereerd bij het werken met een DB, is een veelvoorkomend probleem in productie.
Laten we naar andere parameters kijken:
- De snelheid verandert niet veel: zonder logging — 43,74 sec, met logging — 53,23 sec.
- De prestaties op RAM en CPU zullen dalen, omdat er een bestand met audits moet worden aangemaakt. Dit is ook merkbaar in productie.
Natuurlijk zullen de cijfers iets verslechteren met een toenemend aantal connecties.
In bedrijven met audits is het nog moeilijker:
- veel gegevens;
- de audit is niet alleen nodig via syslog in SIEM, maar ook in bestanden: stel dat er iets met syslog gebeurt, er moet een bestand dicht bij de database zijn waarin de gegevens worden opgeslagen;
- voor de audit is een aparte schijf nodig om I/O op de schijven niet te overbelasten, aangezien deze veel ruimte in beslag neemt;
- Het komt voor dat medewerkers van informatiebeveiliging overal de normen eisen, zij vragen om gecertificeerde identificatie.
Beperkingen op de toegang tot gegevens
Laten we kijken naar de technologieën die worden gebruikt voor de bescherming van gegevens en de toegang tot deze gegevens in commerciële databases en open source.
Wat in het algemeen kan worden gebruikt:
- Encryptie en obfuscatietechnieken voor procedures en functies (Wrapping) — dat wil zeggen, afzonderlijke tools en utiliteiten die leesbare code onleesbaar maken. Het is echter niet mogelijk om deze nadien te wijzigen of terug te refactoren. Deze aanpak is soms noodzakelijk, vooral aan de DB-zijde — de logica van licentiebeperkingen of autorisatielogica wordt gecodeerd op procedure- en functie-niveau.
- Rijbeperkingen (RLS) houden in dat verschillende gebruikers dezelfde tabel zien, maar verschillende rijen daarin, wat betekent dat sommige gegevens niet zichtbaar mogen zijn op het rijniveau.
- Gegevensmaskering (Masking) betekent dat gebruikers in één kolom van de tabel ofwel de gegevens zien, of alleen sterretjes, wat inhoudt dat voor bepaalde gebruikers de informatie wordt afgeschermd. De technologie bepaalt aan welke gebruiker welke gegevens worden getoond, rekening houdend met het toegangsniveau.
- Toegangsbeperking voor Security DBA/Application DBA/DBA betreft voornamelijk het beperken van de toegang tot de database zelf, waardoor beveiligingsmedewerkers kunnen worden gescheiden van databasebeheerders en applicatiebeheerders. In open source zijn er niet veel van deze technologieën, maar commerciële databases hebben er voldoende. Ze zijn nodig wanneer er veel gebruikers zijn met toegang tot de servers.
- Beperking van de toegang tot bestanden op het niveau van het besturingssysteem. Rechten en toegangsprivileges kunnen worden verleend voor mappen, zodat elke beheerder alleen toegang heeft tot de relevante gegevens.
- Mandaattoegang en geheugenreiniging worden zelden toegepast.
- End-to-end encryptie op de database betekent client-side encryptie met sleutelbeheer aan de serverzijde.
- Gegevensencryptie. Bijvoorbeeld kolommenencryptie - wanneer u een mechanisme gebruikt dat een specifieke kolom van de database versleutelt.
Hoe beïnvloedt dit de prestaties van de database?
Kijk bijvoorbeeld naar kolommencryptie in PostgreSQL. Daar is er de pgcrypto-module die het mogelijk maakt om geselecteerde velden versleuteld op te slaan. Dit is nuttig wanneer alleen bepaalde gegevens waardevol zijn. Om de versleutelde velden te lezen, stuurt de client de decryptiesleutel, de server ontsleutelt de gegevens en geeft ze aan de client. Zonder de sleutel kan niemand iets met uw gegevens doen.
Laten we een test uitvoeren met pgcrypto.. We creëren een tabel met versleutelde gegevens en een tabel met gewone gegevens. Hieronder staan de commando's voor het maken van de tabellen, het eerste commando is nuttig - om de extensie met database-registratie te maken:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Laten we nu proberen om uit elke tabel gegevens te extraheren en kijken naar de uitvoeringstijden.
Extractie uit de tabel zonder versleuteling:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
De stopwatch is gestart.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 rijen)
Tijd: 1,386 ms
Extractie uit de tabel met versleuteling:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
De stopwatch is gestart.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 rijen)
Tijd: 50,203 ms
Testresultaten:
Zonder versleuteling
Pgcrypto (decrypt)
Extractie 1000 rijen
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
Versleuteling heeft een sterke invloed op de prestaties. Het is duidelijk dat de timing is gestegen, omdat de decryptie van versleutelde gegevens (en decryptie is meestal nog verpakt in uw logica) aanzienlijke middelen vereist. Dit betekent dat het idee om alle kolommen met gegevens te versleutelen ten koste gaat van de prestaties.
Versleuteling is echter geen zilveren kogel die alle problemen oplost. De gedecodeerde gegevens en de decryptiesleutel bevinden zich tijdens het decoderen en tijdens de overdracht van gegevens op de server. Daarom kunnen sleutels worden onderschept door iedereen met volledige toegang tot de database server, zoals de systeembeheerder.
Wanneer er voor de hele kolom voor alle gebruikers één sleutel is (zelfs als het niet voor iedereen is, maar voor een beperkte set klanten), is dat niet altijd goed of juist. Daarom zijn we begonnen met end-to-end versleuteling; er zijn opties voor gegevensversleuteling vanuit de client en server in databasesystemen, en er zijn die key-vault opslagplaatsen ontstaan - aparte producten die sleutelbeheer aan de database kant waarborgen.

Beveiligingsmiddelen in commerciële en open source databasesystemen
Functies
Type
Wachtwoordbeleid
Audit.
Bescherming van de broncode van procedures en functies
RLS
Versleuteling
Oracle
Commercieel
+
+
+
+
+
MsSql
Commercieel
+
+
+
+
+
Commercieel
+
+
+
+
extensies
PostgreSQL
Gratis
extensies
extensies
—
+
extensies
MongoDb
Gratis
—
+
—
—
Beschikbaar in alleen MongoDB Enterprise
De tabel is verre van compleet, maar de situatie is als volgt: in commerciële producten worden veiligheidsproblemen al lang opgelost, terwijl in open source over het algemeen aanvulling wordt gebruikt voor beveiliging, er ontbreken veel functies en soms moet je iets extra schrijven. Bijvoorbeeld, wachtwoordbeleid - in PostgreSQL zijn er veel verschillende extensies., , , , ), die wachtwoordbeleid implementeren, maar naar mijn mening de behoeften van de binnenlandse bedrijfssector niet allemaal dekken.
Wat te doen als je nergens kunt vinden wat je nodig hebt?? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
Dan kun je gebruikmaken van externe oplossingen die met verschillende databases werken, zoals 'Crypto DB' of 'Garda DB'. Als we het hebben over oplossingen uit de binnenlandse sector, dan zijn ze daar beter op de hoogte van de normen dan in open source.
Een tweede optie is om zelf te schrijven wat nodig is, toegang tot gegevens te realiseren op het niveau van procedures en encryptie in de applicatie. Het zal echter moeilijker zijn om met de normen om te gaan. Maar in het algemeen kun je de gegevens verbergen zoals nodig, in de database opslaan en ze vervolgens op de juiste manier ontcijferen, direct op het niveau van de applicatie. Denk tegelijkertijd na hoe je deze algoritmes in de applicatie gaat beschermen. Naar onze mening moet dit op het niveau van de database gebeuren, omdat dat sneller werkt.
Deze presentatie werd voor het eerst gegeven op door Mail.ru Cloud Solutions. Bekijkandere presentaties en abonneer je op evenementaankondigingen in Telegram .
Wat verder te lezen over dit onderwerp:
- .
- .
Bron: habr.com
