

Dus, je verzamelt statistieken. Net als wij. Wij verzamelen ook statistieken. Natuurlijk die welke nodig zijn voor het bedrijf. Vandaag vertellen we over de allereerste schakel in ons monitoringsysteem - een server voor aggregatie die compatibel is met statsd. , waarom we het hebben geschreven en waarom we brubeck hebben verlaten.
Uit onze eerdere artikelen (, ) kun je leren dat we tot voor kort de metingen verzamelden met behulp van . Het is geschreven in C. Wat betreft de code - het is zo eenvoudig als een kurk (wat belangrijk is wanneer je wilt bijdragen) en vooral, het kan met onze volumes van 2 miljoen metingen per seconde (MPS) in piek goed omgaan. De documentatie claimt ondersteuning voor 4 miljoen MPS met een sterretje. Dit betekent dat je het opgegeven aantal zult behalen als je het netwerk correct configureert op Linux. (Hoeveel MPS je kunt behalen als je het netwerk ongemoeid laat, weten we niet). Ondanks deze voordelen hadden we enkele serieuze klachten over brubeck.
Klacht 1. Github - de ontwikkelaar van het project - is gestopt met het ondersteunen ervan: patches en fixes publiceren, onze en (niet alleen onze) PR's accepteren. In de afgelopen maanden (ergens vanaf februari-maart 2018) is de activiteit hersteld, maar daarvoor was er bijna 2 jaar volledige stilte. Bovendien wordt het project ontwikkeld , wat een serieus obstakel kan zijn voor de implementatie van nieuwe functionaliteiten.
Klacht 2. De nauwkeurigheid van berekeningen. Brubeck verzamelt voor aggregatie slechts 65536 waarden. In ons geval kunnen er voor sommige statistieken in de aggregatieperiode (30 seconden) veel meer waarden binnenkomen (1.527.392 in piek). Als gevolg van dergelijke sampling lijken de waarden van maximum en minimum waardeloos. Bijvoorbeeld, zo:
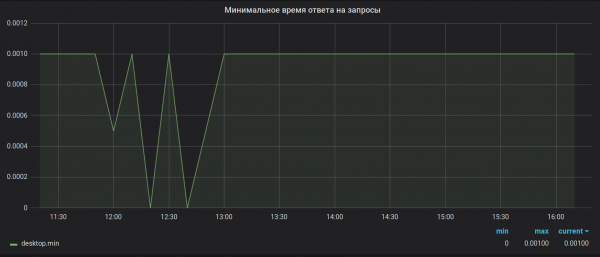
Hoe het was
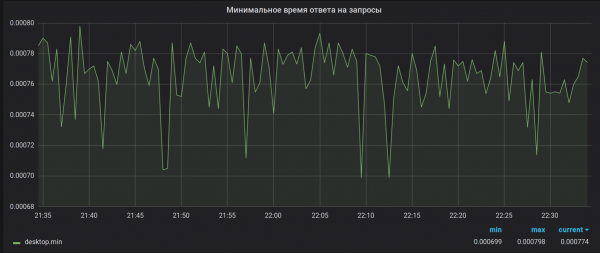
Hoe het zou moeten zijn
Om dezelfde reden worden sommen überhaupt onjuist berekend. Voeg hier de bug met de overflow van 32-bit float aan toe, die de server in segfault stuurt bij het ontvangen van een ogenschijnlijk onschuldige meting, en het wordt echt geweldig. De bug is trouwens nooit opgelost.
En tot slot, Klacht X. Op het moment van schrijven zijn we klaar om onze bevindingen te delen met de 14 meer of minder functionerende implementaties van statsd die we hebben kunnen vinden. Laten we ons voorstellen dat een bepaalde infrastructuur zo is gegroeid dat het ontvangen van 4 miljoen MPS niet meer genoeg is. Of laten we zeggen dat het nog niet is gegroeid, maar dat metrics voor jou al zo belangrijk zijn dat zelfs korte, 2-3 minuten durende onderbrekingen in de grafieken kritiek kunnen worden en onoverkomelijke aanvallen van depressie bij de managers kunnen veroorzaken. Omdat het behandelen van depressie een onbedankbare taak is, zijn technische oplossingen noodzakelijk.
Ten eerste is er fouttolerantie nodig, zodat een plotseling probleem op de server geen psychiatrische zombie-apocalyps in het kantoor veroorzaakt. Ten tweede is er schaalbaarheid nodig, om meer dan 4 miljoen MPS te kunnen verwerken, zonder diep in de Linux-netwerkstack te hoeven graven en rustig ‘breed’ te kunnen groeien tot de benodigde omvang.
Aangezien we voldoende marge hadden voor schaalbaarheid, besloten we te beginnen met fouttolerantie. 'O! Fouttolerantie! Dat is simpel, dat kunnen we!', dachten we en we zetten 2 servers op, waarbij we op elke server een kopie van brubeck draaide. Hiervoor moesten we het verkeer met metrische gegevens naar beide servers kopiëren en daarvoor zelfs een . We hebben het probleem van fouttolerantie hiermee opgelost, maar... niet heel goed. In het begin leek alles in orde: elke brubeck verzamelt zijn eigen versie van aggregatie, schrijft om de 30 seconden gegevens naar Graphite, waarbij de oude interval wordt overschreven (dit gebeurt aan de Graphite-kant). Als een server onverwacht uitvalt, hebben we altijd de tweede met een eigen kopie van de geaggregeerde gegevens. Maar het probleem is: als de server uitvalt, ontstaat er een 'zaag' in de grafieken. Dit komt omdat de 30-seconden intervallen van brubeck niet zijn gesynchroniseerd, en op het moment van uitval wordt er een van hen niet overschreven. Bij het opstarten van de tweede server gebeurt hetzelfde. Het is redelijk te tolereren, maar we willen beter! Ook het probleem van schaalbaarheid is nog steeds aanwezig. Alle metrics vliegen nog steeds naar een enkele server, en daarom zijn we beperkt tot diezelfde 2-4 miljoen MPS, afhankelijk van de kracht van het netwerk.
Als je even nadenkt over het probleem en tegelijkertijd met een schop sneeuw aan het scheppen bent, kan je op zo'n voor de hand liggende gedachte komen: we hebben een statsd nodig dat in gedistribueerde modus kan werken. Dat wil zeggen, zoiets waarin synchronisatie tussen knooppunten op tijd en metrieken is gerealiseerd. 'Zo'n oplossing moet er vast al zijn,' zeiden we en gingen Googelen... en vonden niets. op 11.12.2017), vonden we werkelijk niets. Blijkbaar waren noch de ontwikkelaars, noch de gebruikers van deze oplossingen tot nu toe met zo'n hoeveelheid metrieken geconfronteerd, anders zouden ze zeker iets hebben verzonnen.
En toen herinnerden we ons de 'speelgoed' statsd - bioyino, dat we op de hackathon 'just for fun' hadden geschreven (de naam van het project werd door een script gegenereerd voor het begin van de hackathon) en beseften we dat we dringend onze eigen statsd nodig hadden. Waarom?
- omdat er in de wereld te weinig klonen van statsd zijn,
- omdat we de gewenste of bijna gewenste uitwijkbaarheid en schaalbaarheid kunnen waarborgen (inclusief het synchroniseren van geaggregeerde metrieken tussen servers en het oplossen van het conflict bij verzending),
- omdat we metrieken nauwkeuriger kunnen berekenen dan brubeck doet,
- omdat we zelf gedetailleerdere statistieken kunnen verzamelen, die brubeck ons vrijwel niet heeft verstrekt,
- omdat er een kans was om onze eigen hyperperformance distributed scalable applicatie te programmeren, die de architectuur van een andere hyperperformance... ding niet volledig zou herhalen.
Waarin te schrijven? Natuurlijk in Rust. Waarom?
- omdat er al een prototype van de oplossing was,
- omdat de auteur van het artikel op dat moment al Rust kende en nogal hunkerde om er iets mee te schrijven voor productie met de mogelijkheid om het open-source te maken,
- omdat talen met GC ons niet passen vanwege de aard van het verkregen verkeer (vrijwel realtime) en GC-pauzes vrijwel onaanvaardbaar zijn,
- omdat maximale prestaties nodig zijn, vergelijkbaar met C
- omdat Rust ons fearless concurrency biedt, en als we dit in C/C++ zouden beginnen schrijven, zouden we nog meer kwetsbaarheden, buffer overflow, race conditions en andere angstaanjagende woorden tegenkomen dan bij brubeck.
Er was ook een argument tegen Rust. Het bedrijf had geen ervaring met het ontwikkelen van projecten in Rust, en momenteel zijn we ook niet van plan om het in ons hoofdproject te gebruiken. Daarom waren er serieuze zorgen dat het niets zou worden, maar we besloten de sprong te wagen en het te proberen.
De tijd verstreek…
Eindelijk, na enkele mislukte pogingen, was de eerste werkende versie klaar. Wat is het geworden? Dit is het resultaat.
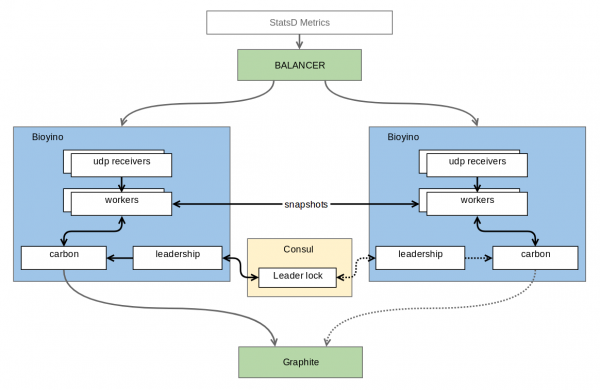
Elke node krijgt zijn eigen set metrics en slaat deze op, zonder de metrics te aggregeren voor de types waarvoor een volledige set nodig is voor de uiteindelijke aggregatie. De nodes zijn met elkaar verbonden via een bepaald protocol voor gedistribueerde locking (distributed lock), dat het mogelijk maakt om de enige (hier waren we in tranen), die het verdient om metrics naar de Great te sturen, te selecteren. Op dit moment wordt dit probleem opgelost met behulp van , maar in de toekomst reiken de ambities van de auteur uit naar van Raft, waarbij die ene waardige natuurlijk de consensus leader node zal zijn. Naast consensus sturen de nodes vrij vaak (standaard één keer per seconde) delen van de pre-geaggregeerde metrics naar hun buren, die ze in die seconde hebben kunnen verzamelen. Het resultaat is dat schaling en fouttolerantie behouden blijven — elke node houdt nog steeds een volledige set metrics, maar de metrics worden nu al geaggregeerd verzonden, via TCP en met codering in een binair protocol, waardoor de kosten voor duplicatie in vergelijking met UDP aanzienlijk verminderen. Ondanks het vrij grote aantal binnenkomende metrics vereist de accumulatie slechts heel weinig geheugen en nog minder CPU. Voor onze goed te comprimeren metrics is dit slechts een paar tientallen megabytes aan gegevens. Een extra voordeel is het ontbreken van onnodige herschrijvingen van gegevens in Graphite, zoals het geval was met burbeck.
UDP-pakketten met metrics zijn in balans verdeeld over de nodes op de netwerkapparatuur via een eenvoudige Round Robin. Uiteraard kan de netwerkapparatuur de inhoud van de pakketten niet analyseren en kan daardoor veel meer dan 4M pakketten per seconde verwerken, om nog maar te zwijgen van de metrics waar het helemaal niets van weet. Aangezien metrics niet één voor één in elk pakket binnenkomen, verwachten we geen prestatiewijzigingen op dit gebied. In geval van een serveruitval ontdekt het netwerkapparaat dit snel (binnen 1-2 seconden) en haalt het de uitgevallen server uit de rotatie. Hierdoor kunnen passieve (d.w.z. niet-leidende) nodes bijna zonder merkbare dips op de grafieken worden in- en uitgeschakeld. Het maximale dat we verliezen, is een deel van de metrics die gedurende de laatste seconde binnenkwamen. Een plotseling verlies/uitschakeling/schakeling van de leider zal nog steeds een kleine anomalie tekenen (de 30-seconde interval is nog steeds niet gesynchroniseerd), maar met een verbinding tussen de nodes kunnen ook deze problemen tot een minimum worden beperkt, bijvoorbeeld door het verzenden van synchroniserende pakketten.
Een beetje over de interne structuur. De applicatie is natuurlijk meerledig, maar de architectuur van de threads verschilt van die in brubeck. De threads in brubeck zijn gelijk — elke thread is tegelijkertijd verantwoordelijk voor zowel het verzamelen van informatie als voor de aggregatie. In bioyino zijn de werkthreads (workers) verdeeld in twee groepen: verantwoordelijk voor het netwerk en verantwoordelijk voor aggregatie. Deze verdeling maakt het mogelijk om de applicatie flexibeler te beheren afhankelijk van het type metrics: waar intensieve aggregatie vereist is, kunnen we aggregators toevoegen, en waar veel netwerkverkeer is, kunnen we het aantal netwerkthreads vergroten. Op dit moment werken we op onze servers met 8 netwerk- en 4 aggregatiedraden.
De rekenkundige (verantwoordelijk voor aggregatie) deel is vrij saai. Gevuld met netwerkthreads buffers worden verdeeld over de rekenthreads, waar ze vervolgens worden geparsed en geaggregeerd. Op aanvraag worden metrics verzonden voor verzending naar andere nodes. Dit alles, inclusief de gegevensoverdracht tussen nodes en de interactie met Consul, gebeurt asynchroon en wordt uitgevoerd op het framework .
De netwerkgedeelte dat verantwoordelijk is voor het ontvangen van metrics vormde veel meer problemen tijdens de ontwikkeling. De belangrijkste taak van het splitsen van netwerkstromen in afzonderlijke entiteiten was om de tijd te verkorten die de stroom nodig heeft niet om gegevens uit de socket te lezen. Opties die gebruik maakten van asynchroon UDP en de gewone recvmsg vielen snel af: de eerste gebruikt te veel user-space CPU voor het verwerken van gebeurtenissen, de tweede vereist te veel contextswitches. Daarom wordt momenteel met grote buffers gebruikt (en buffers, dames en heren, dat is geen kleinigheid!). Ondersteuning voor gewone UDP is behouden voor ongebruikte gevallen waarin recvmmsg niet nodig is. In de multimessage modus wordt het belangrijkste bereikt: het merendeel van de tijd ruimt de netwerkstroom de wachtrij van het besturingssysteem op — leest gegevens uit de socket en verplaatst deze naar de userspace-buffer, waarbij af en toe wordt overgeschakeld om de ingevulde buffer aan de aggregators te geven. De wachtrij in de socket stapelt zich praktisch niet op en het aantal weggelaten pakketten groeit vrijwel niet.
Opmerking
In de standaardinstellingen is de bufferomvang vrij groot ingesteld. Als je besluit om de server zelf uit te proberen, kun je er mogelijk achter komen dat, na het verzenden van een klein aantal metrics, deze niet in Graphite aankomen, maar in de buffer van de netwerkstroom blijven hangen. Voor het werken met een klein aantal metrics moeten in de configuratie de waarden voor bufsize en task-queue-size kleiner worden ingesteld.
Tot slot — een paar grafieken voor de grafiekliefhebbers.
Statistieken van het aantal binnenkomende metrics per server: meer dan 2 miljoen MPS.
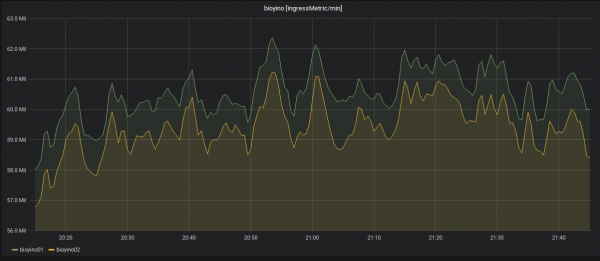
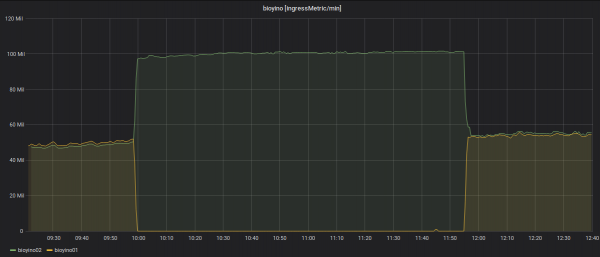
Uitschakelen van een van de nodes en herverdeling van de binnenkomende metrics.
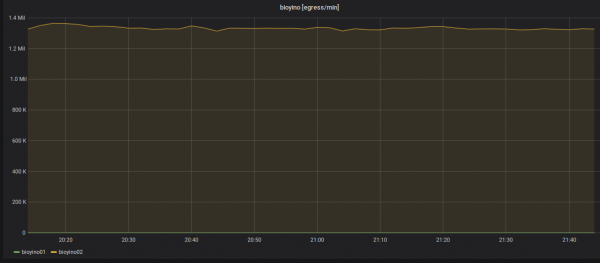
Statistieken van de uitgaande metrics: er verzendt altijd maar één node — de raider.
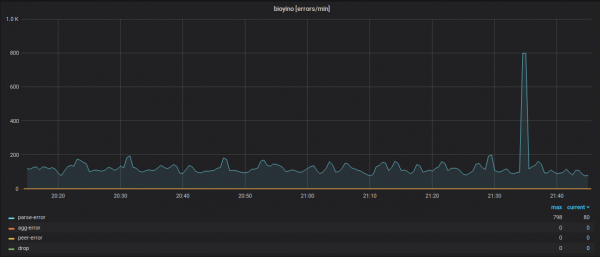
Statistieken van het werk van elke node, rekening houdend met fouten in verschillende modules van het systeem.
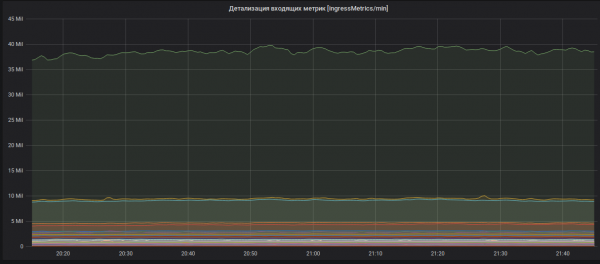
Detailinformatie over binnenkomende metrics (de namen van de metrics zijn verborgen).
Wat zijn we van plan om verder met dit alles te doen? Natuurlijk code schrijven, bl...! Het project was oorspronkelijk bedoeld als open-source en zal dat ook zijn zolang het bestaat. Op korte termijn plannen — overstappen naar een eigen versie van Raft, het peer-protocol vervangen door een meer draagbaar protocol, extra interne statistieken invoeren, nieuwe soorten metrics, fouten corrigeren en andere verbeteringen.
Natuurlijk zijn alle geïnteresseerden welkom om bij te dragen aan de ontwikkeling van het project: maak PR's, Issues aan, we zullen reageren en verder werken waar mogelijk, enz.
Daarom, zoals men zegt, dat is alles, folks, koop onze olifanten!
Bron: habr.com
