

Tot op heden heeft de service 'Bitrix24' geen honderden gigabits aan verkeer en niet een enorme serverpark (hoewel er natuurlijk heel wat servers zijn). Maar voor veel klanten is het de belangrijkste tool binnen hun bedrijf, een echte business-critical applicatie. Daarom mag het absoluut niet uitvallen. En wat als er toch iets misgaat, maar de service zo snel weer 'hersteld' is dat niemand het zelfs maar opmerkt? En hoe lukt het om dit failover te realiseren zonder kwaliteitsverlies en zonder klanten kwijt te raken? Alexander Demidov, directeur van cloudservices bij 'Bitrix24', vertelt in onze blog hoe het reserveringssysteem in de 7 jaren van het bestaan van het product is geëvolueerd.
'We hebben 'Bitrix24' 7 jaar geleden gelanceerd als SaaS. De grootste uitdaging was waarschijnlijk dat deze product vóór de lancering in de publieke SaaS-vorm simpelweg bestond als een doosoplossing. Klanten kochten het bij ons, plaatsten het op hun servers en creëerden een bedrijfsportaal - een gezamenlijke oplossing voor communicatie tussen medewerkers, bestandsopslag, taakbeheer, CRM, dat soort dingen. En tegen 2012 besloten we dat we dit als SaaS wilden lanceren, met zelfbeheer en het waarborgen van failover en betrouwbaarheid. We hebben ervaring opgedaan in het proces, omdat we tot dat moment alleen softwareproducenten waren, geen serviceproviders.
Bij de lancering van de service begrepen we dat het belangrijkste is om failover, betrouwbaarheid en constante beschikbaarheid van de service te waarborgen, want als je een gewoon website hebt, bijvoorbeeld een winkel, en deze valt voor een uur uit - dan lijdt alleen jij eronder, je verliest bestellingen, je verliest klanten, maar voor je klant zelf is dat niet zo kritisch. Natuurlijk is hij teleurgesteld, maar hij gaat naar een andere site en koopt daar. Maar als het een applicatie betreft waar het hele werk binnen het bedrijf van afhankelijk is, de communicatie, de besluiten, dan is het belangrijkste om het vertrouwen van de gebruikers te winnen, dus hen niet teleur te stellen en niet uit te vallen. Want als er iets binnen niet werkt, kan al het werk stilvallen.
Bitrix24 als SaaS
De eerste prototype hebben we een jaar voor de publieke lancering, in 2011, gebouwd. We hebben het in ongeveer een week in elkaar gezet, bekeken en gedraaid - het was zelfs operationeel. Dat wil zeggen, je kon de formulier invullen, de naam van het portaal invoeren en dan werd er een nieuw portaal uitgerold met een gebruikersdatabase. We hebben ernaar gekeken, het product in principe beoordeeld, het opgegeven en hebben een heel jaar verder gewerkt aan de verbetering. Omdat we een grote uitdaging hadden: we wilden geen twee verschillende codebases maken, we wilden het niet afzonderlijk onderhouden voor de boxproduct en voor de cloudoplossingen - we wilden dit alles binnen één code doen.
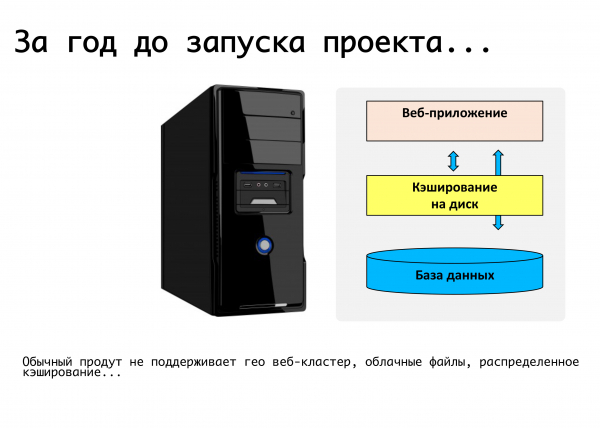
Een typisch webapplicatie op dat moment - dat was één server waarop enige PHP-code draait, met een MySQL-database, bestanden worden geüpload, documenten, foto's worden in de uploadmap geplaatst - en dat is alles. Helaas is het onmogelijk om een kritisch stabiele webservice op deze manier te lanceren. Er wordt geen gedistribueerde cache ondersteund, en er wordt geen database replicatie ondersteund.
We formuleerden de eisen: dat het moest kunnen plaatsvinden op verschillende locaties, ondersteuning voor replicatie moest hebben, idealiter verspreid over verschillende geografisch gespreide datacenters. De logica van het product scheiden van de opslag van gegevens. Dynamisch moeten kunnen opschalen op basis van belasting, en statische bestanden volledig uitbesteden. Vanuit deze overwegingen zijn de eisen voor het product ontstaan, dat we precies dat jaar hebben verbeterd. Gedurende deze tijd hebben we in het platform, dat uiteindelijk één werd - voor boxoplossingen en voor onze eigen service - de ondersteuning ingebouwd voor de dingen die we nodig hadden. Ondersteuning voor MySQL-replicatie op productniveau: dat wil zeggen dat de ontwikkelaar die code schrijft, zich geen zorgen hoeft te maken over hoe zijn verzoeken worden verdeeld, hij gebruikt onze API, en wij kunnen de verzoeken voor schrijven en lezen correct verdelen tussen masters en slaves.
We hebben ondersteuning op productniveau voor verschillende cloud object storage systemen gemaakt: Google Storage, Amazon S3, - plus ondersteuning voor OpenStack Swift. Dit was handig voor ons als service, en voor ontwikkelaars die met de boxoplossing werken: als zij gewoon onze API gebruiken, hoeven ze zich geen zorgen te maken over waar het bestand uiteindelijk wordt opgeslagen, lokaal op het bestandssysteem of het komt in de object object storage.
Uiteindelijk hebben we meteen besloten om op het niveau van een heel datacenter te reserveren. In 2012 zijn we volledig gestart met Amazon AWS, omdat we al ervaring met dit platform hadden — onze eigen website was daar gehost. Wat ons aantrok, was dat er in elke regio van Amazon verschillende beschikbaarheidszones zijn — in wezen, in hun terminologie, verschillende datacenters die min of meer onafhankelijk van elkaar zijn en ons in staat stellen om op het niveau van een heel datacenter te reserveren: als een datacenter om de een of andere reden uitvalt, worden de databases master-master gerepliceerd, de webapplicatieserver zijn gereserveerd, en de statische bestanden zijn opgeslagen in een objectopslag S3. De belasting wordt gebalanceerd — op dat moment met de Amazon ELB, maar een beetje later zijn we overgestapt op onze eigen load balancers, omdat we een complexere logica nodig hadden.
Wat we wilden, hebben we gekregen...
Alle basisdingen die we wilden waarborgen — de fouttolerantie van de servers zelf, webapplicaties, databases — alles werkte goed. Het eenvoudigste scenario: als een van onze webapplicaties uitvalt, is het eenvoudig — ze worden uit de load balancing gehaald.
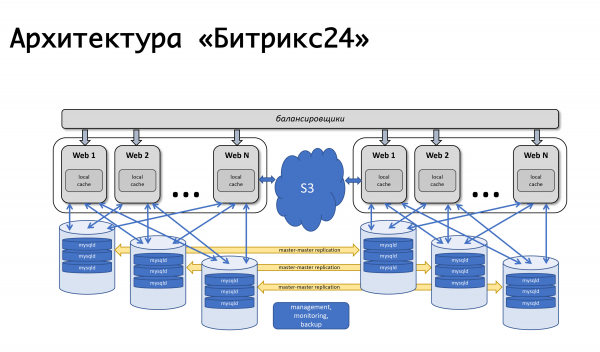
De defecte machines worden door de load balancer (toen de Amazon ELB) zelf gemarkeerd als unhealthy, en de belasting wordt niet meer op hen verdeeld. De Amazon autoscaling werkte: wanneer de belasting toenam, werden er nieuwe machines aan de autoscalinggroep toegevoegd, en de belasting werd verdeeld over de nieuwe machines — alles was goed. Onze load balancers hebben een vergelijkbare logica: als er iets gebeurt met de applicatieserver, verwijderen we de verzoeken ervan, schakelen we deze machines uit, starten we nieuwe op en blijven we operationeel. Het schema is in al die jaren een beetje veranderd, maar het blijft werken: het is eenvoudig, begrijpelijk, en er zijn geen complicaties.
We werken wereldwijd, de belastingspieken van onze klanten zijn absoluut verschillend, en eigenlijk zouden we in staat moeten zijn om met verschillende componenten van ons systeem op elk moment onderhoud uit te voeren — onopgemerkt voor de klanten. Daarom hebben we de mogelijkheid om de database uit te schakelen, terwijl we de belasting naar het tweede datacenter herverdelen.
Hoe werkt dit allemaal? — We schakelen verkeer naar een operationeel datacentrum — als het een storing in het datacentrum betreft, dan volledig, als het onze geplande werkzaamheden zijn met een specifieke database, dan schakelen we een deel van het verkeer dat deze klanten bedient over naar het tweede datacentrum, terwijl de replicatie wordt gepauzeerd. Als er nieuwe machines nodig zijn voor webapplicaties omdat de belasting in het tweede datacentrum is gestegen, worden deze automatisch opgestart. We beëindigen de werkzaamheden, de replicatie wordt hersteld en we brengen de volledige belasting terug. Als we spiegelend werk in het tweede datacentrum moeten verrichten, zoals systeemupdates installeren of instellingen in de tweede database wijzigen, herhalen we in wezen precies hetzelfde, maar dan in de andere richting. En als het een storing is, doen we het heel eenvoudig: in ons monitoringssysteem gebruiken we een mechanisme voor event-handlers. Als verschillende controles afgaan en de status kritieke niveau's bereikt, wordt deze handler geactiveerd, die bepaalde logica kan uitvoeren. Voor elke database hebben we ingesteld welke server de failover is, en waar we het verkeer naartoe moeten schakelen in het geval dat deze niet beschikbaar is. Historisch gezien gebruiken we in een of andere vorm nagios of varianten hiervan. In principe zijn soortgelijke mechanismen in vrijwel elk monitoringssysteem aanwezig, en we gebruiken voorlopig niet iets ingewikkelders, maar misschien doen we dat in de toekomst. Momenteel wordt er gemonitord op beschikbaarheid en is er de mogelijkheid om iets om te schakelen.
Hebben we alles gereserveerd?
We have many clients from the USA, many clients from Europe, and many clients who are closer to the East — Japan, Singapore, and so on. Of course, a large portion of our clients is in Russia. This means our work is not limited to just one region. Users expect fast responses, have requirements for compliance with various local laws, and within each region, we reserve two data centers. Additionally, there are services that are conveniently placed within one region for clients operating there. REST handlers and authorization servers are less critical for the overall operation; they can switch with a slight acceptable delay, but we don't want to reinvent the wheel regarding how to monitor them and what to do with them. Therefore, we try to make maximum use of existing solutions instead of developing our expertise in additional products. In some cases, we simply use DNS-level switching, and we determine the service's liveliness through the same DNS. Amazon has a service called Route 53, but it is not just a DNS where you can add records and that’s it; it is much more flexible and convenient. Through it, you can build geo-distributed services with geolocations, where you determine from where the client has come and provide them with specific records — it enables you to build failover architectures. The same health checks can be configured within Route 53; you specify the endpoints to be monitored, set metrics, and define the protocols for determining the service's 'liveliness' — tcp, http, https; you set the frequency of checks that determine if the service is alive or not. And in the DNS itself, you specify what will be primary, what will be secondary, and where to switch if the health check in Route 53 is triggered. All this can be done with other tools, but the convenience is that you set it up once and then never think about how our checks are done, how the switching occurs: everything works automatically.
The first 'but': maar hoe en waarmee kunnen we route 53 reserveren? Je weet maar nooit wat er mee kan gebeuren. Gelukkig hebben we nog nooit in deze val gelopen, maar ik heb wel een verhaal klaar over waarom we dachten dat het belangrijk was om te reserveren. Hier leggen we wat voorzorgsmaatregelen in. Verschillende keren per dag maken we een volledige export van alle zones die we in route 53 hebben. De API van Amazon stelt ons in staat om deze eenvoudig in JSON te exporteren, en we hebben enkele back-upservers opgezet waar we dit converteren, exporteren in de vorm van configuraties en, om het grofweg te zeggen, een back-upconfiguratie hebben. In geval van nood kunnen we deze snel handmatig herstellen, zodat we de dns-instellingen niet verliezen.
Tweede ‘maar’: wat in dit plaatje nog niet is gereserveerd? De load balancer! We hebben de klantenverdeling over de regio's heel eenvoudig gemaakt. We hebben domeinen zoals bitrix24.nl, bitrix24.com, .de — op dit moment zijn er ongeveer 13 verschillende die werken in heel verschillende zones. We zijn tot het volgende gekomen: elke regio heeft zijn eigen load balancers. Dit maakt het gemakkelijker om per regio te verdelen, afhankelijk van waar de pieklast in het netwerk ligt. Als er een storing is op het niveau van een enkele load balancer, wordt deze gewoon buiten gebruik gesteld en verwijderd uit de dns. Als er een probleem is met een groep load balancers, worden deze gereserveerd op andere locaties, en de omschakeling tussen hen gebeurt met behulp van dezelfde route53, omdat de omschakeling door de korte ttl maximaal binnen 2, 3, 5 minuten plaatsvindt.
Derde ‘maar’: wat is er nog niet gereserveerd? S3, inderdaad. Toen we bestanden opsloegen die we bij gebruikers in S3 bewaarden, geloofden we oprecht dat het onschendbaar was en dat we niets daar moesten reserveren. Maar de geschiedenis leert dat het anders kan lopen. Over het algemeen beschrijft Amazon S3 als een fundamentele service, omdat Amazon zelf S3 gebruikt voor het opslaan van machine-images, configuraties, AMI-images, snapshots... En als S3 uitvalt, zoals een keer is gebeurd in de 7 jaren dat we bitrix24 gebruiken, sleept het een heleboel andere problemen met zich mee — onbeschikbaarheid van virtual machines, falen van de api, enzovoort.
En zelfs S3 kan falen — dat is ooit gebeurd. Daarom hebben we de volgende aanpak gekozen: enkele jaren geleden waren er in Rusland geen serieuze openbare objectopslagplaatsen, en we overwegen om iets eigen te doen… Gelukkig zijn we daar niet aan begonnen, omdat we verdronken zouden zijn in de expertise die we niet bezaten, en we zouden het ongetwijfeld verkeerd hebben gedaan. Tegenwoordig zijn er S3-compatibele opslagplaatsen van Mail.ru, van Yandex en van een aantal andere aanbieders. We kwamen uiteindelijk tot de conclusie dat we, ten eerste, redundantie willen hebben, en ten tweede, de mogelijkheid om met lokale kopieën te werken. Voor de specifieke Russische regio gebruiken we de Mail.ru Hotbox-service, die via API compatibel is met S3. We hadden geen ingrijpende aanpassingen in de code van de applicatie nodig, en we hebben het volgende mechanisme opgezet: in S3 zijn er triggers die worden geactiveerd bij het creëren/verwijderen van objecten, en Amazon heeft zo'n service genaamd Lambda — dit is serverless code-uitvoering die precies gebeurt wanneer die of andere triggers worden geactiveerd.
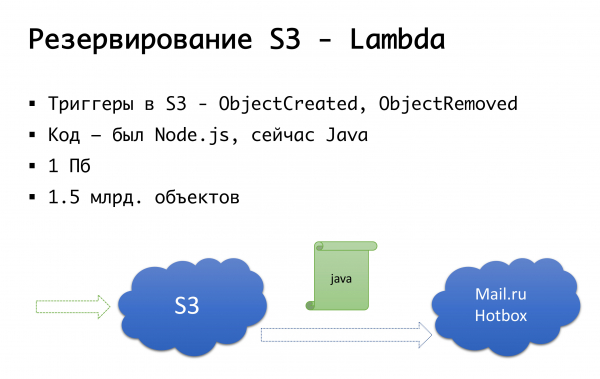
We hebben het heel eenvoudig gedaan: als er een trigger afgaat, voeren we de code uit die het object naar de Mail.ru-opslag kopieert. Om volledig met lokale datakopieën te kunnen werken, hebben we ook omgekeerde synchronisatie nodig, zodat klanten die zich in het Russische segment bevinden, kunnen werken met de opslag die dichterbij hen is. Mail is bijna klaar met de triggers in hun opslag — het wordt mogelijk om op infrastructuurniveau omgekeerde synchronisatie uit te voeren, maar momenteel doen we dit op het niveau van onze eigen code. Als we zien dat een klant een bestand heeft geplaatst, plaatsen we op ons code-niveau een gebeurtenis in de wachtrij, verwerken deze en maken we de omgekeerde replicatie. Het nadeel hiervan is: als er enige bewerking met onze objecten buiten ons product plaatsvindt, via externe middelen, zullen we dit niet registreren. Daarom wachten we tot het einde, wanneer de triggers op opslagniveau beschikbaar komen, zodat ongeacht waar we de code hebben uitgevoerd, het object dat naar ons is gekomen, naar de andere kant wordt gekopieerd.
Op codenniveau hebben we voor elke klant beide opslagruimten ingesteld: de ene wordt als primair beschouwd, de andere als back-up. Als alles goed gaat, werken we met de opslagruimte die het dichtst bij ons is: dat wil zeggen, onze klanten die in Amazon zitten, gebruiken S3, terwijl degenen die in Rusland zijn, werken met Hotbox. Als er een vlag naar boven komt, moet failover worden ingeschakeld, en we schakelen klanten over naar een andere opslagruimte. We kunnen deze vlag onafhankelijk per regio plaatsen en ze heen en weer schakelen. In de praktijk hebben we dit nog niet gebruikt, maar we hebben dit mechanisme voorzien en denken dat we dit soort overschakeling ooit nodig zullen hebben. Het is al een keer gebeurd.
Oh, en jullie Amazon is weggelopen…
Deze april markeert de verjaardag van het begin van de blokkades van Telegram in Rusland. De meest benadeelde provider die hierbij betrokken was, is Amazon. En helaas, Russische bedrijven die wereldwijd opereerden, hebben het meest geleden.
Als het een wereldwijd bedrijf is en Rusland voor hen een zeer klein segment is, 3-5% — nou, zo of zo, dat kan opgeofferd worden.
Als het een puur Russisch bedrijf is — ben ik ervan overtuigd dat ze lokaal moeten worden geplaatst — het zal gewoon handiger en comfortabeler zijn voor de gebruikers, en de risico's zullen minder zijn.
En als het een bedrijf is dat wereldwijd opereert en zij ongeveer net zoveel klanten uit Rusland hebben als uit andere delen van de wereld? De verbondenheid van segmenten is belangrijk, en ze moeten hoe dan ook met elkaar werken.
Aan het eind van maart 2018 heeft Roskomnadzor een brief gestuurd naar de grootste providers waarin stond dat ze van plan zijn om enkele miljoenen IP-adressen van Amazon te blokkeren om… de messenger Zello te blokkeren. Dank aan deze providers — ze hebben de brief succesvol gelekt, en er ontstond een begrip dat de connectiviteit met Amazon kan instorten. Het was vrijdag, en we kwamen in paniek naar onze collega's van servers.ru met de woorden: 'Vrienden, we hebben een paar servers nodig die niet in Rusland staan, niet in Amazon, maar bijvoorbeeld ergens in Amsterdam,' om op zijn minst enige mogelijkheid te hebben om daar iets op te zetten. vpn En proxy voor bepaalde endpoints waar we geen invloed op kunnen uitoefenen, zoals de endpoints van s3 — we kunnen geen nieuwe service opzetten en een ander ip verkrijgen, we moeten er hoe dan ook toegang toe krijgen. In enkele dagen hebben we deze servers ingesteld, opgezet, en in het algemeen waren we voorbereid op het begin van de blokkades. Het is interessant dat de RKN, kijkend naar de ophef en de paniek, zei: ‘Nee, we zullen nu niets gaan blokkeren’. (Maar dit was precies totdat ze begonnen met het blokkeren van Telegram.) Nadat we de mogelijkheden voor omzeiling hadden ingesteld en begrepen dat de blokkade niet was ingevoerd, hebben we, desondanks, dit hele zaak niet verder overwogen. Gewoon, voor alle zekerheid.
En zo leven we in 2019 onder blokkades. Ik keek gisteravond: ongeveer een miljoen ip-adressen worden nog steeds geblokkeerd. Het is waar dat Amazon bijna volledig weer ontgrendeld is, op het hoogtepunt liep het op tot 20 miljoen adressen… In het algemeen is de realiteit zo, dat connectiviteit, goede connectiviteit — het kan er ineens niet zijn. Het kan om technische redenen zijn — branden, graafmachines, dat soort dingen. Of, zoals we zagen, niet helemaal technische redenen. Daarom kan iemand groot en belangrijk, met eigen AS-merken, dit waarschijnlijk op andere manieren aansteken — direct connect en andere dingen al op niveau l2. Maar in een eenvoudig geval, zoals bij ons of nog kleiner, is het een goed idee om op serverniveau redundantie te hebben, ergens anders opgezet, waarbij vooraf een vpn, proxy is ingesteld, met de mogelijkheid om snel de configuratie om te schakelen in die segmenten die kritiek zijn voor je connectiviteit. Dit is ons meerdere keren van pas gekomen, toen de blokkades van Amazon begonnen, gebruikten we ze in het slechtste geval om S3-verkeer te leiden, maar gaandeweg werd alles opgelost.
Maar hoe reserveer je... een hele provider?
Op dit moment hebben we geen scenario voor een volledige uitval van Amazon. We hebben een vergelijkbaar scenario voor Rusland. In Rusland waren we ondergebracht bij een provider waarvan we ervoor zorgden dat er meerdere locaties waren. Een jaar geleden stuitten we op een probleem: ondanks dat het om twee datacentra ging, kunnen er op netwerkniveau bij de provider problemen zijn die beide datacentra beïnvloeden. We kunnen dan beide locaties onbereikbaar krijgen. Natuurlijk is dit ook gebeurd. Uiteindelijk hebben we de architectuur intern herzien. Deze is niet drastisch veranderd, maar voor Rusland hebben we nu twee locaties die niet bij één provider zijn, maar bij twee verschillende. Als er bij de één iets misgaat, kunnen we naar de ander overschakelen.
Hypothetisch bespreken we voor Amazon de mogelijkheid om te reserveren op een niveau van een andere provider; misschien Google, misschien iemand anders... Maar tot nu toe hebben we in de praktijk gezien dat als er bij Amazon een storing in een availability zone is, storingen op regionaal niveau redelijk zeldzaam zijn. Daarom hebben we theoretisch het idee dat we misschien reservering 'Amazon - niet Amazon' zullen maken, maar in de praktijk is dat nog niet gerealiseerd.
Een paar woorden over automatisering
Is automatisering altijd nodig? Het is dan ook gepast om het Dunning-Kruger-effect te herinneren. Op de x-as hebben we onze kennis en ervaring die we opdoen, en op de y-as onze zekerheid in onze acties. Eerst weten we niets en zijn we helemaal niet zeker. Dan weten we een beetje en worden we superzeker - dat is het zogenaamde 'piek van domheid', goed geïllustreerd door de afbeelding 'onkunde en moed'. Daarna hebben we al een beetje geleerd en zijn we klaar om de strijd aan te gaan. Vervolgens stoten we op serieuze obstakels, belanden we in de vallei van wanhoop, wanneer we denken dat we iets weten, maar in werkelijkheid weten we veel minder. Naarmate we meer ervaring opdoen, worden we al meer zelfverzekerd.
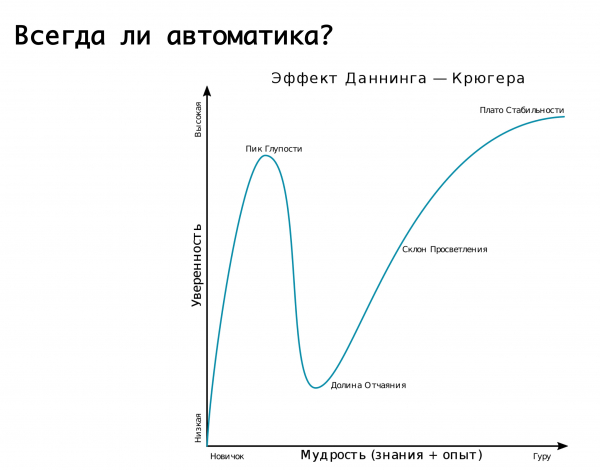
Onze aanpak van verschillende overschakelingen automatisch naar bepaalde storingen wordt heel goed weergegeven in deze grafiek. We zijn gestart — we hadden geen ervaring, vrijwel al het werk werd handmatig uitgevoerd. Vervolgens realizeerden we ons dat we alles konden automatiseren en gerust konden slapen. En plotseling stuiten we op een mega-valkuil: er doet zich een false positive voor en we schakelen het verkeer heen en weer, terwijl we dat eigenlijk niet hadden moeten doen. Dit leidt tot replicatiefouten of andere problemen — dat is de vallei van wanhoop. Daarna komen we tot het besef dat we alles met wijsheid moeten benaderen. Het betekent dat het zinvol is om op automatisering te vertrouwen, met de mogelijkheid van een false positive in het achterhoofd. Maar! als de gevolgen verwoestend kunnen zijn, is het beter om dit over te laten aan de verantwoordelijke ploeg, de wachtende ingenieurs, die zullen controleren en zorgen dat er daadwerkelijk een storing is, en de nodige acties handmatig zullen uitvoeren…
Conclusie
In 7 jaar zijn we van een situatie waarin er paniek was bij elke storing naar het besef gekomen dat er geen problemen zijn, alleen maar taken die moeten — en kunnen — worden opgelost. Wanneer je een service bouwt, bekijk het vanuit een overzichtelijk perspectief en beoordeel alle risico's die zich kunnen voordoen. Als je ze onmiddellijk ziet, zorg dan voor reservering en de mogelijkheid om een fouttolerante infrastructuur op te bouwen, want elk punt dat kan falen en de service onbruikbaar kan maken — het zal dat zeker doen. En zelfs als je denkt dat bepaalde infrastructuurelementen absoluut niet zullen falen — zoals s3 — houd er rekening mee dat ze dat toch kunnen. En heb in ieder geval in theorie een idee van wat je ermee zult doen als er toch iets misgaat. Heb een plan voor risicobeheer. Wanneer je overweegt alles te automatiseren of handmatig te doen, beoordeel dan de risico's: wat gebeurt er als de automatisering alles gaat schakelen — zal dit niet leiden tot een nog slechter resultaat dan de storing zelf? Misschien moet je ergens een redelijke compromis vinden tussen het gebruik van automatisering en de reactie van de verantwoordelijke ingenieur, die het werkelijke beeld zal beoordelen en zal begrijpen of er direct iets moet worden aangepast of "ja, maar niet nu."
Een redelijke compromis tussen perfectionisme en de werkelijke middelen, tijd en geld die u kunt besteden aan het schema dat u uiteindelijk zult hebben.
Deze tekst is een aangevulde en uitgebreide versie van de presentatie van Alexander Demidov op de conferentie. .
Bron: habr.com
