

Vaak hebben mensen die het gebied van Data Science betreden een niet helemaal realistisch beeld van wat hen te wachten staat. Velen denken dat ze meteen geweldige neurale netwerken gaan schrijven, een digitale assistent maken zoals Iron Man of iedereen gaan verslaan op de financiële markten.
Maar het werk Data van een Scientist draait om gegevens, en een van de belangrijkste en tijdsintensievere stappen is het verwerken van gegevens voordat deze aan een neuraal netwerk worden aangeboden of op een bepaalde manier worden geanalyseerd.
In dit artikel zal ons team uitleggen hoe je gegevens eenvoudig en snel kunt verwerken met een stapsgewijze instructie en code. We hebben geprobeerd de code voldoende flexibel te maken, zodat deze voor verschillende datasets kan worden toegepast.
Vele professionals vinden mogelijk niets buitengewoons in dit artikel, maar beginners kunnen iets nieuws opdoen, en ook iedereen die al lang droomt van een aparte notebook voor snelle en gestructureerde gegevensverwerking kan de code kopiëren en deze naar eigen inzicht formatteren of
We hebben de dataset ontvangen. Wat nu?
Dus, het standaardproces: we moeten begrijpen met wat voor gegevens we werken, het algemene beeld. Hiervoor gebruiken we pandas om eenvoudig verschillende typen gegevens te bepalen.
import pandas as pd # importeren van pandas
import numpy as np  # importeren van numpy
df = pd.read_csv("AB_NYC_2019.csv") # lezen van de dataset en opslaan in de variabele df
df.head(3) # bekijken van de eerste 3 rijen om te begrijpen hoe de waarden eruitzien 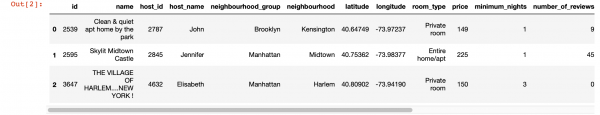
df.info() # tonen van informatie over de kolommen 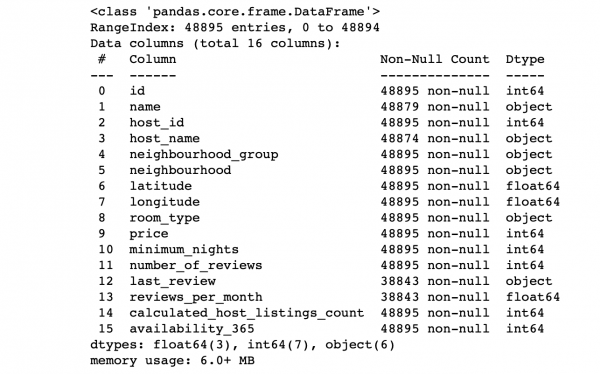
Laten we kijken naar de waarden in de kolommen:
- Is het aantal rijen in elke kolom gelijk aan het totale aantal rijen?
- Wat is de essentie van de gegevens in elke kolom?
- Welke kolom willen we als doel stellen om voorspellingen voor te doen?
Antwoorden op deze vragen helpen bij het analyseren van de dataset en vormen een ruw plan voor de komende stappen.
Voor ook een dieper inzicht in de waarden in elke kolom kunnen we de functie pandas describe() gebruiken. Een nadeel van deze functie is echter dat het geen informatie geeft over kolommen met stringwaarden. Daarover zullen we later meer uitleggen.
df.describe() 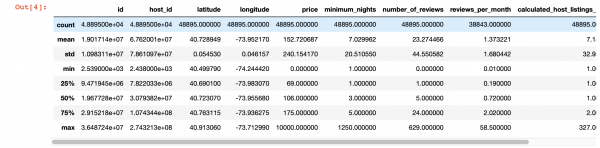
Magische visualisatie
Laten we kijken waar er helemaal geen waarden aanwezig zijn:
import seaborn as sns
sns.heatmap(df.isnull(), yticklabels=False, cbar=False, cmap='viridis') 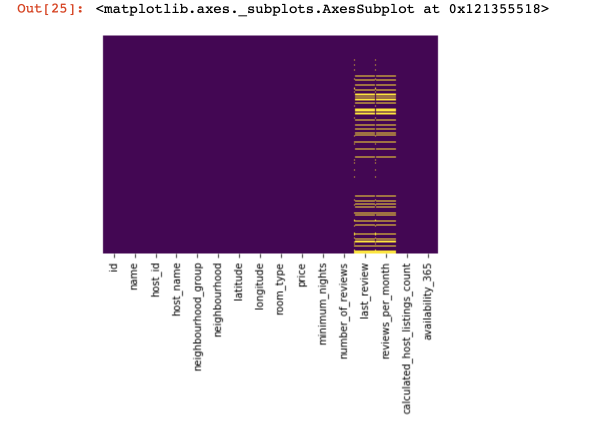
Dit was een klein overzicht van bovenaf, nu gaan we verder met interessantere zaken.
Laten we proberen de kolommen te vinden en waar mogelijk te verwijderen die in alle rijen slechts één waarde hebben (ze zullen het resultaat niet beïnvloeden):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #We overschrijven de dataset, zodat alleen de kolommen met meer dan één unieke waarde overblijven
Nu beschermen we onszelf en het succes van ons project tegen duplicaatrijen (rijen die dezelfde informatie in dezelfde volgorde bevatten als een van de bestaande rijen):
df.drop_duplicates(inplace=True) #We doen dit als we dat nodig achten.
                                 #In sommige projecten is het beter om dergelijke gegevens niet meteen te verwijderen.
We splitsen de dataset in twee: één met kwalitatieve waarden en de andere met kwantitatieve waarden
Hier moet een kleine nuancering worden gemaakt: als de rijen met ontbrekende gegevens bij kwalitatieve en kwantitatieve gegevens niet sterk met elkaar samenhangen, moet er een beslissing worden genomen over wat we opofferen - alle rijen met ontbrekende gegevens, slechts een deel ervan of bepaalde kolommen. Als de rijen wel samenhangen, hebben we het volledige recht om de dataset in tweeën te splitsen. In andere gevallen moeten we eerst de rijen aanpakken waarin de ontbrekende gegevens in de kwalitatieve en kwantitatieve niet samenhangen, en pas daarna de dataset splitsen.
df_numerical = df.select_dtypes(include = [np.number])
df_categorical = df.select_dtypes(exclude = [np.number])
We doen dit om het gemakkelijker te maken deze twee verschillende datatypes te verwerken - later zullen we begrijpen hoezeer dit ons leven vereenvoudigt.
We werken met kwantitatieve gegevens
Het eerste dat we moeten doen, is controleren of er 'spionkolommen' zijn in de kwantitatieve gegevens. We noemen deze kolommen zo omdat ze zich als kwantitatieve gegevens voordoen, maar eigenlijk als kwalitatieve gegevens functioneren.
Hoe kunnen we ze identificeren? Natuurlijk hangt dit allemaal af van de aard van de gegevens die u analyseert, maar over het algemeen kunnen dergelijke kolommen weinig unieke gegevens hebben (ongeveer 3-10 unieke waarden).
print(df_numerical.nunique())Nadat we de spionkolommen hebben geïdentificeerd, verplaatsen we ze van de kwantitatieve gegevens naar de kwalitatieve:
spy_columns = df_numerical[['kolom1', 'kolom2', 'kolom3']]#selecteer spionkolommen en schrijf deze naar een aparte dataframe
df_numerical.drop(labels=['kolom1', 'kolom2', 'kolom3'], axis=1, inplace = True)#verwijder deze kolommen uit de numerieke gegevens
df_categorical.insert(1, 'kolom1', spy_columns['kolom1']) #voeg de eerste spionkolom toe aan de kwalitatieve gegevens
df_categorical.insert(1, 'kolom2', spy_columns['kolom2']) #voeg de tweede spionkolom toe aan de kwalitatieve gegevens
df_categorical.insert(1, 'kolom3', spy_columns['kolom3']) #voeg de derde spionkolom toe aan de kwalitatieve gegevens
We hebben eindelijk de numerieke gegevens volledig gescheiden van de kwalitatieve en nu kunnen we er echt mee aan de slag. Allereerst moeten we begrijpen waar we lege waarden hebben (NaN, en in sommige gevallen ook 0 zal worden beschouwd als lege waarden).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
In deze fase is het belangrijk om te begrijpen in welke kolommen nullen leegstaande waarden kunnen betekenen: heeft dit te maken met hoe de gegevens zijn verzameld? Of kan dit verband houden met de waarden van de gegevens? Deze vragen moeten per geval worden beantwoord.
Als we dus hebben besloten dat er gegevens kunnen ontbreken waar er nullen zijn, moeten we de nullen vervangen door NaN, zodat het later gemakkelijker is om met deze verloren gegevens te werken:
df_numerical[["kolom 1", "kolom 2"]] = df_numerical[["kolom 1", "kolom 2"]].replace(0, nan)Laten we nu kijken waar we gegevens missen:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Je kunt ook df_numerical.info() gebruiken 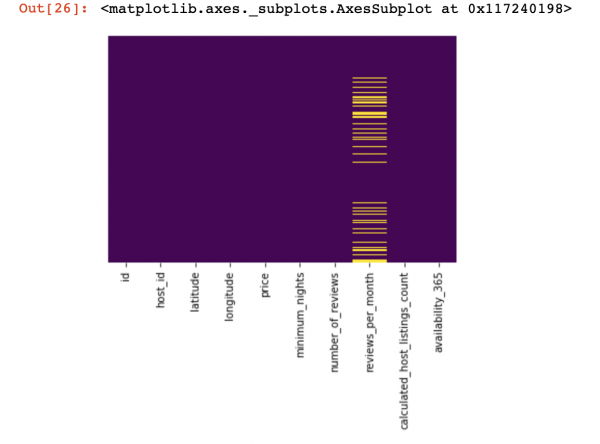
Hier moeten de waarden binnen de kolommen die ontbreken in het geel gemarkeerd zijn. En het meest interessante begint nu — wat moeten we doen met deze waarden? Rijen of kolommen met deze waarden verwijderen? Of deze lege waarden vullen met iets anders?
Hier is een ruwe schets die je kan helpen beslissen wat je in principe met lege waarden kunt doen:
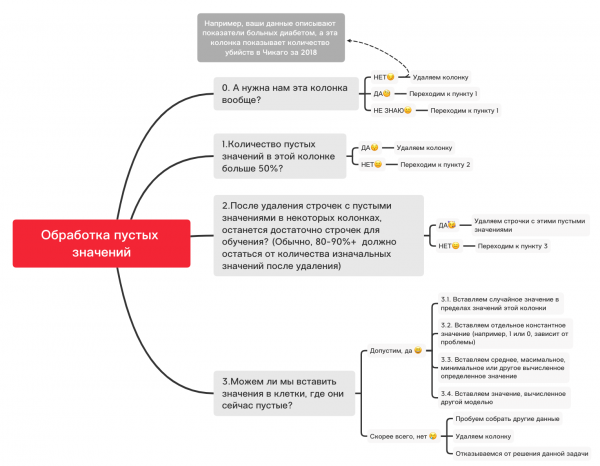
0. Verwijder onnodige kolommen
df_numerical.drop(labels=["kolom1","kolom2"], axis=1, inplace=True)1. Is het aantal lege waarden in deze kolom groter dan 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["kolom1","kolom2"], axis=1, inplace=True)#Verwijder als een kolom meer dan 50 lege waarden heeft2. Verwijder rijen met lege waarden
df_numerical.dropna(inplace=True)#Verwijder rijen met lege waarden, als er daarna voldoende gegevens voor training overblijven3.1. Voer een willekeurige waarde in
import random #importeer random
df_numerical["kolom"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolom"]), inplace=True) #voeg willekeurige waarden in lege cellen van de tabel in
3.2. Voer een constante waarde in
from sklearn.impute import SimpleImputer #importeer SimpleImputer, dat helpt bij het invullen van waarden
imputer = SimpleImputer(strategy='constant', fill_value="") #voeg een bepaalde waarde in met behulp van SimpleImputer
df_numerical[["nieuwe_kolom1",'nieuwe_kolom2','nieuwe_kolom3']] = imputer.fit_transform(df_numerical[['kolom1', 'kolom2', 'kolom3']]) #Pas dit toe op onze tabel
df_numerical.drop(labels = ["kolom1","kolom2","kolom3"], axis = 1, inplace = True) #Verwijder kolommen met oude waarden
3.3. Voer het gemiddelde of het meest voorkomende waarde in
from sklearn.impute import SimpleImputer #importeer SimpleImputer, dat helpt bij het invullen van waarden
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #in plaats van mean kan ook most_frequent worden gebruikt
df_numerical[["nieuwe_kolom1",'nieuwe_kolom2','nieuwe_kolom3']] = imputer.fit_transform(df_numerical[['kolom1', 'kolom2', 'kolom3']]) #Pas dit toe op onze tabel
df_numerical.drop(labels = ["kolom1","kolom2","kolom3"], axis = 1, inplace = True) #Verwijder kolommen met oude waarden
3.4. Voer een waarde in, berekend door een ander model
Waarden kunnen soms worden berekend met regressiemodellen, door gebruik te maken van modellen uit de bibliotheek sklearn of andere vergelijkbare bibliotheken. Ons team zal in de nabije toekomst een apart artikel wijden aan hoe dit kan worden gedaan.
Dus, het verhaal over kwantitatieve gegevens stopt hier, omdat er veel andere nuances zijn over hoe datavoorbereiding en preprocessing het beste kunnen worden gedaan voor verschillende taken, en de basisprincipes voor kwantitatieve gegevens zijn in dit artikel behandeld. Nu is het tijd om terug te keren naar kwalitatieve gegevens, die we een paar stappen geleden van kwantitatieve gegevens hebben gescheiden. U kunt dit notebook naar eigen wens aanpassen voor verschillende taken, zodat de data preprocessing zeer snel verloopt!
Kwalitatieve gegevens
Over het algemeen wordt de One-hot-encoding-methode gebruikt voor kwalitatieve gegevens, om deze te formatteren van string (of object) naar getal. Voordat we dit onderdeel behandelen, zullen we de schema en code hierboven gebruiken om de lege waarden te begrijpen.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 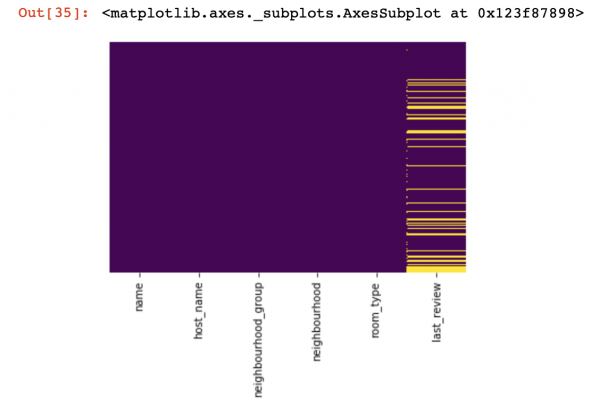
0. Verwijder onnodige kolommen
df_categorical.drop(labels=["kolom1","kolom2"], axis=1, inplace=True)1. Is het aantal lege waarden in deze kolom groter dan 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["kolom1","kolom2"], axis=1, inplace=True) # Verwijderen als een kolom
# meer dan 50% lege waarden heeft2. Verwijder rijen met lege waarden
df_categorical.dropna(inplace=True) # Verwijder rijen met lege waarden,
                                   # als er daarna nog genoeg gegevens overblijven voor training
3.1. Voer een willekeurige waarde in
import random
df_categorical["kolom"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolom"]), inplace=True)
3.2. Voer een constante waarde in
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nieuwe_kolom1", 'nieuwe_kolom2', 'nieuwe_kolom3']] = imputer.fit_transform(df_categorical[['kolom1', 'kolom2', 'kolom3']])
df_categorical.drop(labels=["kolom1", "kolom2", "kolom3"], axis=1, inplace=True)
Dus, eindelijk hebben we de lege waarden in kwalitatieve gegevens opgelost. Nu is het tijd om one-hot-encoding toe te passen op de waarden die in uw database staan. Deze methode wordt vaak gebruikt zodat uw algoritme kan leren met inachtneming van kwalitatieve gegevens.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["kolom1", "kolom2", "kolom3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Dus, eindelijk hebben we de kwalitatieve en kwantitatieve gegevens apart verwerkt — tijd om ze weer samen te voegen
new_df = pd.concat([df_numerical, df_categorical], axis=1)Nadat we de datasets in één hebben samengevoegd, kunnen we als laatste de gegevenstransformatie toepassen met behulp van MinMaxScaler uit de sklearn-bibliotheek. Dit zal onze waarden beperken tot tussen 0 en 1, wat zal helpen bij het trainen van het model in de toekomst.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Deze gegevens zijn nu klaar voor alles — neurale netwerken, standaard ML-algoritmen, enzovoort!
In dit artikel hebben we de verwerking van gegevens met betrekking tot tijdreeksen niet overwogen, omdat voor dergelijke gegevens iets andere technieken voor verwerking moeten worden gebruikt, afhankelijk van uw taak. In de toekomst zal ons team dit onderwerp een aparte artikel wijden, en we hopen dat het iets interessants, nieuws en nuttigs in uw leven zal brengen, net als dit.
Bron: habr.com
