

Hallo allemaal! Mijn naam is Dmitry Samsonov, ik werk als hoofd systeembeheerder bij 'Odnoklassniki'. We hebben meer dan 7.000 fysieke servers, 11.000 containers in onze cloud en 200 applicaties die in verschillende configuraties 700 verschillende clusters vormen. Het overgrote deel van de servers draait onder CentOS 7.
Op 14 augustus 2018 werd informatie gepubliceerd over de kwetsbaarheid FragmentSmack
() en SegmentSmack (). Dit zijn kwetsbaarheden met een netwerkaanvalsvector en een vrij hoge score (7.5), die een denial of service (DoS) kan veroorzaken door uitputting van middelen (CPU). De fix in de kernel voor FragmentSmack was op dat moment nog niet aangeboden, bovendien kwam deze veel later dan de publicatie van de informatie over de kwetsbaarheid. Voor de oplossing van SegmentSmack werd geadviseerd de kernel bij te werken. Het pakket met de update werd op dezelfde dag uitgebracht, het enige wat overbleef was om het te installeren.
Nee, we zijn helemaal niet tegen het bijwerken van de kernel! Maar er zijn nuances...
Hoe we de kernel in productie bijwerken
Eigenlijk is het niet moeilijk:
- Pakketten downloaden;
- Ze installeren op een aantal servers (inclusief servers die onze cloud hosten);
- Zorg ervoor dat er niets kapot is gegaan;
- Zorg ervoor dat alle standaard kernelinstellingen zonder fouten zijn toegepast;
- Enkele dagen wachten;
- De serverprestaties controleren;
- De uitrol van nieuwe servers overschakelen naar de nieuwe kernel;
- Alle servers per datacentrum bijwerken (één datacentrum tegelijk, om de impact voor gebruikers in geval van problemen te minimaliseren);
- Alle servers opnieuw opstarten.
Herhaal dit voor alle versies van de kernels die we hebben. Momenteel zijn dat:
- Standaard CentOS 7 3.10 - voor de meeste gewone servers;
- Vanilla 4.19 - voor onze , omdat we BFQ, BBR, enz. nodig hebben;
- Elrepo kernel-ml 5.2 - voor , omdat 4.19 eerder onbetrouwbaar was, maar we dezelfde features nodig hebben.
Zoals je kunt raden, kost het meeste tijd om duizenden servers opnieuw op te starten. Aangezien niet alle kwetsbaarheden kritiek zijn voor alle servers, herstarten we alleen de servers die direct toegankelijk zijn via het internet. In de cloud, om de flexibiliteit niet te beperken, koppelen we de externe containers niet aan afzonderlijke servers met een nieuw systeem, maar herstarten we alle hosts zonder uitzondering. Gelukkig is de procedure daar eenvoudiger dan bij reguliere servers. Bijvoorbeeld, stateless containers kunnen gewoon naar een andere server verhuizen tijdens de herstart.
Toch is er nog steeds veel werk, en dit kan enkele weken duren; bij problemen met de nieuwe versie kan het zelfs maanden duren. Kwaadwillenden begrijpen dit goed, dus er is een plan 'B' nodig.
FragmentSmack/SegmentSmack. Workaround
Gelukkig bestaat voor sommige kwetsbaarheden zo'n plan 'B', dat wordt Workaround genoemd. Meestal gaat het om het aanpassen van kernel-/applicatie-instellingen die het mogelijk maken de impact te minimaliseren of volledige uitbuiting van kwetsbaarheden uit te sluiten.
In het geval van FragmentSmack/SegmentSmack deze Workaround:
«Je kunt de standaardwaarden 4MB en 3MB in net.ipv4.ipfrag_high_thresh en net.ipv4.ipfrag_low_thresh (en hun equivalente instellingen voor ipv6 net.ipv6.ipfrag_high_thresh en net.ipv6.ipfrag_low_thresh) wijzigen in respectievelijk 256 kB en 192 kB of lager. Tests tonen een kleine tot significante daling van het CPU-gebruik tijdens de aanval aan, afhankelijk van de hardware, instellingen en omstandigheden. Er kan echter enige invloed op de prestaties zijn door ipfrag_high_thresh=262144 bytes, aangezien slechts twee 64K-fragmenten tegelijkertijd in de wachtrij voor hersamenstelling kunnen passen. Bijvoorbeeld, er is een risico dat applicaties die met grote UDP-pakketten werken, beschadigd raken.».
De parameters zelf worden als volgt beschreven:
ipfrag_high_thresh - LANGDIGE GEHEELGETAL
     Maximale geheugen dat gebruikt wordt om IP-fragmenten opnieuw samen te stellen.
ipfrag_low_thresh - LANGEN GETAL
     Maximale geheugen dat wordt gebruikt om IP-fragmenten opnieuw samen te stellen voordat de kernel
     begint onvolledige fragmentwachtrijen te verwijderen om middelen vrij te maken.
     De kernel accepteert nog steeds nieuwe fragmenten voor defragmentatie.
We hebben geen productieservices voor grote UDP. In LAN is gefragmenteerd verkeer afwezig, in WAN is het er, maar niet significant. Er zijn geen tekenen — we kunnen de Workaround toepassen!
FragmentSmack/SegmentSmack. Eerste bloed
Het eerste probleem waarmee we werden geconfronteerd, was dat cloudcontainers soms nieuwe instellingen slechts gedeeltelijk toepasten (alleen ipfrag_low_thresh), en soms helemaal niet - ze crashte simpelweg bij het opstarten. Het was niet mogelijk om het probleem consistent te recreëren (handmatig werden alle instellingen zonder enige complicaties toegepast). Begrijpen waarom de container bij het opstarten crasht was ook niet zo eenvoudig: er werden geen fouten aangetroffen. Eén ding was zeker: het terugdraaien van de instellingen loste het probleem van de crashe containers op.
Waarom is het niet genoeg om Sysctl op de host toe te passen? De container leeft in zijn eigen toegewezen netwerknamespace, dus in ieder geval in de container kan verschillen van de host.
Hoe worden de Sysctl-instellingen in de container toegepast? Aangezien onze containers niet-bevoorrecht zijn, kunnen we geen enkele Sysctl-instelling aanpassen door de container zelf binnen te gaan - de rechten zijn simpelweg niet voldoende. Voor het starten van containers gebruikte onze cloud op dat moment Docker (nu al ). Docker ontving via de API de parameters van de nieuwe container, inclusief de benodigde Sysctl-instellingen.
Tijdens het doorwerken van de versies bleek dat de Docker API niet alle fouten gaf (in ieder geval niet in versie 1.10). Toen we probeerden de container te starten via 'docker run', zagen we eindelijk iets:
write /proc/sys/net/ipv4/ipfrag_high_thresh: ongeldige argument docker: Foutreactie van daemon: Kan container niet starten: [9] Systeemfout: kon niet synchroniseren met het containerproces.
De waarde van de parameter is ongeldig. Maar waarom? En waarom is het alleen soms ongeldig? Het bleek dat Docker de volgorde van de toepassing van Sysctl-parameters niet garandeert (de laatste gecontroleerde versie - 1.13.1), daarom probeerde ipfrag_high_thresh soms 256K in te stellen, terwijl ipfrag_low_thresh nog 3M was, wat betekent dat de bovengrens lager was dan de ondergrens, wat de fout veroorzaakte.
Tegen die tijd gebruikten we al een eigen mechanisme voor het opnieuw configureren van de container na het starten (de container bevriezen via en het uitvoeren van opdrachten in de namespace van de container via ), en we voegden in dit deel ook het vastleggen van de Sysctl-parameters toe. Het probleem was opgelost.
FragmentSmack/SegmentSmack. De eerste bloedding 2
We had just begun to understand the use of Workaround in the cloud when we started receiving the first few sporadic complaints from users. Several weeks had passed since the implementation of Workaround on the first servers. The initial investigation showed that complaints were about specific services, not all servers hosting those services. The problem had once again taken on a highly ambiguous nature.
First and foremost, we tried reverting the Sysctl settings, but this had no effect. Various manipulations with server and application settings also did not help. A reboot did. Rebooting for Linux is as unnatural as it was a normal condition for working with Windows in the past. Nevertheless, it helped, and we attributed everything to a 'glitch in the kernel' when applying new Sysctl settings. How naive we were...
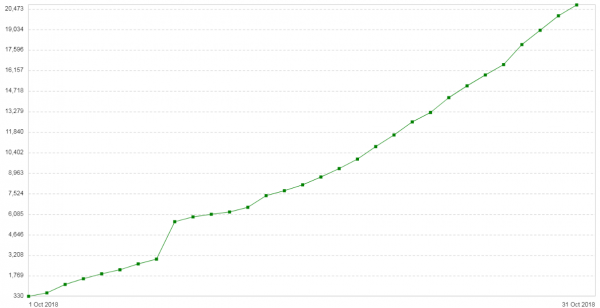
Three weeks later, the problem recurred. The configuration of these servers was quite simple: Nginx in proxy/load balancer mode. The traffic was minimal. A new development: the number of 504 errors on the clients was increasing daily (). The graph shows the number of 504 errors per day for this service:
All errors were related to the same backend—the one located in the cloud. The memory consumption graph for packet fragments on this backend looked as follows:
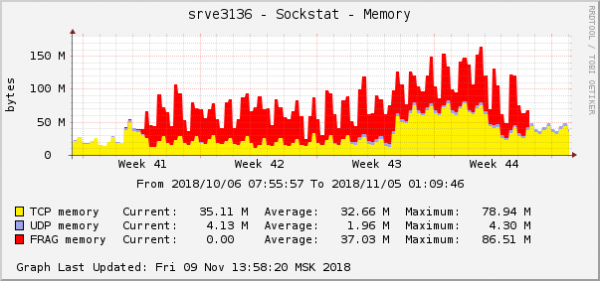
This is one of the most vivid manifestations of the problem on the operating system graphs. At the same time, another network issue with QoS (Traffic Control) settings was fixed in the cloud. The memory consumption graph for packet fragments looked exactly the same:
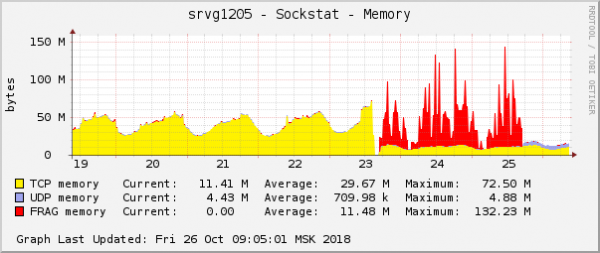
The assumption was simple: if they look the same on the graphs, the cause must be the same. Especially since any issues with this type of memory occur extremely rarely.
The essence of the fixed problem was that we used the fq packet scheduler in QoS with default settings. By default, it allows up to 100 packets to be queued for a single connection, and some connections, in situations of bandwidth shortage, began to fill the queue to capacity. In this case, packets are dropped. This can be seen in the tc statistics (tc -s qdisc) as follows:
qdisc fq 2c6c: parent 1:2c6c limiet 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Verzonden 454701676345 bytes 491683359 pkt (gedropt 464545, overschrijdingen 0 herplaatsingen 0)
  achterstand 0b 0p herplaatsingen 0
   1024 stromen (1021 inactief, 0 afgeknepen)
   0 gc, 0 hoge prioriteit, 0 afgeknepen, 464545 flows_plimit
«464545 flows_plimit» zijn de pakketten die zijn gedropt vanwege het overschrijden van de wachtrijlimiet van één verbinding, terwijl «dropped 464545» de som is van alle gedropte pakketten van deze scheduler. Na het verhogen van de wachtrijlengte tot 1000 en het herstarten van de containers, is het probleem niet meer teruggekomen. Je kunt achterover leunen in je stoel en een smoothie drinken.
FragmentSmack/SegmentSmack. De laatste kwetsbaarheid.
Een paar maanden na de aankondiging van de kwetsbaarheden in de kernel is er eindelijk een patch voor FragmentSmack beschikbaar gekomen (ter herinnering, bij de aankondiging in augustus was er alleen een patch voor SegmentSmack), wat ons de kans gaf om de Workaround te beëindigen die ons behoorlijk veel problemen bezorgde. In de tussentijd hadden we al enkele servers naar de nieuwe kernel overgezet, en nu moesten we opnieuw beginnen. Waarom hebben we de kernel bijgewerkt zonder op de patch voor FragmentSmack te wachten? Dit kwam omdat het proces van bescherming tegen deze kwetsbaarheden samenviel (en versmolt) met het proces van de update van CentOS zelf (wat nog meer tijd kost dan alleen de kernel bijwerken). Bovendien is SegmentSmack een gevaarlijkere kwetsbaarheid, en de patch daarvoor was meteen beschikbaar, dus het had hoe dan ook zin. Echter, we konden de kernel op CentOS niet zomaar bijwerken, omdat de kwetsbaarheid FragmentSmack, die verscheen tijdens CentOS 7.5, pas in versie 7.6 was gepatcht, dus we moesten stoppen met de update naar 7.5 en alles opnieuw starten met de update naar 7.6. En zo kan het ook gaan.
Ten tweede hebben we sporadische klachten van gebruikers over problemen teruggekregen. Nu weten we zeker dat ze allemaal verband hielden met het uploaden van bestanden door klanten naar enkele van onze servers. Overigens ging het via deze servers om een zeer klein aantal uploads in verhouding tot het totaal.
Zoals we ons uit het bovenstaande verhaal herinneren, hielp het terugzetten van Sysctl niet. Een herstart hielp, maar tijdelijk.
De verdenkingen ten aanzien van Sysctl waren nog niet weggenomen, maar deze keer was het nodig om zoveel mogelijk informatie te verzamelen. Ook ontbrak het ons aan de mogelijkheid om het uploadprobleem bij de klant te reproduceren, zodat we gerichter konden onderzoeken wat er aan de hand was.
Analyse van alle beschikbare statistieken en logs heeft ons niet dichterbij het begrijpen van de situatie gebracht. Er ontbrak een mogelijkheid om het probleem te reproduceren, zodat we de specifieke verbinding konden ‘voelen’. Uiteindelijk zijn de ontwikkelaars met een speciale versie van de applicatie erin geslaagd om het probleem stabiel te reproduceren op een testapparaat dat via Wi-Fi is verbonden. Dit was een doorbraak in het onderzoek. De klant maakte verbinding met Nginx, dat doorstuurde naar de backend, dat onze Java-applicatie was.
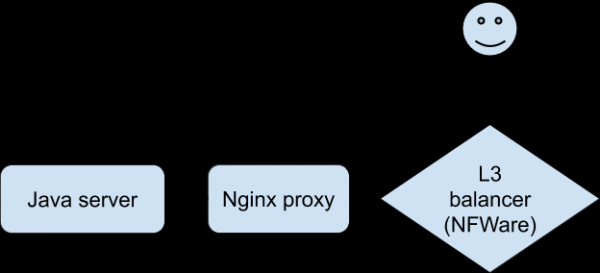
De dialoog bij problemen was als volgt (vastgelegd aan de Nginx-proxyzijde):
- Klant: verzoek om informatie over het opnieuw downloaden van het bestand.
- Java-server: reactie.
- Klant: POST met bestand.
- Java-server: fout.
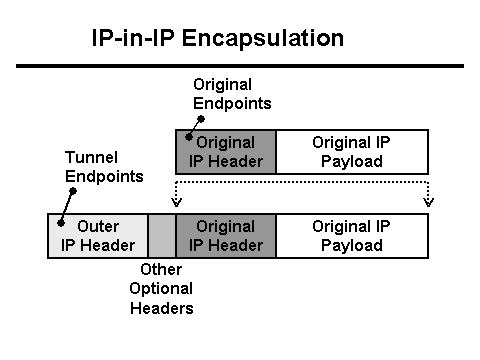
De Java-server schrijft in de log dat er 0 bytes aan gegevens van de klant zijn ontvangen, terwijl Nginx-proxy aangeeft dat de aanvraag meer dan 30 seconden duurde (30 seconden is de timeout van de client-applicatie). Waarom dan de timeout en waarom 0 bytes? Vanuit het perspectief van HTTP werkt alles zoals het zou moeten, maar de POST met het bestand lijkt uit het netwerk te verdwijnen. En het verdwijnt tussen de klant en Nginx. Het is tijd om Tcpdump te gebruiken! Maar eerst moeten we de netwerkconfiguratie begrijpen. Nginx-proxy staat achter een L3-load balancer. . Er wordt tunneling gebruikt om pakketten van de L3-load balancer naar de server te leveren, wat extra headers aan de pakketten toevoegt:
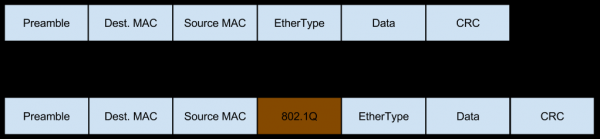
Het netwerk naar deze server komt in de vorm van VLAN-getagde verkeer, dat ook zijn velden aan de pakketten toevoegt:
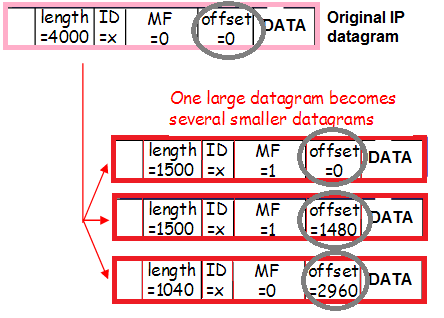
Daarnaast kan dit verkeer fragmenteren (datzelfde kleine percentage van binnenkomend gefragmenteerd verkeer waar we het over hadden bij het risico-evaluatie van de Workaround), wat ook de inhoud van de headers verandert:
Nogmaals: de pakketten zijn ingekapseld met een VLAN-tag, ingekapseld met tunneling, gefragmenteerd. Om beter te begrijpen hoe dit gebeurt, volgen we de route van het pakket van de klant naar de Nginx-proxy.
- Het pakket komt op de L3-load balancer aan. Voor correcte routering binnen het datacenter wordt het pakket ingekapseld in een tunnel en naar de netwerkkaart gestuurd.
- Aangezien het pakket + de headers van de tunnel niet in de MTU passen, wordt het pakket in fragmenten gesneden en naar het netwerk verzonden.
- De switch na de L3-load balancer voegt bij ontvangst van het pakket een VLAN-tag toe en verstuurt het verder.
- De switch vóór de Nginx-proxy ziet (op basis van de poortinstellingen) dat de server een Vlan-ingekapseld pakket verwacht, en verzendt het daarom zoals het is, zonder de Vlan-tag te verwijderen.
- Linux ontvangt fragmenten van afzonderlijke pakketten en plakt deze aan elkaar tot één groot pakket.
- Daarna komt het pakket op de Vlan-interface, waar de eerste laag - Vlan-ingekapseling - wordt verwijderd.
- Vervolgens stuurt Linux het naar de Tunnel-interface, waar nog een laag - Tunnel-ingekapseling - wordt verwijderd.
De moeilijkheid ligt in het doorgeven van dit alles als parameters aan tcpdump.
Laten we beginnen met het einde: zijn er schone (zonder extra headers) IP-pakketten van clients, zonder Vlan- en tunnel-ingekapseling?
tcpdump host
Nee, zulke pakketten waren er niet op de server. Dit betekent dat het probleem eerder moet zijn. Zijn er pakketten met alleen de Vlan-ingekapseling verwijderd?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx is het IP-adres van de client in hex-formaat.
32:4 is het adres en de lengte van het veld waarin het SCR IP in het Tunnel-pakket is opgeslagen.
Het adres van het veld moest door middel van trial-and-error worden bepaald, aangezien op internet over 40, 44, 50, 54 wordt geschreven, maar daar was er geen IP-adres. Je kunt ook een van de pakketten in hex bekijken (met de parameter -xx of -XX in tcpdump) en tellen op welk adres het bekende IP staat.
Zijn er fragmenten van pakketten zonder Vlan- en Tunnel-ingekapseling?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Deze magie zal ons alle fragmenten tonen, inclusief de laatste. Waarschijnlijk kan dit ook worden gefilterd op IP, maar ik heb het niet geprobeerd, omdat er niet zoveel van zulke pakketten zijn, en ik vond de benodigde gemakkelijk in de algemene stroom. Hier zijn ze:
14:02:58.471063 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), lengte 1516: (tos 0x0, ttl 63, id 53652, offset 0, vlaggen [+], proto IPIP (4), lengte 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 bytes ontbreken! (tos 0x0, ttl 50, id 57750, offset 0, vlaggen [DF], proto TCP (6), lengte 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Vlaggen [.], seq 0:1448, ack 1, win 343, opties [nop,nop,TS val 11660691 ecr 2998165860], lengte 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 als..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), lengte 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), lengte 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Dit zijn twee fragmenten van hetzelfde pakket (zelfde ID 53652) met een foto (het woord Exif is zichtbaar in het eerste pakket). Aangezien op dit niveau pakketten aanwezig zijn, maar in samengevoegde vorm in dumps niet, is het probleem duidelijk met de assemblage. Eindelijk is daar documentair bewijs voor!
De pakketdecoder heeft geen problemen gevonden die de assemblage belemmeren. Ik heb het hier geprobeerd: Aanvankelijk, bij de poging om iets te uploaden, vond de decoder het pakketformaat niet leuk. Het bleek dat er twee overbodige octetten waren tussen Srcmac en Ethertype (die niet tot fragmentinformatie behoorden). Nadat deze waren verwijderd, functioneerde de decoder weer. Echter, er werden geen problemen gerapporteerd.
Hoe dan ook, behalve die specifieke Sysctl was er niets anders te vinden. Het was nodig om een manier te vinden om problematische servers te identificeren, zodat we de omvang konden begrijpen en besluiten over verdere actie konden nemen. Al snel vond ik de juiste teller:
netstat -s | grep "packet reassembles failed”
Deze is ook aanwezig in snmpd onder OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«Het aantal fouten dat is gedetecteerd door het IP-herassembleeralgoritme (om welke reden dan ook: tijdoverschrijding, fouten, etc.)».
Onder de groep servers waar het probleem werd bestudeerd, nam deze teller sneller toe op twee servers, langzamer op twee andere, en op weer twee steeg hij helemaal niet. De vergelijking van de dynamiek van deze teller met de dynamiek van HTTP-fouten op de Java-server onthulde een correlatie. Dit betekent dat de teller kon worden opgenomen in de monitoring.
Het hebben van een betrouwbare indicator van problemen is zeer belangrijk om exact te kunnen bepalen of een terugrol van Sysctl helpt, aangezien we uit het eerdere verhaal weten dat dit niet onmiddellijk kan worden begrepen aan de applicatiekant. Deze indicator zou helpen om alle problematische gebieden in de productie te identificeren voordat gebruikers dit ontdekken.
Na de terugrol van Sysctl verdwenen de fouten in de monitoring, waardoor de oorzaak van de problemen werd bewezen, evenals dat de terugrol helpt.
We hebben de fragmentatie-instellingen op andere servers teruggerold, waar nieuwe monitoring was geactiveerd, en ergens heeft men zelfs meer geheugen aan fragmenten toegewezen dan eerder standaard was (dit betrof udp-statistieken, waarvan het gedeeltelijk verlies niet opviel tegen de achtergrond).
De belangrijkste vragen
Waarom worden pakketten op onze L3-loadbalancer gefragmenteerd? De meeste pakketten die van gebruikers op de loadbalancers aankomen, zijn SYN en ACK. De grootte van deze pakketten is klein. Maar omdat het aandeel van dergelijke pakketten heel hoog is, merkten we de aanwezigheid van grotere pakketten die begonnen te fragmenteren niet.
De oorzaak was een defect script voor de configuratie. Op servers met Vlan-interfaces (op dat moment waren er heel weinig servers met getagde verkeer in productie). Advmss maakt het mogelijk om de klant te informeren dat de pakketten in onze richting kleiner moeten zijn, zodat ze na het hechten van de tunnelheaders niet fragment hoeven te worden.
Waarom hielp de rollback van Sysctl niet, terwijl een reboot wel hielp? De rollback van Sysctl veranderde de hoeveelheid geheugen die beschikbaar was voor het samenvoegen van pakketten. Blijkbaar leidde het feit zelf dat het geheugen voor fragmenten vol raakte tot vertraging van de verbindingen, wat resulteerde in langdurige vertragingen van fragmenten in de wachtrij. Kortom, het proces raakte verstrikt.
Een reboot reset het geheugen en alles kwam weer op orde.
Kon men zonder de Workaround? Ja, maar er was een groot risico om gebruikers zonder service te laten in het geval van een aanval. Uiteraard leidde het toepassen van de Workaround tot verschillende problemen, waaronder vertraging van een van de diensten bij de gebruikers, toch denken we dat de acties gerechtvaardigd waren.
Hartelijk dank aan Andrey Timofeyev () voor de hulp bij het uitvoeren van het onderzoek, en ook aan Alexey Krenyov () — voor het enorme werk aan het updaten van Centos en de kernels op de servers. Een proces dat in dit geval meerdere keren opnieuw moest worden begonnen, wat het maanden liet duren.
Bron: habr.com
