

In het begin was er technologie en ze heet BPF. We hebben ernaar gekeken in , de oude testament, artikel van deze cyclus. In 2013 is dankzij Alexei Starovoitov en Daniel Borkman een verbeterde versie ontwikkeld en in de Linux-kernel opgenomen, geoptimaliseerd voor moderne 64-bits machines. Deze nieuwe technologie heette in het kort Internal BPF, later werd het hernoemd naar Extended BPF, en nu, na enkele jaren, noemen we het gewoon BPF.
Grofweg gezegd, BPF stelt gebruikers in staat om willekeurige code uit te voeren in de Linux-kernel, en de nieuwe architectuur bleek zo succesvol te zijn dat we nog een tiental artikelen nodig zullen hebben om alle toepassingen te beschrijven. (Het enige wat de ontwikkelaars niet zijn gelukt, zoals je op de afbeelding hieronder kunt zien, is het maken van een fatsoenlijk logo.)
Dit artikel beschrijft de structuur van de BPF-virtuele machine, de kernelinterfaces voor het werken met BPF, de ontwikkelingshulpmiddelen, en geeft een korte, zeer korte, overzicht van de bestaande mogelijkheden, dat wil zeggen, alles wat we nodig hebben voor een diepere studie van de praktische toepassingen van BPF.
Samenvatting van het artikel
Eerst kijken we vanuit een vogelperspectief naar de BPF-architectuur en markeren we de belangrijkste componenten.
Nu we een algemeen beeld van de architectuur hebben, beschrijven we de structuur van de BPF-virtuele machine.
In dit gedeelte zullen we dieper ingaan op de levenscyclus van BPF-objecten — programma's en mappen.
Met al enige kennis van het systeem zullen we uiteindelijk bekijken hoe we objecten vanuit de gebruikersruimte kunnen creëren en beheren met behulp van een speciale systeemaanroep — bpf(2).
Het is natuurlijk mogelijk om programma's met behulp van systeemaanroepen te schrijven. Maar het is lastig. Voor een realistischer scenario hebben kernelprogrammeurs de bibliotheek ontwikkeld libbpf. We zullen de meest eenvoudige skelettoepassing BPF maken die we in de volgende voorbeelden zullen gebruiken.
Hier leren we hoe BPF-programma's kunnen communiceren met kernel-helperfuncties — een hulpmiddel dat, samen met maps, de mogelijkheden van de nieuwe BPF aanzienlijk uitbreidt in vergelijking met de klassieke versie.
Tegen deze tijd zullen we genoeg weten om te begrijpen hoe programma's die gebruikmaken van maps kunnen worden gemaakt. We zullen zelfs een blik werpen op de grote en krachtige verifier.
Een referentiegedeelte over hoe je de benodigde tools en de kernel kunt samenstellen voor experimenten.
Aan het einde van het artikel zullen degenen die tot daar lezen motiverende woorden en een korte beschrijving van wat de volgende artikelen zullen bevatten, vinden. We zullen ook een aantal links opnoemen voor zelfstandig onderzoek voor degenen die niet willen of kunnen wachten op het vervolg.
Inleiding tot BPF-architectuur
Voordat we de BPF-architectuur gaan bekijken, verwijzen we voor de laatste keer (of niet) naar , die werd ontwikkeld als reactie op de opkomst van RISC-machines en de uitdaging van efficiënte pakket filtering aanpakte. De architectuur bleek zo succesvol dat ze, geboren in de roerige jaren negentig in Berkeley UNIX, naar de meeste bestaande besturingssystemen is geport, de gekke jaren twintig heeft overleefd en nog steeds nieuwe toepassingen vindt.
De nieuwe BPF is ontwikkeld als reactie op de wijdverspreide acceptatie van 64-bits machines, cloudservices en de toenemende vraag naar tools voor het creëren van SDN (Software-We verwijderen de huidige partitie om een nieuwe aan te maken voor in totaal 50 GB.defined networking). Ontwikkeld door netwerktechnici als een geavanceerde vervanging voor de klassieke BPF, vond de nieuwe BPF letterlijk binnen zes maanden toepassingen in de uitdagende taak van het traceren van Linux-systemen, en nu, zes jaar na de lancering, hebben we een geheel volgende artikel nodig om de verschillende typen programma's op te sommen.
VéRkEnDe BeAfGeDe LiNgEn
In wezen is BPF een sandbox-virtuele machine die willekeurige code in de kernelruimte uitvoert zonder de beveiliging in gevaar te brengen. BPF-programma's worden in de gebruikersruimte gemaakt, in de kernel geladen en verbonden met een of andere gebeurtenisbron. Een gebeurtenis kan bijvoorbeeld het afleveren van een pakket op een netwerkinterface zijn, het aanroepen van een bepaalde kernelfunctie, enzovoort. In het geval van een pakket krijgt het BPF-programma toegang tot de gegevens en metadata van het pakket (voor lezen en mogelijk ook voor schrijven, afhankelijk van het type programma), en in het geval van een aanroep van een kernelfunctie zijn de argumenten van de functie beschikbaar, inclusief aanwijzers naar kernelgeheugen, enzovoort.
Laten we dit proces nader bekijken. Ten eerste bespreken we het eerste verschil met de klassieke BPF, waarvoor programma's in assembler werden geschreven. In de nieuwe versie is de architectuur uitgebreid zodat programma's in hogere programmeertalen geschreven kunnen worden, voornamelijk in C. Hiervoor is een backend voor llvm ontwikkeld, die in staat is bytecode voor de BPF-architectuur te genereren.
De BPF-architectuur is ontwikkeld, onder andere, om efficiënt te draaien op moderne machines. Om dit in de praktijk te laten werken, wordt de BPF-bytecode, na de laad in de kernel, door een component genaamd JIT-compiler omgezet in native code (Just In Time). Verder, als je je herinnert, werd in de klassieke BPF het programma atomair in de kernel geladen en verbonden met de gebeurtenisbron - in de context van één systeemaanroep. In de nieuwe architectuur gebeurt dit in twee fasen: eerst wordt de code geladen in de kernel via een systeemaanroep bpf(2), en vervolgens, later, met behulp van andere mechanismen, die variëren afhankelijk van het type programma, wordt het programma verbonden (attaches) met de gebeurtenisbron.
Hier kan de lezer zich afvragen: kon dat echt? Hoe wordt de veiligheid van de uitvoering van dergelijke code gegarandeerd? De veiligheid van de uitvoering wordt gegarandeerd door een fase van het laden van BPF-programma's genaamd de verifier (in het Engels wordt deze fase verifier genoemd en ik zal in het vervolg het Engelse woord gebruiken):
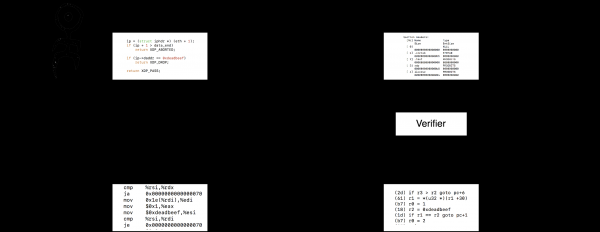
Verifier is een statische analyzer die ervoor zorgt dat een programma de normale werking van de kernel niet verstoort. Dit betekent echter niet dat een programma niet in de systeemwerking kan interfereert — BPF-programma's kunnen, afhankelijk van het type, delen van het geheugensysteem lezen en herschrijven, geretourneerde waarden van functies aanpassen, knippen, aanvullen, herschrijven en zelfs netwerkpakketten doorsturen. Verifier garandeert dat de kernel niet crasht door het draaien van een BPF-programma en dat een programma dat volgens de regels schrijfrechten heeft, bijvoorbeeld op gegevens van uitgaande pakketten, het geheugen van de kernel buiten het pakket niet kan herschrijven. We zullen iets dieper ingaan op verifier in het bijbehorende gedeelte, nadat we alle andere componenten van BPF hebben leren kennen.
Wat hebben we tot nu toe geleerd? De gebruiker schrijft een programma in de C-taal, laadt het in de kernel via een systeemoproep bpf(2), waar het wordt gecontroleerd door de verifier en wordt vertaald naar native bytecode. Vervolgens sluit dezelfde of een andere gebruiker het programma aan op een gebeurtenisbron en begint het met uitvoeren. De scheiding van laden en aansluiten is om verschillende redenen noodzakelijk. Ten eerste, het uitvoeren van de verifier is relatief kostbaar en door steeds dezelfde program te laden, verspillen we computer tijd. Ten tweede hangt de manier waarop het programma wordt aangesloten af van het type ervan en kan één 'universele' interface, ontwikkeld een jaar geleden, niet geschikt zijn voor nieuwe programmsoorten. (Hoewel nu, nu de architectuur rijper wordt, er een idee is om deze interface op niveau te uniformeren) libbpf.)
Een oplettende lezer kan opmerken dat we nog niet klaar zijn met de afbeeldingen. En dat klopt, alles wat hierboven is gezegd, legt niet uit hoe BPF de situatie fundamenteel verandert in vergelijking met de klassieke BPF. Twee innovaties die de toepassingsmogelijkheden aanzienlijk uitbreiden, zijn de mogelijkheid om gedeeld geheugen te gebruiken en kernel helpers. In BPF wordt gedeeld geheugen geïmplementeerd met behulp van zogenaamde maps - gedeelde datastructuren met een bepaalde API. Deze naam hebben ze waarschijnlijk gekregen omdat de eerste type map een hash-tabel was. Later kwamen er arrays, lokale (per-CPU) hash-tabellen en lokale arrays, zoekbomen, maps die aanwijzers naar BPF-programma's bevatten, en nog veel meer. Wat ons nu interesseert, is het feit dat BPF-programma's de mogelijkheid hebben gekregen om hun toestand tussen aanroepen op te slaan en deze te delen met andere programma's en met de gebruikersruimte.
Toegang tot maps wordt verkregen vanuit gebruikersprocessen via een systeemaanroep bpf(2), en vanuit BPF-programma's die in de kernel draaien - met behulp van helper functies. Bovendien zijn helpers niet alleen bedoeld voor het werken met maps, maar ook voor toegang tot andere mogelijkheden van de kernel. Bijvoorbeeld, BPF-programma's kunnen helperfuncties gebruiken om pakketten naar andere interfaces te omleiden, om gebeurtenissen van de perf-subsysteem te genereren, toegang te krijgen tot kernelstructuren, enzovoort.
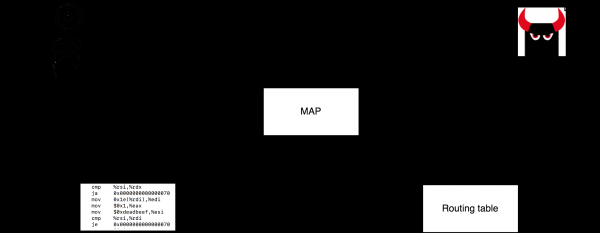
Kortom, BPF biedt de mogelijkheid om willekeurige, dat wil zeggen, door de verifier goedgekeurde gebruikerscode in de kernelruimte te laden. Deze code kan de toestand tussen aanroepen opslaan en gegevens uitwisselen met de gebruikersruimte, en heeft ook toegang tot de voor dit type programma's toegestane subsystemen van de kernel.
Dit lijkt al op de mogelijkheden die door de kernelmodules worden geboden, waar BPF bepaalde voordelen heeft (natuurlijk kun je alleen vergelijkbare toepassingen vergelijken, bijvoorbeeld systeemtrace — het is niet mogelijk om een willekeurige stuurprogramma op BPF te schrijven). Opvallend is de lagere instapdrempel (sommige hulpprogramma's die BPF gebruiken, vereisen geen programmeervaardigheden in de kernel, en in het algemeen ook geen programmeervaardigheden), runtime-veiligheid (steek je hand op in de reacties als je het systeem hebt gebroken tijdens het schrijven of testen van modules), atomiciteit — bij het herladen van modules is er stilstand, terwijl het BPF-subsysteem garandeert dat geen enkel evenement wordt gemist (ter rechtvaardiging, dit geldt niet voor alle typen BPF-programma's).
Het bestaan van dergelijke mogelijkheden maakt BPF een veelzijdig instrument voor het uitbreiden van de kernel, wat in de praktijk wordt bevestigd: er worden steeds nieuwe soorten programma's aan BPF toegevoegd, steeds meer grote bedrijven gebruiken BPF op productie-servers 24×7, steeds meer startups bouwen hun bedrijf op basisoplossingen die op BPF zijn gebaseerd. BPF wordt overal gebruikt: bij de bescherming tegen DDoS-aanvallen, bij het creëren van SDN (bijvoorbeeld netwerken voor Kubernetes), als het belangrijkste hulpmiddel voor systeemtracering en statistiekenverzameling, in inbraakdetectiesystemen en in sandbox-systemen, en meer.
Laten we dit overzichtgedeelte van het artikel afsluiten en dieper ingaan op de virtuele machine en het BPF-ecosysteem.
Afwijking: hulpprogramma's
Om de voorbeelden in de volgende delen te kunnen uitvoeren, heeft u mogelijk een aantal hulpprogramma's nodig, minimaal llvm/clang met ondersteuning voor bpf en bpftool. In de sectie u kunt instructies vinden voor het bouwen van hulpprogramma's en uw eigen kernel. Dit gedeelte is hieronder geplaatst om de samenhang van onze presentatie niet te verstoren.
Registers en het instructiesysteem van de BPF-virtuele machine
De architectuur en het commando-systeem van BPF zijn ontwikkeld met het oog op het feit dat programma's in de C-taal zullen worden geschreven en na het laden in de kernel naar native code zullen worden vertaald. Daarom zijn het aantal registers en de verschillende commando's gekozen met inachtneming van de overlap, in wiskundig opzicht, van de mogelijkheden van moderne machines. Bovendien zijn er verschillende beperkingen opgelegd aan programma's; zo was het bijvoorbeeld tot voor kort niet mogelijk om lussen en subprogramma's te schrijven, en het aantal instructies was beperkt tot 4096 (tegenwoordig kunnen geprivilegieerde programma's tot een miljoen instructies laden).
Er zijn elf beschikbare 64-bits registers voor de gebruiker in BPF. r0—r10 en de instructieteller (program counter). Het register r10 bevat een pointer naar de stack (frame pointer) en is alleen-lezen. Programma's hebben tijdens uitvoering toegang tot een stack van 512 bytes en een onbeperkte hoeveelheid gedeeld geheugen in de vorm van maps.
Programma's in BPF mogen een bepaalde set hulpfuncties (kernel helpers) aanroepen, afhankelijk van het type programma, en sinds kort ook gewone functies. Elke aangeroepen functie kan tot vijf argumenten aannemen, die in de registers r1—r5worden doorgegeven, terwijl de retourwaarde wordt doorgegeven in r0. Het is gegarandeerd dat na terugkeer uit de functie de inhoud van de registers r6—r9 ongewijzigd blijft.
Voor een efficiënte vertaling van programma's worden de registers r0—r11 voor alle ondersteunde architecturen eenduidig toegewezen aan echte registers, rekening houdend met de specifieke kenmerken van de ABI van de huidige architectuur. Bijvoorbeeld, voor x86_64 worden de registers r1—r5die worden gebruikt voor het doorgeven van functieparameters, toegewezen aan rdi, rsi, rdx, rcx, r8, die worden gebruikt voor het doorgeven van parameters aan functies in x86_64. Bijvoorbeeld, de code aan de linkerzijde wordt als volgt naar de code aan de rechterzijde vertaald:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
Het register r0 wordt ook gebruikt voor het retourneren van het resultaat van de uitvoering van het programma, en in het register r1 wordt de pointer naar de context doorgegeven aan het programma — afhankelijk van het type programma kan dit bijvoorbeeld de structuur zijn (voor XDP) of de structuur (voor verschillende netwerkprogramma's) of de structuur (voor verschillende soorten tracing-programma's), enz.
Dus, we hadden een set registers, kernel helpers, een stack, een context pointer en gedeeld geheugen in de vorm van maps. Niet dat dit allemaal absoluut noodzakelijk was voor de reis, maar…
Laten we de beschrijving voortzetten en het commando systeem voor deze objecten uitleggen. Alle () BPF-instructies hebben een vaste 64-bits grootte. Als je naar een instructie op een 64-bits Big Endian machine kijkt, dan zie je

Hier Code — dit is de coderingsinstructie, Dst/Src — dit zijn de coderingen van respectievelijk bestemming en bron, Off — een 16-bits tekenoffset, en Imm — dit is een 32-bits teken geheel getal dat in sommige commando's wordt gebruikt (vergelijkbaar met constante K uit cBPF). De codering Code heeft een van de twee soorten:
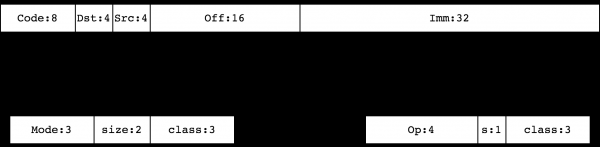
De klassen van instructies 0, 1, 2, 3 definieren commando's voor geheugenbewerking. Zij , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, respectievelijk. Klassen 4, 7 (BPF_ALU, BPF_ALU64) vormen een set ALU-instructies. Klassen 5, 6 (BPF_JMP, BPF_JMP32) omvatten spronkinstructies.
Het verdere plan voor het bestuderen van het BPF commando systeem is als volgt: in plaats van alle instructies en hun parameters gedetailleerd op te sommen, zullen we een paar voorbeelden in deze sectie bespreken en daaruit zal duidelijk worden hoe instructies werkelijk zijn opgebouwd en hoe je handmatig een binaire file voor BPF kunt disassembleren. Om de materie te verstevigen, zullen we verderop in het artikel nog individueel tegenkomen met instructies in de secties over Verifier, JIT-compiler, vertaling van klassieke BPF, evenals bij het bestuderen van maps, functie-aanroepen, enz.
Wanneer we het over individuele instructies hebben, verwijzen we naar de kernelbestanden en , waarin de numerieke codes van BPF-instructies zijn gedefinieerd. Bij zelfstandig bestuderen van de architectuur en/of het analyseren van binaire bestanden, kun je de semantiek vinden in de volgende, gerangschikt op complexiteit, bronnen: , , en natuurlijk in de broncodes van Linux — verifier, JIT, BPF-interpreter.
Voorbeeld: disassembleren BPF in je hoofd
Laten we een voorbeeld bekijken waarin we het programma readelf-example.c compileren en de resulterende binaire bestand bekijken. We zullen de originele inhoud blootleggen readelf-example.c hieronder, nadat we de logica ervan uit de binaire codes hebben hersteld:
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex-dump van sectie '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
De eerste kolom in de uitvoer readelf — is de inspringing en ons programma bestaat dus uit vier instructies:
Code Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
De opcode waarden zijn gelijk b7, 15, b7 en 95. Laten we ons herinneren dat de drie laagste bits de instructieklasse zijn. In ons geval is de vierde bit voor alle instructies leeg, dus zijn de instructieklassen gelijk, namelijk 7, 5, 7, 5. Klasse 7 is BPF_ALU64, en 5 is BPF_JMP. Voor beide klassen is het instructieformaat hetzelfde (zie hierboven) en we kunnen ons programma zo herschrijven (ook herschrijven we de andere kolommen in een begrijpelijke vorm):
Op S  Klasse   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operatie b klasse ALU64 is . Het wijst een waarde toe aan het bestemmingsregister. Als de bit str1 != str2 (source) is ingesteld, wordt de waarde uit het bronsregister gehaald, en als, zoals in ons geval, deze niet is ingesteld, wordt de waarde uit het veld Imm. Dus in de eerste en derde instructies voeren we de operatie uit r0 = Imm. Verder is de operatie 1 van klasse JMP — dat is (spring indien gelijk). In ons geval, omdat de bit S gelijk is aan nul, vergelijkt het de waarde van het bronsregister met het veld Imm. Als de waarden overeenkomen, vindt de sprong plaats naar PC + Off, waar PC, zoals gebruikelijk, bevat het adres van de volgende instructie. Tot slot, de operatie 9 van klasse JMP — dat is . Deze instructie beëindigt het programma en retourneert naar de kernel r0. Laten we een nieuwe kolom aan onze tabel toevoegen:
Op    S  Klasse   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      if (r1 == 0) goto pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      exit
We kunnen dit herschrijven in een handigere vorm:
     r0 = 1
     if (r1 == 0) goto END
     r0 = 2
END:
     exit
Als we ons herinneren dat in het register r1 een pointer naar de context vanuit de kernel wordt doorgegeven, en in het register r0 het waarde terug naar de kernel wordt gestuurd, dan kunnen we zien dat als de pointer naar de context gelijk is aan nul, we 1 retourneren, en in het andere geval 2. Laten we verifiëren of we gelijk hebben door naar de broncode te kijken:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Ja, dit is een zinloze programma, maar het compileert in totaal naar slechts vier eenvoudige instructies.
Voorbeeld-uitzondering: 16-byte instructie
Eerder vermeldden we dat sommige instructies meer dan 64 bits vereisen. Dit geldt bijvoorbeeld voor de instructie lddw (: 0x18 = | | ) — laad een dubbel woord in het register vanuit de velden Imm. Het probleem is dat Imm een grootte heeft van 32 bits, terwijl een dubbel woord 64 bits is, daarom kan een 64-bits directe waarde niet in één 64-bits instructie in het register worden geladen. Hiervoor worden twee aangrenzende instructies gebruikt om het tweede deel van de 64-bits waarde op te slaan in het veld Imm. Voorbeeld:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump van sectie '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
In het binaire programma zijn er slechts twee instructies:
Binary                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
We zullen ook de instructie tegenkomen lddw, wanneer we het hebben over relocaties en het werken met maps.
Voorbeeld: laten we BPF standaard decoderen
Dus hebben we geleerd om BPF-binaire codes te lezen en zijn we klaar om elke instructie te ontleden, indien nodig. Het is echter vermeldenswaard dat het in de praktijk handiger en sneller is om programma's te ontleden met behulp van standaard hulpmiddelen, zoals:
$ llvm-objdump -d x64.o

Disassemblage van sectie .text:

0000000000000000 :
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
De levenscyclus van BPF-objecten, het bestandssysteem bpffs
(Enkele details die in deze paragraaf worden beschreven, leerde ik voor het eerst van Alexei Starovoitov op .)
BPF-objecten — programma's en maps — worden vanuit de gebruikersruimte gemaakt met behulp van de commando's BPF_PROG_LOAD en BPF_MAP_CREATE systeemoproep bpf(2), we zullen bespreken hoe dit precies gebeurt in de volgende sectie. Tegelijkertijd worden er datastructuren in de kernel aangemaakt en voor elk van hen refcount (referentieteller) wordt ingesteld op één, en de gebruiker ontvangt een bestandsdescriptor die naar het object verwijst. Na het sluiten van de descriptor refcount wordt het object met één verminderd, en wanneer deze nul bereikt, wordt het object vernietigd.
Als het programma maps gebruikt, dan refcount wordt deze map met één verhoogd na het laden van het programma, d.w.z. hun bestandsdescriptoren kunnen vanuit het gebruikersproces worden gesloten en zullen daarbij refcount niet nul worden:
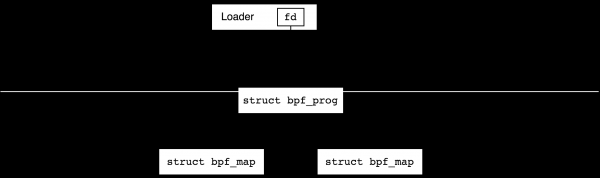
Na succesvolle upload van het programma koppelen we het meestal aan een soort gebeurtenisgenerator. Bijvoorbeeld, we kunnen het op een netwerkinterface plaatsen voor het verwerken van binnenkomende pakketten of het aansluiten op een bepaalde tracepoint in de kernel. Op dat moment zal de referentieteller ook met één toenemen, en kunnen we de bestandshandler in het opstartprogramma sluiten.
Wat gebeurt er als we nu de opstarter beëindigen? Dit hangt af van het type gebeurtenisgenerator (hook). Alle netwerkhooks blijven bestaan na de beëindiging van de opstarter; dit worden de zogenaamde globale hooks. Programma's voor tracing worden daarentegen vrijgegeven na de beëindiging van het proces dat ze heeft aangemaakt (en worden daarom lokale hooks genoemd, van 'local to the process'). Technisch gezien hebben lokale hooks altijd de overeenkomstige bestandshandler in de gebruikersruimte en worden daarom gesloten met de sluiting van het proces, terwijl globale dat niet doen. In de volgende afbeelding probeer ik met rode kruizen aan te geven hoe de beëindiging van het opstartprogramma de levensduur van objecten beïnvloedt in het geval van lokale en globale hooks.
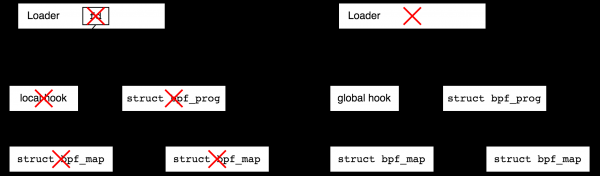
Waarom is er een scheiding tussen lokale en globale hooks? Het runnen van sommige typen netwerkprogramma's heeft ook zonder gebruikersruimte zin; stel je bijvoorbeeld DDoS-bescherming voor - de opstarter schrijft regels en koppelt een BPF-programma aan de netwerkinterface, waarna de opstarter gewoon kan stoppen. Aan de andere kant, stel je een debug traceprogramma voor dat je in tien minuten in elkaar hebt gezet - na het beëindigen zou je willen dat er geen rommel in het systeem achterblijft, en lokale hooks garanderen dat.
Aan de andere kant, stel je voor dat je wilt aansluiten bij een tracepoint in de kernel en jarenlang statistieken wilt verzamelen. In dat geval zou je de gebruikerscomponent willen beëindigen en af en toe terugkomen naar de statistieken. Deze mogelijkheid biedt het BPF-bestandssysteem. Dit is een pseudo-bestandssysteem dat alleen in het geheugen bestaat, waarmee je bestanden kunt maken die verwijzen naar BPF-objecten en zo de refcount objecten vergroten. Daarna kan de opstarter beëindigen, terwijl de door hem gecreëerde objecten levend blijven.
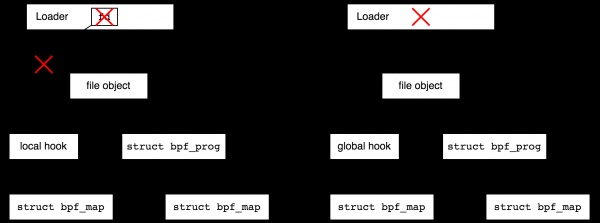
Het maken van bestanden in bpffs die naar BPF-objecten verwijzen, wordt "pinnen" genoemd ("pin", zoals in de volgende zin: "process can pin a BPF program or map"). Het creëren van bestandobjecten voor BPF-objecten is niet alleen zinvol om de levensduur van lokale objecten te verlengen, maar ook voor het gemak van het gebruik van globale objecten. Terugkomend op het voorbeeld van een globaal programma ter bescherming tegen DDoS-aanvallen, willen we in staat zijn om af en toe de statistieken te bekijken.
Het BPF-bestandssysteem wordt meestal gemonteerd op /sys/fs/bpf, maar het kan ook lokaal worden gemonteerd, bijvoorbeeld zo:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Bestandsnamen in het bestandssysteem worden gemaakt met het commando BPF_OBJ_PIN van de BPF-systeemaanroep. Ter illustratie zullen we een programma nemen, dit compileren, laden en het pinnen in bpffs. Ons programma doet niets nuttigs, we geven alleen de code om je in staat te stellen het voorbeeld te reproduceren:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Laten we dit programma compileren en een lokale kopie van het bestandssysteem aanmaken bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Laten we nu ons programma laden met behulp van de tool bpftool en kijken naar de bijbehorende systeemaanroepen bpf(2) (uit de uitvoer van strace zijn enkele irrelevante regels verwijderd):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Hier hebben we het programma geladen met behulp van BPF_PROG_LOAD, hebben we van de kernel een bestanddescriptor ontvangen 3 en hebben we met het commando BPF_OBJ_PIN deze bestanddescriptor als bestand vastgelegd "bpf-mountpoint\/test". Na dat is de laadtakenprogramma bpftool gestopt, maar ons programma is in de kernel gebleven, zelfs al hebben we het aan geen enkel netwerkinterface gekoppeld:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
We kunnen het bestandobject op de gebruikelijke manier verwijderen unlink(2) en daarna zal het overeenkomstige programma worden verwijderd:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Verwijderen van objecten
Bij het verwijderen van objecten moet worden opgemerkt dat nadat we het programma van de hook (evenementgenerator) hebben losgekoppeld, geen nieuwe gebeurtenis de uitvoer ervan zal activeren, maar alle huidige exemplaren van het programma zullen normaal eindigen.
Sommige soorten BPF-programma's stellen je in staat om het programma ter plekke te vervangen, d.w.z. ze bieden atomiciteit in de reeks. replace = oude programma loskoppelen, nieuw programma aansluiten. Alle actieve exemplaren van de oude versie van het programma zullen hun taak beëindigen, en nieuwe gebeurtenishandlers worden al gemaakt vanuit het nieuwe programma; hier betekent 'atomiciteit' dat geen enkele gebeurtenis wordt gemist.
Programma's verbinden aan gebeurtenisbronnen
In dit artikel zullen we de verbinding van programma's aan gebeurtenisbronnen niet apart beschrijven, aangezien dit logisch is om te bestuderen in de context van het specifieke type programma. Zie hieronder, waarin we laten zien hoe programma's van het type XDP worden aangesloten.
Beheer van objecten via de systeemaanroep bpf
BPF-programma's
Alle BPF-objecten worden vanuit de gebruikersruimte gemaakt en beheerd via de systeemaanroep bpf, met de volgende prototype:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Hier is het commando cmd een van de waarden van het type , attr is een pointer naar parameters voor het specifieke programma en size is de grootte van het object waar naar wordt verwezen, d.w.z. meestal sizeof(*attr). In kernel 5.8 ondersteunt de systeemaanroep bpf 34 verschillende commando's, en union bpf_attr vergt 200 regels. Maar we hoeven ons daar niet door te laten afschrikken, aangezien we de commando's en parameters in de loop van verschillende artikelen zullen leren kennen.
We beginnen met het commando BPF_PROG_LOAD, dat BPF-programma's aanmaakt — het neemt een set instructies voor BPF en laadt deze in de kernel. Op het moment van de upload wordt de verifier gestart, gevolgd door de JIT-compiler en, na succesvolle uitvoering, krijgt de gebruiker een bestandsdescriptor van het programma terug. We hebben gezien wat er daarna gebeurt in het vorige deel .
Nu gaan we een gebruikersprogramma schrijven dat een eenvoudig BPF-programma zal laden, maar eerst moeten we beslissen welk soort programma we willen laden — we moeten een kiezen en binnen dat type een programma schrijven dat door de verifier zal komen. Om het proces niet te compliceren, hier is een kant-en-klaar idee: we nemen een programma van het type BPF_PROG_TYPE_XDP, die een waarde zal teruggeven XDP_PASS (alle pakketten overslaan). In BPF-assemblage ziet dit er heel eenvoudig uit:
r0 = 2
exit
Nadat we hebben vastgesteld wat we gaan laden, kunnen we vertellen hoe we dit gaan doen: Interessante gebeurtenissen in het programma beginnen met het definiëren van de array
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
insns — ons BPF-programma in machinecode. Hierbij wordt elke instructie van het BPF-programma verpakt in de structuur bpf_insn komt overeen met de instructie — ons BPF-programma in machinecode. Hierbij wordt elke instructie van het BPF-programma verpakt in de structuur r0 = 2 Terugkomend op., de andere — exit.
In de kernel zijn er meer handige macro's gedefinieerd voor het schrijven van machinecodes, en door gebruik te maken van de kernel header file tools/include/linux/filter.h kunnen we schrijven struct bpf_insn insns[] = { BPF_MOV64_IMM(BPF_REG_0, XDP_PASS), BPF_EXIT_INSN() };
Maar aangezien het schrijven van BPF-programma's in machinecode alleen nodig is voor het schrijven van tests in de kernel en artikelen over BPF, maakt het ontbreken van deze macro's het leven van de ontwikkelaar eigenlijk niet moeilijker.Na het definiëren van het BPF-programma gaan we naar de loading in de kernel. Onze minimalistische set parameters
bevat het type programma, de set en het aantal instructies, een vereiste licentie, en ook de naam attr "woo" , die we gebruiken om ons programma na de loading in het systeem te vinden. Het programma wordt, zoals beloofd, in het systeem geladen via een systeemaanroepAan het einde van het programma komen we in een oneindige loop die de payload simuleert. Zonder dit zal het programma door de kernel vernietigd worden zodra de file descriptor die we van de systeemaanroep kregen, gesloten wordt, en we zullen het niet in het systeem zien. bpf.
Nou, we zijn klaar om te testen. We zullen het programma compileren en uitvoeren onder bpf, om te controleren of alles werkt zoals het hoort:
$ clang -g -O2 simple-prog.c -o simple-prog$ sudo strace ./simple-prog execve("./simple-prog", ["./simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0 ... bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3 pause( straceAlles is in orde,
teruggegeven aan ons descriptor 3 en we gingen de oneindige loop in metpause() bpf(2) . Laten we proberen ons programma in het systeem te vinden. Hiervoor gaan we naar een andere terminal en gebruiken we het hulpprogramma We zien dat er een geladen programma in het systeem iswoo bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
wiens globale ID gelijk is aan 390, en dat er op dit moment een open file descriptor is in het proces simple-prog die verwijst naar het programma (en als een open bestandsdescriptor is die naar het programma verwijst (en als er is een open bestandshandle die naar het programma wijst (en als een open bestandsdescriptor is die naar het programma verwijst (en als de werkstrijd beëindigt, simple-prog verdwijnt). Zoals verwacht, het programma simple-prog neemt 16 bytes in beslag — twee instructies — binaire codes in de BPF-architectuur, maar in native vorm (x86_64) is dat al 40 bytes. Laten we onze programma in de originele vorm bekijken:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
zonder verrassingen. Laten we eens kijken naar de code die door de JIT-compiler is gemaakt:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
niet echt efficiënt voor exit(2), maar om eerlijk te zijn, ons programma is gewoon te eenvoudig, en voor niet-triviale programma's zijn de proloog en epiloog, toegevoegd door de JIT-compiler, natuurlijk nodig.
Maps
BPF-programma's kunnen gestructureerde geheugengebieden gebruiken, toegankelijk voor zowel andere BPF-programma's als programma's uit de gebruikersruimte. Deze objecten worden maps genoemd en in dit gedeelte laten we zien hoe we ze kunnen beheren via systeemoproepen. bpf.
Om meteen te zeggen, de mogelijkheden van maps zijn niet beperkt tot alleen toegang tot gedeeld geheugen. Er zijn speciale mappen die bijvoorbeeld pointers naar BPF-programma's of pointers naar netwerkinterfaces bevatten, mappen voor het werken met perf events, enzovoorts. We zullen hier niet over praten om de lezer niet in verwarring te brengen. Daarnaast negeren we synchronisatieproblemen, aangezien dit niet belangrijk is voor onze voorbeelden. Een volledige lijst van beschikbare maptypen is te vinden in , en in dit gedeelte nemen we voor de gelegenheid de historisch eerste type, de hash-tabel. BPF_MAP_TYPE_HASH.
Als je een hash-tabel zou maken, laten we zeggen, in C++, zou je zeggen unordered_map woo, wat in het Nederlands betekent 'ik heb een tabel nodig simple-prog onbeperkte grootte, waarin de sleutels van het type int, en de waarden van het type long'. Om een BPF-hash-tabel te maken, moeten we ongeveer hetzelfde doen, met als kanttekening dat we de maximale grootte van de tabel moeten opgeven, en in plaats van de soorten sleutels en waarden moeten we hun groottes in bytes opgeven. Voor het maken van maps wordt het commando gebruikt BPF_MAP_CREATE systeemoproep bpf. Laten we kijken naar een min of meer minimale programma die een map maakt. Deze zou je eenvoudig moeten lijken na het vorige programma dat BPF-programma's laadt:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Hier definiëren we een set parameters attr, waarin we zeggen 'ik heb een hashtabel nodig met sleutels en waarden van formaat sizeof(int)', waarin ik maximaal vier elementen kan plaatsen.' Bij het creëren van BPF-maps kunnen ook andere parameters worden opgegeven, bijvoorbeeld, zoals in het voorbeeld met het programma, hebben we de naam van het object opgegeven als , die we gebruiken om ons programma na de loading in het systeem te vinden. Het programma wordt, zoals beloofd, in het systeem geladen via een systeemaanroep.
Laten we het programma compileren en uitvoeren:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace .\/simple-map
execve(".\/simple-map", [".\/simple-map"], 0x7ffd40a27070 \/* 14 vars *\/ ) = 0
...\nbpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Hier heeft de systeemaanroep bpf(2) ons de descriptor van de map met het nummer 3 teruggegeven en vervolgens wacht het programma, zoals verwacht, op verdere aanwijzingen in de systeemaanroep pause(2).
Laten we nu ons programma op de achtergrond uitvoeren of een andere terminal openen en ons object bekijken met behulp van de tool bpftool (we kunnen onze map onderscheiden van andere aan de hand van de naam):
$ sudo bpftool map
...
114: hash  naam woo  vlaggen 0x0
        sleutel 4B  waarde 4B  max_entries 4  memlock 4096B
...
Het nummer 114 is de globale ID van ons object. Elk programma in het systeem kan deze ID gebruiken om een al bestaande map te openen met de opdracht BPF_MAP_GET_FD_BY_ID systeemoproep bpf.
Nu kunnen we spelen met onze hashtabel. Laten we de inhoud ervan bekijken:
$ sudo bpftool map dump id 114
Geprobeerd 0 elementen
Leeg. Laten we er een waarde in zetten hash[1] = 1:
$ sudo bpftool map update id 114 sleutel 1 0 0 0 waarde 1 0 0 0Laten we de tabel nog een keer bekijken:
$ sudo bpftool map dump id 114
sleutel: 01 00 00 00  waarde: 01 00 00 00
Geprobeerd 1 element
Hoera! We hebben het voor elkaar gekregen om één element toe te voegen. Merk op dat we hiervoor op byte-niveau moesten werken, omdat bpftool niet weet welk type waarden in de hashtabel staan. (Je kunt deze informatie doorgeven met BTF, maar daar gaan we nu niet op in.)
Hoe leest en voegt bpftool elementen toe? Laten we onder de motorkap kijken:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
sleutel: 01 00 00 00  waarde: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Eerst hebben we de map geopend op basis van de globale ID met behulp van de opdracht BPF_MAP_GET_FD_BY_ID en bpf(2) die ons descriptor 3 heeft teruggegeven. Vervolgens hebben we met de opdracht BPF_MAP_GET_NEXT_KEY de eerste sleutel in de tabel gevonden door NULL een verwijzing naar de 'vorige' sleutel op te geven. Zodra we een sleutel hebben, kunnen we BPF_MAP_LOOKUP_ELEM, die de waarde in de gegeven pointer retourneert valueDe volgende stap is dat we proberen het volgende element te vinden door de aanwijzer naar de huidige sleutel door te geven, maar onze tabel bevat slechts één element en het commando BPF_MAP_GET_NEXT_KEY geeft hij ENOENT.
Laten we de waarde voor sleutel 1 veranderen; laten we zeggen dat onze zakelijke logica vereist dat we dit schrijven hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Zoals verwacht is het heel eenvoudig: het commando BPF_MAP_GET_FD_BY_ID opent onze map op ID, terwijl het commando BPF_MAP_UPDATE_ELEM deelt een element opnieuw toe.
Dus, na het maken van de hash-tabel vanuit één programma kunnen we de inhoud ervan lezen en schrijven vanuit een ander. Merk op dat als we dit vanaf de opdrachtregel konden doen, elke andere programma in het systeem dat ook kan. Naast de hierboven beschreven opdrachten zijn de volgende beschikbaar voor het werken met mappen vanuit de gebruikersruimte :
BPF_MAP_LOOKUP_ELEM: waarde vinden op sleutelBPF_MAP_UPDATE_ELEM: waarde bijwerken/creërenBPF_MAP_DELETE_ELEM: sleutel verwijderenBPF_MAP_GET_NEXT_KEY: volgende (of eerste) sleutel vindenBPF_MAP_GET_NEXT_ID: stelt ons in staat om door alle bestaande mappen te lopen; zo werktbpftool mapBPF_MAP_GET_FD_BY_ID: open een bestaande map op zijn globale IDBPF_MAP_LOOKUP_AND_DELETE_ELEM: atomair een objectwaarde bijwerken en de oude waarde teruggevenBPF_MAP_FREEZE: maak de map onveranderlijk vanuit de gebruikersruimte (deze bewerking kan niet ongedaan worden gemaakt)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: massabewerkingen. Bijvoorbeeld,BPF_MAP_LOOKUP_AND_DELETE_BATCH— dit is de enige betrouwbare manier om alle waarden uit de map te lezen en ze te wissen
Niet al deze commando's werken voor alle soorten mappen, maar over het algemeen lijkt het werken met andere typen kaarten vanuit de gebruikersruimte precies hetzelfde als het werken met hash-tabellen.
Voor de volledigheid laten we onze experimenten met de hash-tabel eindigen. Vergeet niet dat we een tabel hebben gemaakt die maximaal vier sleutels kan bevatten? Laten we nog een paar elementen toevoegen:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Tot nu toe, zo goed:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
4 elementen gevonden
Laten we proberen nog een toe te voegen:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Fout: update mislukt: Argumentenlijst te lang
Zoals verwacht, hebben we geen succes gehad. Laten we de fout in detail bekijken:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Argument list too long)
Error: update failed: Argument list too long
+++ exited with 255 +++
Alles is in orde: zoals verwacht, de opdracht BPF_MAP_UPDATE_ELEM probeert een nieuwe, vijfde sleutel aan te maken, maar faalt met E2BIG.
Dus, we kunnen BPF-programma's maken en laden, evenals kaarten beheren vanuit de gebruikersruimte. Het is nu logisch om te kijken naar hoe we kaarten kunnen gebruiken vanuit de BPF-programma's zelf. We zouden dit kunnen uitleggen in de moeilijk leesbare programma's in machinecode-macro's, maar het is eigenlijk tijd om te laten zien hoe BPF-programma's echt geschreven en onderhouden worden — met libbpf.
(Voor lezers die ontevreden zijn over het gebrek aan een laag-niveau voorbeeld: we zullen programma's die kaarten en hulpfuncties gebruiken, gemaakt met libbpf , in detail analyseren en uitleggen wat er op het instructieniveau gebeurt. Voor lezers die ontevreden zijn zeer sterk, hebben we toegevoegd op de juiste plaats in het artikel.)
BPF-programma's schrijven met behulp van libbpf
Programma's schrijven met BPF in machinecode kan in het begin interessant zijn, maar na een tijdje komt de verzadiging. Op dat moment moet je je richten op llvm, dat een backend bevat voor het genereren van code voor de BPF-architectuur, evenals op de bibliotheek libbpf, die het mogelijk maakt om de gebruikerscomponent van BPF-applicaties te schrijven en de BPF-programmacode te laden, gegenereerd met llvm/clang.
In werkelijkheid, zoals we in dit en de volgende artikelen zullen zien, libbpf doet behoorlijk veel werk en zonder het (of soortgelijke hulpmiddelen — iproute2, libbcc, libbpf-go, enz.) is het niet mogelijk om te leven. Een van de killer-features van het project libbpf is BPF CO-RE (Compile Once, Run Everywhere) — een project dat het mogelijk maakt om BPF-programma's te schrijven die overdraagbaar zijn van de ene kernel naar de andere, met de mogelijkheid om op verschillende API's te draaien (bijvoorbeeld wanneer de kernelstructuur van versie naar versie verandert). Om met CO-RE te kunnen werken, moet jouw kernel zijn gecompileerd met ondersteuning voor BTF (hoe je dit doet, bespreken we in de sectie . Je kunt eenvoudig controleren of jouw kernel met BTF is gecompileerd of niet — aan de hand van het volgende bestand:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Dit bestand bevat informatie over alle datatypen die in de kernel worden gebruikt en wordt in al onze voorbeelden gebruikt die libbpfVoor CO-RE gaan we in het volgende artikel in detail in, maar in dit artikel — bouw gewoon je eigen kernel met CONFIG_DEBUG_INFO_BTF.
Bibliotheek libbpf dat zich bevindt in de directory tools/lib/bpf van de kernel, en de ontwikkeling ervan gebeurt via de mailinglijst bpf@vger.kernel.org. Voor toepassingen die buiten de kernel draaien, is er echter een aparte repository waar de kernbibliotheek voor leesdoeleinden wordt gespiegeld zoals deze is.
In dit gedeelte gaan we bekijken hoe we een project kunnen maken dat gebruikmaakt van libbpf, we zullen enkele (meer of minder zinloze) testprogramma's schrijven en uitgebreid uitleggen hoe dit alles werkt. Dit zal ons in de volgende secties helpen om gemakkelijker uit te leggen hoe BPF-programma's samenwerken met maps, kernel helpers, BTF, enz.
Normaal gesproken voegen projecten die gebruikmaken van libbpf de GitHub-repository toe als git submodule, laten we dat ook doen:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Lege Git-repository geïnitialiseerd in /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Klonen naar '/tmp/libbpf-example/libbpf'...
remote: Objecten tellen: 200, klaar.
remote: Objecten tellen: 100% (200/200), klaar.
remote: Objecten comprimeren: 100% (103/103), klaar.
remote: Totaal 3354 (delta 101), hergebruikt 118 (delta 79), pack-hergebruikt 3154
Objecten ontvangen: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, klaar.
Delta's oplossen: 100% (2176/2176), klaar.
Wordt zeer eenvoudig verzameld: libbpf $ cd libbpf/src $ mkdir build $ OBJDIR=build DESTDIR=root make -s install $ find root root root/usr root/usr/include root/usr/include/bpf root/usr/include/bpf/bpf_tracing.h root/usr/include/bpf/xsk.h root/usr/include/bpf/libbpf_common.h root/usr/include/bpf/bpf_endian.h root/usr/include/bpf/bpf_helpers.h root/usr/include/bpf/btf.h root/usr/include/bpf/bpf_helper_defs.h root/usr/include/bpf/bpf.h root/usr/include/bpf/libbpf_util.h root/usr/include/bpf/libbpf.h root/usr/include/bpf/bpf_core_read.h root/usr/lib64 root/usr/lib64/libbpf.so.0.1.0 root/usr/lib64/libbpf.so.0 root/usr/lib64/libbpf.a root/usr/lib64/libbpf.so root/usr/lib64/pkgconfig root/usr/lib64/pkgconfig/libbpf.pc
Ons verdere plan in dit gedeelte is als volgt: we zullen een BPF-programma schrijven van het type, hetzelfde als in het vorige voorbeeld, maar in C, het compileren met BPF_PROG_TYPE_XDP, en een helper-programma schrijven dat het naar de kernel zal laden. In de volgende secties zullen we de mogelijkheden van zowel het BPF-programma als het helper-programma uitbreiden. clangVoorbeeld: een volledig applicatie maken met libbpf
Vooral zullen we het bestand gebruiken
, dat hierboven genoemd werd, en we zullen een equivalente headerbestand maken: /sys/kernel/btf/vmlinux$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.h
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hIn dit bestand worden alle datastucturen opgeslagen die in onze kernel aanwezig zijn, bijvoorbeeld zo wordt de IPv4-kop in de kernel gedefinieerd:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Laten we nu ons BPF-programma in C schrijven:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Hoewel ons programma heel simpel is, moeten we nog steeds op veel details letten. Ten eerste is het eerste headerbestand dat we opnemen vmlinux.h, dat we zojuist hebben gegenereerd met behulp van bpftool btf dump — nu hoeven we geen kernel-headers-pakket te installeren om te weten hoe de structuren in de kernel eruitzien. Het volgende headerbestand komt van de bibliotheek libbpf. Op dit moment hebben we het alleen nodig om de macro SECte definiëren, die het symbool naar de juiste sectie van het objectbestand ELF stuurt. Ons programma bevindt zich in de sectie xdp/simple, waar we vóór de slash het type BPF-programma definiëren — dit is een overeenkomst die wordt gebruikt in libbpf, op basis van de naam van de sectie zal het het juiste type tijdens de uitvoering invoegen bpf(2). Het BPF-programma zelf in C is heel eenvoudig en bestaat uit één regel return XDP_PASS. Ten slotte bevat de aparte sectie "license" de naam van de licentie.
We kunnen ons programma compileren met llvm/clang, versie >= 10.0.0, of beter — meer (zie sectie ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Van de interessante kenmerken: we geven de doelsarchitectuur op -target bpf en het pad naar de headers libbpf, die we onlangs hebben geïnstalleerd. Vergeet ook niet de -O2, zonder deze optie kunnen je later verrassingen te wachten staan. Laten we naar onze code kijken en zien of we het programma hebben geschreven dat we wilden?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       bestandstype elf64-bpf

Disassemblage van sectie xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
Ja, het is gelukt! Nu hebben we een binaire bestand met het programma, en we willen een applicatie maken die dit in de kernel laadt. Hiervoor is de bibliotheek libbpf biedt ons twee opties - gebruik een laagdrempelig API of een hoogdrempelig API. We kiezen voor de tweede optie, omdat we willen leren om BPF-programma's te schrijven, te laden en te verbinden met minimale inspanning voor latere bestudering.
Om te beginnen moeten we met behulp van dezelfde tool de 'skeleton' van ons programma genereren uit de binaire code. bpftool de Zwitserse zakmes van de wereld van BPF (en dit kan zowel figuurlijk als letterlijk worden opgevat, aangezien Daniel Borkman - een van de makers en onderhouders van BPF - Zwitser is):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hIn het bestand xdp-simple.skel.h bevat de binaire code van ons programma en functies voor beheer - laden, verbinden en verwijderen van ons object. In ons eenvoudige geval lijkt dit misschien overkill, maar het werkt ook wanneer het objectbestand meerdere BPF-programma's en maps bevat, en voor het laden van dit enorme ELF hoeven we alleen maar de skeleton te genereren en een of twee functies aan te roepen vanuit de gebruikersapplicatie, waaraan we nu verder gaan werken.
Eigenlijk is ons opstartprogramma triviaal:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Hier struct xdp_simple_bpf wordt gedefinieerd in het bestand xdp-simple.skel.h en beschrijft ons objectbestand:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Hier kunnen we sporen van de laagdrempelige API opmerken: de structuur struct bpf_program *simple en struct bpf_link *simple. De eerste structuur beschrijft specifiek ons programma, dat is vastgelegd in de sectie xdp/simple, terwijl de tweede beschrijft hoe het programma is verbonden met de gebeurtenisbron.
Functie xdp_simple_bpf__open_and_load, opent het ELF-object, parseert het, creëert alle structuren en substructuren (bovenop de programma's bevinden zich ook andere secties in de ELF - data, readonly data, debug-informatie, licenties, enz.), en laadt het daarna in de kernel via een systeemaanroep bpf, wat we kunnen controleren door het programma te compileren en uit te voeren:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Laten we nu eens naar ons programma kijken met behulp van bpftool. Laten we de ID ervan vinden:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
en dumpen (we gebruiken de verkorte versie van het commando bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Iets nieuws! Het programma printte delen van ons oorspronkelijke bestand in de taal C. Dit werd gedaan door de bibliotheek libbpf, die het debugsectie in de binaire bestanden vond, deze compileerde naar een BTF-object, en deze in de kernel laadde met behulp van BPF_BTF_LOAD, en daarna de verkregen bestandsdescriptor aangaf bij het laden van het programma met de opdracht BPG_PROG_LOAD.
Kernel Helpers
BPF-programma's kunnen 'externe' functies uitvoeren — kernel helpers. Deze helperfuncties stellen BPF-programma's in staat om toegang te krijgen tot kernelstructuren, maps te beheren, en te communiceren met de 'echte wereld' — zoals perf events te creëren, hardware te beheren (bijvoorbeeld pakketten omleiden), enzovoort.
Voorbeeld: bpf_get_smp_processor_id
In het kader van de 'leren door voorbeelden'-paradigma, laten we een van de helperfuncties bekijken, bpf_get_smp_processor_id(), in het bestand kernel/bpf/helpers.c. Het retourneert het nummer van de processor waarop het aanroepende BPF-programma wordt uitgevoerd. Maar we zijn niet zozeer geïnteresseerd in de semantiek ervan, als wel dat de implementatie ervan één regel in beslag neemt:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Definities van BPF-helperfuncties lijken op de definities van systeemaanroepen in Linux. Hier, bijvoorbeeld, wordt een functie gedefinieerd zonder argumenten. (Een functie die bijvoorbeeld drie argumenten accepteert, wordt gedefinieerd met behulp van de macro BPF_CALL_3. Het maximum aantal argumenten is vijf.) Maar dit is slechts het eerste deel van de definitie. Het tweede deel betreft de definitie van een structuur van het type struct bpf_func_proto, die een beschrijving van de helperfunctie bevat die begrijpelijk is voor de verifier:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Registratie van helperfuncties
Om BPF-programma's van een bepaald type deze functie te laten gebruiken, moeten ze deze registreren, bijvoorbeeld voor het type BPF_PROG_TYPE_XDP in de kernel wordt de functie xdp_func_proto, die op basis van de ID van de helperfunctie bepaalt of XDP deze functie ondersteunt of niet. Onze functie :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Nieuwe typen BPF-programma's worden 'gedefinieerd' in het bestand met behulp van de macro BPF_PROG_TYPEEr worden aanhalingstekens gebruikt omdat dit een logische definitie is, en in de C-taal wordt de definitie van een geheel aantal specifieke structuren op andere plaatsen gedaan. In het bijzonder in het bestand kernel/bpf/verifier.c alle definities uit het bestand bpf_types.h worden gebruikt om een array van structuren te creëren bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = &_name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Dat wil zeggen, voor elk type BPF-programma wordt een pointer naar de gegevensstructuur van het type struct bpf_verifier_ops, die wordt geïnitialiseerd met de waarde _name ## _verifier_ops, d.w.z., xdp_verifier_ops voor xdp. De structuur xdp_verifier_ops in het bestand net/core/filter.c het als volgt:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Hier zien we onze bekende functie xdp_func_proto, die elke keer zal worden aangeroepen door de verifier wanneer deze een aanroep tegenkomt van een functie binnen het BPF-programma, zie .
Laten we kijken naar hoe een hypothetisch BPF-programma de functie gebruikt bpf_get_smp_processor_id. Hiervoor herschrijven we het programma uit ons vorige deel als volgt:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Symbool bpf_get_smp_processor_id in <bpf/bpf_helper_defs.h> bibliotheek libbpf hoe
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;d.w.z., bpf_get_smp_processor_id — dit is een pointer naar de functie, waarvan de waarde 8 is, waarbij 8 het getal is BPF_FUNC_get_smp_processor_id van het type enum bpf_fun_id, dat voor ons wordt gedefinieerd in het bestand vmlinux.h (bestand bpf_helper_defs.h in de kernel wordt gegenereerd door een script, daarom zijn 'magische' getallen oké). Deze functie neemt geen argumenten en retourneert een waarde van het type __u32. Wanneer we deze in ons programma uitvoeren, clang genereert het de instructie BPF_CALL van de 'juiste vorm'. Laten we het programma compileren en kijken naar de sectie xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassemblage van sectie xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 :
       7:       95 00 00 00 00 00 00 00 exit
In de eerste regel zien we de instructie call, parameter IMM welke gelijk is aan 8, en SRC_REG — nul. Volgens de ABI-overeenkomst die door de verifier wordt gebruikt, is dit de aanroep van de hulpfunctie met nummer acht. Na de uitvoering is de logica eenvoudig. De geretourneerde waarde wordt uit het register r0 gekopieerd naar r1 en op de regels 2 en 3 omgezet naar type u32 — de bovenste 32 bits worden op nul gezet. Op de regels 4, 5, 6 en 7 retourneren we 2 (XDP_PASS) of 1 (XDP_DROP) afhankelijk van of de hulpfunctie op regel 0 een nul of een niet-nul waarde heeft geretourneerd.
Laten we onszelf testen: we laden het programma en kijken naar de uitvoer bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Goed, de verifier heeft de juiste kernel-helper gevonden.
Voorbeeld: we geven de argumenten door en starten uiteindelijk het programma!
Alle hulpfuncties op uitvoeringsniveau hebben het prototype
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)De parameters worden aan hulpfuncties doorgegeven in registers r1—r5, en de waarde wordt geretourneerd in het register r0. Er zijn geen functies die meer dan vijf argumenten accepteren, en het is niet de bedoeling om daar ondersteuning voor toe te voegen in de toekomst.
Laten we kijken naar de nieuwe kernel helper en hoe BPF parameters doorgeeft. We herschrijven xdp-simple.bpf.c als volgt (de overige regels zijn ongewijzigd):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Ons programma print het nummer van de CPU waarop het draait. We compileren het en bekijken de code:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
Op regels 0-7 schrijven we naar de stack de regel running on CPU%un, en vervolgens starten we op regel 8 de bekende bpf_get_smp_processor_id. Op regels 9-12 bereiden we de argumenten voor de helper voor bpf_printk — registers r1, r2, r3. Waarom zijn het er drie en niet twee? Omdat bpf_printk — om de echte helper bpf_trace_printk, die de grootte van de opmaakstring vereist, door te geven.
Laten we nu een paar regels toevoegen aan xdp-simple.c, zodat ons programma verbinding maakt met de interface lo en daadwerkelijk werd gestart!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "kon BPF-object niet openen en/of laden");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Hier gebruiken we de functie bpf_set_link_xdp_fd, die BPF-programma's van het type XDP aan netwerkinterfaces koppelt. We hebben het nummer van de interface hardcoded, lo, dat altijd gelijk is aan 1. We roepen de functie twee keer aan om eerst het oude programma los te koppelen, als het was gekoppeld. Let op dat we nu geen aanroep van pause of een oneindige lus nodig hebben: ons laadprogramma zal beëindigen, maar het BPF-programma zal niet worden vernietigd, omdat het is gekoppeld aan een gebeurtenisbron. Na succesvolle belasting en koppeling, zal het programma worden uitgevoerd voor elk netwerkpakket dat binnenkomt op lo.
Laten we het programma laden en de interface bekijken lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  naam simple  tag 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue staat ONBEKEND modus STANDAARD groep standaard qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Het programma dat we hebben geladen heeft ID 669 en dezelfde ID zien we op de interface lo. Laten we een paar pakketten naar 127.0.0.1 (verzoek + antwoord):
$ ping -c1 localhosten laten we nu de inhoud van het debug virtuele bestand bekijken /sys/kernel/debug/tracing/trace_pipe, waarin bpf_printk zijn berichten schrijft:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Twee pakketten zijn gedetecteerd op lo en verwerkt op CPU0 — ons eerste volwaardige betekenisloze BPF-programma heeft gewerkt!
Het is vermeldenswaard dat bpf_printk niet voor niets naar het debugbestand schrijft: dit is niet de handigste helper voor gebruik in productie, maar ons doel was iets eenvoudigs te tonen.
Toegang tot maps vanuit BPF-programma's
Voorbeeld: gebruik een map vanuit een BPF-programma
In eerdere secties hebben we geleerd om maps vanuit de gebruikersruimte te maken en te gebruiken, en nu kijken we naar de kerncomponent. Laten we beginnen, zoals gebruikelijk, met een voorbeeld. Laten we ons programma herschrijven xdp-simple.bpf.c het als volgt:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Aan het begin van het programma hebben we de definitie van de map toegevoegd simple-prog: dit is een array van 8 elementen waarin waarden van het type u64 (in C zouden we zo'n array definiëren als u64 woo[8]). In het programma "xdp/simple" krijgen we het nummer van de huidige processor in de variabele key en vervolgens gebruiken we de hulpfunctie bpf_map_lookup_element We obtain a pointer to the corresponding entry in the array, which we increment by one. In other words: we are counting the statistics of which CPU handled the incoming packets. Let's try to run the program:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Let's check that it has attached to lo and send a few packets:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Now let's look at the contents of the array:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Almost all processes were handled on CPU7. This is not important for us; what matters is that the program works, and we understood how to access maps from BPF programs — using .
The mystical pointer
So, we can access the map from the BPF program using calls like
val = bpf_map_lookup_elem(&woo, &key);where the helper function looks like
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)but we are passing the pointer &woo to an unnamed structure struct { ... }…
If we look at the assembler of the program, we will see that the value &woo is actually undefined (line 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
and is contained in the relocations:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

Relocation section '.relxdp/simple' at offset 0xe18 contains 1 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
But if we look at the already loaded program, we will see a pointer to the correct map (line 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Thus, we can conclude that at the moment of our loader program's launch, the reference to &woo was replaced by something by the library libbpfLaten we beginnen met het bekijken van de uitvoer strace:
$ sudo strace -e bpf .\/xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
We zien dat libbpf de map is aangemaakt simple-prog en vervolgens ons programma is geladen simple. Laten we eens beter kijken naar hoe we het programma laden:
- we roepen aan
xdp_simple_bpf__open_and_loaduit het bestandxdp-simple.skel.h - dat aanroept
xdp_simple_bpf__loaduit het bestandxdp-simple.skel.h - dat aanroept
bpf_object__load_skeletonuit het bestandlibbpf\/src\/libbpf.c - dat aanroept
bpf_object__load_xattruitlibbpf\/src\/libbpf.c
De laatste functie zal, naast nog andere dingen, aanroepen bpf_object__create_maps, die bestaande maps aanmaakt of opent, en ze omzet in bestandsdescriptoren. (Hier zien we BPF_MAP_CREATE in de uitvoer strace.). Vervolgens wordt de functie aangeroepen bpf_object__relocate en dat is wat ons interesseert, omdat we zich herinneren dat we gezien hebben simple-prog in de relocatietabel. Door deze te onderzoeken, komen we uiteindelijk bij de functie bpf_program__relocate, die verantwoordelijk is voor :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Dus nemen we onze instructie
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 llen vervangen de bronregistratie door BPF_PSEUDO_MAP_FD, en de eerste IMM door de bestandsdescriptor van onze map en, als deze bijvoorbeeld gelijk is aan 0xdeadbeef, dan krijgen we als resultaat de instructie
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llOp deze manier wordt informatie over de maps doorgegeven aan het specifieke geladen BPF-programma. Daarbij kan de map zowel aangemaakt zijn met BPF_MAP_CREATE, als geopend worden via ID met BPF_MAP_GET_FD_BY_ID.
Kortom, bij gebruik van libbpf is het algoritme als volgt:
- tijdens de compilatie worden er records in de relocatietabel gemaakt voor verwijzingen naar maps
libbpfopen de ELF-objecten, vindt alle gebruikte maps en maakt bestandsdescriptoren voor hen- bestandsdescriptoren worden geladen in de kernel als onderdeel van de instructie
LD64
Zoals je begrijpt, is dat nog niet alles, en we moeten de kernel in. Gelukkig hebben we een aanwijzing — we hebben de waarde BPF_PSEUDO_MAP_FD in de bronregistratie ingesteld en kunnen deze doorzoeken, wat ons naar het heilige der heiligen zal leiden — kernel/bpf/verifier.c, waar een functie met een kenmerkende naam de bestandsdescriptor vervangt door het adres van een structuur van het type struct bpf_map:
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) {
    ...

    f = fdget(insn[0].imm);
    map = __bpf_map_get(f);
    if (insn->src_reg == BPF_PSEUDO_MAP_FD) {
        addr = (unsigned long)map;
    }
    insn[0].imm = (u32)addr;
    insn[1].imm = addr >> 32;
(je kunt de volledige code vinden ). Dus we kunnen ons algoritme aanvullen:
- Tijdens het laden controleert het programma verifier de juiste omgang met de map en schrijft het adres van de bijbehorende structuur.
struct bpf_map
Bij het laden van een ELF-binaire met behulp van libbpf gebeurt er nog veel meer, maar dit zullen we in andere artikelen bespreken.
We laden programma's en mappen zonder libbpf.
Zoals beloofd, hier is een voorbeeld voor lezers die willen weten hoe ze een programma kunnen maken en laden met behulp van mappen, zonder hulp van libbpf. Dit kan nuttig zijn wanneer je werkt in een omgeving waarvoor je de afhankelijkheden niet kunt compileren, of wanneer je elke bit wilt besparen, of wanneer je een programma schrijft zoals , dat BPF-binaire code on-the-fly genereert.
Om het gemakkelijker te maken de logica te volgen, zullen we ons voorbeeld herschrijven xdp-simple. De volledige en iets uitgebreide code van het programma dat in dit voorbeeld wordt behandeld, vind je in deze .
De logica van onze applicatie is als volgt:
- maak een map van het type
BPF_MAP_TYPE_ARRAYmet behulp van het commandoBPF_MAP_CREATE, - maak een programma dat deze map gebruikt,
- koppel het programma aan de interface
lo,
wat in mensentaal betekent
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Hier map_create maakt een map op dezelfde manier zoals we dat in het eerste voorbeeld met de systeemaanroep deden bpf — "kern, maak alsjeblieft een nieuwe map in de vorm van een array van 8 elementen van het type __u64 en geef me een bestandsdescriptor terug:"
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Het programma wordt ook eenvoudig geladen:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
Het lastige deel prog_load is het definiëren van ons BPF-programma in de vorm van een array van structs struct bpf_insn insns[]. Maar omdat we een programma gebruiken dat we in C hebben, kunnen we een beetje creatief zijn:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4 <LBB0_2>
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 <LBB0_2>:
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Dus, we moeten 14 instructies schrijven in de vorm van struct-types struct bpf_insn (tip: Neem de dump hierboven, lees het gedeelte over instructies opnieuw, open en en probeer te bepalen struct bpf_insn insns[] zelf:
struct bpf_insn insns[] = {
    	/* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    	/* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    	/* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    	/* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    	/* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, 	/* placeholder */

    	/* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    	/* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    	/* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4 <LBB0_2> */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    	/* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    	/* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    	/* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    	/* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    	/* <LBB0_2>: bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    	/* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Een oefening voor degenen die dit niet zelf hebben geschreven — vind map_fd.
In ons programma is er nog één onbeantwoorde vraag — xdp_attach. Helaas kunnen XDP-programma's niet worden aangesloten via een systeemaanroep bpf. De mensen die BPF en XDP hebben gecreëerd, komen uit de Linux-netwerkgemeenschap, wat betekent dat ze de interface gebruikten die voor hen het meest vertrouwd was (maar niet voor normale mensen) in hun interactie met de kernel: , zie ook . De eenvoudigste manier om dit te implementeren xdp_attach is door de code te kopiëren vanuit libbpf, met name uit het bestand , wat we hebben gedaan, en het iets hebben ingekort:
Welkom in de wereld van netlink sockets
We openen een netlink socket van het type NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("netlink foutmelding niet ondersteund");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
We lezen uit zo'n socket:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "verkeerde pid");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); te veel code om te kopiëren...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Ten slotte, hier is onze functie die de socket opent en een speciaal bericht erin verzendt dat een bestandshandle bevat:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* voeg XDP fd toe */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* als de gebruiker vlaggen heeft doorgegeven, voeg deze ook toe */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Dus, alles is klaar voor testen:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Laten we eens kijken of ons programma verbonden is met lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Laten we wat pings sturen en de map bekijken:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Gevonden 8 elementen
Hoera, alles werkt. Merk overigens op dat onze map opnieuw wordt weergegeven in de vorm van bytes. Dit gebeurt omdat, in tegenstelling tot libbpf we geen type-informatie (BTF) hebben geladen. Maar daarover zullen we het volgende keer hebben.
Ontwikkeltools
In dit gedeelte zullen we kijken naar de minimale set tools voor BPF-ontwikkelaars.
Over het algemeen is er niets bijzonders nodig voor de ontwikkeling van BPF-programma's — BPF werkt op elke fatsoenlijke distributiekern, en programma's worden gebouwd met behulp van clang, dat kan worden geïnstalleerd vanuit het pakket. Echter, omdat BPF in ontwikkeling is, veranderen de kernel en tools constant. Als je niet op de ouderwetse manier BPF-programma's wilt schrijven zoals in 2019, moet je het zelf samenstellen.
llvm/clangpahole- je eigen kernel
bpftool
(Ter referentie: dit gedeelte en alle voorbeelden in het artikel zijn uitgevoerd op Debian 10.)
llvm/clang
BPF werkt goed samen met LLVM en, hoewel je sinds kort BPF-programma's ook met gcc kunt compileren, wordt alle huidige ontwikkeling voor LLVM gedaan. Daarom gaan we eerst de actuele versie verzamelen clang uit git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... veel tijd later
$
Nu kunnen we controleren of alles correct is samengevoegd:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  LLVM versie 11.0.0git
  Geoptimaliseerde build.
  Standaarddoel: x86_64-unknown-linux-gnu
  Host CPU: znver1

  Geregistreerde Doelen:
    bpf    - BPF (host-endian)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - 32-bit X86: Pentium-Pro en hoger
    x86-64 - 64-bit X86: EM64T en AMD64
(De instructies voor samenstellen clang heb ik gehaald uit .)
We zullen de net samengestelde programma's niet installeren, maar in plaats daarvan gewoon toevoegen aan PAD, bijvoorbeeld:
export PATH="`pwd`/bin:$PATH"(Dit kan worden toegevoegd aan .bashrc of in een apart bestand. Persoonlijk voeg ik dit soort dingen toe aan ~/bin/activate-llvm.sh en wanneer nodig doe ik . activate-llvm.sh.)
Pahole en BTF
Hulpprogramma pahole wordt gebruikt bij het samenstellen van de kernel om debugging-informatie in het BTF-formaat te genereren. We zullen in dit artikel niet diep ingaan op de details van de BTF-technologie, behalve dat het handig is en we het willen gebruiken. Dus, als je van plan bent je eigen kernel te bouwen, bouw dan eerst pahole (zonder pahole kun je de kernel niet samenstellen met de optie CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Kernels voor experimenten met BPF
Bij het verkennen van de mogelijkheden van BPF wil je je eigen kernel samenstellen. Dit is over het algemeen niet verplicht, want je kunt BPF-programma's ook compileren en laden met een distributiekernel. Echter, het hebben van je eigen kernel stelt je in staat om de nieuwste functies van BPF te gebruiken, die in jouw distributie in de beste geval pas maanden later beschikbaar komen, of, in het geval van sommige debugging-tools, helemaal niet in de nabije toekomst. Bovendien laat een eigen kernel je belangrijker experimenteren met de code.
Om een kernel te bouwen, heb je ten eerste de kernel zelf nodig, en ten tweede een configuratiebestand voor de kernel. Voor experimenten met BPF kunnen we een gewone kernel of een van de ontwikkel-kernels gebruiken. Historisch gezien vindt de ontwikkeling van BPF plaats binnen de Linux-netwerkgemeenschap, waardoor alle wijzigingen vroeg of laat door David Miller gaan — de maintainer van het netwerkgedeelte van Linux. Afhangend van hun aard — wijzigingen of nieuwe functies — komen netwerkveranderingen in een van de twee kernels terecht — of . Wijzigingen voor BPF worden op dezelfde manier verdeeld tussen en , die vervolgens in net en net-next worden gepusht, respectievelijk. Zie voor meer informatie het en . Dus kies een kernel op basis van jouw voorkeur en stabiliteitsbehoeften van het systeem waarop je test (*-next kernels zijn de minst stabiele van de genoemde).
In dit artikel wordt niet uitgelegd hoe je met configuratiebestanden voor de kernel omgaat — het wordt verondersteld dat je dit al weet of zelfstandig te leren. De volgende instructies zouden echter meer dan voldoende moeten zijn om een werkend systeem met BPF-ondersteuning op te zetten.
Download een van de eerder genoemde kernels:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Compileer een minimale werkende kernelconfiguratie:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Schakel BPF-opties in het bestand .config van jouw keuze in (waarschijnlijk is CONFIG_BPF al ingeschakeld, omdat systemd het gebruikt). Hier is een lijst met opties van de kernel die voor dit artikel is gebruikt:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Vervolgens kunnen we gemakkelijk de modules en de kernel verzamelen en installeren (overigens, je kunt de kernel bouwen met de zojuist gebouwde clang, door CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
en opnieuw opstarten met de nieuwe kernel (ik gebruik hiervoor kexec uit het pakket kexec-tools):
v=5.8.0-rc6+ # als je de huidige kernel opnieuw bouwt, kun je v=`uname -r` gebruiken
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
De meest gebruikte tool in dit artikel is de tool bpftool, geleverd met de Linux-kernel. Het is geschreven en onderhouden door BPF-ontwikkelaars voor BPF-ontwikkelaars en hiermee kun je alle soorten BPF-objecten beheren — programma's laden, maps aanmaken en aanpassen, de levenscyclus van het BPF-ecosysteem verkennen, enz. De documentatie in de vorm van bronmateriaal voor man-pagina's is te vinden of, al gecompileerd, .
Op het moment van schrijven wordt bpftool vooraf gecompileerd geleverd voor RHEL, Fedora en Ubuntu (zie bijvoorbeeld , waarin het onafgeronde verhaal over packaging wordt verteld bpftool in Debian). Maar als je je kernel al hebt opgebouwd, dan is het eenvoudig te maken: bpftool $ cd ${linux}/tools/bpf/bpftool # ... geef de paden naar de laatste clang op, zoals hierboven beschreven $ make -sAuto-detecting system features: ... libbfd: [ aan ] ... disassembler-four-args: [ aan ] ... zlib: [ aan ] ... libcap: [ aan ] ... clang-bpf-co-re: [ aan ]Auto-detecting system features: ... libelf: [ aan ] ... zlib: [ aan ] ... bpf: [ aan ]$
(hier${linux} — dit is je directory met de kernel.) Na het uitvoeren van deze commando's zal het worden samengesteld in de directory bpftool ${linux}/tools/bpf/bpftool en het kan aan het pad worden toegevoegd (vooral voor de gebruiker ) of gewoon worden gekopieerd naar rootHet is het beste om te verzamelen met de laatste /usr/local/sbin.
, opgebouwd zoals hierboven beschreven, en om te controleren of het goed is opgebouwd — met behulp van bijvoorbeeld het commando bpftool $ sudo bpftool feature probe kernel Scanning system configuration... bpf() syscall for unprivileged users is enabled JIT compiler is enabled JIT compiler hardening is disabled JIT compiler kallsyms exports are enabled for root ... clangdat laat zien welke BPF-functies zijn ingeschakeld in jouw kernel.
Overigens, het vorige commando kan worden uitgevoerd alsdie zal laten zien welke BPF-functies zijn ingeschakeld in uw kernel.
Trouwens, het vorige commando kan worden uitgevoerd als
# bpftool f p kDit is gedaan naar analogie met de hulpprogramma's uit het pakket iproute2, waar we bijvoorbeeld kunnen zeggen ip a s eth0 in plaats van ip addr show dev eth0.
Conclusie
BPF stelt ons in staat om effectief de functionaliteit van de kernel te meten en te wijzigen. Het systeem is zeer succesvol gebleken, in de beste tradities van UNIX: een eenvoudig mechanisme dat (her)programmeren van de kernel mogelijk maakt, heeft een enorme hoeveelheid mensen en organisaties in staat gesteld om te experimenteren. En hoewel de experimenten, net als de ontwikkeling van de BPF-infrastructuur, nog lang niet voorbij zijn, heeft het systeem al een stabiele ABI die een betrouwbare, en vooral efficiënte bedrijfslogica mogelijk maakt.
Ik wil opmerken dat de technologie, naar mijn mening, zo populair is geworden omdat je aan de ene kant ermee kunt spelen (de architectuur van de machine kan je meer of minder in één avond begrijpen), en aan de andere kant — taken kunt oplossen die (mooi) niet op te lossen waren vóór de komst ervan. Deze twee componenten samen dwingen mensen om te experimenteren en te dromen, wat leidt tot de ontwikkeling van steeds meer innovatieve oplossingen.
Dit artikel, hoewel het niet bijzonder kort is, is slechts een inleiding tot de wereld van BPF en beschrijft niet de 'gevorderde' mogelijkheden en belangrijke onderdelen van de architectuur. Het verdere plan is ongeveer als volgt: het volgende artikel zal een overzicht zijn van de soorten BPF-programma's (in kernel 5.8 worden 30 soorten programma's ondersteund), daarna zullen we eindelijk kijken naar hoe we echte applicaties op BPF kunnen schrijven, met als voorbeeld kerntraceringprogramma's, en dan is het tijd voor een diepgaandere cursus over BPF-architectuur, en daarna voor voorbeelden van netwerks- en beveiligingsapplicaties van BPF.
De vorige artikelen in deze cyclus
Links
— documentatie over BPF van cilium, meer bepaald van Daniel Borkman, een van de makers en onderhouders van BPF. Dit is een van de eerste serieuze beschrijvingen, die zich onderscheidt van de anderen omdat Daniel precies weet waar hij over schrijft en er geen fouten worden waargenomen. In dit document wordt onder andere uitgelegd hoe je werkt met BPF-programma's van de types XDP en TC met behulp van de bekende utility
ipuit het pakketiproute2.— het originele bestand met documentatie over de klassieke, en later de uitgebreide BPF. Het is nuttig om te lezen als je wilt graven in assembler en technische details van de architectuur.
. Het wordt zelden bijgewerkt, maar het is treffend, omdat Alexei Starovoitov (de auteur van eBPF) en Andrii Nakryiko — (de maintainer) daar schrijven.
libbpf).. Een interessante Twitter-thread van Quentin Monnet met voorbeelden en geheimen van het gebruik van bpftool.
. Een enorme (en nog steeds bijgehouden) lijst met links naar BPF-documentatie van Quentin Monnet.
Bron: habr.com
