

Naarmate IPv4-adressen opraken, zijn veel telecomoperators geconfronteerd met de noodzaak om hun klanten toegang tot het netwerk te bieden via adresvertaling. In dit artikel zal ik uitleggen hoe je Carrier Grade NAT-prestaties kunt behalen op commodity-servers.
Een beetje geschiedenis
Het onderwerp van de uitputting van het IPv4-adresblok is al geruime tijd niet nieuw. Op een gegeven moment verschenen er wachtlijsten bij RIPE, en er ontstonden markten waar blokken adressen werden verhandeld en overeenkomsten voor verhuur werden gesloten. Geleidelijk aan begonnen telecomoperators internettoegang te bieden via adres- en poortvertaling. Sommigen hebben niet genoeg adressen gekregen om elke abonnee een ‘wit’ adres te geven, terwijl anderen begonnen met besparen en geen adressen op de secundaire markt wilden kopen. Fabrikanten van netwerkapparatuur steunden dit idee, omdat deze functionaliteit vaak extra uitbreidingsmodules of licenties vereist. Bijvoorbeeld, bij Juniper kan NAPT uitgevoerd worden op een aparte servicekaart MS-MIC in de MX-routerlijn (behalve de laatste MX104 en MX204), bij Cisco ASR1k is een CGN-licentie vereist, en bij Cisco ASR9k een aparte module A9K-ISM-100 met de licentie A9K-CGN-LIC. Over het algemeen kost dit geen kleine som.
IPTables
De taak van NAT vereist geen gespecialiseerde rekencapaciteit, dit kan worden opgelost met standaard processors die bijvoorbeeld in elke thuisrouter zijn geïnstalleerd. Op het niveau van telecomoperators kan deze taak worden uitgevoerd met commodity-servers die draaien op FreeBSD (ipfw/pf) of GNU/Linux (iptables). We zullen FreeBSD niet beschouwen, omdat ik deze OS al geruime tijd niet meer gebruik, dus concentreren we ons op GNU/Linux.
Adresvertaling inschakelen is helemaal niet moeilijk. Begin met het toevoegen van een regel in iptables in de nat-tabel:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Het besturingssysteem zal de module nf_conntrack laden, die alle actieve verbindingen in de gaten houdt en de nodige conversies uitvoert. Hier zijn enkele subtiliteiten. Ten eerste, omdat het gaat om NAT op de schaal van een telecomoperator, moeten de time-outs worden aangepast, want met de standaardwaarden zal de grootte van de vertaaltafel snel toenemen tot catastrofale waarden. Hieronder een voorbeeld van de instellingen die ik op mijn servers heb gebruikt:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
En ten tweede, omdat de standaardgrootte van de vertaaltafel niet is ontworpen voor gebruik in een telecomomgeving, moet deze worden vergroot:
net.netfilter.nf_conntrack_max = 3145728
Het aantal buckets voor de hash-tabel die alle vertalingen opslaat moet ook worden vergroot (dit is een optie van de nf_conntrack-module):
options nf_conntrack hashsize=1572864
Na deze eenvoudige aanpassingen is er een volledig functionele opstelling ontstaan die een groot aantal cliëntadressen kan vertalen naar een pool van externe adressen. Echter, de prestaties van deze oplossing zijn niet optimaal. In mijn eerste pogingen om GNU/Linux voor NAT te gebruiken (ongeveer 2013) kon ik prestaties halen van ongeveer 7Gbit/s bij 0.8Mpps op één server (Xeon E5-1650v2). Sindsdien zijn er vele optimalisaties in de netwerkstack van de GNU/Linux-kernel aangebracht, en de prestaties van één server met dezelfde hardware zijn praktisch gestegen naar 18-19 Gbit/s bij 1.8-1.9 Mpps (dit waren de maximale waarden), maar de behoefte aan het volume dat door één server moest worden verwerkt, groeide veel sneller. Uiteindelijk werden er schema’s ontwikkeld voor load balancing over verschillende servers, maar dit verhoogde de complexiteit van de configuratie, onderhoud en de kwaliteit van de geleverde diensten.
NFTables
Momenteel is een populaire trend in het programmeren van "pakketten doorschuiven" het gebruik van DPDK en XDP. Over dit onderwerp zijn talloze artikelen geschreven, zijn er verschillende presentaties gegeven en verschijnen er commerciële producten (bijvoorbeeld SKAT van VasExperts). Maar onder de omstandigheden van beperkte middelen bij programmeurs van telecomoperators is het behoorlijk problematisch om zelf een soort "project" op basis van deze frameworks te ontwikkelen. Het is namelijk veel moeilijker om een dergelijke oplossing verder te exploiteren, met name omdat er diagnose-instrumenten ontwikkeld moeten worden. Bijvoorbeeld, de standaard tcpdump werkt niet zomaar met DPDK, en de pakketten die via XDP terug de kabels in worden gestuurd, zullen niet "zichtbaar" zijn voor deze tool. Tegen de achtergrond van alle gesprekken over nieuwe technologieën voor het doorsturen van pakketten in de gebruikersruimte zijn de en Pablo Neira Ayuso, maintainer van iptables, over de ontwikkeling van flow offloading in nftables. Laten we dit mechanisme nader bekijken.
Het basisidee is dat als de router pakketten van één sessie in beide richtingen van de stroom (TCP-sessie is in de toestand ESTABLISHED gegaan) heeft doorgelaten, er geen noodzaak is om de volgende pakketten van deze sessie door alle firewall-regels te laten gaan, aangezien al deze controles uiteindelijk toch zullen resulteren in de doorgifte van het pakket voor verdere routing. Bovendien is het kiezen van een route niet nodig — we weten al naar welke interface en aan welk host we de pakketten binnen deze sessie moeten doorsturen. Het blijft alleen om deze informatie op te slaan en te gebruiken voor routing in een vroeg stadium van de pakketverwerking. Bij het uitvoeren van NAT moet bovendien informatie over de wijzigingen in adressen en poorten, die door de nf_conntrack-module zijn omgezet, worden opgeslagen. Ja, natuurlijk, in dit geval werken verschillende policers en andere informatief-statistische regels in iptables niet meer, maar binnen de context van de taak van een afzonderlijke NAT-implementatie of bijvoorbeeld een border is dat niet zo belangrijk, omdat de services over apparaten verspreid zijn.
Configuratie
Om gebruik te maken van deze functie moeten we:
- Een recente kernel gebruiken. Hoewel de functionaliteit al in kernel 4.16 is verschenen, was deze een tijdlang erg "ruw" en veroorzaakte regelmatig kernel panics. Het stabiliseerde ongeveer in december 2019, toen de LTS-kernels 4.19.90 en 5.4.5 uitkwamen.
- Herformuleer de iptables-regels naar het nftables-formaat met behulp van een redelijk recente versie van nftables. Dit werkt perfect in versie 0.9.0.
Als het eerste punt in principe duidelijk is, vergeet dan niet om de module in de configuratie op te nemen bij het bouwen (CONFIG_NFT_FLOW_OFFLOAD=m), vereist het tweede punt enige toelichting. De nftables-regels worden heel anders beschreven dan in iptables. legt vrijwel alle aspecten bloot, er zijn ook speciale voor regels van iptables naar nftables. Daarom geef ik alleen een voorbeeld van de NAT-instelling en flow offload. Een kleine legende voor het voorbeeld: <i_if>, <o_if> — dit zijn de netwerkinterfaces waar het verkeer doorheen gaat, er kunnen in werkelijkheid meer dan twee zijn. <pool_addr_start>, <pool_addr_end> — het start- en eindadres van het 'witte' adresbereik.
De NAT-configuratie is heel eenvoudig:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Met flow offload is het iets ingewikkelder, maar nog steeds begrijpelijk:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Dit is dus de hele configuratie. Nu zal al het TCP/UDP-verkeer in de fastnat-tabel komen en veel sneller worden verwerkt.
Resultaten
Om duidelijk te maken hoezeer dit 'veel sneller' is, voeg ik een screenshot toe van de belasting op twee echte servers, met dezelfde specificaties (Xeon E5-1650v2), evenzo geconfigureerd, met hetzelfde Linux-kernel, maar die NAT uitvoeren in iptables (NAT4) en in nftables (NAT5).
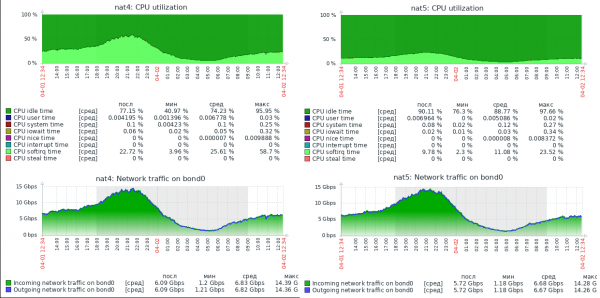
Op de screenshot is er geen grafiek van pakketten per seconde, maar in het belastingprofiel van deze servers ligt de gemiddelde pakketgrootte rond de 800 bytes, waardoor de waarden oplopen tot 1.5Mpps. Zoals te zien is, heeft de server met nftables een enorme prestatiecapaciteit. Op dit moment verwerkt deze server tot 30Gbit/s bij 3Mpps en is duidelijk in staat om tegen de fysieke netwerkbeperking van 40Gbps aan te lopen, met nog vrije CPU-resources.
Ik hoop dat dit materiaal nuttig zal zijn voor netwerkingenieurs die proberen de prestaties van hun servers te verbeteren.
Bron: habr.com
