

De kwaliteit van het draadloze netwerk is al standaard opgenomen in het begrip serviceniveau. En als je wilt voldoen aan de hoge eisen van klanten, moet je niet alleen snel reageren op opkomende netwerkproblemen, maar ook de meest voorkomende ervan voorspellen.
Hoe doe je dit? Alleen door te volgen wat echt belangrijk is in deze context - de interactie van de gebruiker met het draadloze netwerk.
De belasting op netwerken blijft toenemen, en dit heeft vooral impact op de draadloze segmenten - vooral vanwege de openheid van hun interface. Met de groei van het aantal apparaten en de datasnelheden vermenigvuldigen de problemen zich op meerdere niveaus. Op fysiek niveau beïnvloeden veel radiosignaalzenders elkaar, zelfs als ze op aangrenzende segmenten van het frequentiespectrum werken. Op logisch niveau beginnen een groot aantal aangesloten apparaten te concurreren voor het recht om gegevens te verzenden op de gekozen frequentie, wat de pakketlevering voor elke gebruiker vertraagt.
Tegelijkertijd nemen ook de verwachtingen van elke klant ten aanzien van het gebruik van het netwerk toe. Een laadtijd van 5 seconden voor een webpagina in de browser, die nog twintig jaar geleden als 'technologisch hoogstandje' gold, verrast niemand meer. Klanten willen HD-videocommunicatie zonder vertragingen in de beelden.
De nieuwe versies van draadloze transmissiestandaarden helpen gedeeltelijk om dit probleem op te lossen, door het frequentiespectrum efficiënter te benutten. Elke is gericht op het opzetten van steeds drukker belastte netwerken. Maar in een grootschalig netwerk, waar niet zomaar een dozijn toegangspunten functioneren, is het onmogelijk om alles over te laten aan de nieuwste standaard (bovendien werken apparaten in een modus voor achterwaartse compatibiliteit zodra ze een oud gebruikersapparaat tegenkomen). Ook is het niet mogelijk om te blijven leven met verouderde monitoringtools - de netwerkomgeving wordt voortdurend complexer.
Waarom conventionele monitoring niet meer werkt
De klassieke gedachte, die nog steeds alle netwerkbeheerders, inclusief die van draadloze netwerken, achtervolgt - werken alleen op verzoek. Een 'alarm' gaat af - we schrikken wakker en onderzoeken wat er mis is gegaan. Maar zolang er geen 'alarm' is, kun je je beperken tot het controleren van de belasting op de belangrijkste componenten - netwerken en gebruikersapparaten.
Volgens deze taak werken traditionele monitoring- en onderhouds-tools volgens strikte regels en tonen ze bestaande problemen niet altijd tijdig aan, laat staan dat ze voorspellende analyses bieden.
Het voornaamste probleem hier ligt in het verzamelinterval van gegevens. Informatie over de status van draadloze netwerkverbindingen wordt elke paar minuten verzameld, terwijl incidenten zich perfect kunnen voordoen in de intervallen tussen de gegevensverzameling (een uitstekend voorbeeld zijn zeldzame belastingpieken die het netwerk 'vastzetten'). Het is vrij moeilijk om te begrijpen wat de diepere oorzaak van het probleem is zonder realtime gegevens. Is het een verkeerde beheersing van de netwerkbedekking? Of misschien externe verstoringen die niets met het bedrijf te maken hebben (bijvoorbeeld, een militaire basis in de buurt zorgde voor storing in de radiofrequenties). Er zijn geen gegevens beschikbaar om de geleidelijke achteruitgang van bepaalde netwerkkenmerken te zien, waardoor het niet zo eenvoudig is om het probleem te lokaliseren. IT-personeel zal bovendien extra uren moeten besteden aan het zoeken naar zo'n 'naald in een hooiberg'.
Eindgebruikers merken het probleem daarentegen vrijwel onmiddellijk. Een verbindingsfout of het onderbreken van videoweergave zijn uitstekende indicatoren.
Traditionele monitoringtools geven aan dat netwerkpakketten worden verzonden. Maar ze kunnen helemaal niet antwoorden op de vraag of de gebruiker zijn taak heeft opgelost.
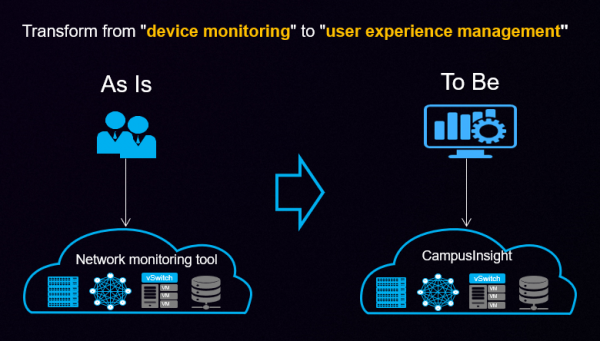
Om een antwoord op deze vraag te krijgen, moeten we niet alleen het instrument veranderen, maar ook de aanpak van de organisatie van monitoring. We moeten overgaan van 'brandbestrijdings' werk op basis van aanvragen (eigenlijk, beheer van de prestaties en belasting van specifieke hardware) naar het controleren van de gebruikerservaring en het identificeren van situaties die tot incidenten kunnen leiden.
Deze transformatie omvat het implementeren van geavanceerdere algoritmen voor probleemidentificatie dan alleen eenvoudige waarschuwingen bij het bereiken van bepaalde drempelwaarden. In het platform voor intelligente netanalyse van Huawei CampusInsight zijn deze algoritmen gebaseerd op de ervaring met het onderhoud van draadloze netwerken en zelflerende technieken.
Onder de motorkap van CampusInsight
Huawei CampusInsight – een schaalbaar platform voor het monitoren van draadloze netwerken van verschillende groottes. Het is gebouwd op basis van microservicesarchitectuur. Elke service draait op meerdere instanties, waarbij berichten tussen hen worden verdeeld door de bijbehorende bus. Extra instanties kunnen dynamisch worden uitgerold, waardoor de capaciteit van het hulpmiddel toeneemt.
Eigenlijk verzamelt, analyseert en toont CampusInsight gegevens in zijn gebruikersinterface in vijf stappen.
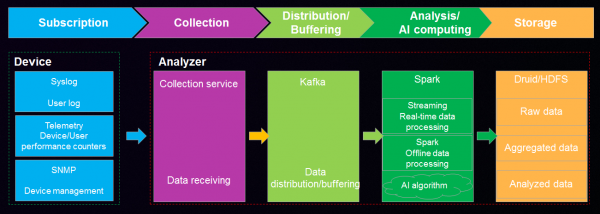
De eerste en tweede stap is toegang tot gegevens (naar de apparaten die deze genereren) en het verzamelen van ‘metingen’. Door gebruik te maken van streaming telemetrieverzameling via het GPB-protocol van Google en ‘traditionele’ Syslog (waar mogelijk), accumuleert Huawei CampusInsight gegevens bijna in real-time:
- over de benutting van het frequentiespectrum;
- over de prestaties van toegangspunten en andere netwerkapparaten (prestatie-indicatoren, aantal aangesloten gebruikers, enz.);
- over het pad van specifieke gebruikers – over netwerkprofielen, wie wanneer met welk toegangspunt is verbonden of niet (en met welke verbindingsparameters);
- over de werking van audio-video toepassingen (met eMDI, geïmplementeerd in een van de aanvullende pakketten).
Om de beperkingen van traditionele hulpmiddelen, die SNMP en de verzending van vaste structuren gebruiken voor gegevensverzameling, te omzeilen, is de basis van CampusInsight een model voor abonnement op de benodigde logs en algoritmen voor het coderen en decoderen van gegevens.
De derde stap is distributie en buffering – dat wil zeggen, het verzenden van ‘rauwe’ gegevens naar Kafka voor distributie naar hoger niveau analysetools.
De vierde stap is analyse. Big Data- en AI-algoritmen helpen bij het snel verwerken van ‘rauwe’ gegevens. Hierdoor kunnen specifieke problemen aan het licht komen die verband houden met:
- authenticatie (ondersteuning voor het Dot1x-protocol) en de werking van DHCP;
- stabiliteit en snelheid van de verbinding;
- draadloze interfaces;
- de werking van afzonderlijke apparaten, inclusief ‘specifieke’ problemen zoals problemen met PoE of de omschakeling van een dual-band apparaat naar 2,4 GHz;
- de kwaliteit van audio-video streams – echter, de functie wordt alleen ondersteund voor onversleutelde SIP of voor bepaalde switches;
- roming tussen verschillende toegangspunten.
AI-algoritmen worden gebruikt om bepaalde specifieke taken op te lossen, zoals het identificeren van interferentie tussen kanalen bij draadloze overdracht.
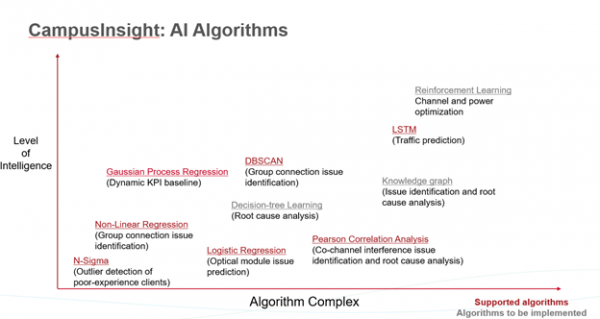
De vijfde en laatste stap is het opslaan van gegevens in de kolom-gebaseerde gedistribueerde database Druid voor toekomstig gebruik.
De analyse van de verzamelde informatie met inachtneming van de op dezelfde historische gegevens gebaseerde "basislijn" maakt het mogelijk typische "mislukkingpatronen" te identificeren - door KPI's vast te stellen die relevant zijn voor probleemgevallen, en problemen te lokaliseren door oplossingen voor te stellen. Op deze manier komt ongeveer 85% van alle netwerkproblemen in aanmerking voor aandacht van de tool.
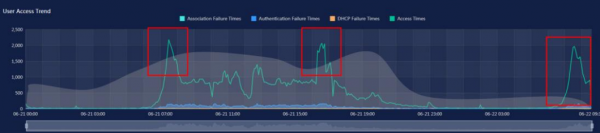
De gegevens worden aan de administrator gepresenteerd in grafische vorm volgens de hiërarchie of topologie van de ruimte (bijvoorbeeld de kantoorindeling). Men kan "heatmaps" maken, analyseren in hoeverre apparatuur van bepaalde platforms of fabrikanten is getroffen, enz. Dit maakt het gemakkelijker om te begrijpen wat precies het probleem heeft veroorzaakt.
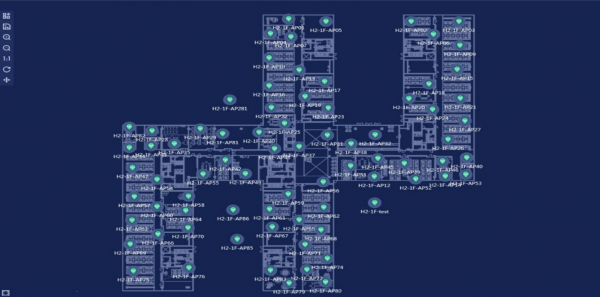
In het algemeen biedt CampusInsight een flink aantal tools die het mogelijk maken om problemen te classificeren, getroffen gebruikers te vergelijken, gegevens over het functioneren van specifieke klanten te bestuderen en zelfs gebeurtenissen die aan het incident voorafgingen "te replayen" om snel de oorzaak te identificeren. Het product ondersteunt ook de nieuwe Wi-Fi 6, om nog maar te zwijgen van de voorgangers.
Cases
CampusInsight is al in de praktijk getest, hoewel het merendeel van de cases onder een NDA valt. De meest sprekende open case is het gebruik van de monitoringtool in ons eigen draadloze netwerk van Huawei.
Het netwerk beslaat ondernemingen waarin ongeveer 180.000 mensen werken, van wie 80.000 tot de R&D-afdeling behoren (dit zijn kantoren in meer dan 170 landen, waar in totaal 62.000 toegangspunten zijn geïnstalleerd).
De implementatie van CampusInsight heeft geholpen om meer dan 630 toegangspunten te optimaliseren en tegelijkertijd de efficiëntie van incidentanalyse met 30% te verhogen.
Hieronder volgen een paar specifieke situaties.
Voorbeeld 1. Groepsfout
Hogereproblemen die bij een groot aantal gebruikers worden waargenomen, zijn vaak het gevolg van lagere fouten. Deze problemen zijn niet zo eenvoudig te identificeren. Bijvoorbeeld, in een van de kantoren ondervonden veel mobiele klanten tegelijkertijd moeilijkheden met authenticatie, ondanks de correctheid van de instellingen en het ontbreken van problemen met server Authenticatie. De visualisatie van gegevens op verschillende niveaus hielp snel vast te stellen dat de oorzaak van het probleem een switch was die te veel fouten meldde. Het enige wat nodig was om de situatie op te lossen, was het vervangen van een stuk kabel. De lokalisatie en oplossing van het probleem namen 90 minuten in beslag.
Voorbeeld 2. Kwaliteitsbewaking van roaming
Het verzamelen van gegevens over de route van een specifieke klant binnen een gedistribueerd netwerk maakt het mogelijk om onvoorziene roamingproblemen te identificeren. Een veelvoorkomend geval is wanneer mobiele gebruikers in bepaalde gebieden van een gebouw problemen ondervinden met het verbinden met het netwerk (terwijl de bijbehorende toegangspunt in orde lijkt te zijn). Een van de oorzaken van dergelijke problemen kan een te hoge aanvoersterkte van een toegangspunt in de aangrenzende ruimte zijn, waardoor de klant probeert verbinding te maken met het toegangspunt dat op dat moment al een groot aantal gebruikers bedient (een echt geval: verbinding maken met een toegangspunt in de conferentieruimte terwijl de gebruiker er gewoon langsloopt).
Om het probleem op te lossen, kan het soms voldoende zijn om de signaalsterkte van het overbelaste toegangspunt te verlagen, maar de identificatie vereist een diepgaande analyse van terugkerende problemen in aangrenzende ruimtes bij de conferentieruimte.
Door de trends in draadloze netwerken te volgen, is het te verwachten dat niet alleen de giganten met netwerken van duizenden toegangspunten in de nabije toekomst met serviceproblemen zullen worden geconfronteerd, maar ook het midden- en kleinbedrijf, dat momenteel mogelijk alleen incidentbeheer uitvoert. Aangezien we een dergelijke ontwikkeling verwachten, is het logisch om te kijken naar nieuwe, meer effectieve standaarden en high-performance apparatuur. Maar het is ook belangrijk om te denken aan de noodzakelijke verandering van de netwerkinrichting, voordat klanten massaal naar concurrenten migreren vanwege de kwaliteit van de service.
Natuurlijk zal het on-site product van de klasse CampusInsight de meeste voordelen opleveren bij grootschalige implementaties, maar er is nu ook een cloudabonnement op de service beschikbaar vanuit de lokale Public Cloud van Huawei, gericht op implementaties in de SMB-sector. In het algemeen kunnen geïnteresseerden alles nu al uitproberen en 'spelen' met de service.
Bron: habr.com
